GPT-5.2 API とは
GPT-5.2 API は、ChatGPT における GPT-5.2 Thinking と同一です。GPT-5.2 Thinking は、OpenAI の GPT-5.2 ファミリーの中位グレードで、より深い作業(多段推論、長文要約、高品質なコード生成、正確性と使える構造を重視するプロフェッショナルな知識業務)を目的に設計されています。API ではモデル gpt-5.2(Responses API / Chat Completions)として公開されており、低レイテンシの Instant バリアントと、より高品質だが高価な Pro バリアントの中間に位置します。
主な機能
- 超長コンテキストとコンパクション: 効率的な 400K 有効ウィンドウと、長い会話や文書にわたる関連性を管理するコンパクションツール。
- 推論負荷の設定可能性:
none | medium | high | xhigh(xhigh は難しい推論に最大の内部計算を有効化)。xhighは Thinking/Pro バリアントで利用可能。 - ツール/関数サポートの強化: 一級のツール呼び出し、構造化出力を制約する文法(CFG/Lark)、複雑な多段自動化を簡素化するエージェント的挙動の改善。
- マルチモーダル理解: 画像+テキストのより豊かな理解と、多段タスクへの統合。
- 安全性の向上/センシティブ内容の取り扱い: 自傷などの領域やその他のセンシティブな文脈で望ましくない応答を減らすための的確な介入。
技術的な能力と仕様(開発者向け)
- API エンドポイントとモデル ID: Thinking 用は
gpt-5.2(Responses API)、チャット/インスタント向けはgpt-5.2-chat-latest、Pro ティア向けはgpt-5.2-pro。該当箇所では Responses API と Chat Completions から利用可能。 - 推論トークンと負荷管理: リクエストごとに計算資源(推論負荷)を割り当てる明示的なパラメータをサポート。負荷を高くするとレイテンシとコストは増える一方、複雑なタスクの出力品質が向上。
- 構造化出力ツール: 文法(Lark / CFG)により、モデル出力を DSL や厳密な構文に制約可能(SQL、JSON、DSL 生成に有用)。
- 並列ツール呼び出しとエージェント調整: 進化した並列性とクリーンなツールオーケストレーションにより、複雑なシステムプロンプトやマルチエージェントの足場の必要性を低減。
ベンチマーク性能と補助データ
OpenAI は GPT-5.2 の社内外ベンチマーク結果を公開しています。以下は主なハイライト(OpenAI の公表値):
- GDPval(44 職種、知識労働) — GPT-5.2 Thinking は「比較の 70.9% で業界トップのプロフェッショナルを上回るか同等」;OpenAI によれば、GDPval のタスクで専門家よりも速度で >11×、**コストで <1%**で成果を生成(速度とコストの推定は過去データに基づく)。タスクにはスプレッドシートモデル、プレゼンテーション、短尺動画が含まれる。
- SWE-Bench Pro(コーディング) — OpenAI によれば、GPT-5.2 Thinking は SWE-Bench Pro で ≈55.6%、SWE-Bench Verified(Python のみ)で ~80% を達成し、同社のテストではコード生成/エンジニアリング評価における新たな最先端性能を確立。これは、実務でより信頼性の高いデバッグとエンドツーエンド修正につながると示されている。
- GPQA Diamond(大学院レベルの科学 Q&A) — GPQA Diamond(ツールなし、最大推論)で GPT-5.2 Pro: 93.2%、GPT-5.2 Thinking: 92.4%。
- ARC-AGI シリーズ — ARC-AGI-2(より難度の高い流動的推論ベンチマーク)で、GPT-5.2 Thinking は 52.9%、GPT-5.2 Pro は 54.2%(これらは思考過程(Chain-of-Thought)系モデルの新たな最先端水準と OpenAI は述べている)。
- 長コンテキスト(OpenAI MRCRv2) — 4-needle MRCR バリアントで 256k トークンまでほぼ 100% の精度を示し、長コンテキスト条件全般で GPT-5.1 と比べて大幅にスコアが向上。(OpenAI は MRCRv2 のチャートとテーブルを公開。)
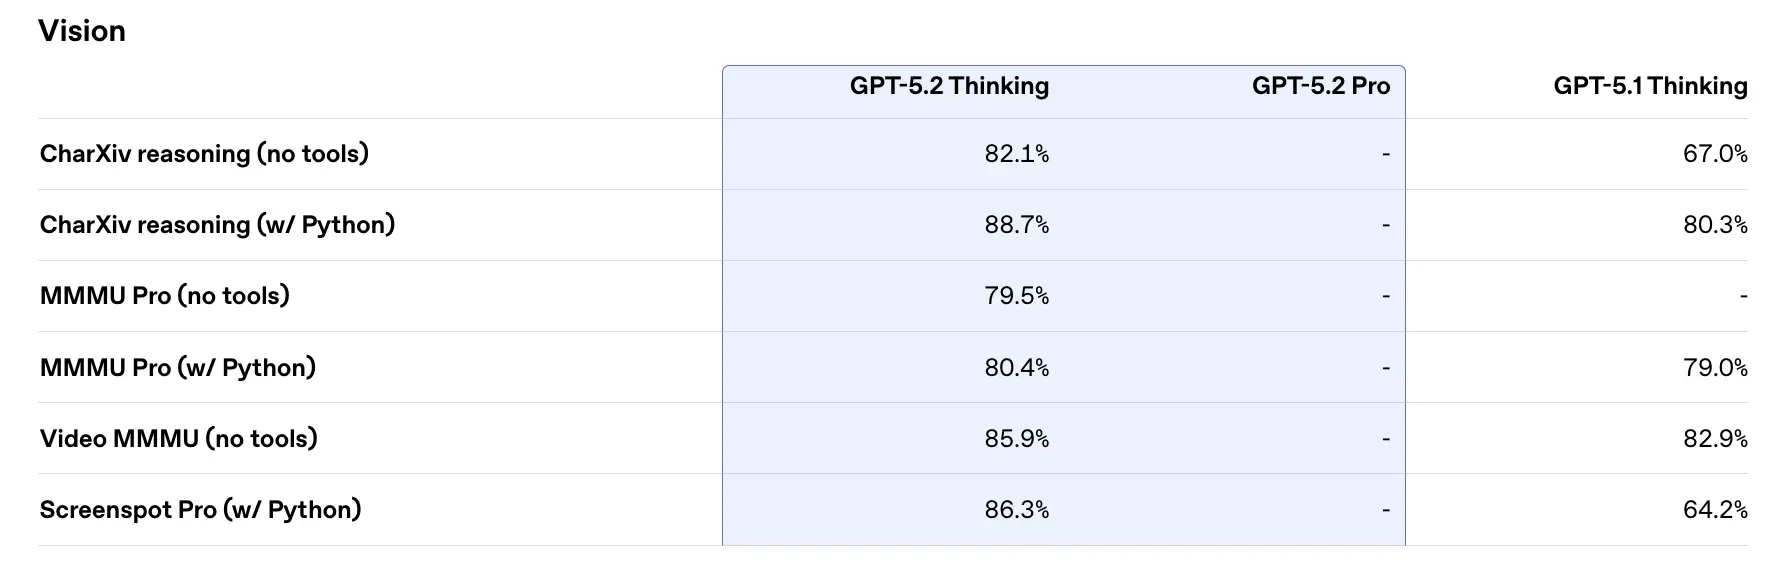
競合との比較
- vs Google Gemini 3(Gemini 3 Pro / Deep Think): Gemini 3 Pro は、約 1,048,576(≈1M)トークンのコンテキストウィンドウ、幅広いマルチモーダル入力(テキスト、画像、音声、動画、PDF)、Vertex AI / AI Studio 経由の強力なエージェント統合が公表されています。理論上、Gemini 3 のより大きいコンテキストウィンドウは非常に大規模な単一セッションのワークロードにおける差別化要因ですが、トレードオフとしてツール面の広さやエコシステム適合が挙げられます。
- vs Anthropic Claude Opus 4.5: Anthropic の Opus 4.5 は、エンタープライズのコーディング/エージェントワークフローを重視し、SWE-bench の強力な結果や長時間のエージェントセッションに対する堅牢性を報告。Anthropic は、200k のコンテキストウィンドウと専用のエージェント/Excel 統合を備えた自動化とコード生成向けに Opus を位置付けています。Opus 4.5 はエンタープライズの自動化とコードタスクにおける強力な競合です。
実務的な要点: GPT-5.2 は(400k コンテキスト、高トークン出力、推論/コーディングの改善)というバランスの取れた強化を狙っています。Gemini 3 は単一セッションでの最大級のコンテキスト(≈1M)をターゲットとし、Claude Opus はエンタープライズのエンジニアリングとエージェント運用の堅牢性に注力。コンテキストサイズ、モダリティ要件、機能/ツール適合、コスト/レイテンシのトレードオフに合わせて選択してください。
GPT-5.2 API のアクセス方法と使い方
ステップ 1: API キーに登録
cometapi.com にログインしてください。まだユーザーでない場合は、まず登録してください。CometAPI コンソール にサインインします。インターフェースのアクセス認証 API キーを取得します。個人センターの API トークンで「Add Token」をクリックし、トークンキー sk-xxxxx を取得して送信します。
ステップ 2: GPT-5.2 API にリクエストを送信
API リクエストを送信する際は「gpt-5.2」エンドポイントを選択し、リクエストボディを設定します。リクエストメソッドとリクエストボディは当社サイトの API ドキュメントから取得できます。当社サイトは利便性のため Apifox テストも提供しています。<YOUR_API_KEY> はアカウントの実際の CometAPI キーに置き換えてください。開発者は Responses API / Chat エンドポイント経由で呼び出します。
ステップ 3: 結果の取得と検証
API レスポンスを処理して生成された回答を取得します。処理後、API はタスクのステータスと出力データを返します。