Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
無料で始める 無料で始める
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog OpenAI、GPT-5.4シリーズをリリース:GPT-5.4は何を変えるのか OpenAI、GPT-5.4シリーズをリリース:GPT-5.4は何を変えるのか - CometAPI
new / CometAPIリサーチ
OpenAI、GPT-5.4シリーズをリリース:GPT-5.4は何を変えるのか GPT-5.4 は、2つの主要バリアント — GPT-5.4 Thinking と GPT-5.4 Pro — を擁し、長コンテキストの文書作業、ネイティブなコンピュータ操作(エージェント)機能、そしてオフィス、法務、金融の各ワークフローにおける事実性とタスク遂行性能の向上を強く重視した、ターゲットを絞った「プロフェッショナルな業務」向けのモデルファミリーとして登場します。このリリースは、GPT-5 系のこれまでのアップデート(とりわけ GPT-5.3 Instant と GPT-5.3-Codex)に続くもので、社内および公開ベンチマークで測定可能な改善、より深いツール統合(ChatGPT for Excel プラグインを含む)、そしてサポートするコンテキストの拡大(最大1 millionトークン)をもたらします。
GPT-5.4 は、2つの主要バリアント — GPT-5.4 Thinking と GPT-5.4 Pro — を擁し、長コンテキストの文書作業、ネイティブなコンピュータ操作(エージェント)機能、そしてオフィス、法務、金融の各ワークフローにおける事実性とタスク遂行性能の向上を強く重視した、ターゲットを絞った「プロフェッショナルな業務」向けのモデルファミリーとして登場します。このリリースは、GPT-5 系のこれまでのアップデート(とりわけ GPT-5.3 Instant と GPT-5.3-Codex)に続くもので、社内および公開ベンチマークで測定可能な改善、より深いツール統合(ChatGPT for Excel プラグインを含む)、そしてサポートするコンテキストの拡大(最大1 millionトークン)をもたらします。
この要約で素早く答えを把握し、ガイドで背景、例、実装詳細を確認してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)OpenAIの最新リリースであるGPT-5.4 は、「プロフェッショナル業務」に特化したモデルファミリーとして登場し、主にGPT-5.4 Thinking とGPT-5.4 Pro の2つのバリアントを備え、長文コンテキストの文書作業、ネイティブなコンピューター操作(エージェント)機能、そしてオフィス、法務、金融のワークフローにおける事実性とタスク性能の向上に強く重点を置いています。このリリースは、GPT-5系の以前の更新(特に GPT-5.3 Instant と GPT-5.3-Codex)に続くもので、社内および公開ベンチマークで測定可能な改善、ツール統合の深化(ChatGPT for Excel プラグインを含む)、より大きなコンテキストのサポート(最大100万トークンまで参照)をもたらしています。
現在、CometAPIはGPT-5.4 とGPT-5.4 Pro に対応しており、割引価格で利用できます。
GPT-5.4とは?
位置付けとバリアント
GPT-5.4は、OpenAIが提示する、
明確性、出典の帰属、最新のAPI用語について確認済みです。
プロフェッショナルで文書中心、かつエージェント的なワークフロー
GPT-5.4 Thinking — 推論に注力したバリアントで、モデルの思考過程をより多く露出し、多段推論やエージェントタスクに最適化(ChatGPTでは「Thinking」モードとして利用可能)。GPT-5.4 Pro — 高スループットや低レイテンシを求めるエンタープライズ向けの高計算・優先推論ティアで、追加計算を反映した高いAPI料金。 OpenAIはGPT-5.4のネイティブなコンピューター操作 機能を強調しています。これは、プログラム的なマウス/キーボード操作を通じたソフトウェアの操作や、複数ツールのオーケストレーションを可能にし、実際にタスクを完遂するエージェントの構築に向けた一歩と位置付けられています。
新機能と強化点
長文コンテキスト対応: GPT-5.4は非常に大きなコンテキストをサポートすると報告されています(ChatGPTとCodexのコンテキストで最大1,000,000トークンをサポート)。これにより、巨大なプロジェクト、書籍、コードベース、データセットをセッション中に「記憶」しておくことが可能になります。文書レビュー、契約書、複数ファイルにまたがるエンジニアリング案件にとって変革的です。ネイティブなコンピューター操作/エージェンティング: GPT-5.4は、ネイティブなコンピューター操作機能を備えたOpenAI初の汎用モデルで、UIアクション列やソフトウェアを操作するためのコードを生成できます(例:Playwright経由、もしくはスクリーンショットに基づくマウス/キーボード指示)。この機能は、ウェブやデスクトップアプリにまたがるタスクを完了するエージェントの構築を念頭に設計されています。オフィススキルの改善: スプレッドシート、プレゼンテーション、ドキュメントに大きく注力。社内ベンチマークでは、スプレッドシートのモデリング、プレゼンの美観、文書作成品質で大幅な向上が示されています。事実性の向上とハルシネーションの低減: OpenAIは、内部で作成した評価セットにおいて、以前のモデルと比べ事実誤りが減少したと報告しています(ベンチマークは後述)。 GPT-5.2 ThinkingやGPT-5.3 Codexのようなモデルと比較すると、GPT-5.4はこれらの能力を統合し、最小限のユーザー介入で長時間作業や複雑なワークフローを処理するよう設計されています。
GPT-5.4の主な特長と技術ハイライト
1) 巨大なコンテキストウィンドウ(最大1,000,000トークン) 最も目に見える能力は、API経由で最大1,000,000トークンのコンテキストウィンドウ に対応することです。これにより、1つのモデルセッションに、書籍全体、長大なコードベース、複数文書のドシエ全体などをチャンク分割せずに保持できます。知識集約的なエンタープライズワークフロー(法務ディスカバリー、研究統合、大規模コード解析)では、100万トークンのコンテキスト維持がエンジニアリングの「つなぎ」を減らし、一貫性を高めます。
示唆: これまでオーケストレーション(検索、チャンク分割、外部メモリ)を要していたワークフローが、より多くの生データコンテキストをモデルの作業メモリ内に保持できるようになり、パイプラインが簡素化され、レイテンシ/一貫性のトレードオフが緩和されます。
2. ネイティブなコンピューター/ツール操作 OpenAIは、スプレッドシート、文書編集、コード実行環境などのソフトウェアツールやコネクタを、従来モデルより堅牢に操作できる能力を強調しています。GPT-5.4は、従来の「ツール使用」機能を以下の点で拡張しています。
より適切なツール選択とツール引数の設定。
外部API呼び出しやUIライクなアクションのステップ実行における、より信頼性の高いシーケンス計画。
より賢いツール呼び出しアーキテクチャによる、エージェントワークフローのトークンオーバーヘッド削減。
デスクトップ/ウェブ自動化: スクリーンショットに基づくマウス/キーボードアクションの発行を明示的にサポートしているため、GPT-5.4は実際のソフトウェアワークフローを操作するエージェントへ組み込めます(例:フォーム入力、ダッシュボードのナビゲーション、複数手順の実行)。OpenAIはOSスタイルベンチマークで最先端の結果を報告しています。ツーリングインターフェースと操縦性: GPT-5.4は開発者メッセージによる操縦性が高く、外部ツール、コネクタ、APIをいつ・どのように呼ぶべきかをより良く判断できます。これは、不要またはリスキーなアクションを最小化する信頼性の高いマルチツールエージェントの構築に不可欠です。 実務的な影響: 「このスプレッドシートを開き、ピボットを計算し、スライドノートを生成する」といった自動化タスクが、失敗/再試行の回数や人的監督の負担を減らします。
3) 5段階の推論負荷レベルとエクストリームモード OpenAIは複数の推論負荷レベル を示しており、レイテンシ/コストと、より深い内部チェーンオブソート計算のトレードオフが可能です(非公式に xhigh や extreme reasoning と呼ばれることがあるモード)。これは、より深い熟考が正答性を実質的に高める問題(複雑な証明、長いコード変換、多段の財務分析)を想定しています。APIの料金と課金ロジックは、これらのモードでモデルが行う追加の計算作業を反映しています。
実務的な影響: 単一のモデルに「万能」を求めるのではなく、ワークロードに応じたトレードオフを選択できるようになります。
4) 生産性とコンテンツ作成
スプレッドシートモデリング: GPT-5.4は、監査、金融、分析ワークフローで使われるスプレッドシートタスクにおいて強い改善を示します。OpenAIは、GPT-5.4が社内の「投資銀行モデリング」様式のタスクで平均87.3%のスコアを記録(GPT-5.2は 68.4% )。数値モデリングや式構成のタスクレベル正確性が劇的に向上しています。プレゼンとビジュアル出力: GPT-5.4が生成したプレゼンテーションは、審査員に**68.0%**の割合でGPT-5.2のものより好まれました。美観、バリエーション、画像生成との統合の面で改善が見られ、スライド作成における内容と形式の双方が向上しています。文書ドラフティングと長文執筆: GPT-5.4は、長文書にわたる整合性の維持、引用の振る舞いの改善、巨大コンテキスト処理時の内部矛盾の低減に最適化されています。これは拡張されたコンテキストウィンドウと推論チューニングにより実現されています。
5) セーフティ、緩和策、サイバー考慮
ハルシネーションの減少: OpenAIは、ユーザーが事実誤りを指摘した匿名化プロンプトセットにおいて、GPT-5.4の個々の主張 が33%低い確率 で虚偽となり、全体の応答 が18%低い確率 で誤りを含むと報告しています(GPT-5.2比)。事実精度が重要なエンタープライズ導入における重要指標です。サイバーセキュリティ緩和策(Thinkingバリアント): GPT-5.4 Thinkingは、5.3/Codex系で用いられてきた保護を基に、ハイ・ケイパビリティの悪用シナリオに対する緩和策を拡張しています。
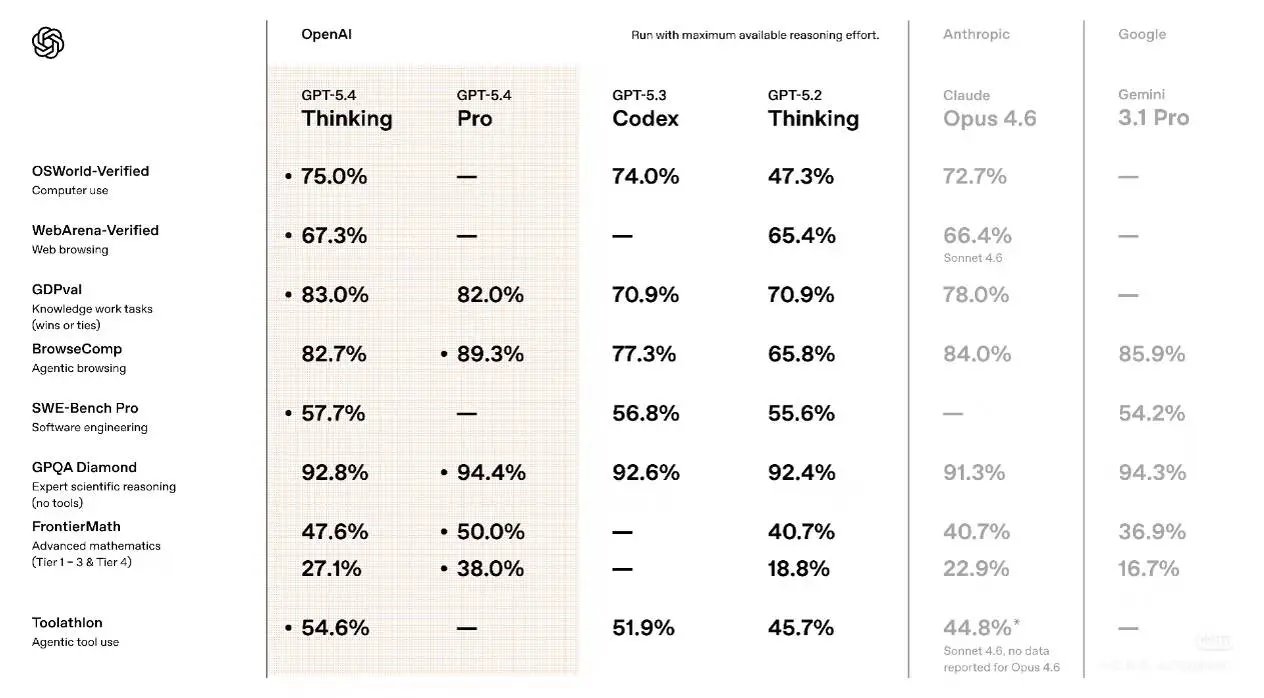
パフォーマンスベンチマーク — 数字が示すもの OpenAIと複数媒体が、ローンチに際して初期ベンチマーク結果を公開しました。ベンチマークは、ウェブナビゲーション、ドメイン知識、安全性などそれぞれ異なる能力を測るため、主要な数値を集約し、その意味を整理することが有益です。
報告結果は、従来のGPT-5.xファミリーに対して顕著な改善を示し、他のトップティアモデルとの接戦も見られます。
ウェブ/デスクトップ相互作用ベンチマーク
WebArena-Verified(ブラウザー利用テスト): GPT-5.4は、DOMとスクリーンショット信号を併用した場合67.3%の成功率 を達成(GPT-5.2は65.4% )。目に見える改善ですが圧倒的ではありません。これは、モデルがライブページやUI要素と相互作用するタスクを測定します。Online-Mind2Web(スクリーンショットベースのブラウザータスク): GPT-5.4は、スクリーンショット観測のみで**92.8%**の成功率に到達。従来のエージェント型ベースラインと比べて特に強い改善(OpenAIはChatGPT AtlasのAgent Modeと対比)。OSWorld-Verified(デスクトップナビゲーション): 独立報告では、GPT-5.4がデスクトップ環境のナビゲーションとタスク完了を評価するベンチマークで**75.0%**を記録。エンドツーエンド自動化タスクにおいて、多くの公開ベースラインを上回る位置付けとなりました。 要旨: 5.4の改善は、視覚コンテキスト、UIアフォーダンス、長いアクション列の理解が重要な場面(すなわちエージェント的ワークフロー)で最も顕著です。
ヘルス/セーフティ/知識ベンチマーク OpenAIの配備セーフティ報告は混在したシグナルを示します。
HealthBench: GPT-5.4は62.6% (GPT-5.2の63.3%からわずかに低下)。このスナップショット評価では、能力と特定の医療関連指標との間で微妙なトレードオフが示唆されます。Hard: GPT-5.4は「Hard」評価スイートで40.1% (42.0%からわずかに低下)。Consensus: GPT-5.4は「Consensus」で**96.6%**を記録(約2.1ポイントの上昇)。キュレーションされた合意回答への整合性を反映する指標です。 OpenAIは、ヘルス評価における平均応答長の変化にも言及しています(GPT-5.4は約3,311文字、GPT-5.2は2,676文字)。これは、モデルがセンシティブなトピックをどのように枠組み付けるかに影響します。
解釈: セーフティ/ヘルス指標は、5.4が全体として合意整合性を高め、応答の冗長性を変化させたことを示します。一方で、一部の限定的なヘルススコアがわずかに低下。これはしばしばモデル目標の再バランスを反映しており、より決定的で長文の回答がユーティリティと合意整合性を助ける一方、センシティブ領域では注意深いモニタリングが必要となることを示唆します。
ドメイン固有の事例と主張 初期テストは、具体的でドメイン化された主張を示しました(OpenAIおよび第三者情報源)。
Legal reasoning benchmark(BigLaw Bench) — GPT-5.4は初期テストで法的推論のスライスにおいて**約91%**を達成。文書分析タスクに有力なシグナル。ただしこれらは早期段階の、査読前の数値です。ハルシネーションの低減: GPT-5.4の応答は、特定の従来ベースラインと比較して、**約33%**虚偽主張を含む可能性が低く、**約18%**事実誤りを含む可能性が低いと報告されました。これらの割合は二次報告や企業コミュニケーションで強調されましたが、ベンチマークスイートとサンプリング方法論に依存します。
取得方法と料金 — GPT-5.4
ChatGPTのティアとエンタープライズアクセス
ChatGPT Plus / Team / Pro ユーザーが、製品内で最初にGPT-5.4 Thinkingを受け取りました。Enterprise およびEducation 管理者は、管理画面から早期アクセスを有効化可能。Free/Goユーザーは即時アクセスが保証されていません。開発者はAPI経由でgpt-5.4およびgpt-5.4-proエンドポイントを呼び出せます。
API料金スナップショット(公開開発者料金) OpenAIの開発者向け料金では、GPT-5.4はフロンティアモデルとしてトークン単価が設定されています。発表時点の公開料金ページに記載されたサンプルレートはおおよそ以下の通りです。
gpt-5.4 (<272K context length) $2.50 $0.25 $15.00 gpt-5.4 (>272K context length) $5.00 $0.50 $22.50 gpt-5.4-pro (<272K context length) $30.00 $180.00 gpt-5.4-pro (>272K context length) $60.00 $270.00
CometAPI(一括で大規模モデルAPIを集約するプラットフォーム)では:
gpt-5.4 Input:$2/M; Output:$16/M Input:$2.5/M; Output:$20/M -20% gpt-5.4-pro Input:$24/MOutput:$192/M Input:$30/MOutput:$240/M -20%
したがって、APIコストを大幅に削減できるため、CometAPIの利用を強く推奨します。
コスト管理の考慮事項 モデルを大規模に利用する、特に長文書や高スループット設定での利用を計画する場合は、以下を検討してください。
入力のキャッシュ化と重複排除 (可能な場合はキャッシュ済み入力料金の活用)プロンプトエンジニアリング によりコンテキストを圧縮し、冗長なトークンを回避バッチ戦略 や、出力生成のコストを最小化する後処理推論モードの利用監視 (深い推論モードは計算コストが高くなる可能性)
比較:GPT-5.4 vs GPT-5.3
GPT-5.3に対するGPT-5.4の改善点
推論の深さとツールオーケストレーション: 5.4 Thinkingは、多段推論とエージェント的ユースケースで5.3を上回るよう明示的にチューニングされています。これはウェブ/デスクトップ相互作用ベンチマークやエージェント成功指標に反映されています。コンテキスト容量: 5.4の100万トークン提供は、一般的なAPI提供において5.3を明確に超える技術的ステップであり、単一セッションでの新たなタスク群を可能にします。ドメイン性能の向上: OpenAIの初期数値や第三者報告は、法務や文書ベンチマークにおける改善を示しており、5.4の長大コンテキストと特化チューニングが寄与しています。
トレードオフと、5.3が依然として適する場面
軽量な会話用途: GPT-5.3 Instant は、迅速で経済的な会話フローに最適化されています。短いチャット対話で最小のレイテンシ/コストを求める組織には適しています。セーフティ指標の安定性: 一部のヘルスや「Hard」評価スコアは、OpenAIのスナップショットでは5.4が5.2よりわずかに低下を示しました。規制の厳しいセンシティブな領域のエンタープライズは、本格導入前に自社の評価スイートでモデル検証を行うべきです。
ユースケースと業界への示唆 GPT-5.4の、深い推論、長文脈メモリ、ツール使用の組み合わせは、実務的かつ戦略的な機会を多数もたらします。
1. プロフェッショナルサービス/コンサルティング 長大な成果物(例:法的文書、複数章のコンサルレポート、M&Aデューディリジェンス資料)をコンテキストに保持し、文書横断的な整合的統合、QAの自動化、チャンクの手動ステッチなしでのエグゼクティブサマリー生成が可能になります。APEX-Agentsのベンチマークでの勝利は、このポジショニングと整合しています。
2. ソフトウェアエンジニアリングとコードベース推論 より長いコンテキストにより、単一のモデル呼び出しにリポジトリ全体や長いログトレースを含められます。GPT-5.4のSWEベンチマーク改善は、デバッグ、リファクタリング、コードレビューのワークフローでの性能向上を示唆します。継続的負荷にはProとの併用が有効です。
3. 自律型エージェントとエンタープライズ自動化 ツール(スプレッドシート、チケッティングシステム、ウェブインターフェース)上で動作するエージェントシステムは、GPT-5.4の改善されたツール選択、エージェントワークフローのトークンオーバーヘッド削減、長期状態保持の向上の恩恵を受けます。これにより、複数システムにまたがるエンタープライズ自動化パイプラインや「行動するアシスタント」への適性が高まります。
結論 — GPT-5.4が変えること GPT-5.4は、長く、複数文書にわたる推論 を扱い、エージェント的ワークフロー をより高い信頼性で実行し、Proによる契約を通じてプロフェッショナルなパイプラインにスケール可能なモデルへと、実務的かつ能力主導の前進を示しています。ワークフローが長期的でツール依存の組織にとって、GPT-5.4は潜在的生産性の段階的な飛躍を意味します。
AIに関するさらなるヒント、ガイド、ニュースを知りたい方は、VK 、X 、Discord をフォローしてください!