
要約: FLUX 3 は Black Forest Labs の統合マルチモーダル基盤モデルです。一般公開されている Video API は、テキスト・画像・キーフレーム・既存動画から、最大20秒・24 fps のクリップを同期音声オプション付きで生成します。解像度は HD から UHD/4K まで対応。なお FLUX 3 Image とオープンウェイトの FLUX 3 Dev は別途のロールアウト項目です。
FLUX 3 とは?
FLUX 3 は Black Forest Labs によるフロンティア・マルチモーダルモデルです。画像用、動画用、音声用にそれぞれ独立したモデルを訓練するのではなく、BFL はこれらのモダリティをまたいだ共有表現を学習させます。
中心となる考え方は、画像・動画・音は同じ基底世界に対する異なる観測だということです。走る車には、見た目、動き、音、空間関係、材質特性、因果的ふるまいがあります。これらの信号をまとめて学習することで、単一のフレームだけを学ぶよりも多くの制約をモデルに与えられます。
このため Black Forest Labs は FLUX 3 を単なる画像・動画ジェネレーターではなく、リアリティモデル/ワールドモデルへの一歩と表現しています。公開済みの動画システムは、すでにその方向性を示しています。同期音声、モーション、シーン構造、セリフ、カメラ挙動、環境音が、ひとつの生成ワークフローで扱われます。
発表された FLUX 3 の全機能がすぐに一般公開されているわけではありません。2026年9月時点では FLUX 3 Video が利用可能で、FLUX 3 Image とオープンウェイトの FLUX 3 Dev は別途のロールアウト項目です。
FLUX 3 仕様(概要)
以下の仕様は、7月の初期構成ではなく、現在の FLUX 3 開発者ドキュメントに基づくものです。
| 仕様 | 公式 FLUX 3 ドキュメント |
|---|---|
| 開発元 | Black Forest Labs |
| モデルファミリー | FLUX 3 |
| モデル種別 | 統合型マルチモーダル基盤/生成動画モデル |
| 公開(動画) | 2026年8月4日 |
| 中核の学習方針 | 画像・動画・音声の共同表現学習 |
| 研究基盤 | Self-Flow |
| 現在の主要API出力 | 同期音声付き動画 |
| テキストから動画(T2V) | 対応 |
| 画像から動画(I2V) | 対応 |
| キーフレームから動画 | 対応 |
| 動画継続 | 対応 |
| 最大 T2V/I2V 長さ | 20秒 |
| 動画継続の長さ | 5–15秒 |
| フレームレート | 24 fps |
| 解像度 | HD、FHD、QHD/2K、UHD/4K |
| FHD 16:9 解像度 | 1920 × 1088 |
| 画像参照 | I2V/キーフレーム ワークフローで最大10枚 |
| ネイティブ音声 | はい |
| 多言語の対話 | はい |
| リップシンク | はい |
| マルチショット生成 | はい |
| ドラフトモード | はい |
| 公開済み静止画 FLUX 3 エンドポイント | BFL により一般提供は未実施 |
| FLUX 3 Dev(オープンウェイト) | 計画中 |
現在の BFL ドキュメントでは、テキスト/画像から動画生成は 5–20 秒、動画継続は 5–15 秒の生成ウィンドウと記載されています。サポートされるアスペクト比は 21:9、2:1、16:9、4:3、1:1、3:4、9:16 です。
FLUX 3 はどのように機能するのか?
Self-Flow
鍵となる研究基盤は、Black Forest Labs の自己教師ありフローマッチング手法 Self-Flow です。従来の生成トレーニングは、別個の事前学習表現モデルや補助的な教師を頼ることが多くありました。Self-Flow は、生成目的から直接有用な表現を学習する設計です。
主なメカニズムに Dual-Timestep Scheduling があります。学習時にトークングループごとに異なるノイズレベルを割り当て、情報の非対称性を作り出します。入力の一部は他より多くの有用情報を含み、ネットワークは欠けた情報を推定するための表現を構築せざるを得なくなります。
実務的には、FLUX 3 は個々のフレームの見た目を記憶するのではなく、物体・フレーム・動き・音・時間イベント間の関係を学ぶよう促されます。
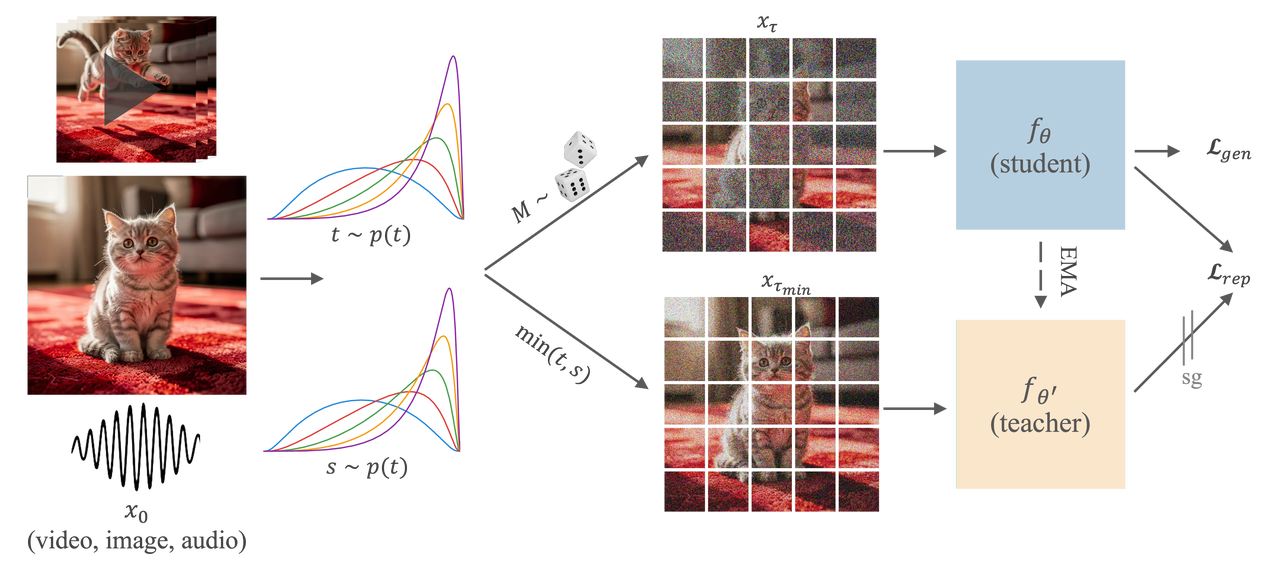
Self-Flow メソッドのアーキテクチャ - 公式画像出典: Black Forest Labs Self-Flow project
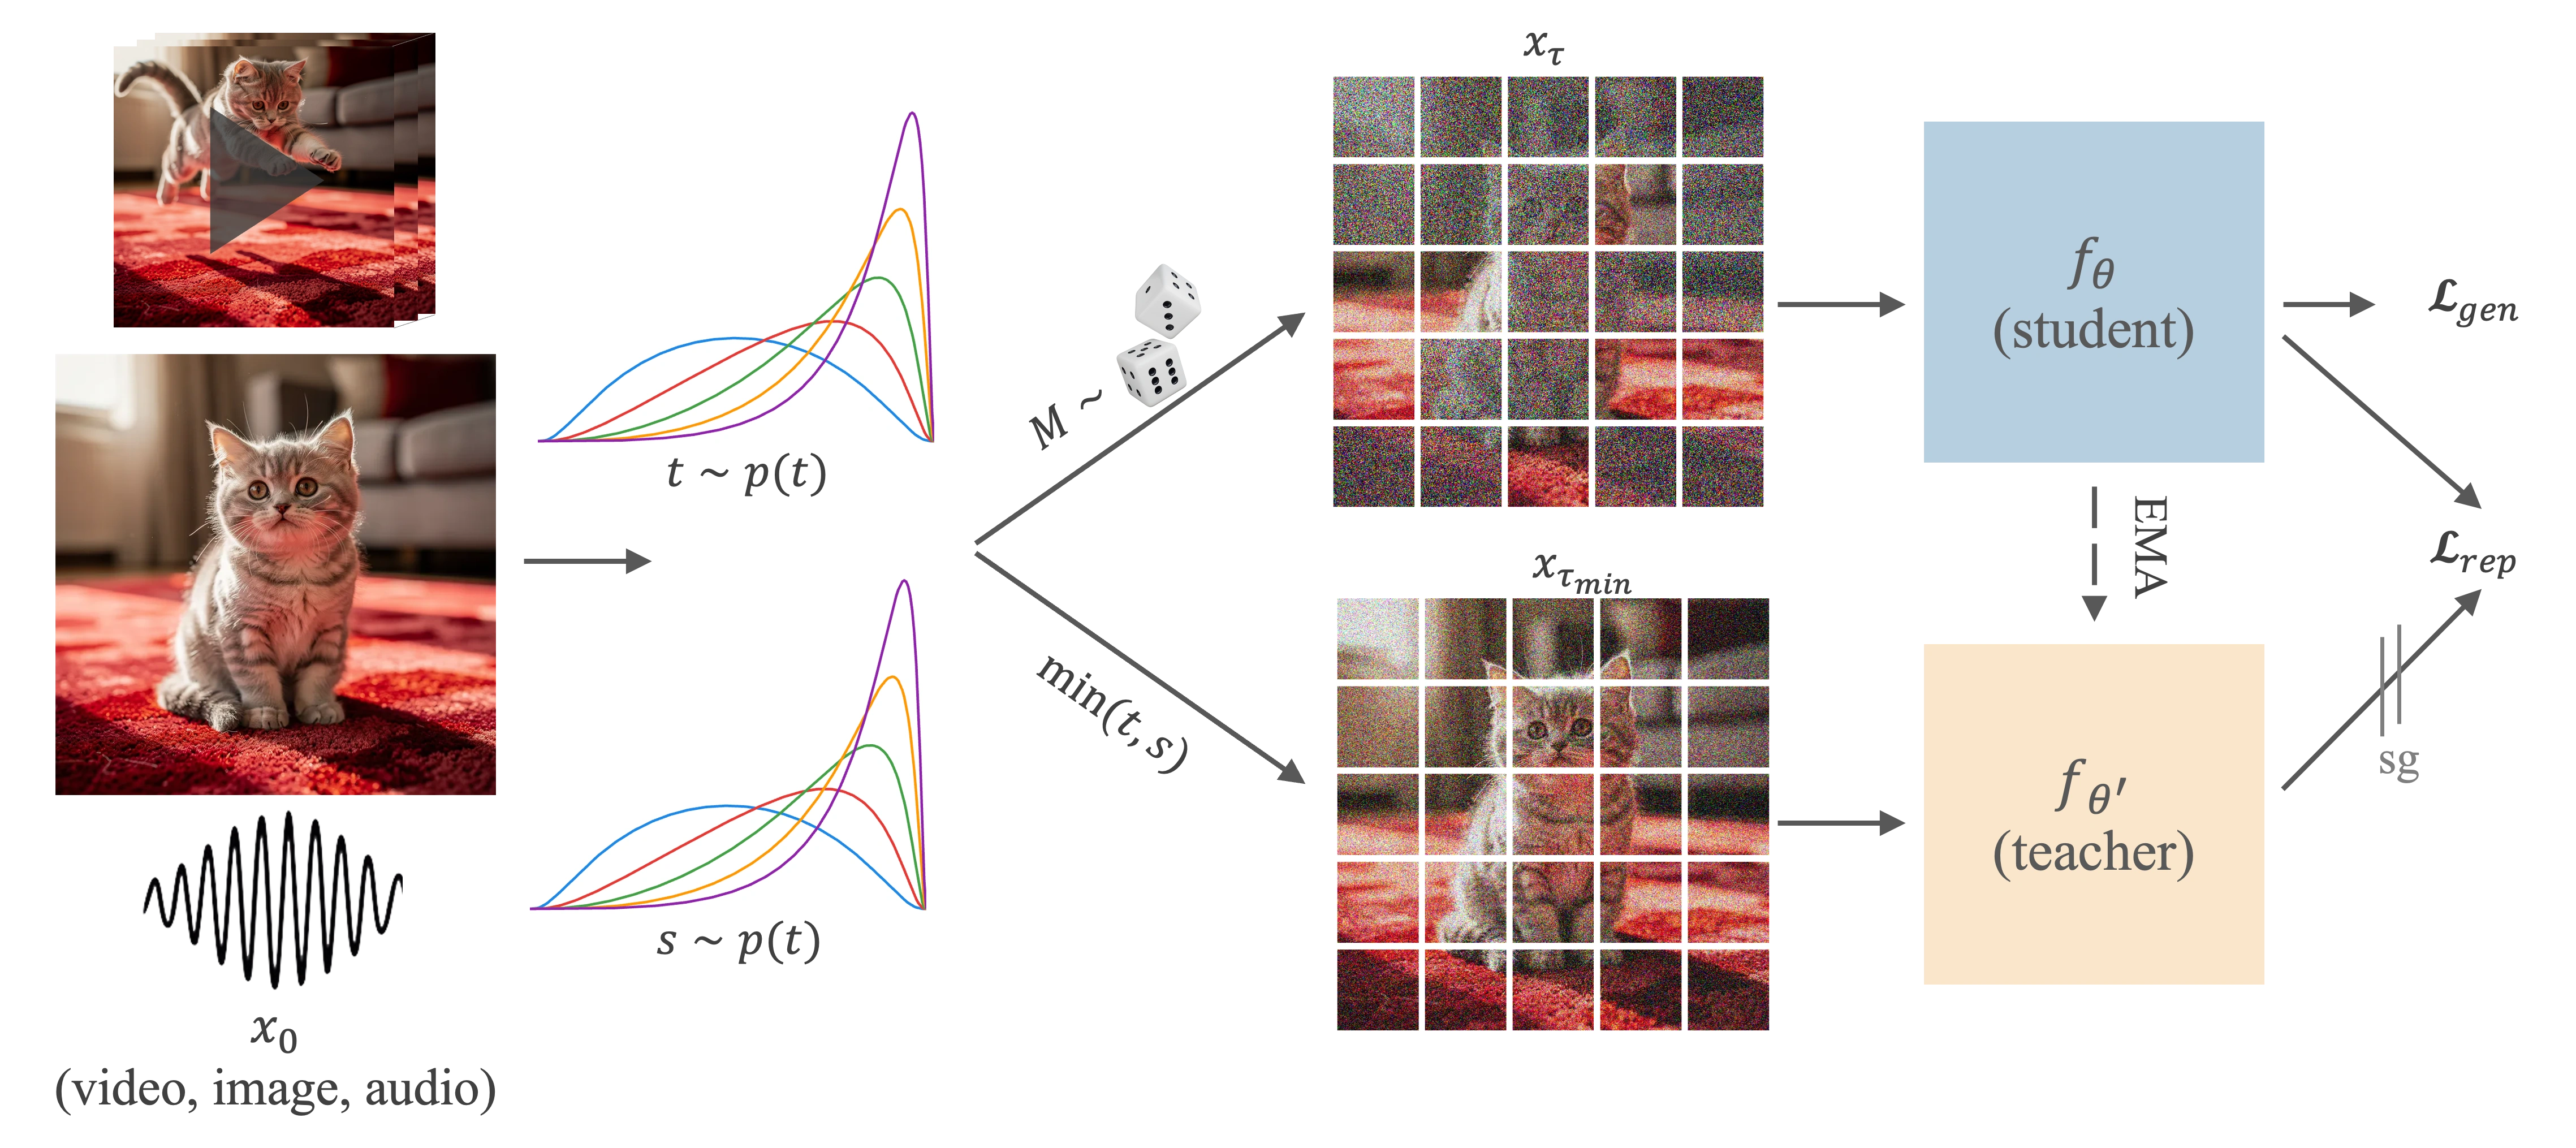
BFL は、FLUX.2由来のバックボーンに基づく共同マルチモーダルトレーニングも検証し、数百万本の動画と数億枚の画像で実験しました。これらの実験は、表現学習と生成が別個のシステムである必要はないという FLUX 3 の広い仮説を支持しています。
なぜ動画が FLUX 3 の中心なのか
動画は、静止画では得られない情報を含むため、ワールドモデリングに特に価値があります。単一フレームは床の上のボールを示せますが、動画はボールが落下し、弾み、衝突で変形し、音を立て、その後に方向を変えることを示せます。
BFL は、動画予測が FLUX 3 の学習計算資源の95%以上を占めると開示しています。音声は次元が低く可視イベントに密接に結びついているため比較的安価です。この配分は、動画が FLUX 3 の最初の一般提供機能となった理由を説明します。
FLUX 3 で何ができるのか?
テキストから動画
自然言語の指示から完全な動画を生成できます。BFL によれば、公開モデルはシンプルなプロンプトから複雑なプロンプトまで扱い、動き、シーンの論理、画作り、音を調和させます。単一の被写体アニメーションではなく、複数の連続イベントを含むプロンプトで特に有用です。
画像から動画とキーフレーム
FLUX 3 は開始画像をアニメーション化したり、終端フレームに向かって進行したり、複数の画像をタイミング付きキーフレームとして使用できます。現在の API は画像から動画のワークフローで最大10枚の画像参照をサポートし、モデルに全シーケンスの即興を任せるのではなく、時間変化のコントロールを可能にします。
動画継続
既存の動画とその音声をコンテキストとして供給し、FLUX 3 がその続きを生成できます。BFL は、継続時に動き、カメラ挙動、セリフ、音を保つと記述しており、これは2つの独立クリップを生成して連結するのとは本質的に異なります。
ネイティブ音声と対話
FLUX 3 は生成時に音声も同時に出力し、別の音声生成パスを必要としません。公開済みの音声機能にはセリフ、効果音、環境音が含まれます。多言語の対話とリップシンクにも対応しています。
1回の生成で複数ショット
単一のプロンプトに複数のシーンやカメラアングルを含められます。多くの従来動画モデルは、短く連続したショットで最も強みを発揮する傾向がありましたが、FLUX 3 は1回の生成内でのマルチショットに明示的に対応しています。
ドラフトモード
ドラフトモードは大量動画生成にとって実務的な追加機能です。すべてのプロンプト実験に正規価格を支払う代わりに、より速く低コストのプレビューを作成し、選んだドラフトを構図や動きを保ったまま高品質化できます。現在の BFL 価格によると、標準の T2V/I2V ドラフトは1秒あたり $0.06、通常の HD 生成は1秒あたり $0.17 です。
まだ出荷されていないものは?
FLUX 3 のローンチ発表は、画像・動画・音声・アクションを単一のアーキテクチャ方向で説明しましたが、提供は段階的です。
| 機能 | 現在の BFL ロードマップと提供状況 |
|---|---|
| FLUX 3 動画生成 | 一般提供 |
| ネイティブ動画音声 | 一般提供 |
| テキストから動画 | 一般提供 |
| 画像から動画/キーフレーム | 一般提供 |
| 動画継続 | 一般提供 |
| 画像/動画/音声参照のより豊富な組み合わせ | 拡張計画 |
| FLUX 3 画像生成と編集 | 近日提供 |
| FLUX 3 Dev オープンウェイト | 計画中 |
| アクション予測のデプロイ | 研究/商用パートナー向けトラック |
この区別は、FLUX.2 Max に慣れたユーザーには特に重要です。FLUX.2 は静止画生成の専用モデルとして現行オプションであり、公開中の FLUX 3 製品は動画と音声が中心です。
FLUX 3 のベンチマーク性能
現在、参考になる FLUX 3 のベンチマークには2種類あります。BFL の公開後の内部評価と、独立した第三者評価です。前者は BFL のプロトコルにおける相対的人間嗜好を示し、後者は独自設計のベンチマークでも同様の強みが見えるかを確認します。
BFL 公開後の ELO 評価
初期の7月発表には暫定勝率が含まれていました。現行ユーザーにより関連するのは、8月4日の公開モデル評価です。Black Forest Labs は、内部の総当たり評価でテキストから動画の ELO スコア 1135 を報告しています。
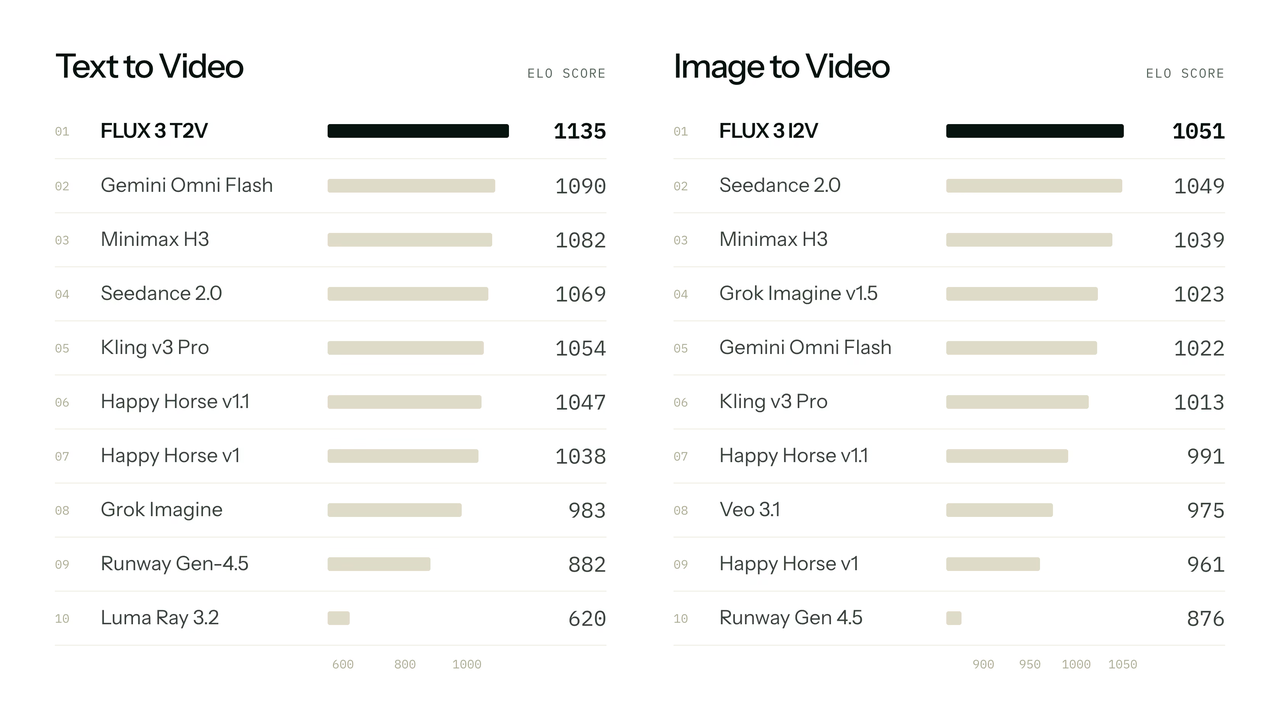
FLUX 3 公開モデルの ELO 評価 - 公式画像出典: Black Forest Labs
| 指標 | BFL 公開モデル評価 |
|---|---|
| テキストから動画 ELO | 1135 |
| T2V の位置づけ | BFL のテスト群における最高スコア |
| 画像から動画の結果 | 最強の競合と同等、他の評価対象モデルを上回る |
| 評価タイプ | 内部の人間嗜好評価 |
| モデル段階 | 一般提供中の FLUX 3 Video リリース |
これは、8月の公開モデルを評価している点で初期ローンチ時のベンチマークより強い証拠です。ただしベンダー主導の評価であることは変わらないため、FLUX 3 があらゆるプロンプトカテゴリーで常に全競合を上回る証明と解釈すべきではありません。
独立ベンチマーク(Megaton)
Megaton の v-benchmark v2 は独立の検証として有用です。FLUX 3 は2026年8月に評価され、現在の公開セットにおいて 76.51/100 の Megaton Index を記録し、当時のランキングで第3位です。
| ベンチマーク次元 | Megaton による FLUX 3 評価 |
|---|---|
| Megaton Index | 76.51 |
| プロンプト遵守 | 87.07 |
| シーン一貫性 | 94.76 |
| 物理 | 70.63 |
| 人間表現忠実度 | 73.70 |
| 物体・製品忠実度 | 83.82 |
| 因果・意味的一貫性 | 80.91 |
| テキスト忠実度 | 82.41 |
| シネマトグラフィ | 71.43 |
| テイストとアートディレクション | 65.00 |
総合スコアよりもプロファイルが示唆的です。シーン一貫性 94.76 が主要カテゴリで最も強く、プロンプト遵守、物体忠実度、因果的一貫性、テキスト忠実度も 80 超です。一方で物理・人間表現・テイスト/アートは弱く、時間表現の強化だけでは合成的な動きや芸術的品質のばらつきがなくならないことがわかります。
このため結論が異なり得ます。BFL の内部嗜好テストでは比較セットのトップである一方、Megaton の独立リーダーボードでは第3位です。プロンプト、評価軸、評価者層、集計方法の違いが順位差を生みます。
FLUX 3 vs Seedance 2.5 vs MiniMax H3 vs Wan 3.0
2026年、AI 動画市場は急速に進化しました。FLUX 3 は、長尺生成、同期音声、参照、編集を統合するマルチモーダルシステムと競合しています。
| 次元 | FLUX 3 | Seedance 2.5 | MiniMax H3 | Wan 3.0 |
|---|---|---|---|---|
| 開発元 | Black Forest Labs | ByteDance Seed | MiniMax | Alibaba |
| 最大広告クリップ長 | 20 s | 30 s | 15 s | 30 s |
| 動画解像度 | HD / FHD / QHD (2K) / UHD (4K) | API ティアに依存 | 最大 2K | 最大 1080p |
| ネイティブ音声 | はい | はい | はい(ステレオ) | はい |
| テキストから動画 | はい | はい | はい | はい |
| 画像/参照入力 | はい | はい | はい | はい |
| キーフレーム/参照コントロール | タイミング付きキーフレームが強力 | 参照駆動と編集に強い | マルチモーダル条件付け | マルチモーダル参照コントロール |
| 動画継続/編集 | 継続に対応 | 編集指向ワークフロー | オムニ生成重視 | 編集と参照ワークフロー |
| マルチショット生成 | はい | はい | はい | はい |
| 特徴的な強み | リアリティモデル設計、シーン一貫性、Self-Flow | 長編ストーリーテリングと参照コントロール | 2K オーディオビジュアル生成とオムニモーダル文脈 | 長尺クリップと低い開始コスト |
| CometAPI 開始/単価価格* | $0.136/s | $0.0824/s 掲載 | $0.064/s | $0.040/s |
* 価格は概算の比較です。動画 API は解像度、長さ、品質ティア、課金ルールが異なるため、最安の秒単価が必ずしも同品質の最安出力を意味しません。
FLUX 3 と Seedance 2.5 の比較
Seedance 2.5 は最大30秒生成の優位があり、FLUX 3 の20秒より長尺です。参照駆動生成、編集、長編ストーリーテリングに強く指向されています。FLUX 3 は、共有ワールドモデル設計、シーン一貫性、ネイティブな音声・映像生成、タイミング付きキーフレーム、広い画像/アクションのロードマップで差別化します。
独立評価でもハイエンドの競合であることが裏付けられており、Megaton は現状でSeedance 2.5 を FLUX 3 より上位に置いています。
FLUX 3 と MiniMax H3 の比較
MiniMax H3 は最大 2K 出力とネイティブのステレオ音声を備え、オーディオビジュアルの技術仕様で強みがあります。FLUX 3 は最大生成時間が長く(H3 の 15 秒に対して 20 秒)、ドラフトモードによりコストを抑えた反復ワークフローを提供します。
FLUX 3 と Wan 3.0 の比較
Wan 3.0 は広範なマルチモーダル入力、オーディオビジュアル生成、編集、最大30秒のクリップを重視します。CometAPI 掲載の開始価格も安価です。FLUX 3 はより高価ですが、リアリティモデルのポジショニング、シーン一貫性、Self-Flow の研究基盤、ドラフトモード、アクション予測との統合で差別化します。
FLUX 3 の価格
Black Forest Labs は生成された動画の長さに応じて課金します。
| モード | 公式 BFL FLUX 3 価格 |
|---|---|
| T2V / I2V ドラフト HD | $0.06/s |
| T2V / I2V HD | $0.17/s |
| T2V / I2V FHD | $0.29/s |
| T2V / I2V QHD (2K) | $0.40/s |
| T2V / I2V UHD (4K) | $0.80/s |
| 動画継続 ドラフト | $0.12/s |
| 動画継続 HD | $0.41/s |
| 動画継続 FHD | $0.53/s |
| 動画継続 QHD (2K) | $0.65/s |
| 動画継続 UHD (4K) | $0.95/s |
標準的な10秒の HD 生成は、BFL 掲載レートで約 $1.70、10秒の FHD 生成は約 $2.90 となります。動画継続は通常の生成より秒単価が大幅に高いため、クリップ拡張を頻繁に行うアプリケーションでは別途コストモデル化が必要です。
CometAPI における FLUX 3 価格
CometAPI は現在、モデル ID flux-3 として FLUX 3 の提供を掲載しています。
| 解像度 | CometAPI FLUX 3 価格 |
|---|---|
| 720p | $0.136/s |
| 1080p | $0.232/s |
10秒の生成では、720p が約 $1.36、1080p が約 $2.32 に相当します。BFL 掲載の $0.17/s と $0.29/s と比較すると、これら2ティアのデフォルト CometAPI 価格は約20%低くなっています。
提供状況に関する注記: CometAPI 上の一部の旧記述は 7月の Early Access 期を反映しています。現在の ライブのモデルカード、価格欄、API 例では flux-3 が Available とされ、CometAPI のリリース日は 2026年8月13日です。統合判断には旧い提供状況コピーよりも、ライブの API と価格フィールドが有用です。
なぜ FLUX 3 は AI 動画を超えて重要なのか
FLUX 3 の特異性は「20秒の動画生成」そのものではありません。同等以上の長さを生成できる競合はすでに存在します。より大きな技術的賭けは、強力な動画表現が他の知能形態の基盤になり得るという点です。
動画予測からアクション予測へ
ロボット制御信号は、視覚観測に条件付けられた時系列予測です。BFL は FLUX 3 の動画表現をアクション予測の基盤として用いています。mimic robotics との協業で生まれた FLUX-mimic では、アクションデコーダが独立の知覚スタックを訓練する代わりに動画モデルの表現を読み取ります。
BFL は、FLUX-mimic のバックボーンが単一の RTX 5090 で80 ms 未満で動作し、ロボットシステム全体の反応ループは約 101 ms に達すると報告しています。同社は Audi との産業評価についても言及しています。
これは公開中の FLUX 3 Video API がロボティクス API であることを意味しませんが、BFL が動画生成を孤立したメディアタスクではなく、マルチモーダル動画表現に重点投資した理由を示しています。
FLUX 3 の主な強みは?
- 時間的・シーンの一貫性。Megaton のシーン一貫性 94.76 は主要カテゴリで最強。
- ネイティブな音声・映像の同時生成。セリフ、効果音、環境音、映像を個別モデルの後付けではなく一体で生成。
- 強いプロンプト遵守。独立評価の 87.07 は見た目の美しさを超えた強みを示唆。
- キーフレーム制御。現行の画像から動画ワークフローで最大10枚の画像が時間制御に参加可能。
- ドラフトから本番へのワークフロー。ドラフトモードは反復時のコスト問題に実務的に対処。
- 広いビジュアルレンジ。生々しい・自然・シネマティック・ノスタルジック・遊び心・スタイライズ・実験的など固定のハウススタイルに限定されない。
- ワールドモデル研究の方向性。Self-Flow とアクション予測により、メディア生成を超える関連性。
FLUX 3 の制約は?
- マルチモーダルの全ロードマップは未出荷。公開中の FLUX 3 Image や FLUX 3 Dev オープンウェイトを家族名から当然視しないこと。
- 20秒は最長ではない。2026年の一部競合はすでに 30 秒生成に対応。
- 物理は未解決。Megaton の物理スコア 70.63 はシーン一貫性よりかなり低い。
- 人間表現は改善余地あり。独立スコア 73.70 は難度の高い解剖学やリアルな人間動作に失敗があり得ることを示す。
- 動画継続は高価。BFL の継続価格は通常の T2V/I2V より秒単価が大幅に高い。
- BFL の主な競合比較は内部評価。実運用の判断には、固有のプロンプト・ショットタイプ・言語・参照アセットでの独自テストも必要。
CometAPI で FLUX 3 を使う方法
CometAPI の以前の FLUX 3 紹介は 7月の Early Access、暫定ベンチマーク、計画ロールアウトを説明しています。本セクションは現行の本番統合、価格、実動 API フローに焦点を当て、過去の説明は繰り返しません。本番モデルの FLUX 3はモデル ID flux-3 を使用します。
基本的な 720p リクエストは /v1/videos エンドポイントを使います。
Bash
curl --request POST "https://api.cometapi.com/v1/videos" \--header "Authorization: Bearer $COMETAPI_KEY" \ --form-string "model=flux-3" \ --form-string "prompt=穏やかな朝の光の中、紙の船が静かな池の上を滑るように進む" \ --form-string "seconds=5" \ --form-string "size=1280x720" |
|---|
動画ワークフローは非同期です。初回リクエストがタスク ID を返した後、生成完了までアプリケーションがタスクをポーリングし、その後に生成動画を取得します。本番アプリケーションでは、生成は通常、HTTP リクエストを全レンダリング時間保持するのではなく、バックグラウンドジョブやタスクキューで処理するのが望ましいです。
FLUX 3 を使うべきユーザーは?
5秒の見栄えの良いクリップ以上を必要とする用途に特に適しています。同期した映像と音声が必要な広告システム、自動短尺制作、物体の持続性が重要な製品デモ、多言語の対話生成、絵コンテから動画へのワークフロー、キーフレーム制御アニメーション、教育コンテンツ、より長いマルチモーダルパイプラインの実験などです。
最安の秒単価のみが要件の場合、1パスで 20 秒を超える生成が必須の場合、あるいは静止画生成が主目的の場合には魅力が薄れるかもしれません。静止画については、現行の FLUX 画像モデル(例: FLUX.2 Max)が適する可能性があります。
FLUX 3 は他の AI 動画モデルより優れているのか?
すべてのユースケースで単一の決定的な答えはありません。BFL の内部評価では、公開済み FLUX 3 がテキストから動画の比較でトップに位置する一方、独立した Megaton の評価では、FLUX 3は新しい競合の後塵を拝し第3位です。両方の結果が妥当であり得るのは、測定するプロンプト分布や品質次元が異なるためです。
シーン一貫性、プロンプト遵守、物体忠実度、因果的一貫性、テキスト描画、同期音声、コントロール可能なキーフレームが重要な場合、FLUX 3 は特に強いように見えます。最大長、解像度、アート嗜好、人間表現、編集ワークフロー、コストでは他モデルが勝ることもあります。開発者にとって正しい比較は、リーダーボードではなく、ワークロード固有の比較です。
よくある質問
FLUX 3 は今すぐ使えますか?
はい。FLUX 3 Video は 2026年8月4日に BFL から一般提供になりました。CometAPI でも Available としてモデル ID flux-3 が掲載されています。静止画の FLUX 3 リリースと FLUX 3 Dev のオープンウェイトは別途のロードマップ項目です。
FLUX 3 は音声を生成できますか?
はい。FLUX 3 Video は同期ネイティブ音声(セリフ、環境音、効果音)を生成します。多言語の対話とリップシンクにも対応しています。
FLUX 3 の動画はどれくらい長くできますか?
現在のテキストから動画・画像から動画は 5–20 秒に対応。動画継続は 5–15 秒の新規生成に対応します。
どの解像度をサポートしていますか?
BFL は HD(フレームあたり最大 1 メガピクセル)、FHD(最大 2 MP)、QHD/2K(最大 4 MP)、UHD/4K(最大 8 MP)をサポートします。16:9 の FHD 出力は 1920 × 1088 です。解像度帯はアスペクト比ではなく総ピクセル数に基づきます。ドラフトモードは HD のみです。
画像から動画は対応していますか?
はい。画像から動画とキーフレーム生成は一般提供中の FLUX 3 Video の機能です。
FLUX 3 は画像生成モデルですか?
アーキテクチャ的には、FLUX 3 は画像・動画・音声をまたいで学習されており、BFL は画像生成・編集の研究も示しています。しかし、FLUX 3 Image 製品は今後のリリースであり、家族のロードマップと現在公開中の FLUX 3 Video API を混同しないでください。
FLUX 3 はオープンソースですか?
現時点では違います。BFL はFLUX 3 Dev というオープンウェイトのマルチモーダル変種を発表していますが、公開日程はまだ公表していません。
料金はいくらですか?
BFL はテキスト/画像から動画をドラフト HD $0.06/s、HD $0.17/s、FHD $0.29/s、QHD $0.40/s、UHD $0.80/s と掲示。動画から動画はドラフト HD $0.12/s、HD $0.41/s、FHD $0.53/s、QHD $0.65/s、UHD $0.95/s です。CometAPI は現在 720p $0.136/s、1080p $0.232/s を掲載しています。
Self-Flow とは?
Self-Flow は BFL の自己教師ありフローマッチング手法です。外部の表現モデルに依存せず、生成モデルが有用な内部表現を育成できるよう設計されています。トークン間で異なるノイズレベルを用いることで、欠損情報の推定を促し、マルチモーダル観測間の関係性を学ばせます。
FLUX 3 はワールドモデルですか?
Black Forest Labs は、FLUX 3 をオーディオビジュアル予測から物理的アクション予測へと広がるリアリティモデル基盤と位置づけています。汎用の完全なワールドモデルと呼ぶのは現状の証拠より強い表現であり、より正確にはワールドモデリング目標を明示的に据えたマルチモーダル生成基盤モデルといえます。
まとめ
FLUX 3 は、従来の FLUX 画像モデルからの単純なアップグレード以上の変化を Black Forest Labs にもたらします。鍵となる発想は、世界の共有マルチモーダル表現を学習し、その表現を動画・音・画像・最終的にはアクションに用いることです。Self-Flow が研究基盤を提供し、公開された FLUX 3 Video はその戦略の最初の本番デモです。
2026年9月時点で、FLUX 3 Video は最大20秒・24 fps、HD~UHD/4K 出力、同期音声、多言語の対話、画像から動画、キーフレーム、動画継続、マルチショット生成、ドラフトモードをサポートしています。
ベンチマークもローンチ時より信頼性が増しています。BFL の現行公開モデル評価では内部 T2V ELO テストで首位、独立の Megaton では総合3位で、特にシーン一貫性の強さが際立ちます。
したがって FLUX 3 があらゆるワークロードで自動的に最良というわけではありません。Seedance 2.5、MiniMax H3、Wan 3.0 は、より長い生成、名目上の高解像度、低価格、異なる参照・編集機能を提供し得ます。
FLUX 3 を特に興味深くするのは、動画ジェネレーターの下にある方向性です。BFL は、説得力のある動画を予測するために必要な同じ表現が、将来的に画像生成、音声、物理推論、ロボットアクションを支え得ると見ています。開発者は、CometAPI のモデル ID flux-3 を通じて、すでにその最初の本番ステップを試すことができます。