
TL;DR
Claude Haiku 5.5와 GPT-6 Luna는 대규모 API 워크로드를 위한 저비용 추론 모델입니다. 두 모델 모두 입력 토큰 100만 개당 $0.10, 출력 토큰 100万 개당 $0.50에서 시작합니다. Haiku는 Anthropic의 출시 자료에 게시된 6개 비교에서 더 높은 점수를 기록합니다. Luna는 Haiku의 100K 임계값과 달리 입력 토큰 272K까지 기본 요금을 유지합니다. 개발자에게 핵심 지표는 승인율, 엔드투엔드 지연 시간, API 호환성, 그리고 승인된 결과당 비용—사전에 정의한 검사에 통과한 출력 수로 모든 시도의 총비용을 나눈 값—입니다.
Key Takeaways
- Haiku 5.5는 인용된 OSWorld 2.1 컴퓨터 사용 비교에서 72.4%로 Luna의 48.9%를 앞섭니다.
- Terminal-Bench 4.0에서 인용된 결과는 Haiku 39.2%, Luna 16.4%입니다.
- 두 모델의 단문맥 가격은 동일하지만, Haiku의 높은 가격 티어는 100K 프롬프트 토큰 초과부터 적용되며, Luna는 272K까지 기본 요금이 유지됩니다.
- Artificial Analysis의 최대 노력 기준 모델 페이지(2026년 10월 9일 확인)에서 Haiku의 출력 속도는 240.6 tokens/s, Luna는 123.0 tokens/s로 기재되어 있습니다. 처리량은 첫 토큰 대기 시간을 제외합니다.
- 공개된 벤치마크에 반영된 컴퓨터 사용 및 터미널 작업은 Haiku로 시작하세요. 대형 프롬프트에는 Luna를 고려하세요. 대표 파일럿에서 유의미한 개선이 확인될 때까지 현재 모델을 유지하세요.
What Are Claude Haiku 5.5 and GPT-6 Luna?
Claude Haiku 5.5: Overview
Claude Haiku 5.5는 2026년 10월 7일 출시되었습니다. 저렴한 추론 비용과 조정 가능한 추론, 도구 사용, 긴 컨텍스트, 텍스트·이미지 입력을 결합합니다. 일반적인 사용례로 문서 추출, 데이터베이스 쿼리, 고객 지원, 경량 서브에이전트가 있습니다.
GPT-6 Luna: Overview
GPT-6 Luna는 2026년 9월 22일 출시되었습니다. 분류, 정보 추출, 구조화된 출력, 프로그래밍 지원, 장문서 처리 등 규모화된 집중 작업을 위한 모델로 포지셔닝되어 있습니다. 유연한 추론 설정을 제공하며, 단순 작업용 비추론 구성도 포함합니다.
Specifications
| Specification | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Developer | Anthropic | OpenAI |
| Release | October 7, 2026 | September 22, 2026 |
| Model ID | claude-haiku-5-5 | gpt-6-luna |
| Context window | 1,000,000 tokens | 1,050,000 tokens |
| Maximum output (standard API) | 128,000 tokens | 128,000 tokens |
| Input | Text and image | Text and image |
| Output | Text | Text |
| Reasoning | Adjustable, Low to Max | None to Max |
| Default effort | Medium | Medium |
| Knowledge cutoff | June 2026 | May 18, 2026 |
| Tool use | Yes | Yes |
| Structured output | Yes | Yes |
| Open weights | No | No |
| Architecture and parameter count | Not specified in the cited official materials | Not specified in the cited official materials |
명세는 벤더의 표준 API 모델 문서를 기반으로 합니다(2026년 10월 9일 확인): Haiku의 표준 API 명세와 Luna의 표준 API 명세. 아키텍처와 파라미터 수는 해당 자료에서 확정되지 않았으므로 명시하지 않았습니다.
Claude Haiku 5.5 vs GPT-6 Luna: Benchmark Results
| Benchmark | Haiku 5.5 | GPT-6 Luna | Leader |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1,620 | 1,437 | Haiku +183 |
| AA-Briefcase v1.1 (Elo) | 1,578 | 1,336 | Haiku +242 |
| OSWorld 2.1, offline partial score | 72.4% | 48.9% | Haiku +23.5 pp |
| Terminal-Bench 4.0 | 39.2% | 16.4% | Haiku +22.8 pp |
| FrontierCode 1.1 Main | 46.4% | 42.4% | Haiku +4.0 pp |
| Chartography, no tools | 46.4% | 29.1% | Haiku +17.3 pp |
위 6개 행은 Anthropic의 출시 비교 결과(2026년 10월 9일 확인)를 재현한 것입니다. 이는 Anthropic가 게시한 비교(독립 결과의 재현 포함)이며, 본 문서를 위해 새로 수행한 테스트가 아닙니다. GDPval-AA와 AA-Briefcase는 Elo 점수이며, 퍼센트 격차는 퍼센트포인트입니다. 이 벤치마크 계열은 상이한 작업을 측정하므로 하나의 보편적 승자를 평균으로 낼 수 없습니다.
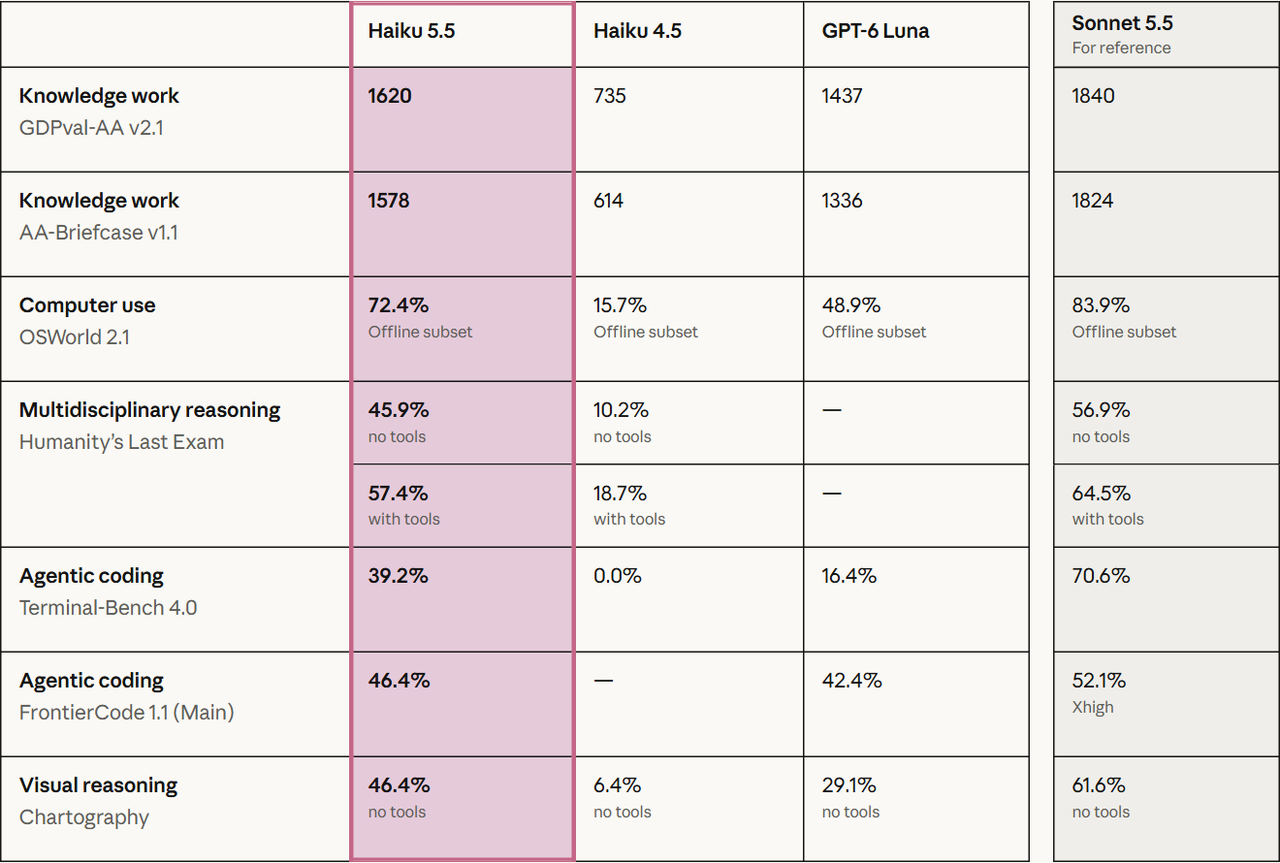
이 출시 표에서 Haiku가 상대적으로 가장 강한 영역은 시각적 컴퓨터 상호작용과 터미널 기반 작업입니다. FrontierCode에서의 격차가 더 작다는 점은 모든 코딩 상황에 20포인트 격차를 단정적으로 외삽해서는 안 됨을 시사합니다. 이 결과를 파일럿 후보 선별에 활용하고, 이후 프롬프트와 도구 스택으로 검증하세요.
Reasoning Effort and Evaluation Limits
추론 노력 수준은 정확도–비용 간의 트레이드오프를 바꿉니다. 동일한 워크로드와 하니스로 가능한 설정을 비교하세요. 벤더 간 설정 이름이 같다고 해서 추론 토큰 예산이 동일하다는 보장은 없습니다. 출시 표는 OSWorld의 오프라인 하위집합과 도구 미사용 Chartography 결과를 보고합니다. 하니스, 작업 선택, 재시도, 도구 접근 여부가 결과를 바꿀 수 있습니다. Anthropic의 시스템 카드는 벤치마크별 조건을 문서화합니다. Anthropic의 시스템 카드에서 벤치마크 방법을 확인하세요.
- OSWorld는 82개 작업의 오프라인 하위집합, Ubuntu 가상 머신, 1080p 스크린샷, 500-액션 제한, 최대 노력, 작업당 5회 시도를 사용합니다. 72.4%/48.9% 비교는 부분 점수이며, 작업을 완벽히 완료한 비율이 아닙니다. Haiku의 엄격 통과율은 37.1%입니다. Anthropic은 동일한 작업 하위집합을 OpenAI의 API를 통해 Luna로 실행했습니다.
- Terminal-Bench는 66개의 컨테이너화된 작업을 사용합니다. Haiku는 인터넷 이그레스나 폴백 모델 없이 Claude Code bare 모드에서 최대 노력으로 실행되었고, 작업당 평균 10회 시도했습니다.
- FrontierCode Main은 100개 작업에 대해 작업당 5회 실행합니다. Claude 모델은 Claude Code를, GPT 모델은 Codex를 사용했습니다.
- GDPval-AA와 AA-Briefcase는 Artificial Analysis가 독립적으로 평가했으며, 출시 자료에 재현되었습니다. 이는 단일 프로덕션 하니스가 아니라 별도의 평가 파이프라인입니다.
Claude Haiku 5.5 vs GPT-6 Luna: Feature Comparison
Computer Use and Agentic Coding
Haiku의 가장 큰 강점은 그래픽 컴퓨터와 상호작용하거나 터미널에서 작업하는, 공유 출시 작업 유형에서 나타납니다. OSWorld의 부분 점수 격차는 23.5퍼센트포인트이고, Terminal-Bench의 차이는 22.8포인트입니다. FrontierCode의 4.0포인트 격차는 코딩을 단일 워크로드로 다루지 말아야 함을 보여줍니다.
브라우저 자동화의 경우 페이지 탐색, 폼 입력, 도구 실패 복구, 엔드투엔드 완료를 테스트하세요. 코딩의 경우 패치가 저장소의 기능 검사를 통과하고 범위를 벗어나지 않는지 확인하세요. 이러한 승인 검사가 가장 큰 헤드라인 격차로 모델을 고르는 것보다 유용합니다.
Long Context and Document Processing
공식 컨텍스트 용량의 5% 차이는 대용량 프롬프트를 처리하는 신뢰성과 가격만큼 중요하지 않습니다. 컨텍스트 창이 더 크다고 해서 모델이 정보를 더 잘 회수하는 것은 아닙니다.
핵심 차이는 높은 요금이 적용되는 시점입니다. 150K 토큰 프롬프트는 Haiku의 임계값을 넘지만 Luna의 기본 티어 안에 머뭅니다. 따라서 해당 토큰 워크로드에서는 Luna가 더 낮은 비용의 시작점입니다. 다만 더 나은 문서 분석 모델인지는 추출 정확도, 인용, 그리고 수용 가능한 답을 얻기 위한 재시도 횟수에 달려 있습니다.
Reasoning Controls
두 모델은 조정 가능한 추론 노력을 제공하며, 인용된 문서에서 기본값은 Medium입니다. Luna는 none 설정도 노출합니다. 작업에 맞춰 이 제어를 사용하세요. 추출과 라우팅은 불확실한 다단계 도구 워크플로보다 적은 추론이 필요할 수 있습니다. 동일한 노력 레이블이 벤더 간 동일한 연산 예산을 의미하지는 않습니다.
Multimodal Input and Structured Workflows
두 모델 모두 텍스트와 이미지를 입력으로 받고 텍스트를 출력합니다. 이는 스크린샷, 문서 이미지 추출, 구조화된 다운스트림 워크플로에 후보가 될 수 있음을 의미합니다. 입력 지원만으로 작은 텍스트, 차트, 시각 인터페이스에서의 정확도가 동일하다는 뜻은 아닙니다. 해당 사례는 별도로 측정하세요.
Speed and Task Economics
| Independent metric (max effort) | Haiku 5.5 — Artificial Analysis | GPT-6 Luna — Artificial Analysis |
|---|---|---|
| Intelligence Index v4.3.2 | 43 | 38 |
| Output speed | 240.6 tokens/s | 123.0 tokens/s |
| Weighted cost per Intelligence Index task | $0.21 | $0.07 |
Artificial Analysis는 독립 테스트 발행사입니다. 이 표는 공식 벤더 성능이 아니라 2026년 10월 9일 확인된 최대 노력 기준 모델 페이지의 스냅샷입니다. 출력 속도는 생성이 시작된 이후 수신한 토큰을 측정하며, 첫 토큰까지의 시간과 전체 작업 지연 시간과는 구분됩니다. 작업당 비용은 Intelligence Index의 가중 메트릭으로, 귀하의 프로덕션 작업 견적이나 성공 결과당 비용을 의미하지 않습니다.
Haiku의 스냅샷 출력 처리량은 Luna의 약 1.96배이지만, Luna의 가중 평가 작업 비용은 더 낮습니다. 이는 전체 작업 완료 시간에서 1.96배의 우위를 입증하지 않습니다. 프로덕션 테스트에서는 첫 토큰 시간, 완료 시간, 출력 길이, 추론 소비, 도구 실행 시간을 각각 기록하세요.
Claude Haiku 5.5 vs GPT-6 Luna: Pricing and API Access
Official Standard Rates
| USD per 1M tokens | Haiku ≤100K | Haiku >100K | Luna ≤272K | Luna >272K |
|---|---|---|---|---|
| Input | $0.10 | $0.50 | $0.10 | $0.20 |
| Cached read | $0.01 | $0.05 | $0.01 | $0.02 |
| Cache write (Haiku: 5-minute TTL) | $0.125 | $0.625 | $0.125 | $0.25 |
| Output | $0.50 | $2.50 | $0.50 | $0.75 |
표준 처리 요율 기준 USD/100만 토큰(2026년 10월 9일 확인). 표는 Haiku의 표준 요율과 5분 캐시 쓰기 요율 및 Luna의 단·장문맥 요율을 사용합니다. 도구 요금, 세금, 지역 가산, 선택적 처리 티어 조정은 제외됩니다. 입력 임계값을 초과하면 초과분만이 아니라 요청 전체에 높은 요율이 적용됩니다.
Haiku는 또한 짧은/긴 프롬프트에 대해 100만 토큰당 $0.20/$1.00의 1시간 캐시 쓰기를 제공합니다. 캐시 지속성 및 가격 메커니즘은 벤더별로 다르므로, 두 캐시 쓰기 행을 동일한 제품으로 보지 말고 재사용 패턴을 비교하세요. Haiku의 128K 출력 제한은 표준 API 제한이며, Message Batches API는 베타 헤더로 300K 출력을 지원할 수 있습니다.
Illustrative Costs at Fixed Token Budgets
| Workload | Input / Output | Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Ticket classification | 2K / 200 | $0.0003 | $0.0003 |
| Short report | 40K / 4K | $0.006 | $0.006 |
| Repository analysis | 150K / 5K | $0.0875 | $0.0175 |
| Large document review | 300K / 10K | $0.175 | $0.0675 |
| Massive context analysis | 800K / 20K | $0.45 | $0.175 |
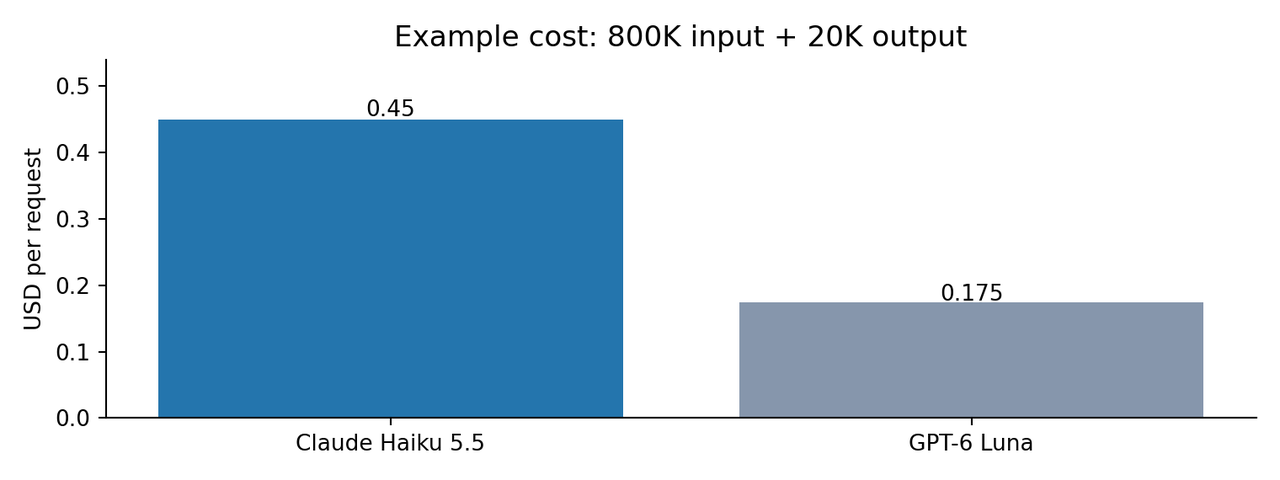
작성자 계산(캐시 미사용) 표준 요율 추정: cost = input tokens × input rate / 1,000,000 + billed output tokens × output rate / 1,000,000. “Output”은 이 추정에서 과금되는 총 출력(출력으로 과금되는 추론 토큰 포함)을 의미하며, 가시 답변 길이와 일치하지 않을 수 있습니다. 두 모델에 동일한 보고 토큰 수를 사용하지만, 토크나이저는 다를 수 있습니다.
저렴한 토큰이 곧 성공 결과의 저렴한 비용을 의미하지는 않습니다. 반복 시도, 실패한 도구 호출, 추론 토큰 소비, 토크나이저 차이를 반영하세요.
CometAPI Access and Integration Constraints
CometAPI는 두 모델에 대한 접근 옵션을 제공합니다. 게이트웨이를 통해 비교하거나 배포하기 전에 각 라우트의 모델 ID, 지원 엔드포인트, 요청 파라미터, 도구 동작, 과금 규칙을 확인하세요. 이 제공자 링크는 접근 옵션을 문서화하지만, 벤더의 기술 문서나 표준 가격 정보를 대체하지는 않습니다.
OpenAI에 직접 통합하는 경우, Luna는 Responses API를 통해 내장 도구를 지원합니다. Chat Completions 함수 호출에는 none 추론 노력 설정이 필요합니다. Haiku는 Anthropic의 Messages API와 adaptive thinking을 사용합니다. 게이트웨이는 기본 스키마를 상호 교환 가능하게 만들지 않습니다. 사용하려는 정확한 라우트로 도구 정의, 구조화 출력 동작, 스트리밍 이벤트, 정산을 검증하세요.
How Can Developers Compare Claude Haiku 5.5 and GPT-6 Luna With the Same Prompt?
Long-Document Extraction Example
실용적인 비교는 공급업체 계약 묶음을 사용해 효력 발생일, 갱신 조건, 통지 기간, 예외를 포함해 진행할 수 있습니다. 문서 묶음, 추출 지침, 예상 필드, 검증 규칙을 동일하게 유지하세요. 아래는 평가 설계 예시이며, 새로운 모델 측정 결과가 아닙니다.
Example prompt: 각 계약의 공급업체명, 효력 발생일, 갱신일, 계약 해지 통지 기간, 가격 예외를 추출하세요. 추출된 모든 값에 대해 문서 제목과 정확한 근거 구절을 인용하세요. 필드가 없으면 null을 반환하고, 누락된 날짜를 추정하지 마세요. 상충 조항을 표시하고 최종 답변은 1,000단어 이내로 제한하세요.
| Check | Acceptance criterion | What to record |
|---|---|---|
| Extraction accuracy | Required fields match an independently checked answer key | Correct, incorrect, and missing values |
| Grounding | Every non-null field has a valid supporting passage | Unsupported claims and wrong document citations |
| Instruction following | No invented dates; absent fields return null | Schema failures and constraint violations |
| Economics | Calculate spend per accepted extraction | Billed input, output, reasoning, retries, and fallback cost |
| Latency | Compare full job completion under the same tool policy | First-token time and end-to-end time |
결과가 달라지는 사례를 중심으로 대표 묶음을 여러 번 실행하세요. 가용한 동일 노력 수준에서 시작한 뒤, 각 모델에 더 낮은 비용 구성을 테스트하세요. 승자를 제시하기 전에 표본 크기, 설정, 라우트, 날짜, 실패 건수를 보고하세요.
Haiku 5.5 or GPT-6 Luna: Which to Choose?
| Dimension | Better-supported starting point | Decision boundary |
|---|---|---|
| GUI interaction | Claude Haiku 5.5 | 공유된 OSWorld 부분 점수가 Haiku에 유리; 전체 작업 완료로 검증 |
| Terminal coding | Claude Haiku 5.5 | 공유된 Terminal-Bench 점수가 Haiku에 유리; 저장소 변경을 검증 |
| Short prompts and base prices | Test both | 기본 요율 동일; 청구 사용량과 재시도를 비교 |
| Prompts above 100K tokens | GPT-6 Luna on standard rates | Luna가 기본 티어를 더 길게 유지; 정확도가 총비용을 바꿀 수 있음 |
| Streamed token throughput | Claude Haiku 5.5 in the dated snapshot | 처리량은 전체 완료 지연과 다름 |
| Simple repeated extraction | Test Luna with low or no reasoning | 가격만이 아니라 유효 승인 출력으로 선택 |
Choose Claude Haiku 5.5 for Benchmark-Relevant Interactive Tasks
공개된 그래픽 컴퓨터, 터미널 코딩, 전문 업무 작업과 유사한 애플리케이션에서는 Haiku로 시작하세요. 더 높은 완료율이 추가 추론 또는 장문맥 비용을 상쇄할 수 있습니다. 프로덕션 트래픽 라우팅 전에 자체 도구 스택에서 그 이점을 확인하세요.
Choose GPT-6 Luna for Large-Prompt Cost Control
프롬프트가 100K 토큰을 자주 넘고 표준 토큰 비용이 예산에 큰 영향을 준다면 Luna로 시작하세요. 낮거나 없는 추론으로 성공할 수 있는 반복 추출이나 라우팅에도 후보가 됩니다. 다만 추천은 승인 결과율과 실제 청구 사용량에 따라 조건부입니다.
Use Both When Workloads Have Different Needs
파일럿에서는 장문서 추출을 Luna로, GUI나 터미널 작업을 Haiku로 라우팅하고 각 선택을 승인 검사로 검증할 수 있습니다. 출력이 스키마 검증에 실패하거나 요구 증거가 없거나 작업별 검사를 통과하지 못하면 폴백을 트리거하세요. 비교에는 폴백 비용과 지연도 포함하세요.
Validate Before Switching
현재 모델을 기준선으로 포함하세요. 후보가 사전 정의한 정답률 목표를 충족하고 승인 결과당 비용 또는 엔드투엔드 지연을 마이그레이션·유지 비용 이상으로 개선할 때만 전환하세요. 중요한 도구 오류가 증가하면 롤아웃을 보류하세요. 파일럿에서 Luna의 낮은 요율이 재시도로 상쇄되거나, Haiku의 높은 벤치마크 점수가 작업 성공을 개선하지 못한다면 추천은 달라질 수 있습니다.
- 대표 워크로드 표본을 사용해 정답, 오답, 불완전 결과를 점수화하세요.
- 첫 토큰 지연, 엔드투엔드 작업 시간, 도구 신뢰성을 측정하세요.
- 입력, 캐시, 출력, 추론 토큰을 별도로 집계하세요.
- 재시도와 폴백을 포함해 성공 결과당 비용을 계산하세요.
- 기본 최대 설정을 쓰기 전에 Medium과 High 추론 노력을 비교하세요.
Conclusion
Claude Haiku 5.5는 본 비교의 전문 업무, 컴퓨터 사용, 에이전트형 코딩 벤치마크에서 더 강한 정면 승부 증거를 보유하고 있습니다. 독립 스냅샷에서 출력 처리량도 더 높습니다. GPT-6 Luna는 Haiku의 100K 임계값을 넘는 프롬프트에서 표준 요금상 명확한 이점이 있으며, 가중 평가 작업 비용도 더 낮습니다. 어느 한 가지 관찰만으로 프로덕션 신뢰성이나 승인 결과당 비용을 결정할 수는 없습니다.
실질적인 승자는 동일한 수준의 승인 결과를 최저의 완전 측정 운영 비용으로 제공하는 모델입니다. 단일 벤치마크를 정답으로 취급하지 말고, 자체 프롬프트·도구·재시도 규칙으로 두 모델을 모두 실행하세요.
FAQ
Why can task costs differ when both models have the same base token prices?
기본 가격이 같아도 총 청구액은 다를 수 있습니다. 모델이 사용하는 입력, 출력, 추론 토큰 양이 다르고, 수용 가능한 결과를 위해 필요한 재시도나 도구 호출 횟수도 다를 수 있습니다. 장문맥 요율과 캐시 사용도 총액에 영향을 줍니다. 토큰 가격만이 아니라, 모든 시도의 총비용을 승인된 결과 수로 나눈 값으로 비교하세요.
Do higher long-context rates apply only to tokens above the threshold?
아니요. 본 문서에서 설명한 표준 가격 하에서는 입력 임계값을 넘기면 초과분만이 아니라 요청 전체에 높은 요율이 적용됩니다. 예를 들어 입력 150K 토큰 요청은 Haiku의 100K 임계값을 넘지만 Luna의 272K 기본 티어 안에 머뭅니다. 비용 추정 시 요청 전체에 해당 입력 및 출력 요율을 적용하세요.
Can Claude Haiku 5.5 and GPT-6 Luna share a prompt cache?
모델이나 제공자 간 캐시 엔트리가 이전된다고 가정하지 마세요. 별도의 재사용 전략을 설계하고, 각 라우트에서 적중률과 청구 사용량을 측정하세요. 게이트웨이 지원, 보존 규칙, 요청 구조가 반복 입력의 캐시 적격 여부에 영향을 줄 수 있으므로, 절감 효과 예측 전에 이를 검증하세요.
What should a Haiku-to-Luna migration test cover?
대표 텍스트·이미지 입력, 요구 구조화 필드, 도구 인자, 스트리밍 응답, 오류 복구를 테스트하세요. 마이그레이션 전에 현재 시스템의 승인율을 확립하고, 동일한 재시도·도구 정책하에 두 후보를 비교하세요. 유사한 토큰 가격이나 모델 카테고리는 호환성을 보장하지 않습니다.
Should benchmark scores drive a Haiku or Luna fallback?
후보 선정에는 점수를 활용하되, 폴백은 유효하지 않은 도구 인자, 필수 필드 누락, 작업 검사 미충족 같은 관측 실패에 따라 트리거하세요. 폴백 빈도와 총 청구 비용을 추적하세요. 두 번째 모델은 지연과 비용을 추가할 수 있으므로, 단지 두 번째 답변을 내는 것이 아니라 승인 결과를 개선하는지 검증하세요.
Can sensitive data be routed through both APIs?
관련 벤더와 게이트웨이, 최신 보존 설정, 처리 위치, 계약 조건, 조직의 데이터 정책을 확인한 뒤에 민감한 입력을 라우팅하세요. 모델 역량과 가격 표는 규제 또는 기밀 데이터 요건에 적합한 라우트를 입증하지 않습니다. 그러한 요건이 결정적이라면 승인된 라우트를 사용하세요.