
TL;DR
Google은 2026년 9월 30일 복잡하고 장시간 실행되는 워크플로를 위한 프런티어 모델인 Gemini 4 Argon을 발표했다. 공개된 결과는 뚜렷한 패턴을 보인다: 전문 지식 업무, 긴 컨텍스트 과제, 일부 소프트웨어 공학 평가에서 강한 성능을 보이는 한편, 일부 터미널 및 컴퓨터 사용 벤치마크에서는 약한 결과를 보인다. Google은 단계적 롤아웃을 통해 모델을 도입 중이다. 별도로, CometAPI는 10월 1일 기준 카탈로그 제공을 보고하며, 배포 전 계정 자격과 테스트 요청 성공 여부를 확인해야 한다. 더 유용한 성능 관점은 이점이 어디에서 나타나는지다.
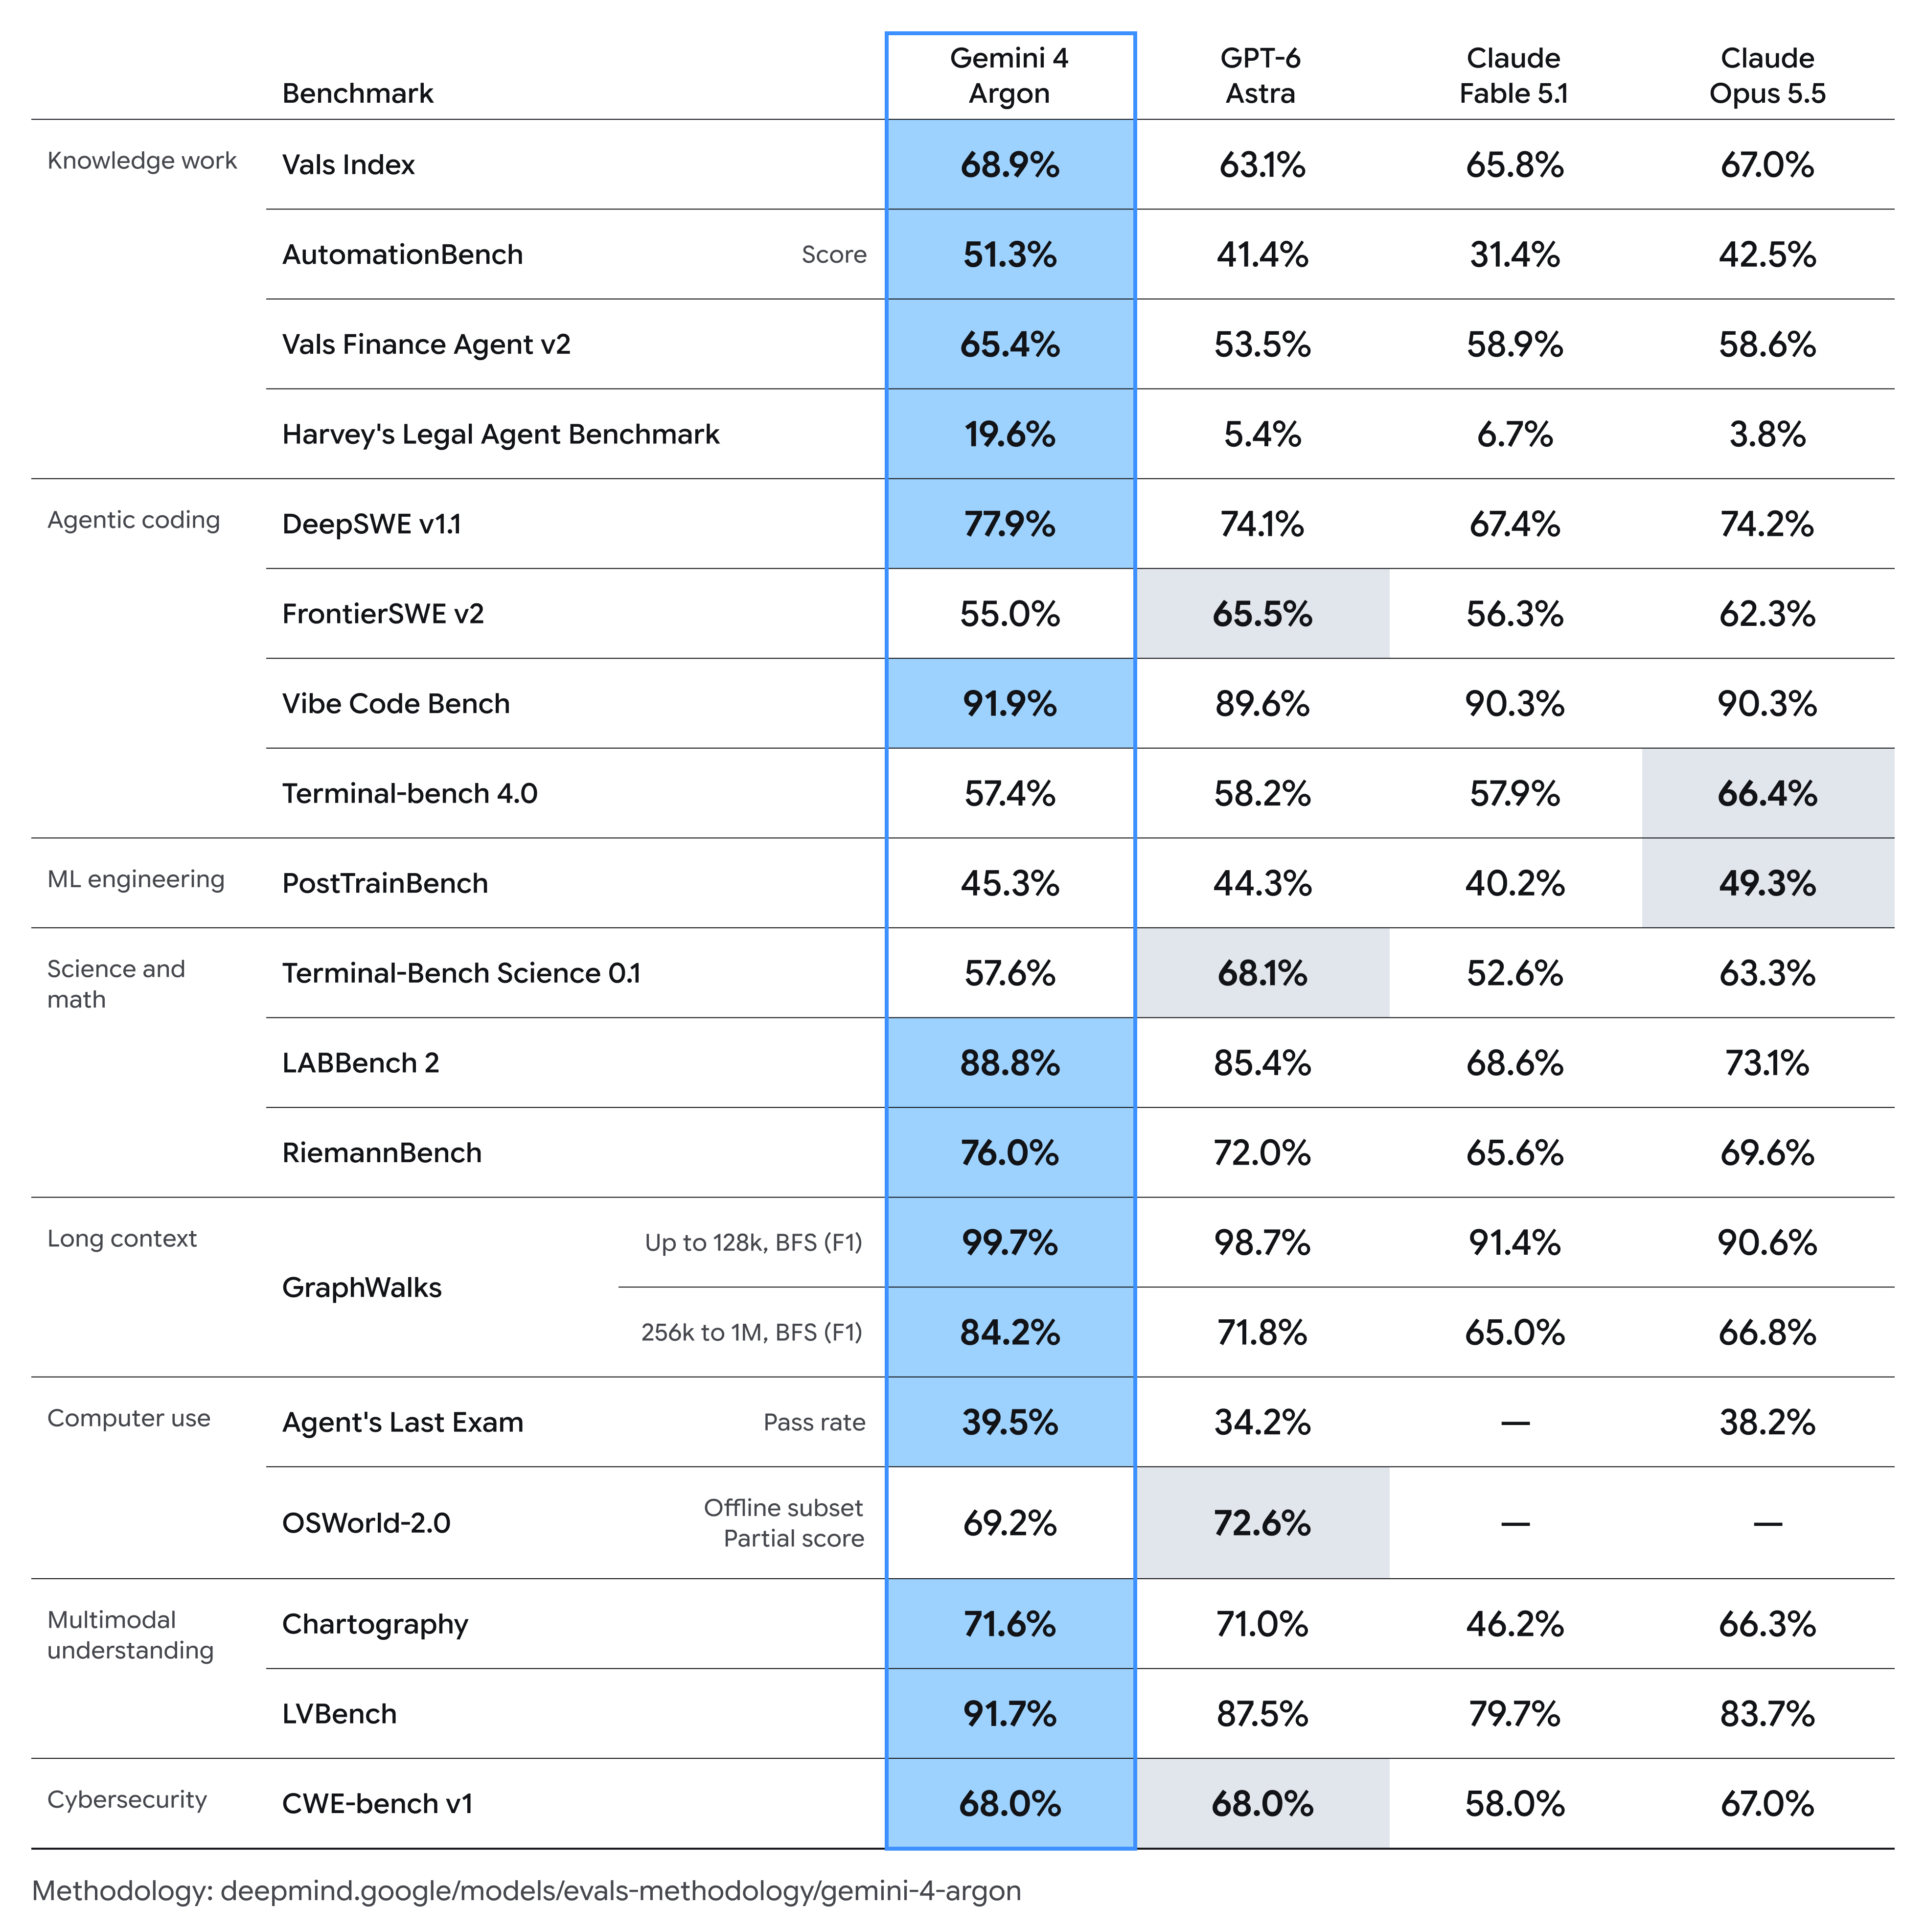
Argon은 Vals Index 68.9%, Vals Finance Agent v2 65.4%, DeepSWE v1.1 77.9%, LVBench 91.7%, GraphWalks 256K–1M 84.2%를 기록했다. 동시에 FrontierSWE v2, Terminal-Bench 4.0, Terminal-Bench Science, OSWorld-2.0에서는 경쟁 프런티어 모델에 뒤처진다.
이 결과는 Argon을 워크로드별로 바라보는 관점을 지지한다. 가장 강한 점수는 전문 지식 업무, 매우 긴 컨텍스트 과제, 선택된 멀티모달 및 소프트웨어 공학 평가에 집중되어 있다. 다른 모델들은 여러 터미널 및 컴퓨터 사용 시험에서 여전히 우위를 유지한다.
Key Takeaways
- Gemini 4 Argon은 엔터프라이즈 지식 업무, 긴 컨텍스트 추론, 멀티모달 이해, 여러 장기 지평 코딩 평가에서 가장 강하다.
- 최대 100만 토큰의 출력 한도는 긴 추론 경로를 위한 생성 여유를 제공하지만, 공개 입력 컨텍스트 사양을 확립하지는 않는다.
- Argon은 여러 지식 업무 및 긴 컨텍스트 결과에서 선도하지만, GPT-6 Astra와 Claude Opus 5.5는 일부 코딩 및 컴퓨터 사용 평가에서 앞선다.
- 벤치마크 점수는 특정 모델·에이전트 구성에서의 결과를 설명한다. 지표, 입력 조건, 평가 설정은 헤드라인 퍼센트만큼 중요하다.
- Google의 롤아웃과 CometAPI 접근성은 별개의 가용성 주장이다. 트래픽 마이그레이션 전 활성 라우트, 모델 식별자, 계정 자격을 확인하라.
What Is Gemini 4 Argon?
Gemini 4 Argon은 짧은 한 번의 프롬프트 응답이 아니라 많은 단계를 거치는 추론이 필요한 어려운 워크플로를 중심으로 구축된 Google DeepMind의 새로운 프런티어 Gemini 모델이다.
Google의 공식 포지셔닝은 실세계 소프트웨어 엔지니어링, 법무·금융 등 엔터프라이즈 지식 업무, 방어적 사이버보안, 멀티모달 이해, 장시간 에이전트형 작업을 강조한다.
이는 최근 Flash 릴리스와의 중요한 구분이다. CometAPI의 Gemini 3.8 Flash API는 대규모 에이전트형 워크로드를 위한 저비용 일꾼형 모델로 설계되었다. 반면 Argon은 Google 스택의 프런티어 끝을 대표하며, 깊이와 지속적 실행을 우선한다.
Model Specifications
| 사양 | Gemini 4 Argon |
|---|---|
| 개발사 | Google DeepMind |
| 발표일 | September 30, 2026 |
| 모델 계열 | Gemini 4 |
| 포지셔닝 | 프런티어 추론 및 장기 지평 모델 |
| 최대 출력 | 1,000,000 tokens |
| 긴 컨텍스트 평가 | GraphWalks에서 256K–1M 범위로 테스트 |
| 공개 입력 컨텍스트 한도 | 출시 시점의 표준 공개 API 사양 표에 공식적으로 명시되지 않음 |
| 멀티모달 이해 | 예; 차트, 문서 및 장시간 비디오 평가 포함 |
| 에이전트형 코딩 | 예 |
| 컴퓨터 사용 | 평가됨 |
| 사이버보안 | 특화된 방어 능력 |
| Google 공개 API 모델 ID | Google의 초기 공개 문서에 미공개; CometAPI는 카탈로그 식별자로 gemini-4-argon을 사용 |
Output Budget and Trade-offs
Google은 Argon의 최대 출력 한도를 100만 토큰으로 발표했으며, 이는 출시 공지에서 인용된 이전 64K 한도에서 상향된 수치다. 이는 더 긴 추론 경로를 위한 여유를 제공한다. 다중 호출 에이전트 세션 전체에 대한 보장 예산이나 모든 작업이 개선된다는 증거로 해석되어서는 안 된다.
최대 출력은 지능과 동일하지 않다. 더 많은 출력 토큰을 준다고 모델이 자동으로 더 유능해지지는 않는다. 다만 잠재적 병목 하나를 제거할 뿐이며, 그 예산을 생산적으로 사용하는 것은 여전히 모델의 몫이다.
비용과 지연 시간의 트레이드오프도 있다. 실제로 수십만 개의 생성 토큰을 소비하는 모델은 명목상 토큰당 가격이 매력적으로 보이더라도 비용이 많이 들고 느릴 수 있다.

기사에서 재현한 일부 벤치마크 결과. 각 행 내에서 모델을 비교하라. 지표와 평가 조건이 다르다. 이 차트는 장식용 그라디언트 아트를 대체하며 독립 테스트를 의미하지 않는다.
최대 출력 한도와 입력 컨텍스트 윈도우는 서로 다른 역량을 설명한다. GraphWalks의 평가 범위는 테스트된 입력에 대한 증거일 뿐, 공개 API 사양의 대체물이 아니다.
How Does Gemini 4 Argon Perform on Benchmarks?
Google DeepMind의 성능 표는 에이전트 워크플로, 전문 지식 업무, 멀티모달 작업을 다룬다. 아래 값은 그 공개 비교를 재현한 것이다. 이들은 작업 성능을 측정하며, 토큰 처리량이나 응답 지연을 측정하지 않는다; “—”는 이 비교에서 결과가 보고되지 않았음을 의미한다.
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | Evaluation conditions |
|---|---|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% | Vals AI |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% | 비공개 세트; Zapier 리더보드 |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% | Vals AI |
| Harvey's Legal Agent | 19.6% | 5.4% | 6.7% | 3.8% | Vals AI |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% | mini-swe 하니스; 혼합 소스 |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% | Proximal 리더보드 |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% | Vals AI 리더보드 |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% | 자가 테스트 / 리더보드 |
| PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% | v1.1; OpenCode; 10시간; H100 1개 |
| Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% | 검증기 타임아웃 ×6 |
| LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% | Linux 도구; 인터넷 |
| RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% | Surge 리더보드 |
| GraphWalks up to 128K | 99.7% | 98.7% | 91.4% | 90.6% | BFS F1; 650개 항목 |
| GraphWalks 256K–1M | 84.2% | 71.8% | 65.0% | 66.8% | BFS F1; 200개 항목 |
| Agent's Last Exam | 39.5% | 34.2% | — | 38.2% | 이진 통과; ALE-Claw; 5시간 |
| OSWorld-2.0 | 69.2% | 72.6% | — | — | 오프라인 부분 점수; 3회 중 최고 |
| Chartography | 71.6% | 71.0% | 46.2% | 66.3% | 도구 없음; Surge 리더보드 |
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% | 도구 없음; 모델별 프레임 샘플링 |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% | pass@1; pass@4로 동률 해소 |
Google 공식 Gemini 4 Argon 벤치마크 비교
별도 언급이 없는 한, Argon 결과는 단일 시도와 최고 수준의 사고 설정을 사용한다. 다른 모델 결과는 일반적으로 제공업체 보고에서 가져오며, 벤치마크별 예외가 있다. LVBench는 Gemini에 1 FPS, GPT-6 Astra에 800 프레임, Fable 5.1에 300, Opus 5.5에 600을 사용한다. 이 입력은 동일하지 않으므로, 각 행을 통제된 재실행으로 보지 말고 보고된 구성 자체를 비교하라.
Evaluation Conditions and Limitations
이 표는 유용하지만, 독립적·보편적 리더보드로 해석해서는 안 된다.
- 벤치마크 선택은 Google의 선택이다.
- 벤치마크별 평가 설정은 에이전트 프레임워크, 시간 예산, 도구, 입력 샘플링 등 행마다 다르다.
- 공식 방법론은 기본적으로 경쟁사 결과를 제공업체 보고 값으로 식별하며, 벤치마크별 리더보드 및 자체 계산 예외가 있다.
- 최고 벤치마크 설정은 기본 프로덕션 추론 구성과 일치하지 않을 수 있다.
- 헤드라인 점수만으로는 토큰 사용량, 도구 호출, 재시도, 경과 시간, 인간 개입 여부가 드러나지 않는다.
프로덕션 시스템에서는 토큰당 가격이나 단일 퍼센트보다, 성공적으로 완료된 작업당 비용이 더 나은 지표인 경우가 많다.
Which Workload Is Gemini 4 Argon Best For?
Knowledge Work Performance
Argon의 결과에서 가장 뚜렷한 패턴은 전문적이고 다단계의 지식 업무에 나타난다.
Vals Index에서 Argon은 68.9%에 도달했으며, Claude Opus 5.5의 67.0%와 비교된다. 수치 격차는 크지 않지만, 특화된 워크플로에서 패턴이 더 분명해진다.
- Vals Finance Agent v2: 65.4%, Google 표에 나타난 가장 강한 경쟁자 대비 6.5포인트 우위.
- AutomationBench: 51.3%, Claude Opus 5.5 대비 8.8포인트 우위.
- Harvey's Legal Agent Benchmark: 19.6%, 보고된 차상위 모델의 6.7%와 비교.
성능 프로필은 정보를 수집하고, 상태를 보존하며, 여러 단계를 가로질러 추론하고, 단답이 아닌 전문 산출물을 만들어야 할 때 Argon이 가장 큰 이득을 본다는 점을 시사한다.
절대 법무 에이전트 점수가 낮다는 점도 중요하다. 19.6%라는 수치만으로 몇 개의 기준이나 전체 워크플로가 실패했는지는 드러나지 않는다. 유용한 결론은 이 평가에서 Argon이 큰 상대적 개선을 보이지만, 그 결과가 법률 업무의 신뢰할 만한 자동화를 입증하지는 않는다는 것이다.
Long-Context Reasoning
Argon의 가장 두드러진 이점은 GraphWalks 256K–1M 버전일 수 있다.
- Gemini 4 Argon: 84.2%
- GPT-6 Astra: 71.8%
- Claude Opus 5.5: 66.8%
- Claude Fable 5.1: 65.0%
이는 공개 비교에서 가장 근접한 모델 대비 12.4포인트 우위다.
더 짧은 컨텍스트 길이에서는 격차가 훨씬 작다: GraphWalks up to 128K에서 Argon은 99.7%, GPT-6 Astra는 98.7%를 기록한다. 이는 해당 매우 긴 컨텍스트 평가에서 Argon이 비교 모델들보다 성능 저하가 덜하다는 점을 시사한다.
Google은 이 차이를 특정 어텐션 메커니즘, 검색 시스템, 학습 레시피, 추론 시 전략에 귀속할 수 있을 만큼의 아키텍처 정보를 공개하지 않았다. “Gemini 4가 새로운 어텐션 아키텍처를 도입했다”와 같은 주장은 공개 증거를 넘어선다.
Coding Performance
공식 벤치마크 표는 단순한 예/아니오로 답할 수 없다.
Argon은 어떤 형태의 코딩에서는 매우 뛰어나고, 다른 형태에서는 분명히 밀린다. DeepSWE v1.1에서 77.9%를 기록하며, Claude Opus 5.5의 74.2%, GPT-6 Astra의 74.1%를 앞선다. Vibe Code Bench 점수도 91.9%로 강하다.
- FrontierSWE v2: Argon 55.0% vs. GPT-6 Astra 65.5%.
- Terminal-Bench 4.0: Argon 57.4% vs. Claude Opus 5.5 66.4%.
- Terminal-Bench Science 0.1: Argon 57.6% vs. GPT-6 Astra 68.1%.
이 분할은 개발자에게 중요하다. Argon은 컨텍스트와 계획이 많은 장기 엔지니어링 워크플로로 코딩이 전개될 때 특히 강해 보이는 반면, 터미널 중심 실행에서는 경쟁이 더 치열하다. 저장소 마이그레이션 벤치마크와 대화형 터미널 벤치마크를 “코딩 능력”의 상호 대체 지표로 취급해서는 안 된다.
Defensive Cybersecurity
사이버보안은 핵심 배포 영역이다. Google의 방어적 사이버보안 포지셔닝은 자율 취약점 발견, 검증, 패칭을 포함한다. 이는 제공업체의 역량 주장이며, 아래 CWE-bench 결과는 자체 평가에서의 취약점 수정 능력을 측정한다.
CWE-bench v1에서 Argon은 68%를 기록해 GPT-6 Astra와 공동, Claude Opus 5.5(67%)보다 약간 앞선다.
Google은 오용 방지, 간접 프롬프트 인젝션, 위험한 에이전트 행동, 실행 환경 손상에 대한 더 강한 안전장치도 강조한다. 이는 Argon이 전통적 모델 업그레이드만이 아니라 에이전트 보안 릴리스이기도 하다는 뜻이다.
Multimodal Understanding
Argon은 Chartography에서 71.6%, 장시간 비디오 이해를 다루는 LVBench에서 91.7%를 기록한다. LVBench 결과는 Google의 표에서 GPT-6 Astra 대비 4.2포인트 높다. 모델마다 프레임 샘플링 구성이 다르므로, 이는 순수 모델 우위라기보다 보고된 설정 간 비교다.
이는 많은 전문 워크플로가 텍스트만으로 이루어지지 않는다는 점에서 중요하다. 금융 리서치 에이전트는 차트를 봐야 할 수도 있고, 엔터프라이즈 어시스턴트는 보고서·PDF·스크린샷을 결합할 수 있으며, 비디오 분석 시스템은 개별 프레임을 독립적으로 처리하기보다 긴 시퀀스 전반의 사건을 보존해야 할 수 있다.
Argon의 멀티모달 지각과 지속적 추론의 조합은 단순한 멀티모달 지원 그 이상으로 중요하다.
Science and Mathematics Performance
결과는 혼재하지만 전반적으로 강하다. Argon은 LABBench 2에서 88.8%, RiemannBench에서 76.0%를 기록하며 Google 표의 비교 모델들을 앞선다. 그러나 Terminal-Bench Science 0.1에서는 GPT-6 Astra가 68.1%로 Argon(57.6%)보다 높다.
이 차이는 더 넓은 패턴을 가리킨다: Argon은 과학 정보를 가로지르는 추론에서는 강하지만, 도구 중심의 모든 과학 실행 형태에서까지 강한 것은 아니다.
Computer-Use Performance
Agent's Last Exam에서 Argon은 39.5% 이진 통과율을 기록해 GPT-6 Astra(34.2%)와 Claude Opus 5.5(38.2%)를 앞선다. OSWorld-2.0의 오프라인 서브셋에서는 부분 점수 69.2%로 GPT-6 Astra(72.6%)보다 낮다. OSWorld 값은 전체 작업 성공률이 아니며, Claude 항목의 미기재는 0 능력을 의미하지 않는다.
따라서 현재 데이터는 전반적인 컴퓨터 사용 우위는 보여주지 않는다. 프로덕션 배포에서는 탐색 정확도, 실패 클릭, 재시도 빈도, 의도치 않은 동작, 완료까지의 시간, 인간 보정률 등 작업 단위 테스트로 벤치마크 점수를 보완해야 한다.
Gemini 4 Argon vs GPT-6 Astra and Claude
| 측면 | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|
| 지식 업무 | 매우 강함 | 강함 | 매우 강함 | 강함 |
| 긴 컨텍스트 벤치마크 | 발표된 결과 중 최강 | 강함 | 보통~강함 | 보통 |
| 장기 지평 코딩 | 매우 강함 | 매우 강함 | 매우 강함 | 강함 |
| 터미널 코딩 | 경쟁력 있음 | 강함 | 선별된 테스트에서 최강 | 경쟁력 있음 |
| 과학 분야 터미널 에이전트 | 경쟁력 있음 | 선별된 테스트에서 최강 | 강함 | 경쟁력 있음 |
| 멀티모달 이해 | 매우 강함 | 매우 강함 | 강함 | 경쟁력 있음 |
| 컴퓨터 사용 | 경쟁력 있음 | 강함 | 혼재 / 제한적 비교 | 제한적 비교 |
| 사이버보안 | CWE-bench v1에서 공동 1위 | 공동 1위 | 근소한 차이로 근접 | 낮음 |
Argon은 긴 컨텍스트, 문서 중심, 전문 에이전트 업무에서 두드러진다. 개발자는 CometAPI를 통해 GPT-6 Astra, Claude Opus 5.5, Claude Fable 5.1과 비교할 수 있다.
Performance-based selection
위의 정성적 라벨은 선택된 벤치마크 표를 요약한 것이며, 보편적 순위가 아니다. 업무가 Argon의 선도 평가와 유사하다면 파일럿에서 Argon을 우선 고려하라; 터미널 중심 워크로드에서는 기본값을 선택하기 전에 Astra와 Opus를 테스트하라.
Specifications and deployment constraints
이 성능 비교는 아키텍처 우위나 일반적인 가격 대비 성능 승자를 확립하지 않는다. Argon의 파라미터 수와 아키텍처는 검토한 Google 출시 자료에서 명시되지 않았다. 공개 입력 컨텍스트 한도는 공식 API 문서가 필요하다. CometAPI는 gemini-4-argon 라우트를 보고한다; Google의 더 넓은 롤아웃과 별개로, 지원 매개변수와 계정 접근성을 독립적으로 확인하라. 배포 전 각 라우트의 한도와 실제 작업 비용을 비교하라.
How Can Developers Access Gemini 4 Argon Through CometAPI?
CometAPI는 모델을 gemini-4-argon으로 제공 중이라고 보고한다. 계정 대시보드에서 API 키를 생성하고, 플레이그라운드에서 해당 식별자를 선택해 통합 전 테스트 요청을 실행하라. OpenAI 호환 예시는 기본 URL로 https://api.cometapi.com/v1를 사용한다. 모델이 지원하는 엔드포인트와 매개변수를 계정 문서에서 확인하라; 카탈로그 배지 자체는 성공 호출을 보증하지 않는다.
- CometAPI 계정을 만들고 대시보드에서 API 키를 생성한다.
- gemini-4-argon을 선택해 플레이그라운드에서 대표 요청을 검증한다.
- 호환 클라이언트를 CometAPI 기본 URL, 키, 모델 식별자로 구성하고, 배포 전 지원 요청 스키마와 과금 정책을 확인한다.
CometAPI and official pricing
Google은 백만 입력 토큰당 $2, 백만 출력 토큰당 $10의 도입 가격과, 캐시된 입력에 대해 입력 요율의 95% 할인 가격을 발표했다. 도입 기간 이후 발표 요율은 입력 $4, 출력 $20(백만 토큰당)이다. 이는 Google의 발표 요율이며, CometAPI 가격이나 즉시 일반 API 접근을 보증하지 않는다.
| 청구 기준 | CometAPI 내 Gemini 4 Argon API | Google 공식 발표 | 비교 |
|---|---|---|---|
| 입력 / 100만 토큰 | $3.20 | 도입 기간 종료 후 $4.00 | 발표된 소개 기간 종료 후 요율 대비 20% 낮음 |
| 출력 / 100만 토큰 | $16.00 | 도입 기간 종료 후 $20.00 | 발표된 소개 기간 종료 후 요율 대비 20% 낮음 |
Conclusion
Gemini 4 Argon의 벤치마크 프로필은 단순 리더보드 주장보다 더 흥미롭다.
이번 비교에서 가장 강한 결과는 전문 지식 업무, 긴 컨텍스트, 지속적 에이전트 실행에 집중되어 있다. 이 패턴은 워크로드 선택에 유용하지만, 근저의 아키텍처를 식별하거나 어떤 메커니즘이 이득을 가져왔는지를 입증하지는 않는다.
보고된 금융, 법무, 장시간 비디오, 소프트웨어 공학 결과는 해당 워크로드에 대한 집중 파일럿을 지지한다. 동일한 이점이 프로덕션에서도 유지되는지는 입력 구성, 에이전트 프레임워크, 추론 설정, 검증 요건에 달려 있다.
동시에, 프런티어 모델 성능은 점점 더 특화되고 있음을 보여준다. Argon은 DeepSWE에서 선도하면서도 FrontierSWE에서는 뒤처질 수 있고; Agent's Last Exam에서 선도하면서 OSWorld에서는 뒤처질 수 있으며; LABBench에서 선도하면서 Terminal-Bench Science에서는 뒤처질 수 있다. 이 벤치마크들은 에이전트 시스템의 서로 다른 측면을 스트레스 테스트한다.
개발자에게 가장 중요한 교훈은 모델 선택이 점점 브랜드나 계열 수준이 아니라 워크로드 수준에서 이뤄져야 한다는 점이다.
FAQ
개발자는 자체 워크로드에서 Gemini 4 Argon을 어떻게 검증해야 하는가?
명확한 수용 기준을 갖춘 대표 작업 세트를 구축하라. 도구, 시간 제한, 입력 준비, 재시도 정책을 모델 간에 유사하게 유지하라. 완료된 작업 수, 총 토큰, 경과 시간, 인간 보정을 기록하라. 소규모 파일럿으로 시작하고 프로덕션 트래픽을 라우팅하기 전에 실패 사례를 분석하라.
Gemini 4 Argon의 벤치마크 퍼센트를 하나의 점수로 평균낼 수 있는가?
아니다. 표는 F1, 통과율, 부분 점수 등 서로 다른 지표를 결합한다. 모든 퍼센트를 평균내기보다 작업별 기준을 사용하라.
Gemini 4 Argon 에이전트는 항상 최대 출력 예산을 사용해야 하는가?
아니다. 품질과 신뢰 요건을 충족하는 가장 작은 테스트된 예산을 선택하라. 최대 출력 한도는 목표가 아니라 상한선이다.
CometAPI를 통한 Gemini 4 Argon 접근성을 팀은 어떻게 평가해야 하는가?
문서화된 CometAPI 라우트를 사용해 계정 수준의 가용성 확인과 소규모 요청으로 시작하라. 응답 품질, 지연, 한도, 과금 토큰을 측정한 뒤, 대체 모델에 사용한 동일한 수용 테스트를 적용하라. CometAPI의 접근성 주장을 Google의 더 넓은 롤아웃과 별개로 취급하고, 해당 라우트가 요건을 충족할 때까지 라우팅을 구성 가능하게 유지하라.