
요약
DeepSeek V4.1 Flash는 코딩, 추론, 에이전트, 장문 맥락 작업을 위한 DeepSeek의 효율 지향 멀티모달 모델입니다. 공식 기술 문서에 따르면, 입력에 80억, 출력에 160억 활성 파라미터를 사용하는 552B Mixture-of-Experts 설계를 채택하고 있으며, 네이티브 비전 이해와 훨씬 작은 KV 캐시 풋프린트를 제공합니다.
CometAPI에서 DeepSeek V4.1 Flash API를 사용하는 개발자를 위해, 실사용 연동은 OpenAI 호환 방식입니다: 기본 URL로 https://api.cometapi.com/v1를 사용하고, 모델을 deepseek-v4.1-flash로 설정하며, 표준 Chat Completions 인터페이스를 호출하십시오.
한 가지 중요한 명명 차이가 있습니다: DeepSeek의 1차 API는 deepseek-flash를 사용하고, CometAPI는 deepseek-v4.1-flash를 사용합니다. 모델 식별자는 공급자별 구성으로 취급하십시오.
핵심 요점
- DeepSeek V4.1 Flash는 552B MoE 백본, 네이티브 이미지 이해, 비대칭 입력/출력 연산 프로파일을 결합합니다.
- CometAPI에서는 deepseek-v4.1-flash를 사용하고, DeepSeek 1차 API에서는 deepseek-flash를 사용합니다.
- CometAPI는 $0.12/M 입력 토큰부터의 기본 가격을 공개하며, DeepSeek는 오프피크 캐시 미스 입력 가격으로 $0.15/M을 표기합니다.
- 가장 큰 차이는 코딩, 터미널, 리포지토리, 자동화, 도구 보조 에이전트 벤치마크에 집중됩니다.
- 프로덕션 도입 전, 실제 배포 라우트에서 thinking 제어, 비전 페이로드, 스트리밍, 도구 호출, 구조화 출력 등 고급 필드를 검증하십시오.
DeepSeek V4.1 Flash API란?
DeepSeek V4.1 Flash는 552B-파라미터 Mixture-of-Experts 아키텍처에 기반한 최신 Flash 모델입니다. 인과적 인코더-디코더 설계를 채택하여 입력 처리에 80억, 출력 생성에 160억 활성 파라미터가 활성화됩니다.
연동 계획을 위해, 공식 DeepSeek API는 100만 토큰 컨텍스트 창과 최대 38.4만 토큰 출력을 제공합니다. 상위 서비스는 OpenAI 호환 Chat Completions 및 Responses API, Anthropic 호환 API, 스트리밍, JSON 출력, 도구 호출, 네이티브 이미지 입력을 지원합니다. 본 가이드는 CometAPI Chat Completions 라우트를 사용하므로, 프로덕션 배포 전에 해당 라우트에서 기능 패스스루를 확인하십시오.
| 명세 | DeepSeek V4.1 Flash 공식 API 세부 |
|---|---|
| 아키텍처 | 552B MoE, 인과적 인코더-디코더 |
| 활성 파라미터 | 입력 80억; 출력 160억 |
| 컨텍스트 길이 | 100만 토큰 |
| 최대 출력 | 38.4만 토큰 |
| 인터페이스 | Chat Completions, Responses API, Anthropic 호환 API |
| 스트리밍 | 지원 |
| 구조화 출력 | JSON 출력 및 지원 엔드포인트의 JSON Schema |
| 도구 호출 | 지원, thinking 모드 도구 사용 포함 |
| 비전 입력 | JPEG, PNG, GIF, WebP |
| 이미지 제한 | 인라인 32 MiB; 파일당 64 MiB; 요청당 최대 600장 |
| 1차 모델 ID | deepseek-flash |
| CometAPI 모델 ID | deepseek-v4.1-flash |
공급자 참고: 모델 ID와 고급 요청 필드는 라우트별입니다. 본 가이드의 CometAPI 예시에서는 deepseek-v4.1-flash를 사용하고, 배포된 엔드포인트에서 비전, 도구 호출, 구조화 출력, thinking 제어를 테스트하십시오.
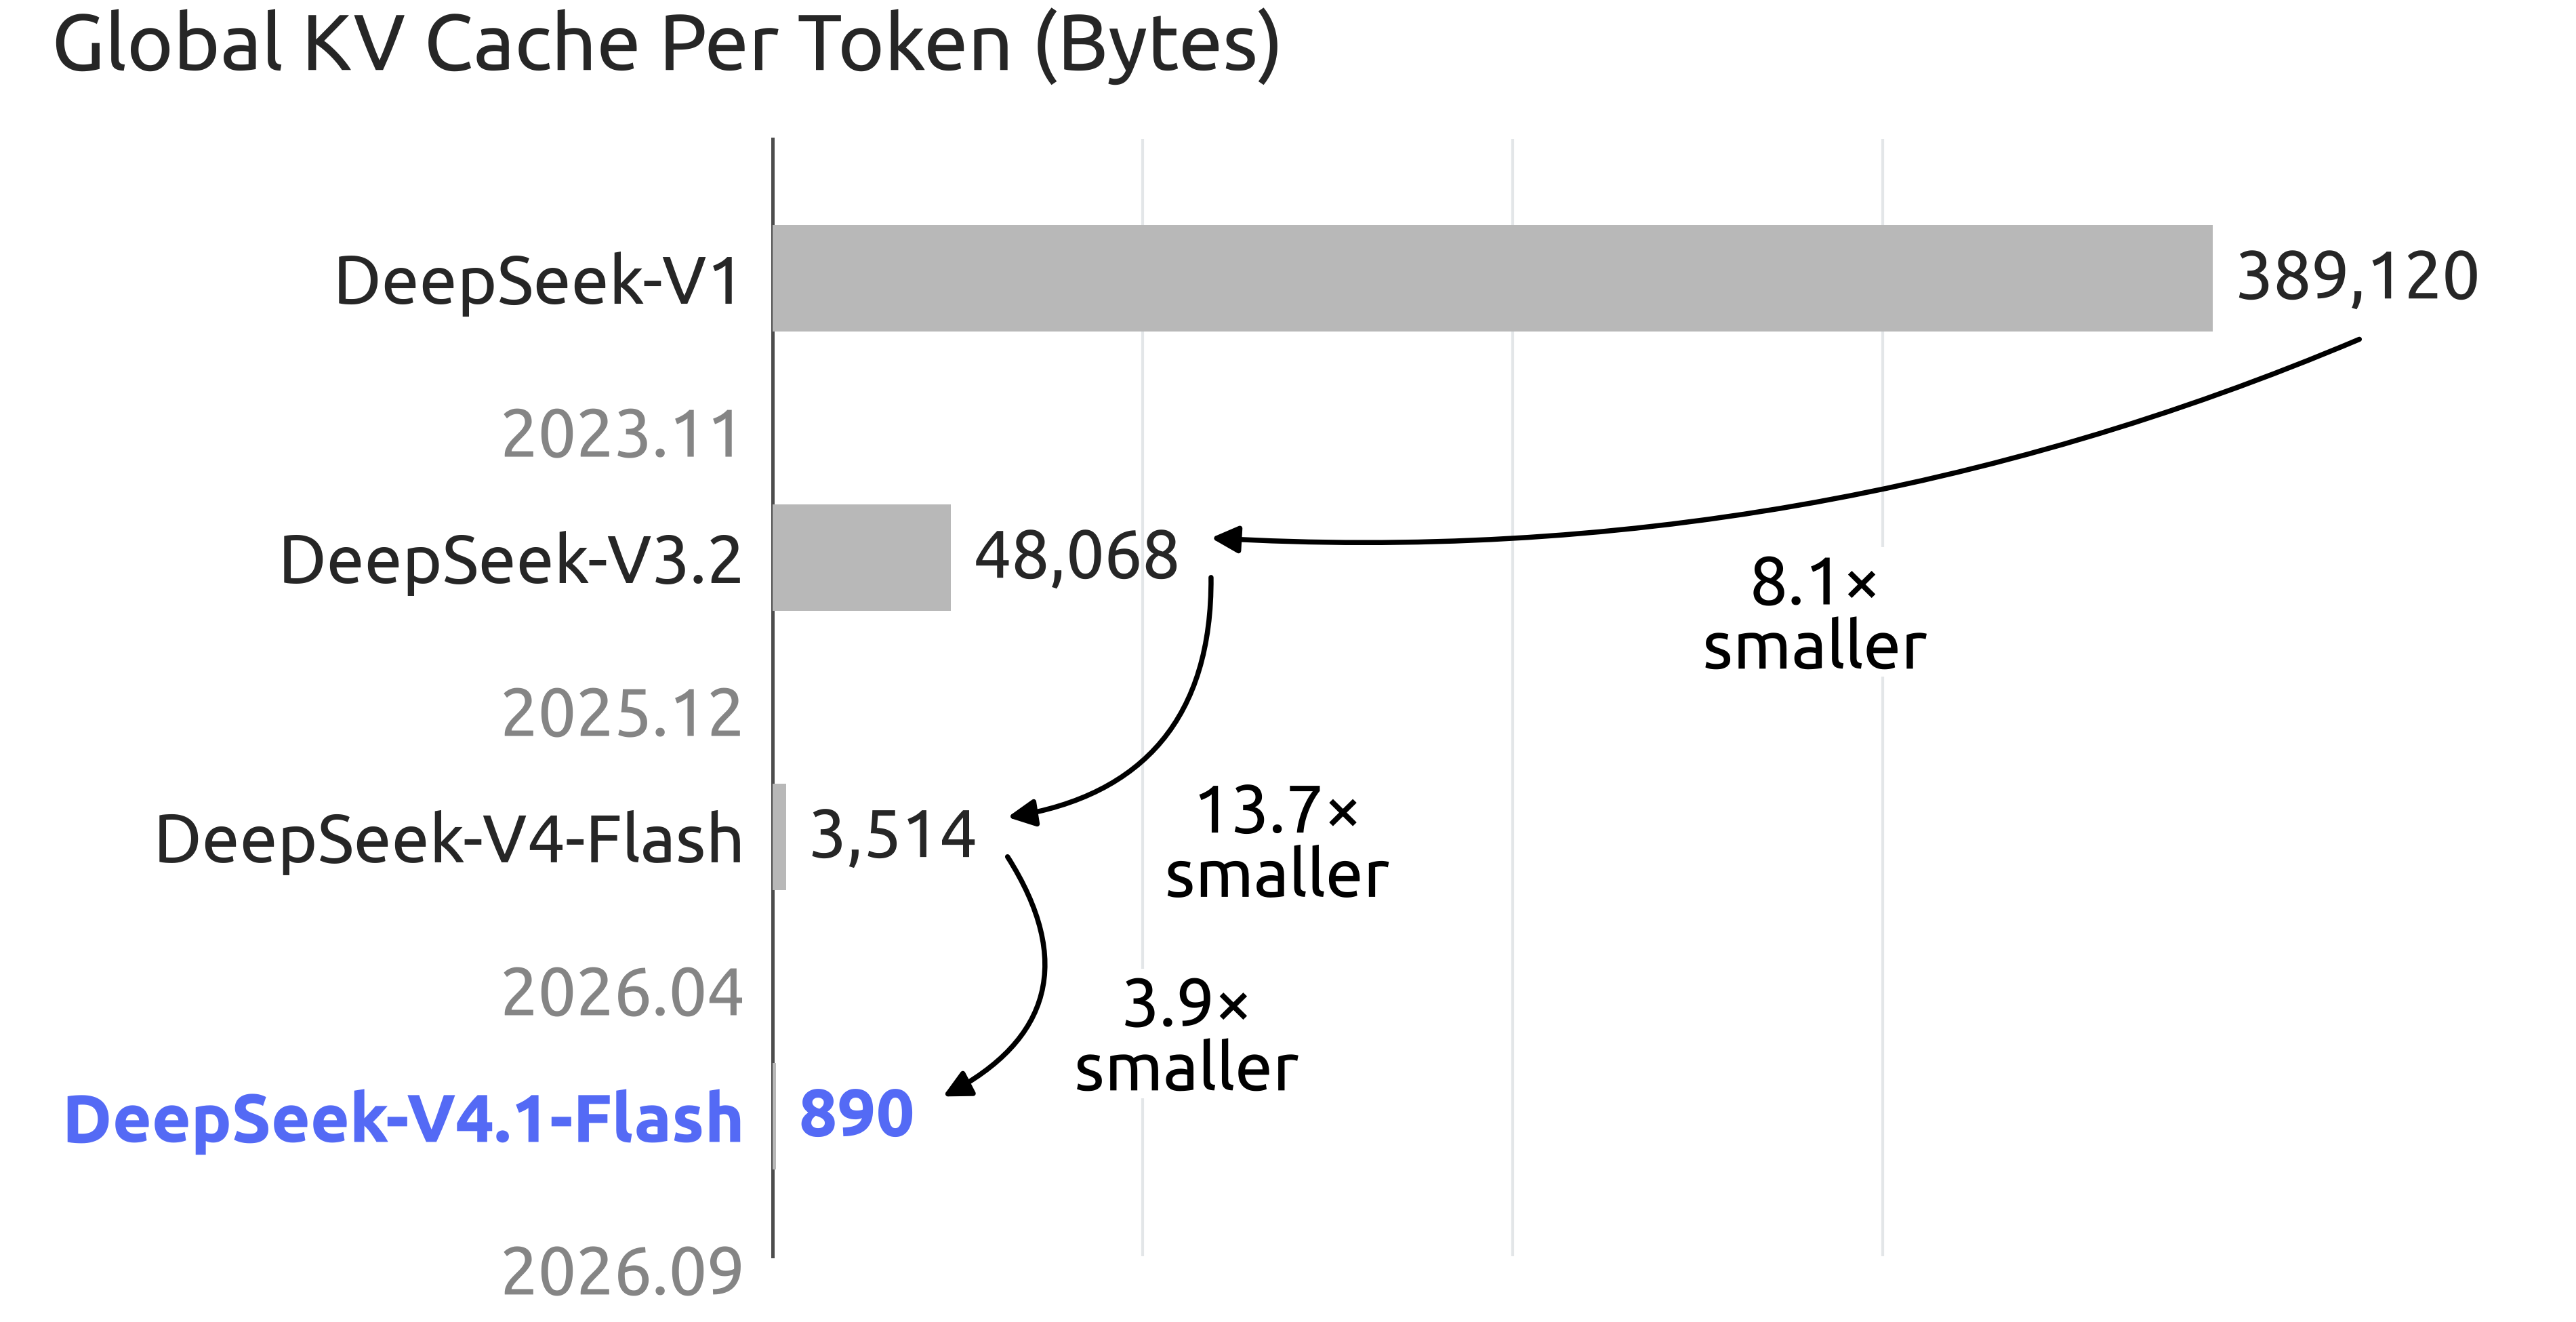
DeepSeek는 전역 KV 캐시가 토큰당 약 890바이트로, 이전 V4 Flash 세대의 토큰당 3,514바이트 대비 감소했다고 보고합니다. 이 감소는 큰 프롬프트, 도구 스키마, 대화 기록을 반복 재사용하는 장기 실행 에이전트에서 특히 중요합니다.
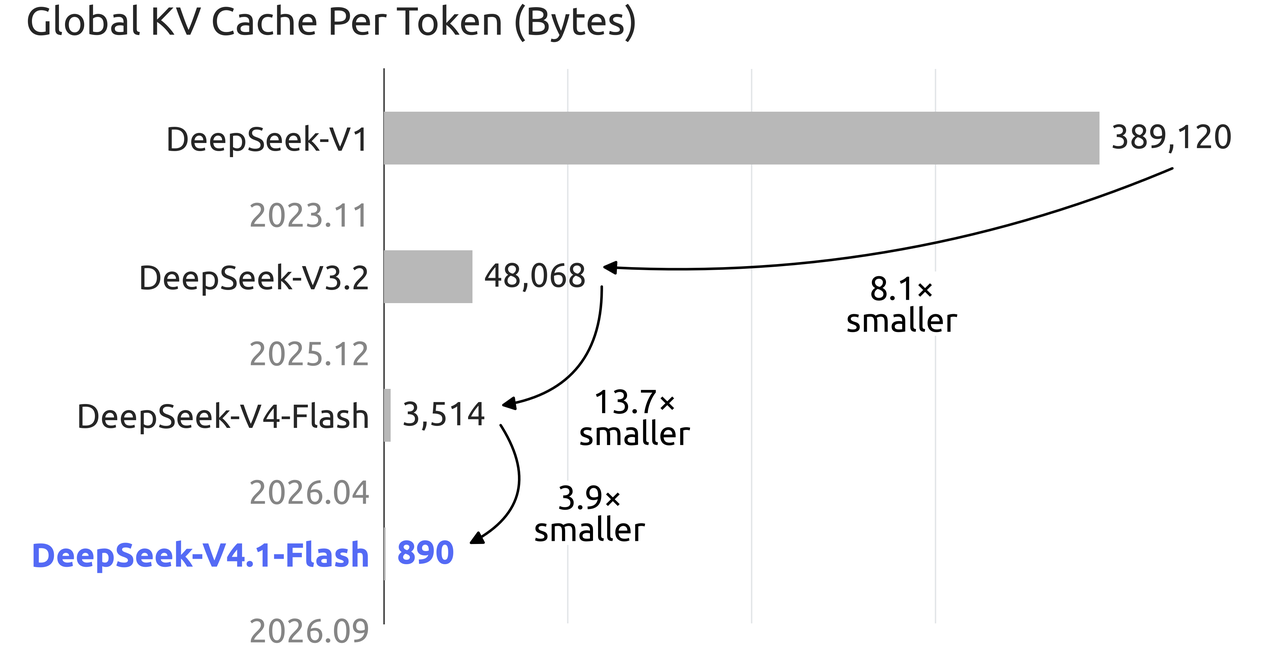
공식 DeepSeek KV 캐시 비교? 공식 이미지 소스
코딩과 AI 에이전트에서 DeepSeek V4.1 Flash는 얼마나 강력한가요?
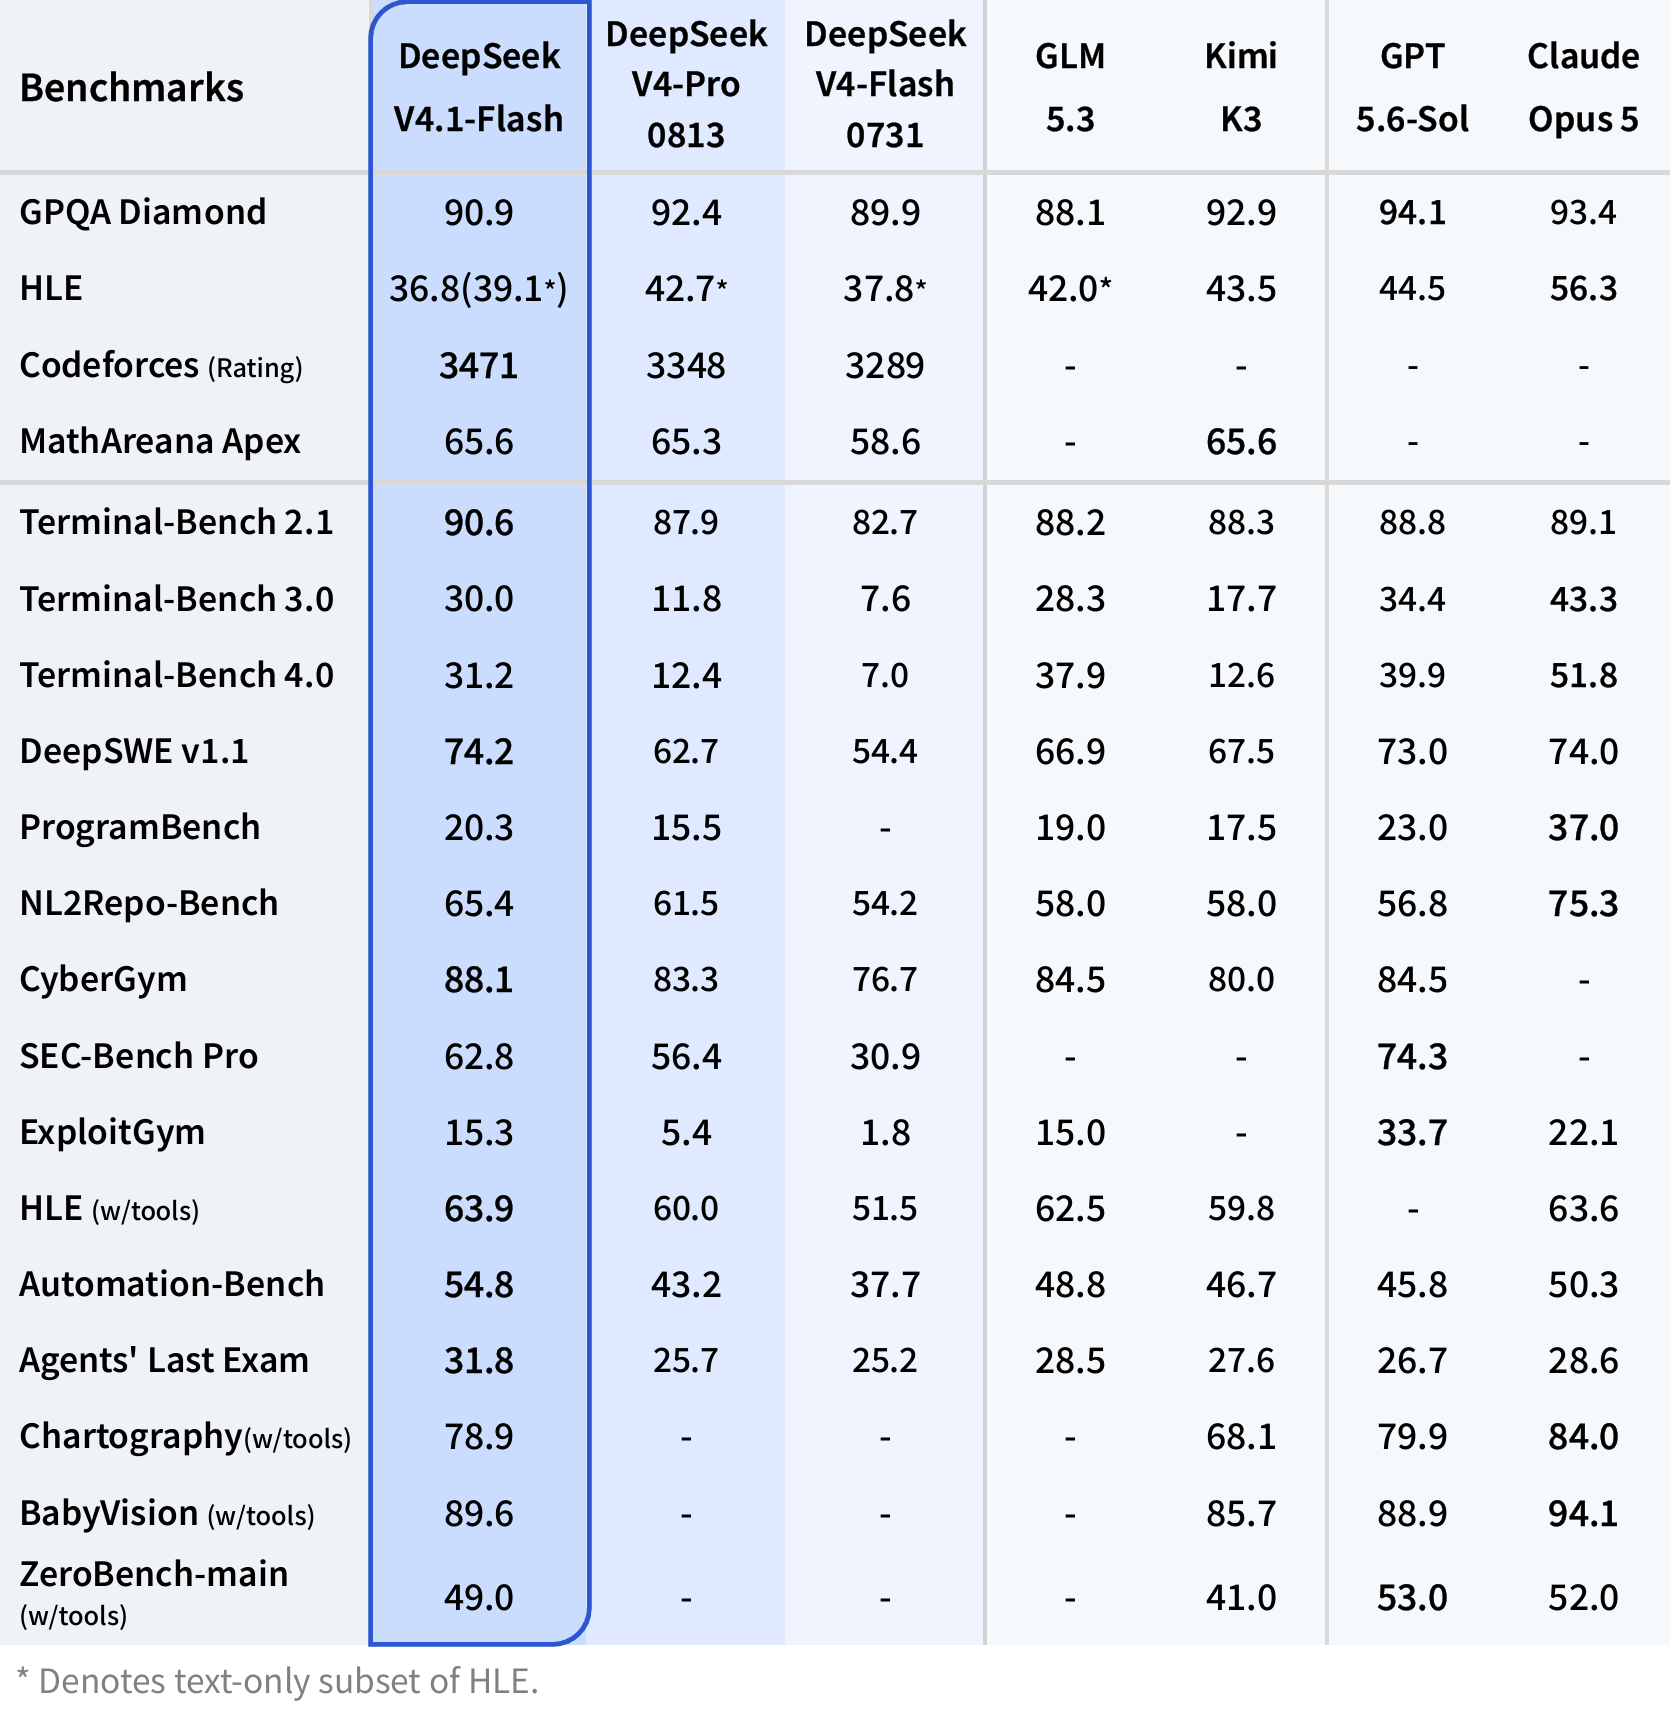
이 가이드는 API 선택에 직접 도움이 되는 벤치마크 증거에 초점을 둡니다. DeepSeek는 공개한 평가 전반에서 V4.1 Flash가 V4 Pro를 포함한 플래그십 모델을 능가한다고 밝힙니다. 가장 실용적인 향상은 터미널 작업, 소프트웨어 엔지니어링, 리포지토리 작업, 자동화, 도구 보조 에이전트에 나타납니다. 다만 프로덕션 팀은 자체 프롬프트와 완료 기준으로 모델을 검증해야 합니다.
| 벤치마크 | DeepSeek V4.1 Flash | DeepSeek V4 Pro | DeepSeek V4 Flash |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| HLE with tools | 63.9 | 60.0 | 51.5 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
실무 결론은 “V4.1이 더 똑똑하다”보다 좁습니다. DeepSeek V4.1 Flash는 반복적인 도구 사용, 터미널 액션, 리포지토리 규모 코딩, 자동화, 긴 에이전트 경로에서 특히 매력적입니다. 순수 지식 또는 추론 작업에서는 다른 순위가 나올 수 있습니다.
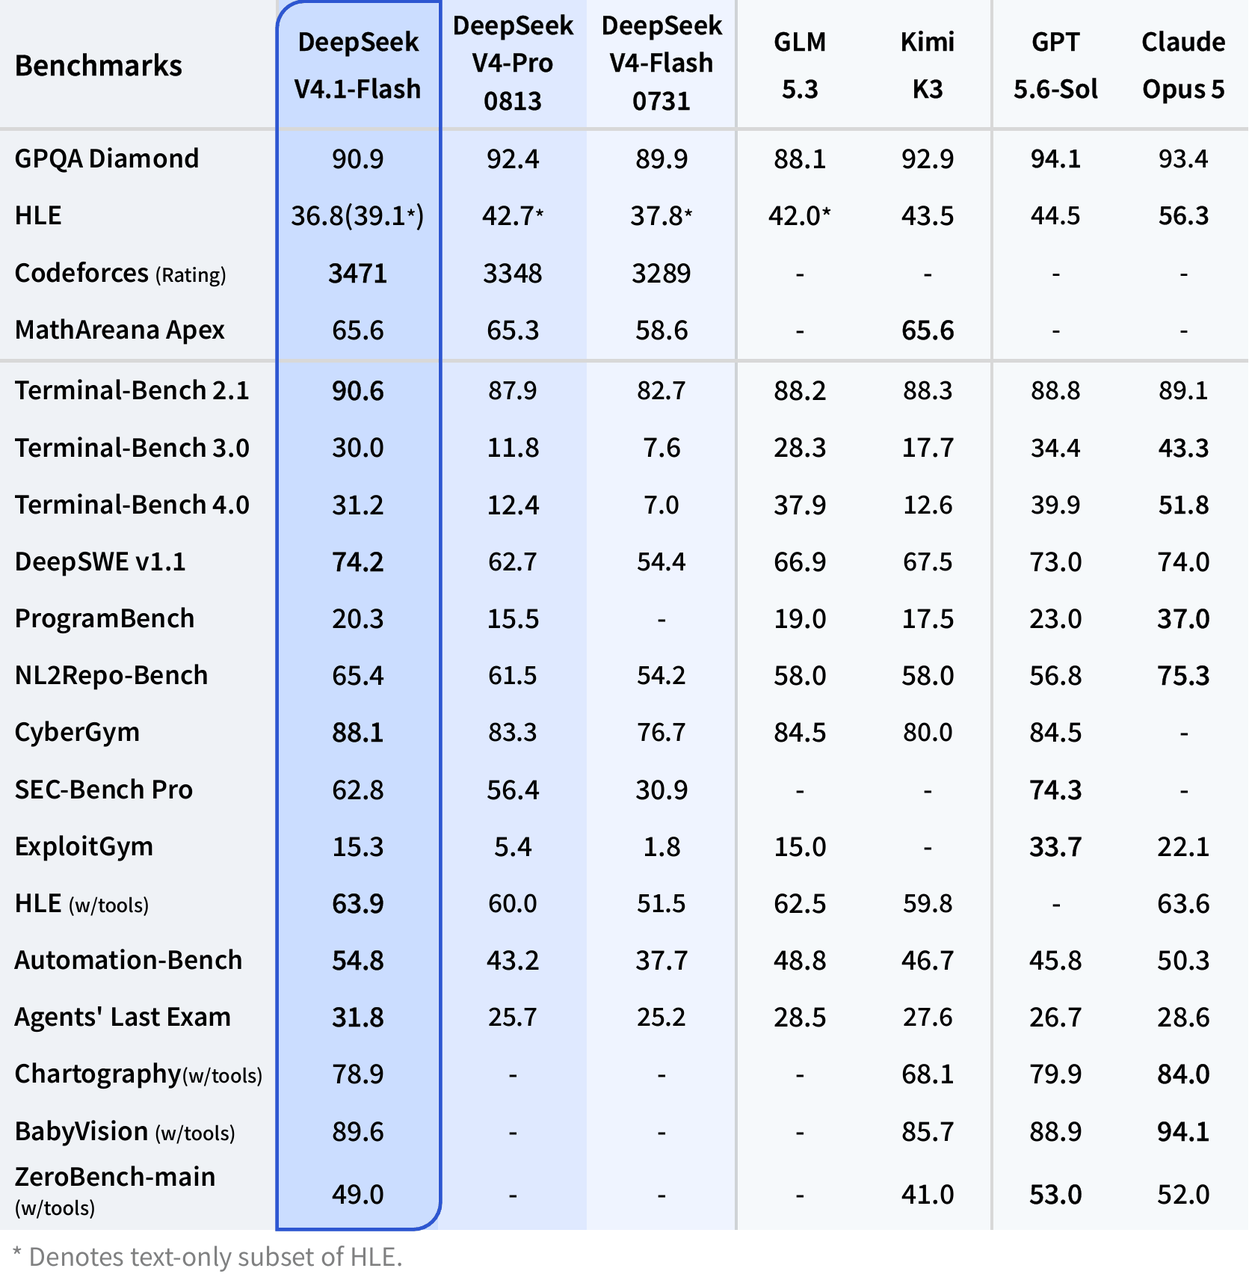
공식 DeepSeek 벤치마크 결과? 공식 이미지 소스
왜 CometAPI를 통해 DeepSeek V4.1 Flash API를 사용할까요?
주요 연동 장점은 CometAPI의 DeepSeek V4.1 Flash API가 다른 모델에 사용하던 OpenAI 호환 클라이언트 패턴으로 호출 가능하다는 점입니다. 멀티 모델 애플리케이션에서 SDK 변경을 줄일 수 있습니다.
| 설정 | 값 |
|---|---|
| Base URL | https://api.cometapi.com/v1 |
| Chat endpoint | /chat/completions |
| Model ID | deepseek-v4.1-flash |
| Authentication | Bearer API key |
| Python SDK | OpenAI SDK 호환 |
| JavaScript SDK | OpenAI SDK 호환 |
이는 흔한 연동 실수를 피하는 데도 도움이 됩니다: DeepSeek 1차 식별자를 CometAPI 요청에 복사하는 일입니다. 두 공급자 라우트는 동일한 모델 계열을 가리키지만, 문서화된 모델 ID는 다릅니다.
| 구분 | CometAPI DeepSeek V4.1 Flash | DeepSeek 공식 API |
|---|---|---|
| Base URL | https://api.cometapi.com/v1 | https://api.deepseek.com |
| Model | deepseek-v4.1-flash | deepseek-flash |
| Interface | OpenAI 호환 | OpenAI 호환 |
| Base/off-peak input | $0.12/M base | $0.15/M 오프피크 캐시 미스 |
| Base/off-peak output | $0.48/M base | $0.60/M 오프피크 |
| Cache read/hit | $0.0024/M base | $0.003/M 오프피크 |
CometAPI로 DeepSeek V4.1 Flash에 연결하기
API 키와 Base URL 구성
CometAPI API 키를 생성하고 환경 변수에 저장한 뒤, OpenAI 호환 base URL을 https://api.cometapi.com/v1.로 설정하십시오. 프로덕션 자격 증명을 소스 코드에 포함하지 마십시오.
export COMETAPI_KEY="YOUR_COMETAPI_KEY"
``````sh
$env:COMETAPI_KEY="YOUR_COMETAPI_KEY"
첫 API 요청 보내기
표준 Chat Completions 엔드포인트에서 CometAPI 모델 식별자 deepseek-v4.1-flash를 사용하십시오.
curl "https://api.cometapi.com/v1/chat/completions"
  -H "Content-Type: application/json"
  -H "Authorization: Bearer ${COMETAPI_KEY}"
  -d '{
    "model": "deepseek-v4.1-flash",
    "messages": [
      {
        "role": "user",
        "content": "Explain three ways to reduce latency in a high-throughput API service."
      }
    ]
  }'
성공 응답은 익숙한 OpenAI 스타일 completion 구조를 사용하므로, 이미 choices[0].message.content를 읽는 애플리케이션은 마이그레이션 작업이 최소화됩니다.
Python SDK 예시
pip install openai
``````python
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Write a Python retry helper with exponential backoff."
        }
    ],
)

print(response.choices[0].message.content)
프로덕션에서는 명시적 타임아웃, 제한된 재시도, 요청 로깅, 사용량 모니터링을 추가하십시오.
JavaScript SDK 예시
npm install openai
``````js
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
});

const response = await client.chat.completions.create({
  model: "deepseek-v4.1-flash",
  messages: [
    {
      role: "user",
      content: "Create a typed rate limiter interface for an Express API."
    }
  ],
});

console.log(response.choices[0].message.content);
클라이언트 추상화는 그대로 유지되며, base URL과 모델 ID만 공급자 구성으로 전환됩니다.
DeepSeek V4.1 Flash API 기능
추론 및 Thinking 모드 구성
DeepSeek는 thinking 및 non-thinking 동작 모두를 문서화합니다. CometAPI를 경유할 때, 공급자별 필드가 기대대로 정확히 패스스루되는지 프로덕션 계약으로 의존하기 전에 확인하십시오.
response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant distributed job scheduler."
        }
    ],
    reasoning_effort="high",
    extra_body={
        "thinking": {"type": "enabled"}
    },
)
공급자 매핑이 다를 수 있으므로, 각 지원 수준을 자체 지연 시간, 토큰 사용량, 작업 완료 목표에 대해 측정하십시오.
비전 입력으로 이미지 분석
DeepSeek V4.1 Flash는 JPEG, PNG, GIF, WebP 이미지를 수용합니다. 공식 제한은 인라인 이미지 32 MiB, 파일 기반 이미지 64 MiB, 요청당 최대 600장, 외부 이미지 URL 길이 8,192자입니다. 이미지는 system 또는 assistant 메시지가 아닌 user 또는 developer 메시지에 포함해야 합니다.
response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "Identify the three most important anomalies."},
                {
                    "type": "image_url",
                    "image_url": {"url": "https://example.com/dashboard.png"}
                }
            ]
        }
    ],
)
프로덕션에서 사용하는 정확히 그 CometAPI 라우트에서 이미지 크기, URL 접근성, 전처리, 토큰 사용량, 지연 시간을 검증하십시오.
SSE로 응답 스트리밍
스트리밍은 점진적 출력을 제공하여 인터랙티브 코딩, 채팅, 에이전트 인터페이스의 체감 지연 시간을 줄입니다.
stream = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Explain distributed-cache invalidation."
        }
    ],
    stream=True,
)

for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
프로덕션 클라이언트는 중단된 스트림, 빈 델타, 타임아웃 복구, 재시도 한계, 최종 사용량 집계를 처리해야 합니다.
DeepSeek V4.1 Flash API 비용은 얼마인가요?
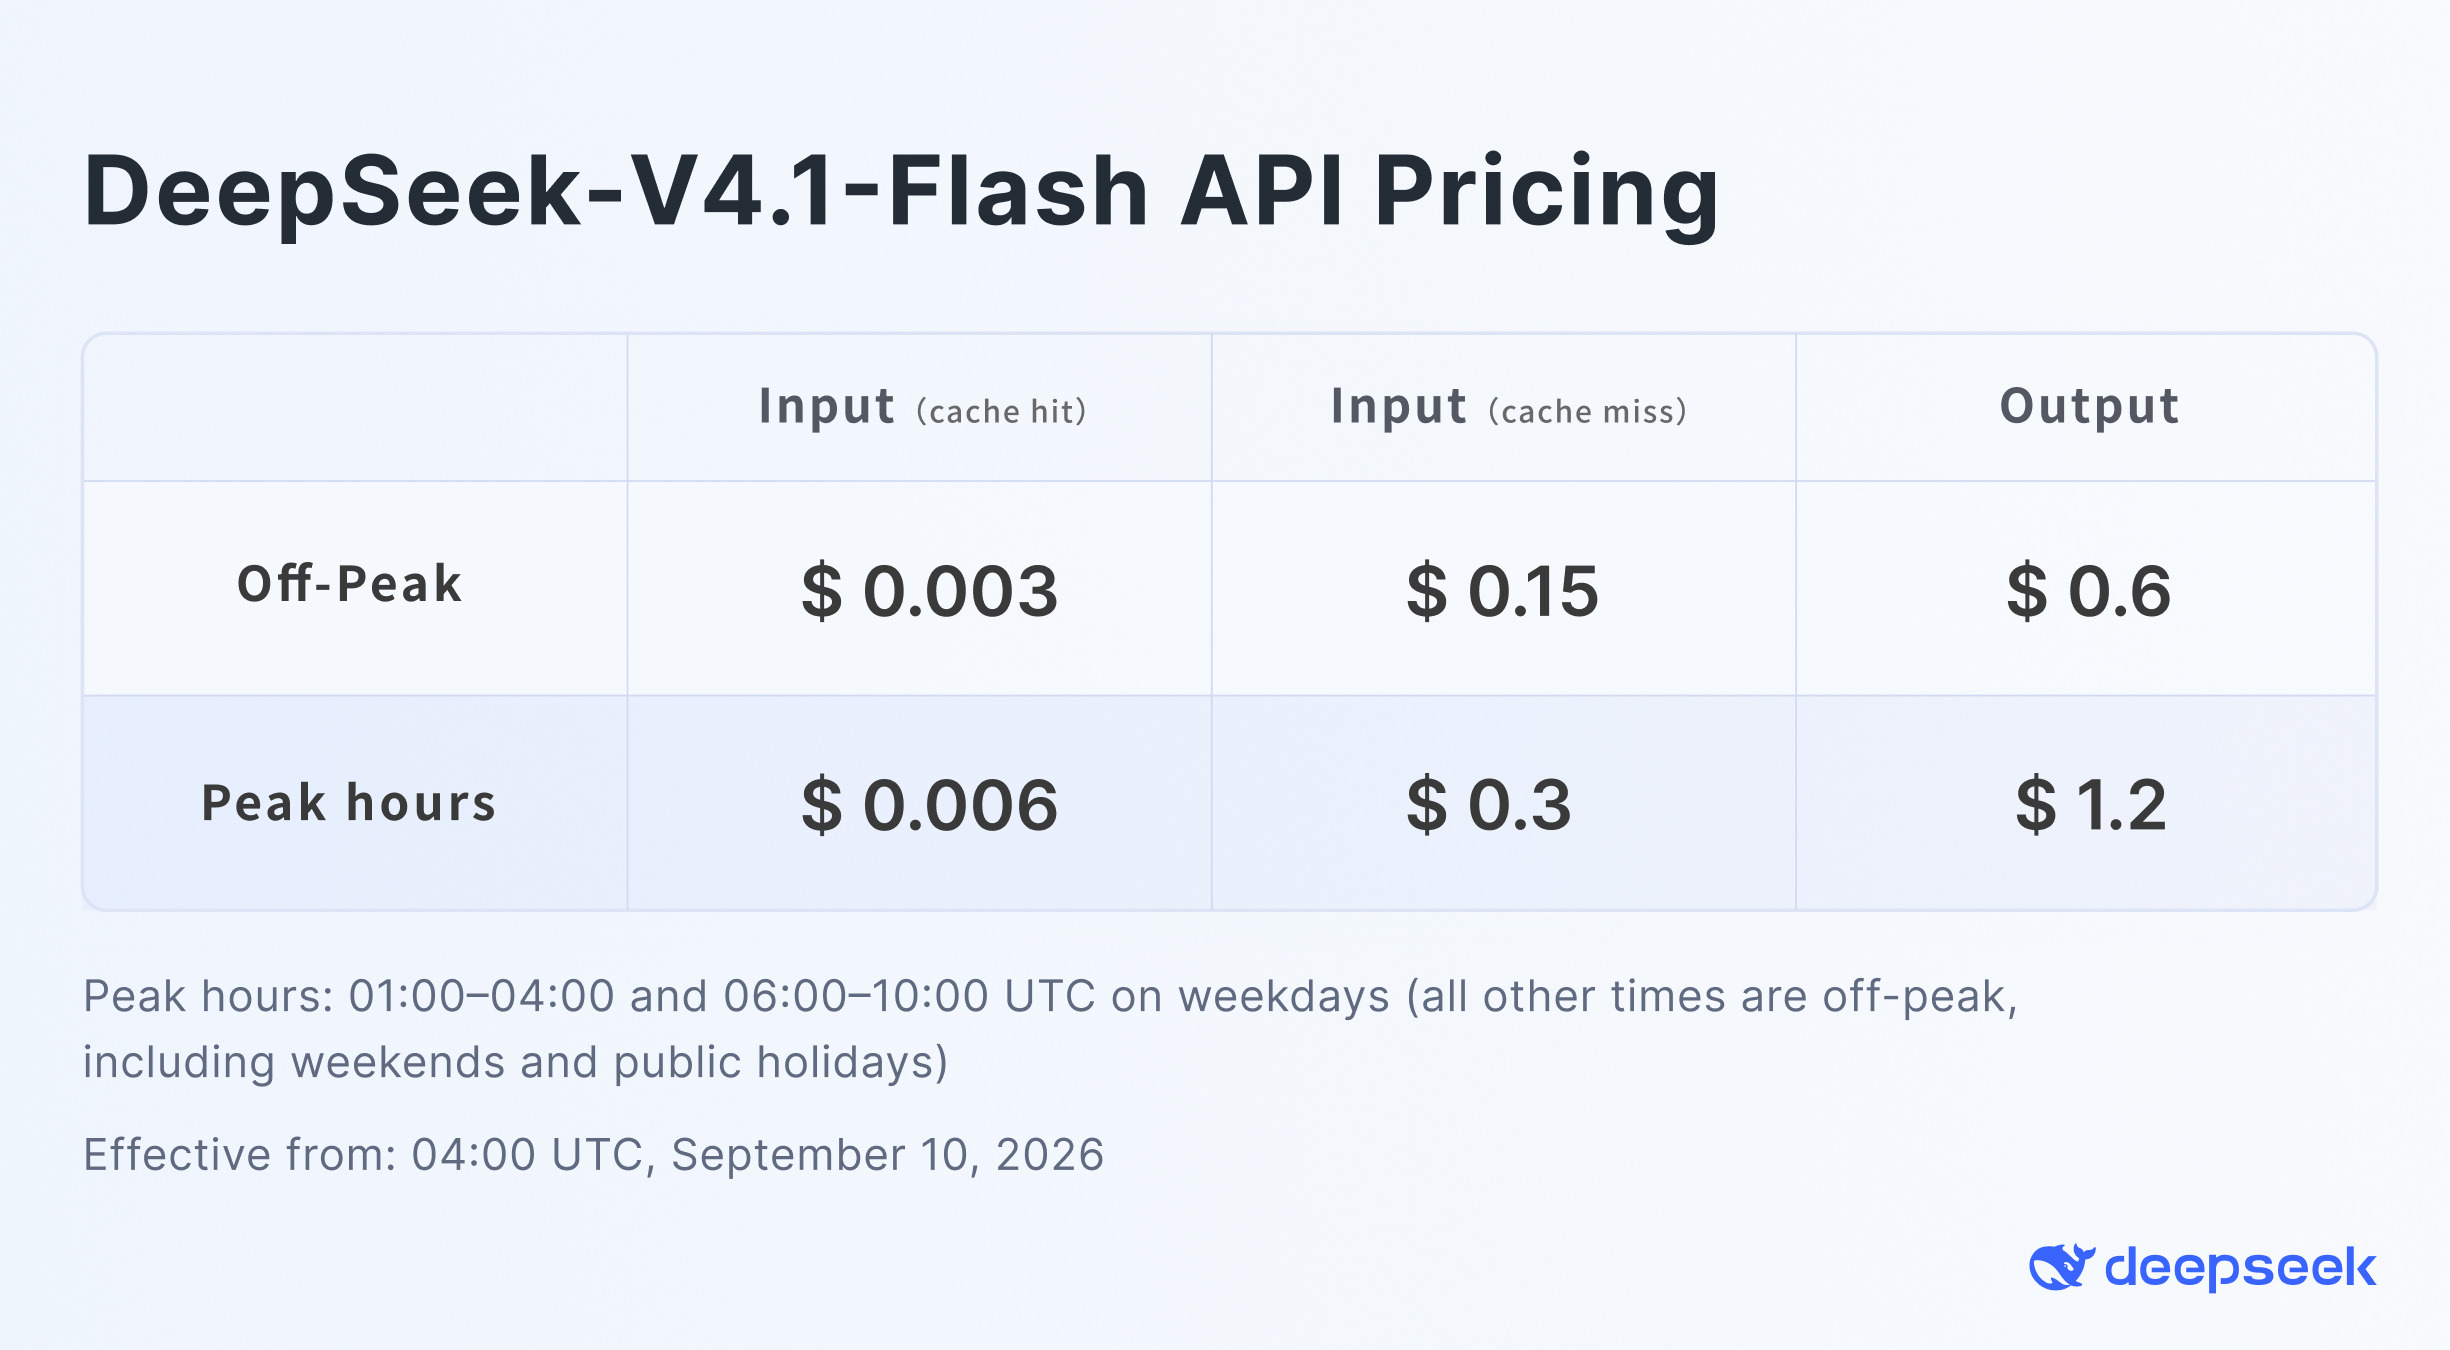
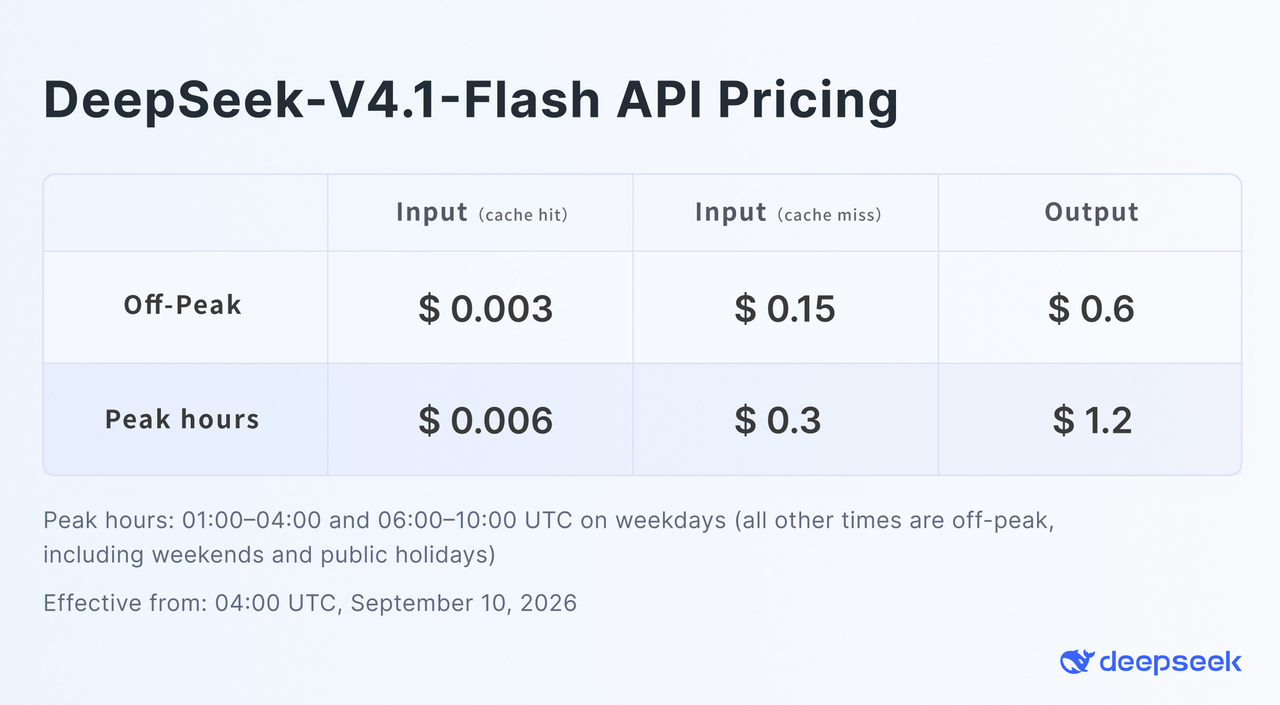
DeepSeek의 문서화된 API 가격은 피크/오프피크 창을 사용합니다. 공식 가격 이미지는 오프피크 기준으로 캐시 히트 입력 $0.003/M, 캐시 미스 입력 $0.15/M, 출력 $0.60/M를 보여줍니다. 피크 요금은 2배입니다.
공식 DeepSeek V4.1 Flash API 가격? 공식 이미지 소스
| 토큰 범주 | CometAPI DeepSeek V4.1 Flash | DeepSeek 공식 가격 |
|---|---|---|
| 입력 / 캐시 미스 | $0.1200/M base | $0.15/M 오프피크 |
| 출력 | $0.4800/M base | $0.60/M 오프피크 |
| 캐시 읽기 / 캐시 히트 | $0.0024/M base | $0.003/M 오프피크 |
| 피크 승수 | 해당 창에서 2배 | 해당 창에서 2배 |
| 평일 피크 창 1 | 01:00-04:00 UTC | 01:00-04:00 UTC |
| 평일 피크 창 2 | 06:00-10:00 UTC | 06:00-10:00 UTC |
100M 캐시 미스 입력 토큰과 20M 출력 토큰의 간단한 기본 요금 예시는 다음과 같습니다:
Input:
100 x $0.12 = $12.00

Output:
20 x $0.48 = $9.60

Total base cost:
$21.60
실제 프로덕션 비용은 캐시된 토큰 비율, 피크 승수, 요청 조건, 현재 공급자 요금에 따라 달라집니다. 캐시 히트와 캐시 미스 가격 차이가 매우 크므로, 시스템 지침, 도구 스키마, 공통 컨텍스트 같은 재사용 가능한 프리픽스를 안정적으로 유지하는 것이 중요한 비용 레버입니다.
DeepSeek V4.1 Flash API vs V4 Pro vs V4 Flash
| 구분 | DeepSeek V4.1 Flash | DeepSeek V4 Pro | DeepSeek V4 Flash |
|---|---|---|---|
| 주요 포지셔닝 | 효율적 추론, 에이전트, 비전 | 고급 V4 추론 | 이전 세대 빠른 V4 티어 |
| 네이티브 비전 | 예 | 모델/라우트별 | 이전 세대에서 별도 비전 라우트 |
| Thinking | 예 | 예 | 예 |
| 에이전트 성능 | 많은 공개 에이전트 테스트에서 셋 중 가장 강함 | 강함 | 공개 테스트에서 V4.1보다 낮음 |
| 1차 정식 ID | deepseek-flash | deepseek-v4-pro | 레거시/호환 별칭 |
| CometAPI ID | deepseek-v4.1-flash | deepseek-v4-pro | deepseek-v4-flash |
| 최적 적합 | 신규 고용량 에이전트/코딩 워크로드 | Pro에서 검증된 특정 워크로드 | 레거시 호환성과 비교 |
현재 상태: DeepSeek의 라이브
에 따르면 DeepSeek V4 Pro는 2026년 9월 14일 이후에도 변동 없이 과금되며 사용 가능합니다. 라우팅 또는 마이그레이션 동작에 의존하기 전에 라이브 문서를 확인하십시오.
DeepSeek V4.1 Flash API를 프로덕션에 투입하기 전 무엇을 테스트해야 하나요?
- 모델 라우팅: CometAPI에서 deepseek-v4.1-flash를 확인하고, 공급자별 ID를 애플리케이션 로직이 아닌 구성에 저장하십시오.
- 프롬프트 회귀: 대표적인 프로덕션 프롬프트를 실행하고 벤치마크 점수뿐 아니라 작업 완료율을 비교하십시오.
- 구조화 출력: 모든 JSON 응답을 애플리케이션 스키마에 대해 검증하고, 복구 또는 재시도 경로를 정의하십시오.
- 도구 호출: 인자 타입, 잘못된 호출, 병렬 호출, 루프 종료 조건을 테스트하십시오.
- Thinking 제어: CometAPI가 어떤 필드를 패스스루하는지 확인하고, 각 설정의 지연 시간과 토큰 영향도를 측정하십시오.
- 비전: 실제 스크린샷과 문서로 테스트하고, 크기 제한, 접근 불가 URL, 지원되지 않는 메시지 역할을 포함하십시오.
- 스트리밍: 빈 델타, 중단된 연결, 재시도 경계, 최종 사용량 집계를 처리하십시오.
- 장문 컨텍스트와 캐싱: 프롬프트 길이가 증가할 때 답변 품질, 캐시 히트 비율, 비용을 측정하십시오.
- 신뢰성: p50, p95, p99 지연 시간을 기록하고 429, 5xx, 타임아웃, 폴백 경로를 검증하십시오.
- 비용 관리: 완료된 작업당 입력, 캐시된 입력, 추론, 출력 토큰을 추적하십시오.
에이전트 워크로드의 경우, 백만 토큰당 비용뿐 아니라 작업당 비용을 비교하십시오. 모델이 출력 토큰당 더 비싸더라도 재시도와 도구 호출을 줄이면 전체 비용이 더 낮을 수 있습니다. 반대로 높은 reasoning effort가 토큰만 늘리고 작업 완료를 개선하지 못하면 비용이 증가할 수 있습니다.
DeepSeek V4.1 Flash API는 사용할 가치가 있나요?
새로운 DeepSeek 연동에서는, DeepSeek V4.1 Flash가 향상된 공개 에이전트 성능, 네이티브 비전, 공격적인 가격을 결합하여 Flash 계열의 강력한 기본 후보입니다.
가장 강한 사용 사례는 단순 일반 채팅이 아닙니다. 더 적합한 영역은 코딩 에이전트, 자동화된 소프트웨어 엔지니어링, 장문 컨텍스트 분석, 멀티모달 어시스턴트, 반복 컨텍스트가 총비용을 지배할 수 있는 도구 사용 에이전트입니다.
OpenAI 스타일 SDK 아키텍처를 유지하려는 개발자에게 CometAPI의 DeepSeek V4.1 Flash API는 본 가이드 전반에서 사용한 연동 패턴을 제공합니다: 표준 클라이언트 인터페이스를 유지하고 https://api.cometapi.com/v1로 지정한 뒤, deepseek-v4.1-flash를 사용하십시오.
DeepSeek V4.1 Flash API FAQ
공급자별 모델 ID는 어떻게 구성해야 하나요?
공급자, base URL, 모델 ID를 환경별 구성에 함께 저장하십시오. 이렇게 하면 DeepSeek 1차 ID인 deepseek-flash가 deepseek-v4.1-flash를 기대하는 CometAPI 라우트로 잘못 전송되는 일을 방지할 수 있습니다.
장기 실행 에이전트에서 캐시 재사용을 어떻게 개선할 수 있나요?
안정적인 시스템 지침, 도구 스키마, 공유 참조 컨텍스트를 프롬프트의 시작 부분에 유지하십시오. 변동성이 큰 사용자 입력과 도구 결과는 뒤에 추가하여 재사용 가능한 프리픽스가 덜 변하도록 하십시오.
V4.1 Flash와 V4 Pro를 비교하는 가장 안전한 방법은?
동일한 프로덕션 작업 집합을 재생하고, 재시도 예산을 제한한 뒤, 완료율, 지연 시간, 도구 호출 수, 총 토큰을 비교하십시오. 토큰 단가가 낮다고 해서 작업당 비용이 자동으로 낮아지는 것은 아닙니다.
에이전트는 어떤 폴백 정책을 사용해야 하나요?
어떤 실패가 재시도 가능한지 정의하고, 엄격한 재시도 상한을 설정하며, 안전하게 재개하는 데 필요한 도구 상태를 보존한 후에만 폴백 모델을 선택하십시오. 모든 폴백을 로깅하여 조용한 품질 드리프트를 가시화하십시오.
이미지를 전송하기 전에 어떻게 검증해야 하나요?
실제 파일 시그니처, 지원 포맷, 바이트 크기, URL 접근성, 메시지 역할을 확인하십시오. 불필요한 메타데이터를 제거하고, 보존/접근 정책이 명시적으로 허용하지 않는 한 민감한 이미지는 전송하지 마십시오.
Chat Completions 대신 Responses API를 언제 고려해야 하나요?
기존 OpenAI 호환 메시지 워크플로를 유지할 때는 Chat Completions를 사용하십시오. 입력 항목 타입, 도구 출력 이미지, JSON Schema 출력이 애플리케이션에 이점이 있다면 Responses API를 고려하고, 선택한 공급자 라우트가 필요한 필드를 지원하는지 확인하십시오.
스키마 검증 실패는 어떻게 처리해야 하나요?
다운스트림 시스템에 도달하기 전에 잘못된 출력을 거부하고, 검증 오류를 기록한 뒤, 제한된 수의 복구 프롬프트로 재시도하십시오. 반복된 복구가 실패하면 그럴듯하지만 잘못된 JSON을 수용하는 대신 안전한 폴백으로 작업을 라우트하십시오.