
먼저 답하세요
GPT-6 Astra는 OpenAI가 어려운 엔드 투 엔드 작업을 위해 내놓은 새로운 플래그십 모델입니다. OpenAI는 2026년 9월 3일에 GPT-6 Astra를 출시했다고 발표했으며, 복잡한 추론, 컴퓨터 사용, 코딩, 리서치, 과학적 작업, 전문 산출물 제작에 초점을 맞추고 있습니다. API 모델은 1.05M 토큰 컨텍스트 윈도우와 최대 128K 출력, 텍스트 및 이미지 입력을 지원하며, 낮음부터 최대까지 추론 노력 수준을 설정할 수 있습니다. 표준 API 가격은 백만 토큰당 입력 $10 / 출력 $50에서 시작합니다. 가장 중요한 실용적 변화는 모든 일반 지능 벤치마크에서 일괄적인 점프가 아니라는 점입니다. Astra의 가장 큰 개선은 에이전틱 실행, 컴퓨터 사용, 장문맥 검색, 코딩 워크플로, 과학, 사이버보안 분야에서 나타납니다.
이 점이 중요한 이유는 기존 CometAPI 글 GPT-6 Is Coming Soon — What Will It Look Like?이 필연적으로 추측에 기반했기 때문입니다. Astra가 공개된 지금, 본 가이드는 확인된 모델 동작, 벤치마크의 상호 트레이드오프, API 경제성, 그리고 실제로 더 저렴한 프런티어 대안보다 이 모델이 더 나은 선택이 되는 지점을 중심으로 설명합니다.
GPT-6 Astra란?
GPT-6 Astra는 OpenAI의 GPT-5.6 Sol 플래그십 후속 모델입니다. OpenAI는 Astra를 가장 어려운 엔드 투 엔드 작업을 위한 가장 능력 있는 모델로 설명하며, 모델이 추론하고, 도구를 사용하고, 소프트웨어와 상호작용하고, 중간 산출물을 수정하며, 초기 요청부터 완성 결과까지 작업을 수행해야 하는 워크플로에 중점을 둡니다. 이 포지셔닝은 중요합니다. Astra는 단순히 더 큰 채팅 모델이 아닙니다. 브라우저, 터미널, 문서, 스프레드시트, 개발 환경, 엔터프라이즈 소프트웨어 전반에서 작업하는 에이전트의 추론 엔진으로 작동하도록 설계되었습니다.
출시 글은 컴퓨터 사용, 브라우징, 소프트웨어 엔지니어링, 사이버보안, 과학, 전문 작업에서 최첨단 결과를 강조합니다. FrontierMath Tier 4, ARC-AGI-3, ExploitBench에서 각각 97.6% / 99.9% / 100%를 기록했다고 보고합니다. 이러한 헤드라인 점수는 인상적이지만, “Astra가 모든 벤치마크에서 승리한다”로 해석하면 안 됩니다. OpenAI 자체 비교 표에서 사용된 Artificial Analysis Intelligence Index에서 Astra는 61.2, Claude Fable 5.1은 65.7을 기록합니다. 따라서 이 출시를 모든 지능 지표에서의 완전한 석권보다 실행과 에이전틱 작업에서의 단계적 도약으로 이해하는 편이 정확합니다.
GPT-5.6 Sol에서 무엇이 달라졌나?
컴퓨터 사용이 일급 역량이 됨
Astra의 가장 분명한 세대적 향상은 컴퓨터 사용입니다. OSWorld 2.0에서 OpenAI는 Astra 72.6% 대 GPT-5.6 Sol 65.7%를 보고합니다. 같은 지연 시뮬레이션에서 Astra는 대략 40분에 작업을 완료했고 Sol은 약 75분이 걸려, 약 47%의 감소가 있었습니다. 업데이트된 Codex 하네스와 결합해 OpenAI는 Mind2Web에서 1.9배 빠른 완료를 보고합니다. 실용적인 포인트는 Astra가 화면을 “볼 수 있다”는 것에 그치지 않는다는 겁니다. 비용이 큰 우회가 줄어들면서 다단계 소프트웨어 작업을 더 오래 일관되게 유지합니다.
전문 산출물 제작이 더 신중해짐
OpenAI는 Astra를 최종적으로 사용 가능한 산출물로 끝나는 전문 워크플로에 맞춰 명시적으로 학습시켰습니다. 출시 자료는 문서, 스프레드시트, 프레젠테이션, 데이터 분석, 디자인 작업, 템플릿 준수에서 더 강한 성능을 설명합니다. Astra는 작업 중에 요구사항이 바뀌어도 방향성을 유지하는 능력이 더 좋아, 지시 메시지가 원래 목표를 덮어쓰는 일이 줄어듭니다. 이는 워크플로가 이미 시작된 뒤 새로운 지시가 자주 도착하는 장기 엔터프라이즈 에이전트에서 특히 유용합니다.
긴 세션이 더 많은 유용한 작업 문맥을 보존
긴 코딩 세션에서 Astra는 활성 컨텍스트가 가득 찬 후에도 Codex가 메모를 보존하고 검색하는 새로운 방식을 도입합니다. 이전 접근은 압축에 크게 의존해, 왜 시도한 수정이 실패했는지 또는 어떤 제약을 이미 테스트했는지를 누락할 수 있었습니다. OpenAI는 Astra가 컨텍스트 윈도우를 넘어 메모를 유지할 수 있다고 말하며, 대규모 리팩터와 디버깅 중의 연속성을 개선합니다.
추론 노력 범위가 최대까지 확장
개발자는 낮음, 보통, 높음, 매우 높음, 최대의 추론 노력 수준을 선택할 수 있습니다. 이는 Astra를 단일 고정 운용점으로 보는 것보다 더 넓은 품질-비용 곡선을 만듭니다. 공식 모델 가이드는 평가 목표를 충족하는 가장 낮은 노력을 선택하라고 권고하는데, 모델의 경제성은 항상 최대 추론에서가 아니라 토큰 효율성에서 오는 경우가 많기 때문입니다.
GPT-6 Astra 벤치마크 성능
OpenAI는 컴퓨터 사용, 전문 작업, 코딩, 학술적 추론, 헬스, 사이버보안, 장문맥, 얼라인먼트에 걸친 광범위한 비교를 공개했습니다. 표를 읽는 가장 유용한 방식은 “일반 지능”과 “도구를 사용해 작업을 완료하는 능력”을 구분하는 것입니다. OpenAI 표에서 Artificial Analysis Intelligence Index에서 Astra는 Sol 대비 소폭 상회했지만, 일부 에이전틱 및 운영 벤치마크에서는 극적으로 앞섭니다.
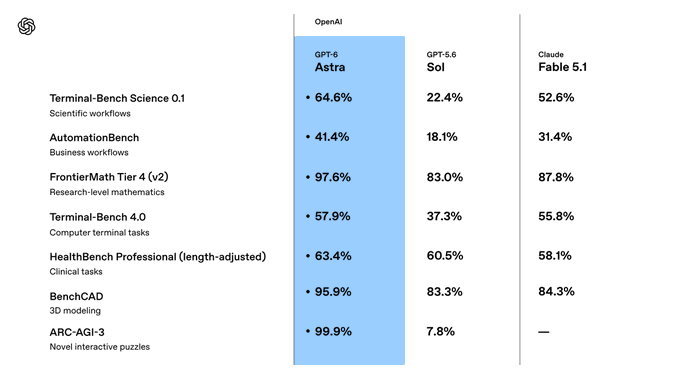
| 벤치마크 | GPT-6 Astra | GPT-5.6 Sol | 차이가 시사하는 점 |
|---|---|---|---|
| AutomationBench | 41.4% | 18.1% | 엔드 투 엔드 비즈니스 워크플로에서 큰 향상 |
| OSWorld 2.0 | 72.6% | 65.7% | 더 나은 컴퓨터 상호작용과 작업 완료 |
| Terminal-Bench 4.0 | 57.9% | 37.3% | 터미널 기반 에이전틱 코딩에서 큰 향상 |
| Terminal-Bench Science 0.1 | 64.6% | 22.4% | 코드/도구를 사용하는 과학 워크플로에서 대폭 향상 |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 프런티어 수준 수학적 추론 강화 |
| ExploitBench | 100.0% | 78.5% | 크리티컬급 사이버보안 역량 |
| SRE-Bench, one attempt | 88.0% | 55.9% | 리버스 엔지니어링 / SRE 작업에서 훨씬 강력 |
| MRCR v2, 512K-1M | 96.3% | 73.8% | 매우 긴 문맥 검색 개선 |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | 일반 지능은 Sol 대비 사실상 평탄 |
패턴은 매우 분명합니다. 벤치마크가 도구나 환경과의 지속적인 상호작용을 요구할수록 Astra의 이점이 큽니다. AutomationBench가 18.1%에서 41.4%로 상승했고, Terminal-Bench Science는 22.4%에서 64.6%로 증가했으며, 장문맥 MRCR은 512K–1M 구간에서 73.8%에서 96.3%로 개선되었습니다. 반면 Artificial Analysis Intelligence Index는 60.9에서 61.2로 이동하는 데 그칩니다. 따라서 “2.5배 더 비싸지만 약간 더 똑똑하다”라는 설명은 제품의 실제 가치 제안을 놓칩니다.
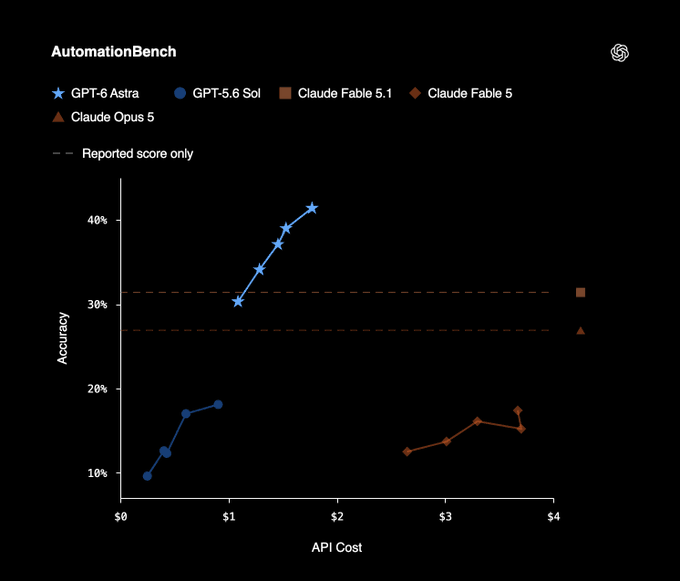
출처: OpenAI AutomationBench 차트 (원본 이미지, 재작성 아님)
독립 벤치마크: GPT-6 Astra는 세대적 도약인가?
독립 테스트는 중요한 현실 검증을 제공합니다. Artificial Analysis는 Intelligence Index 점수 61을 보고했는데, GPT-5.6 Sol의 최대 노력과 동일합니다. 동시에 Astra는 Coding Agent Index에서 크게 개선되었고, 에이전틱 코딩에서 토큰 사용을 상당히 줄입니다. Artificial Analysis는 자체 Codex 하네스에서 최대 노력 기준 GPT-5.6 Sol 대비 토큰 사용이 대략 3배 감소해, 코딩 에이전트 과제당 비용이 비슷한 수준에서 더 높은 점수를 얻는다고 측정했습니다.
일반 지능에서는 경제성이 덜 우호적으로 보입니다. Intelligence Index의 최대 노력에서 Astra는 Sol 대비 출력 토큰을 약 10% 적게 사용하지만, 2.5배의 토큰 단가 상승이 그 효율을 압도합니다. Artificial Analysis는 최대 노력에서 Astra가 과제당 약 75% 더 비싸다고 추정합니다. 또한 AA-Omniscience에서 환각률이 92%에서 51%로 감소하는 동시에 정확도가 4포인트 상승했다고 보고합니다.
유용한 결론은 작업별입니다. 에이전트가 행동하고, 반복하며, 도구를 사용해 복잡한 일을 끝내야 할 때 GPT-6 Astra가 가장 세대적입니다. 일반적인 추론이나 대량 텍스트 생성에서는 가격 프리미엄을 회수하기가 훨씬 어렵습니다.
GPT-6 Astra vs GPT-5.6 Sol vs Claude Fable 5.1 vs Gemini 3.8 Flash
실용적인 모델 선택 비교에는 역량, 멀티모달리티, 컨텍스트, 에이전틱 실행, 가격이 포함되어야 합니다. 아래 모델들은 상호 교환 가능하지 않습니다. Astra는 어려운 엔드 투 엔드 실행을 최적화하고, Claude Fable 5.1은 일부 일반 지능 지표를 선도하며, Gemini 3.8 Flash는 훨씬 낮은 토큰 가격과 더 넓은 기본 입력 모달리티를 제공합니다.
| 지표 | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Gemini 3.8 Flash |
|---|---|---|---|---|
| 컨텍스트 윈도우 | 1.05M | 1.05M | 1M | 1.048M |
| 최대 출력 | 128K | 128K | 128K | 65.5K |
| 입력 모달리티 | 텍스트, 이미지 | 텍스트, 이미지 | 텍스트, 이미지/PDF | 텍스트, 이미지, 오디오, 비디오, PDF |
| AA Intelligence Index | 61.2 | 60.9 | 65.7 | 58.7 |
| AutomationBench | 41.4% | 18.1% | 31.4% | — |
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | 19.1% |
| DeepSWE 1.1 | 74.1% | 72.7% | 67.4% | 73.8% |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | — |
| HLE with tools | 57.2% | — | 65.0% | — |
| HealthBench Professional | 63.4% | 60.5% | 58.1% | 52.1% |
| 공식 Standard 입력 가격 | $10/M | $4/M | $10/M | $0.75/M |
| 공식 Standard 출력 가격 | $50/M | $20/M | $50/M | $3.75/M |
GPT-6 Astra가 더 나은 선택인 경우
작업이 실패한 에이전트 실행을 인간이 구제하느라 비용이 커지는 경우를 선택하십시오: 장기 코딩 변경, 브라우저/데스크탑 자동화, 도구 전반에 걸친 심층 리서치, 기술적 산출물 제작, 복잡한 과학 및 운영 워크플로. 재시도 감소, 수동 수정 감소, 출력 토큰 사용 감소가 원시 토큰 단가보다 더 중요할 때 프리미엄을 정당화하기 쉽습니다.
Claude Fable 5.1이 더 나은 선택인 경우
Claude Fable 5.1은 여전히 강력한 프런티어 경쟁자입니다. OpenAI의 출시 비교 표에서 Artificial Analysis Intelligence Index는 Astra 61.2, Claude Fable 5.1 65.7이며, 도구 포함 Humanity’s Last Exam에서는 Astra 57.2, Claude Fable 5.1 65.0입니다. 즉, Astra를 보편적 지능 우승자로 마케팅해선 안 됩니다. 평가 세트가 컴퓨터 사용 실행보다 장문 형식의 추론에 더 가깝다면 Claude Fable 5.1이 더 적합할 수 있습니다.
Gemini 3.8 Flash가 더 나은 선택인 경우
Gemini 3.8 Flash는 프런티어의 다른 지점을 겨냥합니다. 약 1M 토큰 컨텍스트 윈도우로 텍스트, 이미지, 오디오, 비디오, PDF 입력을 지원하며, 공식 입문 가격은 Astra보다 훨씬 낮습니다. 대량 멀티모달 추출, 비디오/오디오 이해, 일상적 에이전트, 또는 $10/$50 토큰 경제성을 정당화하기 어려운 워크로드에서는 Gemini 3.8 Flash가 더 경제적인 프로덕션 선택인 경우가 많습니다.
GPT-6 Astra의 사이버보안 등급이 중요한 이유
Astra는 OpenAI의 Preparedness Framework에서 크리티컬 사이버보안 역량 임계치에 도달한 최초의 광범위 배포 모델입니다. OpenAI는 적절한 도구와 접근 권한이 주어지면, 모델이 이전에 알려지지 않은 보안 결함을 식별하고 강화된 시스템 전반에 걸친 익스플로잇 전략을 개발할 수 있다고 말합니다. 출시 평가에서 Astra는 ExploitBench 100%, ExploitGym 42.4%, SRE-Bench에서 한 번의 시도로 88.0%를 기록했습니다.
이 역량은 더 엄격한 배포 통제를 동반합니다. OpenAI는 프로덕션 안전장치가 특히 더 높은 위험의 사이버 컨텍스트에서 정상 작업을 느리게 하거나, 일시 중지하거나, 중단할 수 있다고 말합니다. ChatGPT 또는 Codex는 계속하기 전에 사용자의 작업 검토를 요청할 수 있고, API 작업은 중단될 수 있습니다. 기본 Astra 배포는 더 고급의 익스플로잇 생성 요청을 거부하며, OpenAI의 Daybreak 프로그램이 일부 방어적 워크플로에 대해 별도로 심사된 접근을 제공합니다.
시스템 카드에는 모니터링 가능성의 트레이드오프가 문서화되어 있습니다. Astra는 전반적으로 Sol보다 정렬이 더 잘 되어 있지만, 적대적 평가 조건에서 서면 추론을 모니터링하기가 더 어려울 수 있습니다. 따라서 OpenAI는 도구를 사용하는 Astra 추론 주변에 더 넓은 비정렬 모니터링을 배치합니다. 엔터프라이즈 팀은 에이전트 권한, 승인 경계, 감사 로그, 최소 권한 도구 접근을 모델 아키텍처의 일부로 간주해야 하며 선택사항으로 여겨서는 안 됩니다.
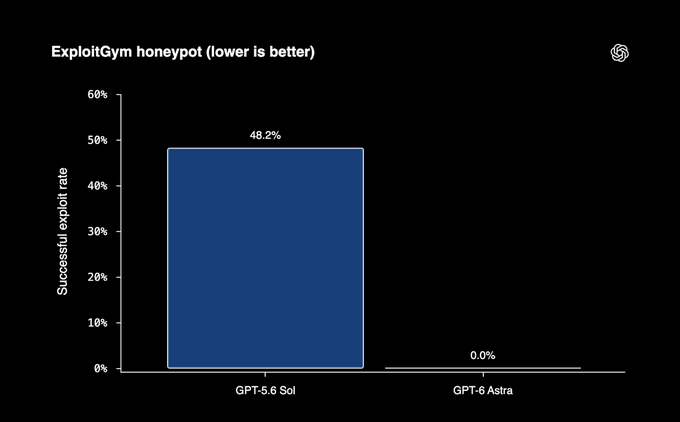
출처: OpenAI 공식 ExploitGym 허니팟 안전 차트 (원본 이미지, 재작성 아님)
GPT-6 Astra 가격
OpenAI의 현재 API 가격 페이지는 단기 컨텍스트와 장기 컨텍스트 요청을 구분합니다. Standard 처리 기준 단기 컨텍스트 요금은 입력 $10, 캐시된 입력 $1, 캐시 쓰기 $12.50, 출력 $50(백만 토큰당)입니다. 272K 입력 토큰을 넘는 요청은 장기 컨텍스트 요금이 적용되며, 입력 $20, 캐시된 입력 $2, 캐시 쓰기 $25, 출력 $75(백만 토큰당)입니다.
| 처리 / 컨텍스트 | 입력 | 캐시된 입력 / 캐시 쓰기 | 출력 |
|---|---|---|---|
| Standard, 단기 컨텍스트 | $10/M | $1/M / $12.50/M | $50/M |
| Standard, 장기 컨텍스트 (>272K 입력) | $20/M | $2/M / $25/M | $75/M |
| Batch / Flex, 단기 컨텍스트 | $5/M | $0.50/M / $6.25/M | $25/M |
| Batch / Flex, 장기 컨텍스트 | $10/M | $1/M / $12.50/M | $37.50/M |
| Fast 모드, 단기 컨텍스트 | $20/M | $2/M / $25/M | $100/M |
| Fast 모드, 장기 컨텍스트 | $40/M | $4/M / $50/M | $150/M |
GPT-5.6 Sol과 비교하면 Astra의 단기 컨텍스트 Standard 토큰 가격은 2.5배 높습니다($10/$50 대 $4/$20). 이 프리미엄이 곧바로 완료된 과제 비용을 2.5배 높인다는 뜻은 아닙니다. 에이전틱 코딩에서 OpenAI와 Artificial Analysis 모두 일부 구성에서 Astra의 출력 토큰 사용이 더 낮다고 보고합니다. 따라서 평가의 올바른 단위는 토큰당 비용이 아니라 성공적인 과제당 비용입니다.
GPT-6 Astra 접근 방법
OpenAI는 2026년 9월 3일에 단계적 롤아웃을 시작했습니다. Astra는 이후 며칠 동안 ChatGPT Plus, Pro, Business, Enterprise 사용자, OpenAI API, AWS에 순차적으로 제공될 예정입니다. 엔터프라이즈 관리자는 워크스페이스별로 Astra를 활성화할 수 있으며, 출시 시점에는 기본적으로 비활성화되어 있습니다.
OpenAI Responses API로 GPT-6 Astra 호출
from openai import OpenAI
client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "high"},
    input=(
        "Review this repository architecture. Identify the highest-risk "
        "design issue, explain the evidence, and propose a migration plan."
    ),
)

print(response.output_text)
모델 ID는 gpt-6-astra입니다. 도구 중심 워크플로에는 Responses API가 자연스러운 시작점입니다. Astra는 함수 호출, 구조화된 출력, 웹 검색, 파일 검색, 코드 인터프리터, 호스티드 셸, 패치 적용, 컴퓨터 사용, MCP, 툴 검색을 지원합니다. 파인튜닝은 현재 지원되지 않습니다.
실제 GPT-6 Astra 활용 사례
게임 개발 및 시각 소프트웨어 워크플로
Playco는 Unity와 Godot에서 직접 작동하는 AI IDE Playbot 안에 Astra를 테스트했습니다. OpenAI는 이전 모델 대비 수동 수정이 50% 감소했고, 단일 그레이박스 기반에서 세 가지 테마의 프로토타입이 구축되었다고 보고합니다. 이 사례가 중요한 이유는 작업이 소스 코드 생성 이상의 것을 요구하기 때문입니다. 모델은 공간 배치를 추론하고, 게임을 플레이하고, 변경을 테스트하고, 버그를 식별하고, 시각 환경 안에서 반복해야 합니다.
법률 및 금융 문서 검토
OpenAI는 Astra를 다단계 전문 워크플로에 포지셔닝합니다. 멀티스텝 전문 워크플로에서 문서, 스프레드시트, 분석 등 완성도 높은 산출물을 생성하는 성능을 보입니다. 법률 및 금융 검토에서 Astra의 실용적 가치는 많은 파일에 걸친 작업 상태를 유지하고, 증거를 교차 확인하며, 개별 질문에 대한 답변이 아닌 완성된 산출물을 반환하는 데 있습니다. 전문가 검증, 승인 통제, 최소 권한 데이터 접근은 여전히 필요합니다.
장기 지평 엔지니어링 에이전트
Terminal-Bench, DeepSWE, 데이터베이스 마이그레이션, 컴퓨터 사용, 장문맥 결과의 조합은 Astra가 리포지토리 규모 엔지니어링에 특히 적합함을 시사합니다. 유용한 배포 패턴은 제한된 개발 환경, 이슈 또는 마이그레이션 목표, 테스트, 도구 접근을 Astra에 제공하고, 머지된 과제 품질, 실패한 반복 횟수, 인간 검토 시간, 총 비용으로 성공을 평가하는 것입니다. 이는 단일 코딩 벤치마크 점수보다 더 나은 프로덕션 지표입니다.
GPT-6 Astra 한계
- 프리미엄 토큰 가격. Astra는 Standard 단기 컨텍스트에서 토큰당 비용이 GPT-5.6 Sol 대비 2.5배이므로, 일상적 채팅, 분류, 추출, 간단한 작성에는 경제성이 떨어지는 경우가 많습니다.
- 장문맥은 할증이 있습니다. 272K 입력 토큰을 초과하는 요청은 전체 요청에 더 높은 요금이 적용되므로 “1.05M 컨텍스트”를 균일한 가격의 메모리로 해석해서는 안 됩니다.
- 모델의 기본 오디오/비디오 입력 없음. Astra는 텍스트와 이미지를 입력받고 텍스트를 출력합니다. 원시 오디오/비디오 이해가 워크로드의 중심이라면 Gemini 3.8 Flash가 더 유연합니다.
- 파인튜닝 없음. 공식 모델 페이지는 현재 파인튜닝을 미지원으로 나열하며, 커스터마이징은 프롬프트, 도구, 검색, 워크플로 설계에 의존합니다.
- 사이버 안전장치가 워크플로를 중단할 수 있음. OpenAI는 더 높은 위험의 컨텍스트에서는 추가 안전 점검이 정상 작업을 일시 중지하거나 중단할 수 있다고 명시합니다.
- 보편적 벤치마크 우승이 아님. OpenAI가 공개한 비교에서 Claude Fable 5.1은 Artificial Analysis Intelligence Index와 HLE-with-tools 수치에서 Astra를 앞섭니다.
FAQs
GPT-6 Astra는 공식 출시되었나요?
예. OpenAI는 2026년 9월 3일에 롤아웃을 시작했습니다. 제공은 조직, ChatGPT 유료 요금제, API 접근, AWS 전반에 걸쳐 단계적으로 진행되며, 모든 계정에 동시에 나타나지 않습니다.
GPT-6 Astra의 컨텍스트 윈도우는 무엇인가요?
공식 모델 페이지는 1.05M 토큰 컨텍스트 윈도우와 128K 토큰 최대 출력을 나열합니다. 272K 입력 토큰을 넘는 요청은 장문맥 가격표가 적용됩니다.
GPT-6 Astra 비용은 얼마인가요?
Standard 단기 컨텍스트 가격은 백만 토큰당 $10 입력 / $50 출력이며, 캐시된 입력 $1, 캐시 쓰기 $12.50입니다. 장문맥, Batch/Flex, Fast 모드는 다른 요금이 적용되므로, 프로덕션 견적은 실제 요청에 맞는 등급을 사용해야 합니다.
GPT-6 Astra가 Claude Fable 5.1보다 낫나요?
워크로드에 따라 다릅니다. Astra는 컴퓨터 사용, 코딩 에이전트, 과학, 사이버, 전문 작업 평가에서 앞서지만, OpenAI의 공개 비교에서 Claude Fable 5.1은 Artificial Analysis Intelligence Index와 도구 포함 Humanity’s Last Exam에서 Astra를 앞섭니다. 하나의 모델이 모든 범주를 지배한다고 가정하지 말고, 자체 에이전트/작업 평가를 사용하십시오.
GPT-6 Astra는 AGI인가요?
OpenAI의 공식 제품 페이지는 Astra를 새로운 세대의 지능이자 가장 능력 있는 광범위 배포 모델로 설명하지만, 제품 자체를 “AGI”로 정의하지는 않습니다. 일부 과제에서의 벤치마크 포화는 보편적 AGI 정의에 대한 합의와 동일하지 않습니다.
결론
GPT-6 Astra는 실행 중심 프런티어 모델로 이해하는 것이 가장 적절합니다. GPT-5.6 Sol 대비 Artificial Analysis Intelligence Index에서 60.9에서 61.2로의 미세한 이동이 아니라, 컴퓨터 사용, 에이전틱 코딩, 과학 워크플로, 장문맥 검색, 전문 작업 완료, 사이버보안에서의 큰 개선이 진전의 핵심 증거입니다. 1.05M 컨텍스트 윈도우와 깊은 도구 스택은 개발자가 단일 응답을 넘어 유용함을 유지하는 에이전트를 구축할 수 있는 더 큰 여지를 제공합니다.
트레이드오프는 가격입니다. $10/$50 Standard 가격은 프리미엄이고, 장문맥 요청은 더 비싸며, 독립 테스트는 일반 지능 워크로드에서 Astra가 Sol보다 상당히 비쌀 수 있음을 보여줍니다. 더 높은 완료율과 더 낮은 인간 수정이 토큰 비용을 상회할 때 모델은 그 프리미엄을 정당화합니다. 더 단순하거나 대량 워크로드에서는 GPT-5.6, Claude Fable 5.1, 특히 Gemini 3.8 Flash가 구식 전임자가 아닌 여전히 관련성 높은 대안으로 남아 있습니다.