
요약
OpenAI Decisions API는 텍스트와 이미지를 생성된 산문이 아닌 실행 가능한 기계 판독 결정으로 변환하는 특화 엔드포인트입니다. GPT-6 Luna를 사용하며 판정형(predicate), 선택형(choice), 점수형(score) 질문을 지원합니다. OpenAI는 지원되는 결정 작업에서 Responses API 대비 약 10× 더 빠른 성능과 $0.10/백만 토큰의 표준 입력 요금을 보고했습니다.
핵심 요점
- 목적 지향형 결정: 자유로운 대화가 아니라 미리 정의된 질문 기반.
- 세 가지 결정 유형: 판정형(predicate), 선택형(choice), 점수형(score).
- 확률을 고려한 자동화: 모호하거나 결과가 중대한 입력은 인간 검토로 라우팅.
- 공급업체 보고 기준의 속도 향상과 입력만 과금되는 $0.10/백만 토큰 표준 요금으로 대량 결정 워크로드에 적합.
- 라우팅, 분류, 시각적 점검, AI 에이전트 결정 게이트에 적합.
OpenAI Decisions API란?
OpenAI Decisions API는 정보를 평가해 경계가 명확하고 기계가 읽을 수 있는 결정을 반환합니다. OpenAI는 이를 2026년 10월 6일 베타로 출시했습니다(https://developers.openai.com/api/docs/changelog). 이 가이드는 API 키와 JSON을 이미 이해하고 분류나 라우팅 워크플로를 평가하려는 개발자를 위한 것입니다. 제품 세부사항은 2026년 10월 12일 기준으로 확인되었습니다.
POST /v1/decisions 요청 스키마는 모델, 공유 텍스트 또는 이미지 입력, 그리고 개발자 정의 질문을 받습니다. 전용 엔드포인트는 설명적 산문이 아닌 타입이 지정된 판단을 반환합니다.
OpenAI Decisions API 사양
| 사양 | 문서에 기재된 엔드포인트 세부정보 |
|---|---|
| 제품 유형 | 특화된 API 엔드포인트(독립형 기반 모델 아님) |
| 엔드포인트 | POST /v1/decisions |
| 기반 모델 | gpt-6-luna |
| 입력 | 텍스트와 이미지 |
| 결정 유형 | predicate, choice, score |
| 출력 | 타입이 지정된 결정과 확률 정보 |
| 성능 | Responses API 대비 약 10× 더 빠름(공급업체 주장) |
| 표준 입력 요금 | $0.10 / 1M tokens |
| 출력 요금 | Decisions API는 없음 |
| 툴 호출/스트리밍 | 이 엔드포인트에서 직접 지원되지 않음 |
현재 제공 상태와 접근
2026년 10월 15일 기준, 공식 가이드는 공개 베타 접근을 안내하며, 지원 모델은 gpt-6-luna 하나입니다. 요청은 POST /v1/decisions로 전송합니다. 베타 상태는 프로덕션 안정성을 보장하지 않습니다.
OpenAI API 프로젝트를 사용하고, 배포 전에 모델 접근 권한, 결제 상태, 속도 제한을 확인하세요. 가이드는 Python SDK 3.26.0 이상을 명시합니다. 계정별 접근은 작은 테스트 요청으로 확인하세요.
자격을 갖춘 고객은 Zero Data Retention 및 HIPAA 약정을 사용할 수 있습니다. 가이드는 미국 및 유럽 지역 처리 옵션을 나열합니다. 자격 및 계약 요건은 여전히 적용됩니다. 타사 Luna 인터페이스를 통한 접근은 이 전용 엔드포인트와의 호환성을 보장하지 않습니다.
OpenAI Decisions API는 어떻게 동작하나?
요청은 공유 입력 증거와 개발자 정의 질문을 결합합니다. API는 GPT-6 Luna로 입력을 평가하고, 애플리케이션 코드가 자동화, 검토, 에스컬레이션에 사용할 수 있는 답을 반환합니다. 여러 질문이 동일한 입력을 공유할 수 있지만, 의존적인 질문은 애플리케이션에서 순차 처리해야 합니다.
판정형(predicate) 평가
판정형은 특정 조건이 성립하는지를 평가합니다. 예를 들어 소매업체는 사진에 가시적 제품 손상이 있는지 물을 수 있으며, 응답은 0과 1 사이의 확률을 제공합니다.
예시 판정형 응답 발췌.
{
  "type": "predicate",
  "name": "visible_damage",
  "probability": 0.92
}
선택형(choice) 선택
선택형 질문은 Billing, Technical Support, Account Access와 같이 명시적으로 제공된 범주 중에서 선택합니다. 분포와 신뢰도 필드는 이후 라우팅 및 에스컬레이션 정책을 지원합니다.
점수형(score) 평가
점수형 질문은 정렬된 루브릭에 따라 입력을 평가합니다. 예상 점수는 정의된 레벨의 확률 가중 인덱스를 반영할 수 있으나, 이것이 자동으로 현실의 교정된 위험을 의미하지는 않습니다.
| 인덱스 | 심각도 | 해석 |
|---|---|---|
| 0 | 낮음 | 즉각 조치 불필요 |
| 1 | 보통 | 일상적 후속 조치 |
| 2 | 높음 | 중대한 고객 영향 |
| 3 | 치명적 | 즉시 에스컬레이션 |
주요 기능은 무엇인가?
빠르고 경계가 명확한 실행
타입 지정 출력은 산문 생성, 텍스트 파싱, 잘못된 답 재시도 필요성을 상당 부분 제거합니다. OpenAI는 지원되는 결정 작업에서 상대적으로 약 10배의 속도 향상을 설명하지만, 실제 이득은 입력 길이, 네트워크 오버헤드, 동시성에 따라 달라집니다.
공유 컨텍스트에 대한 다중 질문
하나의 지원 티켓을 한 번의 요청에서 부서, 긴급도, 검토 적합성으로 평가할 수 있습니다. 애플리케이션은 여전히 결정론적 비즈니스 규칙과 권한 검사를 강제해야 합니다.
텍스트 및 이미지 이해
텍스트와 이미지는 티켓 라우팅, 스크린샷 분류, 시각 점검에 활용됩니다. 지원 이미지 포맷, 크기 제한, 현재 허용되는 페이로드 구조는 공식 문서를 참조하세요.
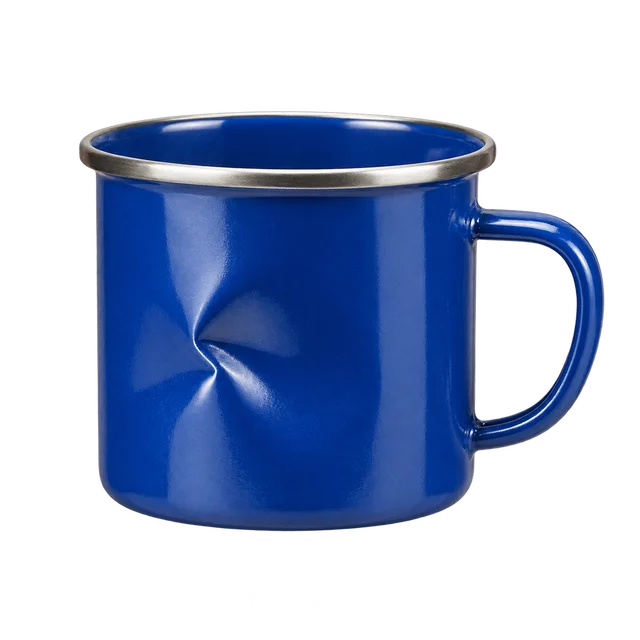
OpenAI는 시각 결정 예시에서 이 찌그러진 머그 컵을 사용합니다. 이미지는 관측 가능한 손상을 보여주지만, 측정된 정확도율의 증거는 아닙니다. 이 엔드포인트는 호스팅된 이미지 URL이나 파일 ID가 아니라 인라인 base64 이미지 데이터 URL을 받습니다.
확률을 고려한 자동화
보고된 신뢰도는 정확도를 보장하지 않습니다. 팀은 라벨링된 홀드아웃 데이터로 임계값을 조정하고, 오검출/미검출의 결과가 큰 경우 별도 임계값을 사용해야 합니다.
보안 및 데이터 통제
데이터 보존, 지역 처리, 규제 사용은 계정 구성과 적용 가능한 계약 요건에 달려 있습니다. 규제되거나 민감한 정보를 처리하기 전에 적격성을 확인하세요.
비용은 얼마인가?
보고된 표준 요금은 전용 Decisions 엔드포인트를 통해 출력 토큰 과금 없이 입력 토큰 백만 개당 $0.10입니다. 지역 처리 또는 긴 컨텍스트 배율이 최종 비용을 변경할 수 있습니다.
| 항목 | 전용 엔드포인트 요금 |
|---|---|
| 표준 입력 | $0.10 per 1M tokens |
| 출력 토큰 | $0 |
| 캐시 읽기/쓰기 | $0 |
| 지역 처리 | 프리미엄이 적용될 수 있음 |
| 긴 컨텍스트 | 배수가 적용될 수 있음 |
| 과금 단위 | 입력 토큰 |
Decisions API는 Responses API 대비 얼마나 절감할 수 있나?
동일 모델에서 동등한 작업을 비교하세요. Decisions 가이드는 입력 백만 토큰당 $0.10과 출력/캐시 요금 없음으로 안내합니다. Luna 모델 페이지는 일반 모델 사용 시 표준 텍스트 요금을 비캐시 입력 $0.10/M, 출력 $0.50/M으로 안내합니다.
예시 계산이며 벤치마크가 아닙니다: 텍스트 요청 1,000,000건, 각 엔드포인트에서 요청당 비캐시 과금 입력 토큰 500개, 요청당 분류 1회, 지역/긴 컨텍스트 프리미엄 없음. Responses의 경우 보이는 답 길이가 아니라 과금된 모든 출력 토큰(과금되는 추론 토큰 포함)을 사용하세요.
이 가정에서: Decisions cost = N × I × $0.10 / 1,000,000. Responses cost = N × (I × $0.10 + O × $0.50) / 1,000,000. Savings percentage = (Responses cost − Decisions cost) / Responses cost × 100%, 여기서 N은 요청 수, I는 요청당 입력 토큰, O는 요청당 과금된 출력 토큰입니다.
| 청구된 Responses 출력/요청 | Decisions 비용/100만 요청 | Responses 비용/100만 요청 | 추정 절감액 |
|---|---|---|---|
| 5 tokens | $50.00 | $52.50 | $2.50 (4.8%) |
| 20 tokens | $50.00 | $60.00 | $10.00 (16.7%) |
| 100 tokens | $50.00 | $100.00 | $50.00 (50.0%) |
위 절감액은 가정된 Responses 출력 과금에서 비롯됩니다. 고정된 엔드포인트 할인은 아닙니다. 실제 입력 사용량, 캐시 적중/기록, 처리 티어, 재시도를 반영해 다시 계산하세요. 캐시된 입력이나 Batch/Flex 요금은 결과를 바꿀 수 있습니다. 툴 비용, 인간 검토, 인프라는 별도입니다. 품질과 지연 시간을 확인한 뒤 승인된 정확 결정당 비용을 비교하세요. 짧은 레이블과 긴 설명은 서로 다른 워크로드입니다.
OpenAI Decisions API vs Responses API vs Jev 및 Aplomb 1
이 표는 전용 결정 서비스에 초점을 맞춥니다. 생성형 설명, 맞춤 추출 스키마, 툴 워크플로가 필요하면 OpenAI decision guide에 설명된 대로 Responses API를 사용하세요. 결정은 워크플로 분기를 선택할 수 있으며, Responses는 콘텐츠를 생성하거나 툴 호출을 요청하고, 애플리케이션 코드는 맞춤 툴 실행을 처리합니다.
기능 및 요금 개요
| 항목 | OpenAI Decisions API | Jev 1.13 | Aplomb 1 |
|---|---|---|---|
| 입력 | 텍스트와 이미지 | 텍스트; 옵트인 기반 실험적 이미지 | 텍스트, JSON, 이미지, 비디오 및 오디오 |
| 표준 입력 요금/백만 토큰 | $0.10 | $0.042 | $0.02 |
| 접근 방식 | 호스팅 OpenAI API | 호스팅 TypeSafe API | 호스팅 API; EmpirioLabs Model License 하의 가중치 다운로드 제공 |
| 평가 적합성 | OpenAI 워크플로에서 라우팅, 필터링, 점수화 | 분류 및 의도 라우팅 | 복합 미디어 결정; 가중치 배포가 필요한 배치 |
선정 범위: Jev와 Aplomb은 게시된 결정 기능 때문에 포함되었으며, 인기도 순위가 아닙니다. 사양과 표준 입력 가격은 2026년 10월 16일 기준으로 확인했습니다. TypeSafe는 여전히 jev-latest를 1.13, jev-preview를 1.14에 매핑하므로 본 비교는 1.13에 고정합니다. Jev의 이미지 지원은 실험적입니다. Aplomb 가중치는 라이선스 제한이 있으므로 상용 배포 전 조건을 확인하세요. 게시된 토큰 가격은 품질 순위나 전체 워크플로 비용의 추정이 아닙니다.
워크플로 선정
필요한 입력과 배포 옵션으로 서비스를 쇼트리스트한 뒤, 동일한 라벨링 사례로 테스트하세요. 입력 준비, 결정 루브릭, 종단간 지연 시간 측정, 인간 검토 정책을 맞추십시오. 라우팅 정확도, 놓친 사례, 검토 작업량, 승인된 정확 결정당 비용을 비교하세요. 낮은 토큰 가격이나 더 빠른 응답이 추가 오류나 검토 비용을 가리지 않도록 함께 보고하세요.
어떻게 OpenAI Decisions API를 사용할 수 있나?
1단계: 자격증명 구성
API 키를 생성하고 OPENAI_API_KEY 환경 변수로 제공하세요. 저장소나 프론트엔드 애플리케이션에 비밀 키를 하드코딩하지 마세요.
2단계: cURL로 요청 보내기
다음 요청은 공식 선택형 예시 스키마를 따릅니다. 실행 전에 OPENAI_API_KEY를 설정하세요. 성공 응답에는 answers 배열이 포함됩니다. 셸 명령은 Bash 문법을 사용합니다.
cURL로 지원 요청을 라우팅.
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [
      {
        "type": "choice",
        "name": "department",
        "instructions": "Which department should handle this complaint?",
        "choices": [
          {"value": "billing", "description": "Payments and refunds"},
          {"value": "technical", "description": "Product issues"},
          {"value": "other", "description": "Everything else"}
        ]
      }
    ]
  }'
3단계: Python으로 통합
필수 Python SDK를 설치합니다.
pip install --upgrade "openai>=3.26.0"
선택형 결정을 요청하고 확인합니다.
from openai import OpenAI

client = OpenAI()
result = client.decisions.create(
    model="gpt-6-luna",
    input="I was charged twice for my order.",
    questions=[{
        "type": "choice",
        "name": "department",
        "instructions": "Which team should handle this request?",
        "choices": [
            {"value": "billing", "description": "Payments and refunds"},
            {"value": "technical", "description": "Product issues"},
            {"value": "other", "description": "Other requests"}
        ]
    }]
)
answer = result.answers[0]
if answer.type == "refusal":
    print("Decision refused")
elif answer.type == "choice":
    print(answer.choice, answer.confidence)
4단계: 에스컬레이션 규칙 정의
예시 라우팅 임계값을 적용합니다.
if answer.type == "choice":
    if answer.choice != "other" and answer.confidence >= 0.90:
        print("Eligible for automatic routing")
    else:
        print("Send to human review")
0.90 임계값은 예시일 뿐이며, 제공자 보장이나 공식 권장 기본값이 아닙니다. 실제 사례와 비즈니스 위험에 따라 검증하세요.
CometAPI를 통해 GPT-6 Luna에 접근하는 방법은?
개발자는 일반 목적 모델 작업을 위해 CometAPI의 GPT-6 Luna API를 사용할 수 있습니다. 이는 전용 OpenAI Decisions 엔드포인트 지원과 혼동하면 안 되며, 별도의 호환성 검증이 필요합니다.
CometAPI Responses를 통해 텍스트를 분류.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)
response = client.responses.create(
    model="gpt-6-luna",
    input=(
        "Classify as billing, technical, or other. "
        "Return only the category. "
        "Request: I was charged twice for my order."
    )
)
print(response.output_text)
이 샘플은 CometAPI 호환 모델 인터페이스를 통한 일반 목적 분류이며, Decisions API의 고유 확률 구조를 반환하지 않거나 해당 입력 전용 요금을 따르지 않습니다.
OpenAI Decisions API의 최적의 사용 사례는 무엇인가?
다음은 보고된 배포나 벤치마크 결과가 아닌 예시 애플리케이션 워크플로입니다. 공식 Decisions 가이드의 판정형, 선택형, 점수형 질문 유형을 사용합니다. 이후 동작은 애플리케이션 코드가 수행합니다.
고객 지원 분류
티켓 텍스트, 관련 대화 기록, 미리 정의된 지원 팀 목록을 제공합니다. 선택형 질문은 Billing, Technical Support, Account Access를 선택할 수 있고, 별도의 점수형 질문은 서면 루브릭에 따라 긴급도를 평가할 수 있습니다. 애플리케이션 코드는 제안된 큐를 할당하고, 불확실하거나 불완전한 사례를 검토자에게 보낼 수 있습니다.
지원 직원이 라벨링한 티켓으로 워크플로를 평가하고, 범주별 라우팅 정확도, 놓친 긴급 사례, 재할당 비율, 검토 작업량을 측정하세요. 배포 확대 전 기존 라우팅 프로세스와 결과를 비교하세요.
콘텐츠 모더레이션 및 검토 큐
제출된 텍스트 또는 이미지와 명확히 정의된 검토 범주를 함께 제공합니다. 판정형 질문은 콘텐츠에 특정 조건이 있는지를 평가하고, 점수형 질문은 문서화된 심각도 루브릭에 따라 검토 우선순위를 정할 수 있습니다. 애플리케이션은 플래그된 항목을 적절한 큐에 배치하고 관련 콘텐츠를 검토자에게 제시합니다. 엔드포인트 자체가 콘텐츠를 제거하거나 플랫폼 규칙을 집행하지는 않습니다.
대표 라벨 예시에서 놓친 위반, 불필요한 플래그, 검토자 합의도, 큐 지연을 평가하세요. 결과가 다른 범주에는 별도의 임계값을 조정하세요.
전자상거래 이미지 검사
제품 사진과 해당 품목에 관련된 검사 기준(가시적 균열, 찢어짐, 포장 손상 등)을 제공합니다. 판정형 질문은 각 조건의 존재 여부를 평가하고, 이미지에 충분한 증거가 있는 경우 점수형 질문은 정의된 심각도 루브릭을 적용할 수 있습니다. 증거가 불명확하면 애플리케이션은 추가 사진을 요청하거나 인간 검사 작업을 생성할 수 있습니다.
검사된 항목을 기준으로 탐지 정확도(품목 카테고리와 이미지 조건 전반의 누락 손상과 오경보 포함)를 평가하세요. 환불 또는 교체 결정은 소매업체의 기존 승인 워크플로에 유지하세요.
AI 에이전트 액션 게이팅
제안된 동작과 그 인수, 관련 사용자 요청, 애플리케이션의 서면 실행 규칙을 제공합니다. 판정형 질문은 제안이 요청된 작업에 부합하는지 또는 검토가 필요한지를 평가할 수 있습니다. 애플리케이션 코드는 결과를 사용해 계속 진행, 명확화 요청, 에스컬레이션 같은 사전 정의 분기를 선택합니다. 독립적인 권한 검사는 여전히 실행 허용 여부를 결정해야 하며, 모델의 판단은 입력 중 하나일 뿐입니다.
라벨링된 동작 제안으로 게이트를 평가하고, 놓친 미허가 동작, 불필요한 에스컬레이션, 불완전/충돌 컨텍스트에 대한 민감도를 측정한 뒤 실행에 연결하세요.
문서 및 이메일 트리아지
문서 또는 이메일 텍스트, 관련 메타데이터, 송장/지원 요청/미팅 요청/기타와 같은 고정 범주 집합을 제공합니다. 선택형 질문은 범주를 선택하고, 판정형 질문은 필수 정보 누락 등 조건을 식별할 수 있습니다. 애플리케이션 코드는 항목을 적절한 추출, 검색, 검토 워크플로로 보낼 수 있으며, 해당 이후 단계는 결정 엔드포인트에 맡기지 않습니다.
대표 라벨 기록에서 범주 정확도, 잘못된 다운스트림 라우팅, 검토 물량, 처리 시간을 평가하세요. 모호한 항목과 낯선 형식도 포함하세요.
OpenAI Decisions API의 한계는 무엇인가?
이 API는 임의의 설명적 콘텐츠를 생성하거나 툴을 직접 실행하지 않으며, 예측 검증의 필요성을 제거하지도 않습니다. 누락된 범주와 불완전한 결정 루브릭은 부적절한 결과를 낳을 수 있습니다. 신뢰도 값은 교정되지 않았을 수 있으므로, 고위험 자동화는 여전히 안전장치, 인간 검토, 권한 부여 로직이 필요합니다.
결론
Decisions API는 타입 지정 확률 출력과 단순화된 토큰 과금 모델을 결합해 대량의 경계가 명확한 판단에 유망합니다. 동일한 라벨 사례, 지연 시간 측정, 전체 워크플로 비용으로 Structured Outputs와 대안 결정 모델과 비교하세요. 핵심 기회는 산문 생성이 아니라 선택이 필요한 AI 애플리케이션 단계의 식별입니다.
자주 묻는 질문
OpenAI Decisions API의 거부(refusal)는 어떻게 처리해야 하나?
거부를 별도의 워크플로 결과로 다루세요. choice, score, probability 필드를 읽기 전에 answer.type을 확인하세요. 질문 이름을 로깅하고, 요청을 검토 또는 복구 경로로 라우팅하세요. 거부를 음성 판정이나 0점으로 해석하지 마세요.
Decisions API의 임계값은 시간이 지나면서 어떻게 유지해야 하나?
라벨링된 홀드아웃 예시로 임계값을 선택한 뒤, 승인된 결정의 정확도와 검토로 보낸 비율을 모니터링하세요. 범주, 지시문, 입력 소스, 모델 동작이 변경되면 재평가하세요. 라우팅 변경을 해당 구성으로 추적할 수 있도록 버전 관리된 루브릭을 유지하세요.
OpenAI Decisions API 지연 시간 테스트는 어떻게 보고해야 하나?
날짜, 지역, 모델 식별자, 질문 수, 텍스트 길이, 이미지 크기, 동시성, 클라이언트 버전, 재시도 정책, 비교 엔드포인트 구성을 기록하세요. 수집 샘플 수와 품질 결과와 함께 종단간 p50과 p95를 보고하여, 더 많은 오류를 수용함으로써만 얻어진 속도 향상을 피하세요.
통합을 깨뜨리지 않고 Decisions API 카테고리를 어떻게 발전시켜야 하나?
안정적인 기계 판독 값을 사용하고 다운스트림 큐에 대한 명시적 매핑을 유지하세요. 폴백 범주를 추가하고 배포 전에 과거 경계 사례를 테스트하세요. 범주 이름을 변경하는 경우, 알 수 없는 값이 프로덕션 동작에 도달하지 않도록 라우팅 맵과 루브릭을 함께 업데이트하세요.
Decisions API 라우팅 감사에는 무엇을 기록해야 하나?
루브릭 버전, 선택된 범주, 관련 확률 또는 신뢰도, 임계값, 모델 식별자, 타임스탬프, 수행한 조치를 기록하세요. 워크플로에 필요한 입력 콘텐츠만 저장하고 조직의 보존 정책을 적용하세요. 감사 기록은 애플리케이션 로직이 왜 라우팅하거나 에스컬레이션했는지를 보여주어야 합니다.