
TL;DR: Pilih DeepSeek-V4-Flash untuk automasi teks yang pantas dan latensi rendah; pilih GLM-5.3-Flash untuk keupayaan multimodal, penanda aras ejen yang unggul, dan pengehosan pelayan peribadi konteks panjang yang sangat cekap. Kedua-dua model menyediakan open weights di bawah MIT License**** dan dikeluarkan di bawah lesen MIT yang permisif.
DeepSeek-V4-Flash**** ialah pilihan yang lebih baik jika anda mahukan API teks sahaja yang sangat pantas dan ber-throughput tinggi untuk gelung pengaturcaraan tradisional dan pemprosesan kelompok besar. Ia memperoleh skor 50 pada Artificial Analysis Intelligence Index, menjana sehingga 122+ token/saat menggunakan enjin penyahkodan spekulatif DSpark bersepadu, dan menawarkan kadar API luar puncak serendah $0.22/$0.66 per sejuta token input/output.
GLM-5.3-Flash ialah pilihan yang lebih serba boleh apabila keperluan melibatkan multi-modality asli, pengaturcaraan visual-in-the-loop, dan penskalaan kendiri yang sangat cekap. Ia memperoleh skor 57 pada Artificial Analysis Intelligence Index, memanfaatkan mekanisme perhatian hibrid linear-dan-jarang (KDA + NoPE Sparse MLA) untuk mengurangkan memori KV Cache sebanyak 4.44× pada konteks 1M, dan menampilkan penaakulan visual asli. API-nya berharga sangat kompetitif pada $0.15/$0.50 per sejuta token input/output (kadar promosi turun kepada $0.075/$0.25).
Ringkasan Utama
- DeepSeek-V4-Flash beralih daripada pratonton awal pada DeepSeek API News Announcement kepada keluaran rasmi di Hugging Face, menggabungkan Token-wise Compression, DeepSeek Sparse Attention (DSA), dan penyahkodan spekulatif DSpark untuk meningkatkan kelajuan generasi.
- GLM-5.3-Flash dikeluarkan pada 26 Ogos, 2026, selepas mencapai populariti meluas semasa fasa ujian anonim di OpenRouter dengan nama kod "Ox Alpha."
- GLM-5.3-Flash mendahului keseluruhan Artificial Analysis Intelligence Index dengan 57 mata berbanding 50 mata untuk DeepSeek-V4-Flash-0731, mencerminkan keupayaan keseluruhan yang lebih kukuh dalam penaakulan kompleks dan tugasan ejen.
- Kedua-dua seni bina ialah model Mixture-of-Experts (MoE) dengan jejak pengiraan yang sangat ringan semasa inferens: DeepSeek mengaktifkan 13B daripada 284B jumlah parameter per token, manakala GLM mengaktifkan 18B daripada 320B.
- Kedua-dua model mempunyai open weights sepenuhnya dan diedarkan di bawah MIT License, menawarkan kebebasan maksimum untuk pengkomersialan perusahaan, penalaan halus tersuai, dan pengesahan di premis.
DeepSeek-V4-Flash vs GLM-5.3-Flash: Perbandingan Pantas
| Spesifikasi | DeepSeek-V4-Flash-0731 | GLM-5.3-Flash |
|---|---|---|
| Pembangun | DeepSeek-ai | Z.ai (Zhipu AI) |
| Tarikh keluaran | July 31, 2026 | August 26, 2026 |
| ID model | deepseek-v4-flash | glm-5.3-flash |
| Repositori Hugging Face | deepseek-ai/DeepSeek-V4-Flash | zai-org/GLM-5.3-Flash |
| Arkitektur | MoE; DSA + Token-wise Compression | MoE; KDA + NoPE Sparse MLA + mHC |
| Jumlah parameter | 284B (304B dengan modul DSpark) | 320B |
| Parameter aktif | 13B per token | 18B per token |
| Tetingkap konteks | 1,000,000 tokens | 1,048,576 / about 1M tokens |
| Input / output | Text → Text | Text + Image + Video + File → Text |
| Penaakulan | Boleh dikonfigurasi (Thinking / Non-Thinking) | Tiga tahap (Low / High / Max) |
| Fungsi / penggunaan alat | JSON Schema / Tool Calls | ToolCalls, constraints, dynamic tool loading |
| Open weights | Yes (MIT License) | Yes (MIT License) |
| AA Intelligence Index | 50 | 57 |
| Harga Rasmi (1M Tokens) | Peak: $0.44 / $1.32 <br> Off-peak: $0.22 / $0.66 | List: $0.15 / $0.50 <br> Promo: $0.075 / $0.25 |
| Paling sesuai | Ejen throughput tinggi, generasi teks pantas | Pengaturcaraan visual, pengesahan on-prem tersuai |
Apakah DeepSeek-V4-Flash?
DeepSeek-V4-Flash ialah model MoE yang ringan dan sangat pantas yang direka untuk menyokong ejen pembangun autonomi dan paip pemprosesan teks besar-besaran. Pada asalnya dipratonton pada DeepSeek API News Announcement, model ini menerima peningkatan pasca latihan utama dalam keluaran rasminya sebagai DeepSeek-V4-Flash-0731 di Hugging Face.
Model ini dioptimumkan untuk throughput teks tulen, panggilan API berstruktur, dan pelaksanaan kod program yang pantas. Ia meminimumkan kedua-dua latensi dan kos inferens token-ke-token, menyasarkan gelung pembangunan perisian multi-giliran di mana kelajuan dan kos pelaksanaan adalah keutamaan.
Apa yang Berubah Daripada Pratonton?
Versi rasmi 0731 termasuk model draf spekulatif bersama terlatih pilihan yang membawa jumlah bilangan parameter setempat kepada 304B. Apabila dihoskan, rangka kerja penyahkodan spekulatif ini (DSpark) beroperasi bersama laluan 13B aktif untuk mempercepatkan kelajuan generasi kepada 122.7 token sesaat.
Selain itu, proses penjajaran dilatih semula secara meluas dengan pembelajaran pengukuhan (RL) dalam persekitaran pelaksanaan berpetak, menghasilkan kebolehpercayaan yang jauh lebih tinggi pada kerja terminal berbilang langkah, skrip shell, dan penggunaan alat berstruktur.
Spesifikasi DeepSeek-V4-Flash
| Sifat | DeepSeek-V4-Flash-0731 |
|---|---|
| Konteks | 1,000,000 tokens |
| Modaliti | Input teks; output teks (model standard) |
| Penaakulan | Menyokong mod Non-thinking dan Thinking |
| Keupayaan API asli | JSON Output, Tool Calls, Responses API |
| Had pengetahuan | Undisclosed |
| Harga Standard (per MTok) | Peak: $0.44 Input / $0.014 Cached / $1.32 Output <br> Off-peak: $0.22 Input / $0.007 Cached / $0.66 Output |
Apakah GLM-5.3-Flash?
GLM-5.3-Flash ialah model MoE multimodal open-weights utama Z.ai. Diperkenalkan secara rasmi pada Z.ai Blog pada 26 Ogos, 2026, model ini direka untuk melaksanakan ejen yang sangat kompleks, navigasi web automatik, dan penaakulan dokumen visual pada kos peringkat "Flash" standard. Berat model boleh diakses secara umum di Hugging Face.
Model ini dipra-latih pada set data multimodal 30 trilion token yang besar, menjadikan input visual sebagai modality asli dan bukannya afterthought. Ia menyasarkan kejuruteraan perisian, automasi proses robotik, dan pertanyaan pangkalan data multimodal.
Perhatian Hibrid, mHC dan Penskaliran MoE Jarang
GLM-5.3-Flash membezakan dirinya melalui tiga tonggak seni bina:
- Hybrid Attention: Seperti yang digariskan pada Z.ai Blog, model ini menggabungkan Kimi Delta Attention (KDA) dengan NoPE Sparse MLA (Multi-head Latent Attention with No Positional Encoding). Lapisan perhatian hibrid ini memampatkan saiz unjuran keys dan values, mengurangkan storan KV Cache sebanyak 4.44× dan mengurangkan pengiraan perhatian sebanyak 3.01× semasa penilaian konteks 1M.
- Stable LatentMoE: Mengoperasikan 896 jumlah pakar dengan tepat 16 diaktifkan per token, model ini mengelakkan keruntuhan perutean pakar dan kekal stabil semasa jejak inferens berbilang langkah yang panjang.
- Manifold-Constrained Hyper-Connections (mHC): Teknik ini menstabilkan kecerunan mendalam merentasi struktur 45 lapisannya, mengoptimumkan prestasi perkakasan apabila dijalankan pada kluster GPU teragih atau cip AI setempat.
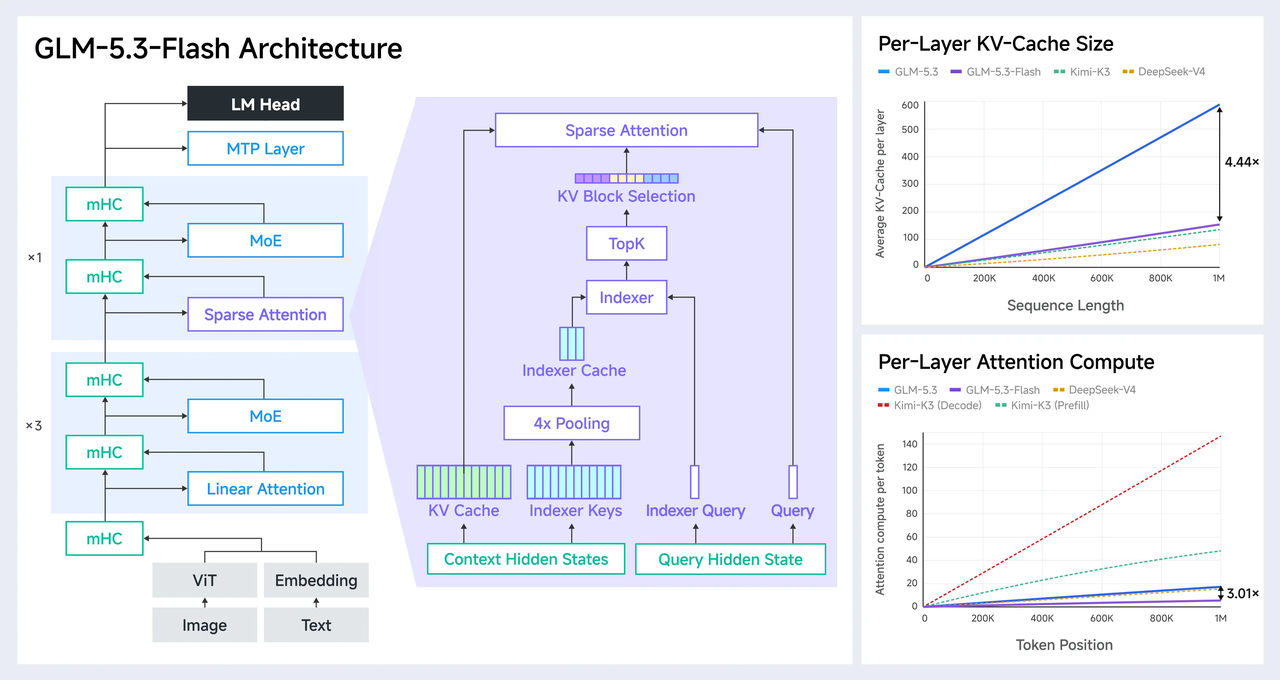
GLM-5.3-Flash: Arkitektur untuk Kecekapan Melampau Sumber: z.ai
Spesifikasi GLM-5.3-Flash
| Sifat | GLM-5.3-Flash |
|---|---|
| Jumlah / parameter aktif | 320B / 18B |
| Arkitektur | MoE dengan Perhatian Hibrid Jarang & Linear |
| Pakar | 896 jumlah; 16 diaktifkan per token |
| Konteks | 1,048,576 tokens (~1M) |
| Visi | Multimodal Asli (Teks, Imej, Video, Fail Doc) |
| Penaakulan | Menyokong mod thinking Low, High, Max |
| Alat | ToolCalls, constraints, dynamic tool loading |
| Open weights | Tersedia di Hugging Face (MIT License) |
| Harga Rasmi (per MTok) | List: $0.15 Input / $0.03 Cached / $0.50 Output <br> Promo (ends Sept 9): $0.075 Input / $0.015 Cached / $0.25 Output |
DeepSeek-V4-Flash vs GLM-5.3-Flash: Perbandingan Ciri
Arkitektur dan Kecekapan Parameter
DeepSeek-V4-Flash mengoperasikan arkitektur jumlah parameter 284B (13B aktif) dengan model draf spekulatif bersama (meningkatkan saiz pengesahan setempat kepada 304B). GLM-5.3-Flash menggunakan 320B jumlah parameter (18B aktif) merentasi susun atur 45 lapisan yang sangat jarang. Kedua-dua model mengaktifkan sangat sedikit parameter per token, membolehkan mereka berprestasi pada kelajuan tinggi yang tipikal bagi model yang jauh lebih kecil sambil mengekalkan perwakilan pengetahuan kaya model besar.
Mekanisme Perhatian dan Pengoptimuman Memori
DeepSeek-V4-Flash menggunakan DeepSeek Sparse Attention (DSA) dan Token-wise Compression. Ia menganalisis struktur jujukan secara dinamik dan memampatkan token berlebihan (contohnya, struktur kod boilerplate atau header sistem berulang) semasa pemprosesan prompt yang panjang.
GLM-5.3-Flash menggabungkan KDA linear dengan unjuran laten (NoPE Sparse MLA). Ini menghapuskan pengkodan kedudukan eksplisit daripada blok pemampatan key/value, mengurangkan jejak memori cache KV fizikal kepada hanya 22.5% daripada susun atur tradisional. Ini membolehkan kluster dengan kekangan memori menyokong kebersamaan yang jauh lebih tinggi semasa beban kerja konteks panjang.
Modality dan Kedalaman Multimodal
DeepSeek-V4-Flash-0731 ialah model teks sahaja. Ia cemerlang dalam menghurai fail teknikal, skema JSON, dan markdown berstruktur. Untuk tugasan penghurai visual, pembangun mesti menggunakan model multimodal eksperimen berasingan (deepseek-v4-flash-vision-exp).
GLM-5.3-Flash adalah multimodal secara asli. Ia menerima imej resolusi tinggi, video, dan fail dokumen pejabat kompleks (PDF, PPTX, spreadsheet) secara langsung. Multi-modality asli ini menyokong pengaturcaraan "visual-in-the-loop", di mana model boleh memeriksa reka letak UI yang dipaparkan, mengesan isu penjajaran, dan membetulkan kodnya sendiri secara iteratif tanpa campur tangan manual pembangun.
Lesen dan Keterbukaan
Kedua-dua model dikeluarkan di bawah MIT License yang sangat permisif. Ini memberikan pembangun perusahaan kebebasan lengkap untuk mengubah suai, mengedar, melesenkan semula, dan mengesahkan model secara komersial secara setempat, dalam VPC peribadi, atau di dalam infrastruktur awan on-prem air-gapped.
DeepSeek-V4-Flash vs GLM-5.3-Flash: Perbandingan Penanda Aras
Apabila dinilai pada set data yang sama di bawah harness ujian yang identik, kedua-dua model berprestasi kompetitif pada tugasan kejuruteraan perisian dan automasi ejen.
Prestasi Pengaturcaraan & Ejen
| Penanda Aras | GLM-5.3-Flash (Z.ai) | DeepSeek-V4-Flash-0731 |
|---|---|---|
| Artificial Analysis Index v4.1.1 | 57 | 50 |
| Terminal Bench 2.1 (Acc) | 84.3 | 82.7 |
| DeepSWE v1.1 (GitHub Issues) | 63.4 | 54.4 |
| Toolathlon (Verified / Pass@1) | 78.4 | 70.3 |
| NL2Repo (Acc) | 56.3 | 54.2 |
| Automation Bench (Acc) | 48.8 | 25.1 |
| GDPval-AA v2 (Agent Elo) | 1773 | 1554 |
GLM-5.3-Flash mengekalkan kelebihan merentasi kebanyakan penanda aras ejen dan kejuruteraan perisian, memperoleh 63.4% pada DeepSWE v1.1 dan 84.3 pada Terminal Bench 2.1. Laluan parameter aktif 18B dan penjajaran pasca latihan multi-giliran membantu ia mengendalikan penjejakan repositori kompleks dan interaksi sistem operasi.
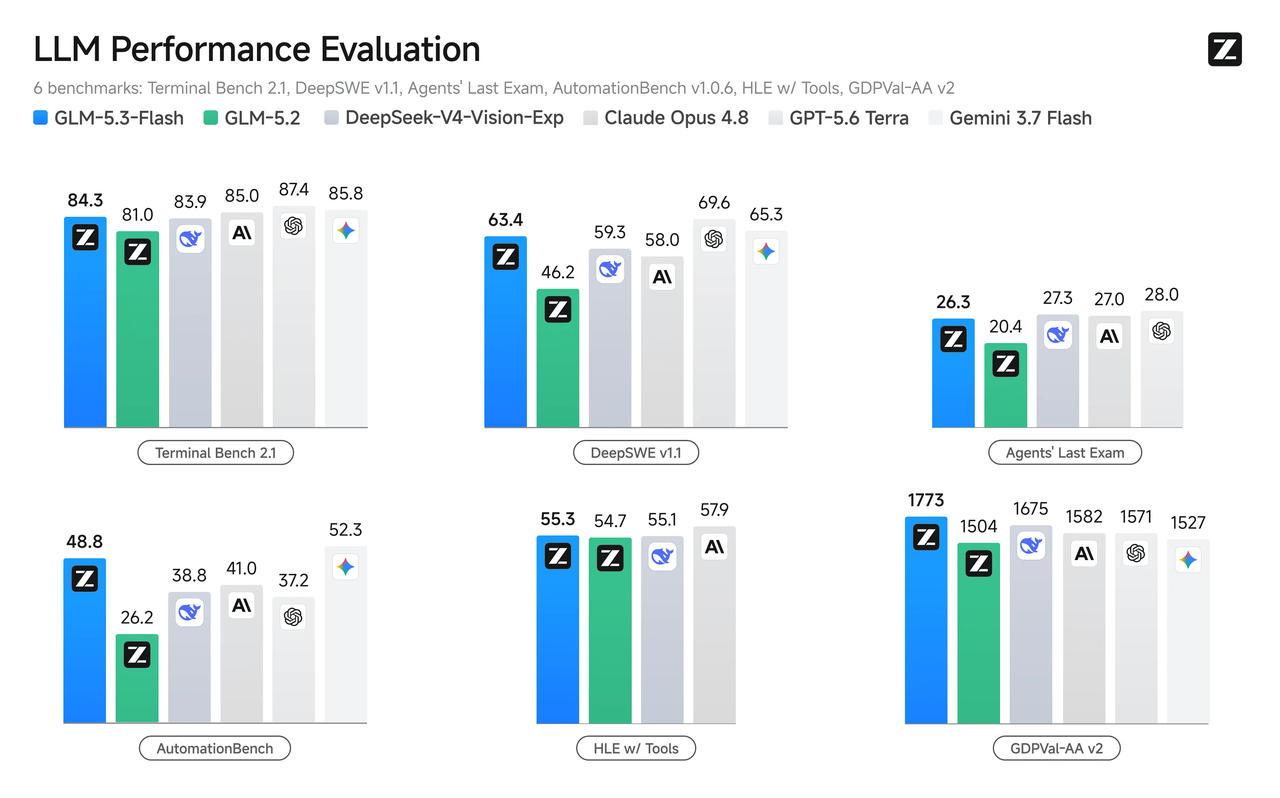
Penanda Aras GLM-5.3-Flash: skor 84.3 pada Terminal Bench 2.1 Sumber: z.ai
DeepSeek-V4-Flash-0731 juga sangat kompeten, memperoleh 82.7 pada Terminal Bench 2.1 dan 70.3 pada Toolathlon. Ia menyampaikan prestasi boleh dipercayai pada struktur API deterministik dan panggilan fungsi yang ketat.
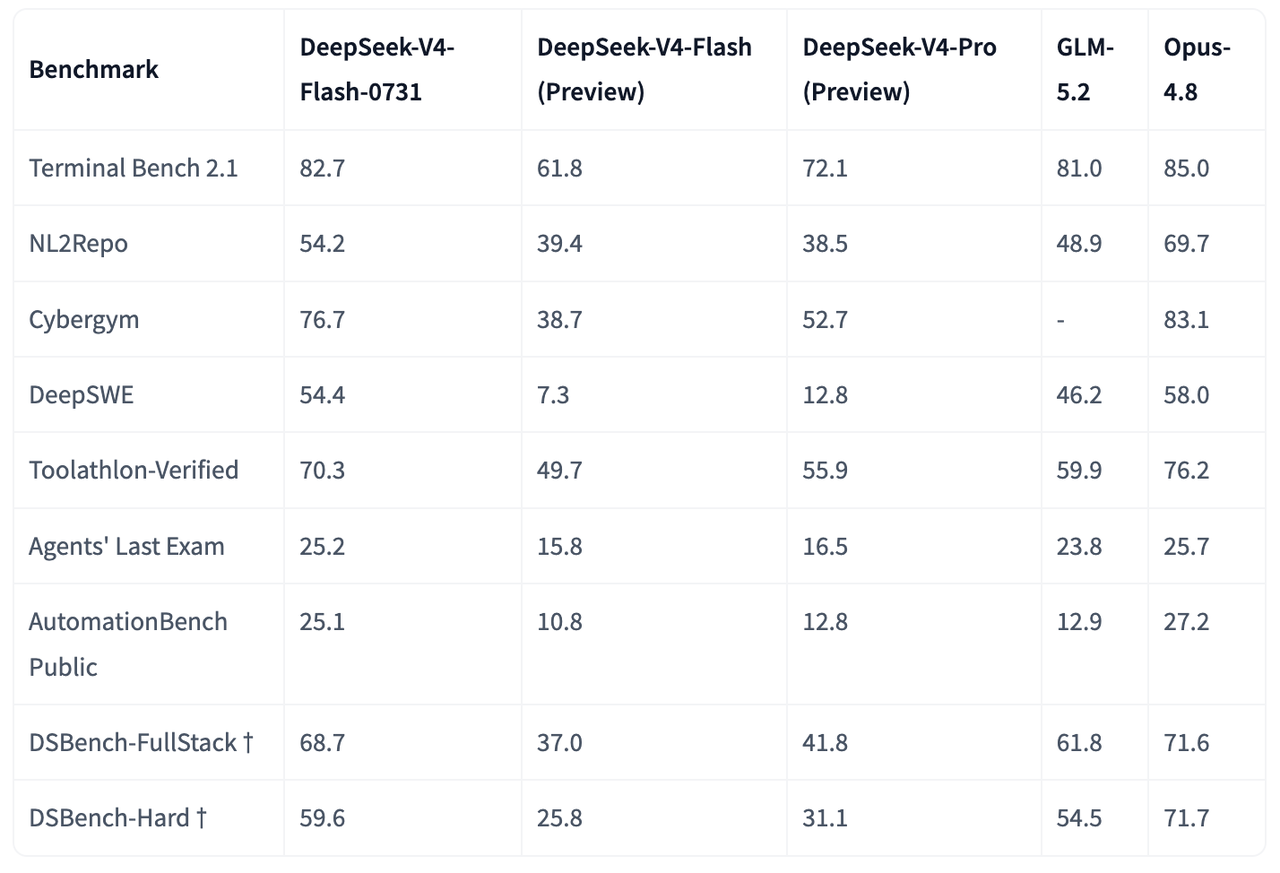
Penanda Aras DeepSeek-V4-Flash 0731: skor 82.7 pada Terminal Bench 2.1 Sumber: Hugging Face
Multimodal dan Penaakulan Visual
Latihan multimodal asli GLM-5.3-Flash memberikannya kelebihan yang jelas pada tugasan penaakulan visual:
- OfficeQA Pro: 62.4 (GLM-5.3-Flash) vs 57.9 (DeepSeek-V4-Vision cawangan eksperimen). GLM menunjukkan penghurai asli yang unggul terhadap imej terbenam, jadual PDF berstruktur, dan dek slaid.
- Chartography with Tools: 78.0 (GLM-5.3-Flash). Model ini menunjukkan keupayaan cemerlang untuk mengambil carta alir sistem, rajah wireframe, dan imbasan bil, menterjemahkannya terus kepada logik sistem yang boleh dilaksanakan.
Kelajuan dan Latensi
- Kelajuan Generasi: DeepSeek-V4-Flash-0731 lebih pantas, mencapai kelajuan output purata 122.7 token/saat pada endpoint awan perusahaan standard, dibantu oleh rangka kerja penyahkodan spekulatifnya.
- Time to First Token (TTFT): GLM-5.3-Flash menampilkan TTFT lebih rendah iaitu 1.21 saat, berbanding lebih 3.0 saat untuk DeepSeek-V4-Flash, menjadikannya terasa lebih responsif dalam aplikasi sembang bersemuka pengguna masa nyata.
DeepSeek-V4-Flash vs GLM-5.3-Flash: Harga API
Kedua-dua model menawarkan model harga yang sangat berkesan kos, menjadikannya sangat kompetitif berbanding seni bina padat tradisional.
Senarai Harga Rasmi API (per 1 Juta Token)
| Lapisan Harga | DeepSeek-V4-Flash-0731 (Peak) | DeepSeek-V4-Flash-0731 (Off-Peak) | GLM-5.3-Flash (Standard) | GLM-5.3-Flash (Promo - to Sep 9) |
|---|---|---|---|---|
| Input Price (Cache Miss) | $0.44 | $0.22 | $0.15 | $0.075 |
| Input Price (Cache Hit) | $0.014 | $0.007 | $0.03 | $0.015 |
| Output Price | $1.32 | $0.66 | $0.50 | $0.25 |
Pada waktu luar puncak, DeepSeek-V4-Flash-0731 sangat ekonomikal, menurunkan kos input kepada $0.22/MTok dan output kepada $0.66/MTok, dengan kos input cache pada $0.007/MTok.
GLM-5.3-Flash menyediakan kadar rata standard yang kompetitif ($0.15 input / $0.50 output) tanpa caj waktu puncak. Kadar promosinya (tersedia hingga 9 September, 2026) menurunkan kos input dan output kepada $0.075 dan $0.25 masing-masing, menjadikannya pilihan yang sangat baik untuk migrasi berskala besar dan pemprosesan kelompok.
Kekuatan dan Kelemahan
DeepSeek-V4-Flash-0731
- Kekuatan:
- Kelajuan Generasi Luar Biasa: Menjana sehingga 122.7 token per saat menggunakan model draf spekulatif bersama (DSpark).
- Ekonomi Luar Puncak: Menawarkan kadar luar puncak yang sangat murah $0.22 input dan $0.66 output per sejuta token.
- Sokongan Kuantisasi CPU yang Kukuh: Memiliki laluan integrasi GGUF yang matang, menjadikannya sangat dioptimumkan untuk runtime setempat berasaskan CPU dan kekangan memori sistem peribadi.
- Tolak ansur:
- Volatiliti Kadar Waktu Puncak: Harga API berganda semasa waktu puncak (0.44/1.32 per MTok).
- Berat Teras Teks Sahaja: Berat standard tidak menyokong penaakulan visual, imej, atau video secara asli.
- Overhed TTFT: Menunjukkan Time to First Token (TTFT) yang lebih panjang berbanding GLM.
GLM-5.3-Flash
- Kekuatan:
- Kecerdasan Peringkat Atas: Mencapai 57 mata yang sangat kompetitif pada Artificial Analysis Index.
- Vision-in-the-Loop Asli: Mengintegrasikan pengendalian imej dan video terus ke dalam penjajaran pasca latihan, membolehkan penilaian visual kod front-end web.
- Pengurangan Cache Luar Biasa: Lapisan KDA linear hibrid dan NoPE MLA mengurangkan penggunaan memori sebanyak 4.44×, membuka kebersamaan setempat yang lebih tinggi.
- Kadar Konteks Panjang Rata: Harga standard kekal rata sehingga 1M token dengan kadar cache-hit terendah industri ($0.03 standard, $0.015 promosi).
- Tolak ansur:
- Kelajuan Output Token Lebih Perlahan: Kelajuan generasi mentah lebih perlahan daripada enjin penyahkodan spekulatif khusus DeepSeek.
- Keperluan Perkakasan: Mengehoskan keseluruhan struktur MoE 320B setempat memerlukan persekitaran GPU multi-nod walaupun dengan jarang yang tinggi.
| Model | Kekuatan | Tolak ansur |
|---|---|---|
| DeepSeek-V4-Flash | Generasi pantas (122.7 tok/s dalam “Artificial Analysis”); harga luar puncak sangat murah; ekosistem kuantisasi teks matang; sangat dioptimumkan untuk GGUF CPU. | Varians kadar waktu puncak; model teras teks sahaja (tiada visi asli); TTFT lebih perlahan. |
| GLM-5.3-Flash | 57 mata pada AA Intelligence; penghurai multimodal asli; pemampatan KV cache 4.44×; harga rata; TTFT pantas (1.21s); MIT license. | Kelajuan generasi token mentah sedikit lebih perlahan daripada DeepSeek; pengesahan setempat intensif HW. |
DeepSeek-V4-Flash vs GLM-5.3-Flash: Yang Mana Patut Anda Pilih?
| Kes penggunaan | Disyorkan | Mengapa |
|---|---|---|
| API frontier lalai | GLM-5.3-Flash | Skor lebih tinggi pada indeks kecerdasan (57) dan mendominasi penanda aras ejen berbilang langkah. |
| Ejen teks berjalan lama | DeepSeek-V4-Flash | Kelajuan generasi yang sangat pantas (122+ tok/s) menjadikannya sangat cekap untuk generasi teks/kod besar. |
| Pengkodan visual / aliran UI | GLM-5.3-Flash | Reka bentuk multimodal asli menyokong debug visual-in-the-loop dan analisis render UI. |
| VPC peribadi/kendiri | GLM-5.3-Flash | Lesen MIT dengan pemampatan KDA + NoPE MLA, yang mengurangkan keperluan VRAM perkakasan sebanyak 4.44×. |
| Jalankan CPU setempat sahaja | DeepSeek-V4-Flash | Sokongan kuant GGUF setempat lebih kukuh (92GB Unified Memory untuk laluan 1-bit atau 3-bit ekstrem). |
| Kos output puncak lebih rendah | GLM-5.3-Flash | Harga output standard $0.50/MTok kekal rata dan lebih murah daripada kadar output puncak DeepSeek $1.32. |
| Caching Prompt Berat | DeepSeek-V4-Flash | Cache hit luar puncak sangat rendah pada $0.007 per sejuta token. |
Mengapa Menggunakan Cometapi untuk Mengakses DeepSeek-V4-Flash dan GLM-5.3-Flash
Kedua-dua model disepadukan sepenuhnya ke dalam CometAPI. Pembangun boleh mengakses DeepSeek-V4-Flash, dan sokongan untuk akses gaya Chat Completions / Responses serta GLM-5.3-Flash model page mendedahkan GLM-5.3-Flash melalui endpoint CometAPI bersatu. Ini memudahkan ujian A/B kerana anda boleh menukar ID model sambil mengekalkan pengesahan dan kebanyakan paip aplikasi kekal sama.
Kesimpulan
Pengenalan DeepSeek-V4-Flash-0731 dan GLM-5.3-Flash telah mengubah ekonomi pengesahan model MoE jarang konteks panjang. Kedua-dua seni bina menyampaikan kecerdasan tinggi pada titik harga yang sangat rendah.
DeepSeek-V4-Flash-0731 ialah enjin teks dan kod yang sangat dioptimumkan yang cemerlang dalam throughput generasi mentah, penyahkodan spekulatif, dan kuantisasi berasaskan CPU setempat. GLM-5.3-Flash mewakili langkah besar untuk aliran kerja multimodal dan berasaskan ejen, menggabungkan penaakulan visual latensi rendah dengan mekanisme perhatian hibrid yang menjadikan pengehosan on-prem sangat cekap.
Soalan Lazim
Apakah nama ujian anonim GLM-5.3-Flash?
Sebelum pelancaran rasminya, GLM-5.3-Flash diuji secara anonim di OpenRouter dan OpenCode dengan nama kod "Ox Alpha," di mana ia dengan pantas menjadi model popular untuk pembangun.
Bolehkah saya menjalankan model ini secara setempat pada komputer peribadi standard?
Ya, kedua-dua model mempunyai open-weights dan tersedia di Hugging Face. Walau bagaimanapun, disebabkan saiz parameternya, pengehosan setempat memerlukan memori bersatu yang signifikan:
- DeepSeek-V4-Flash-0731: Kuantisasi 1-bit ekstrem memerlukan ~92GB RAM; jalankan kuantisasi 3-bit sangat disyorkan dan memerlukan antara 110–135GB RAM.
- GLM-5.3-Flash: Kuantisasi 1-bit ekstrem memerlukan ~100GB RAM, manakala jalankan 3-bit berprestasi terbaik dengan 128GB–150GB memori sistem bersatu.
Adakah DeepSeek-V4-Flash menyokong pemprosesan visual atau video?
Tidak, DeepSeek-V4-Flash-0731 standard ialah model teks sahaja. Untuk tugasan visual, anda mesti menggunakan model eksperimen multimodal berasingan mereka (deepseek-v4-flash-vision-exp).
Bagaimana "visual-in-the-loop" berfungsi pada GLM-5.3-Flash?
Oleh kerana model ini mempunyai kefahaman visual dan imej asli, ia boleh menulis kod frontend, mengkaji output visual yang dipaparkan, mengesan ralat susun atur atau gaya, dan menulis semula kod untuk membetulkan pepijat tersebut tanpa memerlukan manusia menerangkan isu susun atur dalam teks.
Bagaimana Prompt Caching menjimatkan wang dengan model ini?
Jika anda menghantar konteks besar yang sama (seperti kod asas atau koleksi dokumen) dalam berbilang panggilan API, kedua-dua model boleh cache prompt ini. Pada panggilan seterusnya, mereka hanya mengenakan caj pada kadar "cache-hit", yang turun kepada $0.007/MTok untuk DeepSeek-V4-Flash (luar puncak) dan $0.015/MTok untuk GLM-5.3-Flash (promosi), sekali gus mengurangkan kos API dengan ketara.