
TL;DR
GLM-5.3 Flash ialah lalai yang lebih baik untuk kebanyakan beban kerja pengeluaran: ia menambah input visual natif dan tetingkap konteks 1M token, manakala harga senarai standardnya jauh lebih rendah. GLM-5.3 kekal sebagai pilihan yang lebih kukuh apabila kedalaman pengekodan maksimum, penalaran jangka panjang yang sukar, atau prestasi keselamatan siber lebih penting daripada kos seunit.
Ini bukan kisah model kecil lawan model besar. Flash ialah MoE 320B jumlah / 18B aktif yang dilatih daripada asas multimodal baharu dengan perhatian jarang hibrid dan perhatian linear. Model utama ialah MoE 744B jumlah / 40B aktif yang mana peningkatan GLM-5.3 datang daripada pasca-latihan berskala pada asas GLM-5.2.
Intipati Utama
- Pilih Flash untuk pengekodan multimodal, pemahaman dokumen, ejen pelayar atau GUI, automasi volum tinggi, dan aplikasi peka kos.
- Pilih model utama untuk tugasan kejuruteraan skala repositori paling sukar, penalaran lebih dalam dibantu alat, dan penyelidikan keselamatan defensif.
- Kedua-dua model menyokong konteks 1M token, penalaran sentiasa aktif, panggilan fungsi, penstriman, dan penerapan berat terbuka.
- Pada penanda aras yang dilaporkan Z.ai secara dipadankan, model utama mendahului DeepSWE, NL2Repo, HLE dengan alat, dan Agents’ Last Exam; Flash mendahului AutomationBench, Toolathlon, dan GDPval-AA v2.
- Ujian bebas memberikan model utama Indeks Kecerdasan lebih tinggi dan output lebih pantas, manakala Flash sedikit lebih pantas ke token pertama dan kos campuran jauh lebih rendah.
GLM-5.3 Flash vs GLM-5.3 Sekilas Pandang
| Dimensi | GLM-5.3 Flash | GLM-5.3 | Hasil praktikal |
|---|---|---|---|
| Pemosisian | Model pengekodan dan ejen multimodal natif yang cekap | Model utama penalaran teks, pengekodan, ejen jangka panjang, keselamatan siber | Bergantung beban kerja |
| Saiz model | 320B jumlah / 18B aktif | 744B jumlah / 40B aktif | Flash mengaktifkan 55% parameter lebih sedikit |
| Model asas | Asas multimodal 30T token yang baru dilatih | Asas yang sama seperti GLM-5.2; peningkatan daripada pasca-latihan | Laluan pembangunan berbeza |
| Input / output | Input teks + visual / output teks | Input teks / output teks | Flash untuk aliran kerja visual |
| Konteks / output maksimum | 1M / 128K | 1M / 128K | Seri |
| Usaha penalaran | rendah, tinggi, maksimum; penalaran sentiasa diaktifkan | rendah, tinggi, maksimum; penalaran sentiasa diaktifkan | Seri |
| Indeks Kecerdasan Bebas | 57 | 60 pada usaha maksimum | GLM-5.3 |
| Kelajuan output bebas | 50.2 token/s | 76.6 token/s | GLM-5.3 dalam API diuji |
| Harga senarai rasmi input/output | $0.15 / $0.50 per 1M token | $1.40 / $4.40 per 1M token | Flash |
| Kesesuaian terbaik | Penghalaan lalai, ejen multimodal, skala | Tugasan teks dan keselamatan paling kompleks berisiko tinggi | Gunakan penghalaan selektif |
Sumber: dokumentasi model Z.ai dan perbandingan Artificial Analysis.
Apakah GLM-5.3 Flash?
Z.ai memposisikan Flash sebagai model multimodal natif pertama dalam siri GLM-5. Ia mempunyai 320B parameter jumlah dan 18B aktif, tetapi “Flash” tidak harus dibaca sebagai “kecil.” Checkpoint penuh masih merupakan model yang sangat besar; kecekapan datang daripada mengaktifkan subset pakar yang lebih kecil dan mereka bentuk semula tumpukan perhatian.
Model asasnya dilatih pada korpus multimodal 30 trilion token. Penglihatan natif disepadukan dalam kitaran pengekodan, membolehkan model memeriksa tangkapan skrin, antara muka terpapar, carta, susun atur halaman, dan maklum balas visual lain sebelum memperhalusi tindakan seterusnya.
Spesifikasi GLM-5.3 Flash
| Spesifikasi | GLM-5.3 Flash |
|---|---|
| Pembangun | Z.ai / Zhipu AI |
| ID model | glm-5.3-flash |
| Jenis model | Mixture-of-Experts multimodal natif |
| Parameter jumlah / aktif | 320B / 18B |
| Lapisan | 45 |
| Senibina | Perhatian jarang hibrid + perhatian linear; mHC; MTP |
| Korpus latihan | Korpus pra-latihan multimodal 30T token |
| Modaliti input | Input teks dan visual, termasuk imej dan aliran kerja video/fail yang disokong |
| Modaliti output | Teks |
| Konteks / output maksimum | 1M / 128K token |
| Penalaran | Sentiasa diaktifkan; usaha rendah, tinggi, maksimum |
| Alat | Panggilan fungsi, panggilan alat beraliran, aliran kerja berstruktur |
| Berat / lesen | Berat terbuka; Apache-2.0 dalam repositori rasmi |
Sumber: dokumentasi Flash Z.ai dan repositori rasmi GLM-5.
Apakah GLM-5.3?
Model utama dioptimumkan untuk kejuruteraan perisian kompleks, ejen jangka panjang, dan keselamatan siber. Z.ai menyatakan ia menggunakan model asas yang sama seperti GLM-5.2; peningkatan datang daripada pasca-latihan berskala dan bukannya pra-latihan baharu.
Repositori rasmi menyenaraikan checkpoint pada 744B parameter jumlah dengan 40B aktif. Dibandingkan dengan Flash, ia mengaktifkan lebih daripada dua kali ganda parameter setiap token dan memperuntukkan kapasiti lebih tinggi untuk penalaran berbilang langkah yang sukar.
Spesifikasi GLM-5.3
| Spesifikasi | GLM-5.3 |
|---|---|
| Pembangun | Z.ai / Zhipu AI |
| ID model | glm-5.3 |
| Jenis model | Model teks Mixture-of-Experts utama |
| Parameter jumlah / aktif | 744B / 40B |
| Model asas | Asas GLM-5.2; semua peningkatan GLM-5.3 daripada pasca-latihan |
| Input / output | Teks / teks |
| Konteks / output maksimum | 1M / 128K token |
| Penalaran | Sentiasa diaktifkan; usaha rendah, tinggi, maksimum |
| Alat | Panggilan fungsi, panggilan alat beraliran, cache konteks, output berstruktur |
| Fokus utama | Pengekodan kompleks, ejen jangka panjang, kejuruteraan, keselamatan siber |
| Berat / lesen | Berat terbuka di bawah Lesen GLM-5.3 yang berasingan; kod repositori sokongan di bawah Apache-2.0. |
Sumber: dokumentasi model utama Z.ai dan repositori rasmi GLM-5.
Senibina: Mengapa Flash Lebih Murah Tanpa Menjadi Kecil
Flash menggilirkan blok perhatian linear dengan blok perhatian jarang dan menggunakan mHC di sekeliling komponen perhatian dan MoE. Mekanisme IndexPool memampatkan empat vektor kekunci pengindeks menjadi satu. Z.ai melaporkan 3.01× pengiraan perhatian per lapisan lebih rendah dan cache KV per lapisan 4.44× lebih kecil berbanding model utama pada panjang jujukan 1M token.
Ini ialah perbandingan peringkat senibina, bukan pengganda kependaman hujung-ke-hujung yang terjamin. Kelajuan API sebenar juga bergantung pada perkakasan, pengkuantuman, pembungkusan (batching), panjang penalaran, perisian pelayan, dan beban penyedia.
Senibina perhatian hibrid GLM-5.3-Flash dan perbandingan pengiraan/cache konteks panjang.
Sumber: dokumentasi senibina rasmi Z.ai
Prestasi Penanda Aras: Di Mana Setiap Model Menang
Perbandingan paling bersih memisahkan penanda aras tugas yang dilaporkan vendor daripada ukuran API bebas. Walaupun nama penanda aras sepadan, versi harness, konfigurasi alat, pengurusan konteks, dan usaha penalaran boleh berbeza. Jadual di bawah menggunakan nilai paling hampir dipadankan dalam penilaian model utama dan penilaian Flash, menganggap jurang kecil sebagai arah aliran bukannya muktamad.
| Penanda aras | GLM-5.3 Flash | GLM-5.3 | Skor lebih tinggi | Apa yang diuji |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 88.2 | GLM-5.3 | Terminal dan pengekodan ejen |
| DeepSWE v1.1 | 63.4 | 66.9 | GLM-5.3 | Kejuruteraan perisian |
| NL2Repo | 56.3 | 58.0 | GLM-5.3 | Penjanaan repositori |
| Toolathlon Verified | 78.4 | 73.0 | Flash | Penggunaan alat |
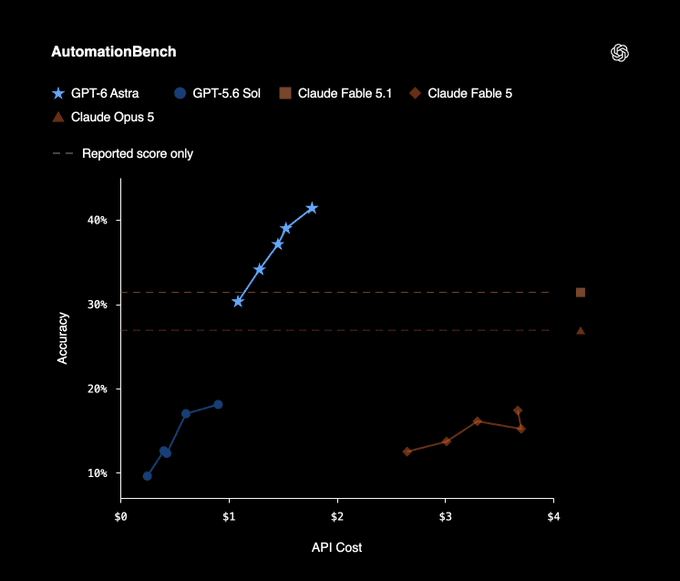
| AutomationBench | 48.8 | 48.2 | Hampir seri / Flash | Automasi penggunaan komputer |
| Agents’ Last Exam | 26.3 | 28.5 | GLM-5.3 | Penalaran ejen jangka panjang |
| HLE with tools | 55.3 | 62.5 | GLM-5.3 | Penalaran sukar dibantu alat |
| GDPval-AA v2 | 1773 Elo | 1769 Elo | Hampir seri / Flash | Kerja pengetahuan profesional |
Sumber: penilaian model utama dan penilaian Flash. Bandingkan secara arah kerana tetapan penilaian mungkin berbeza.
Pengekodan dan Kejuruteraan Repositori
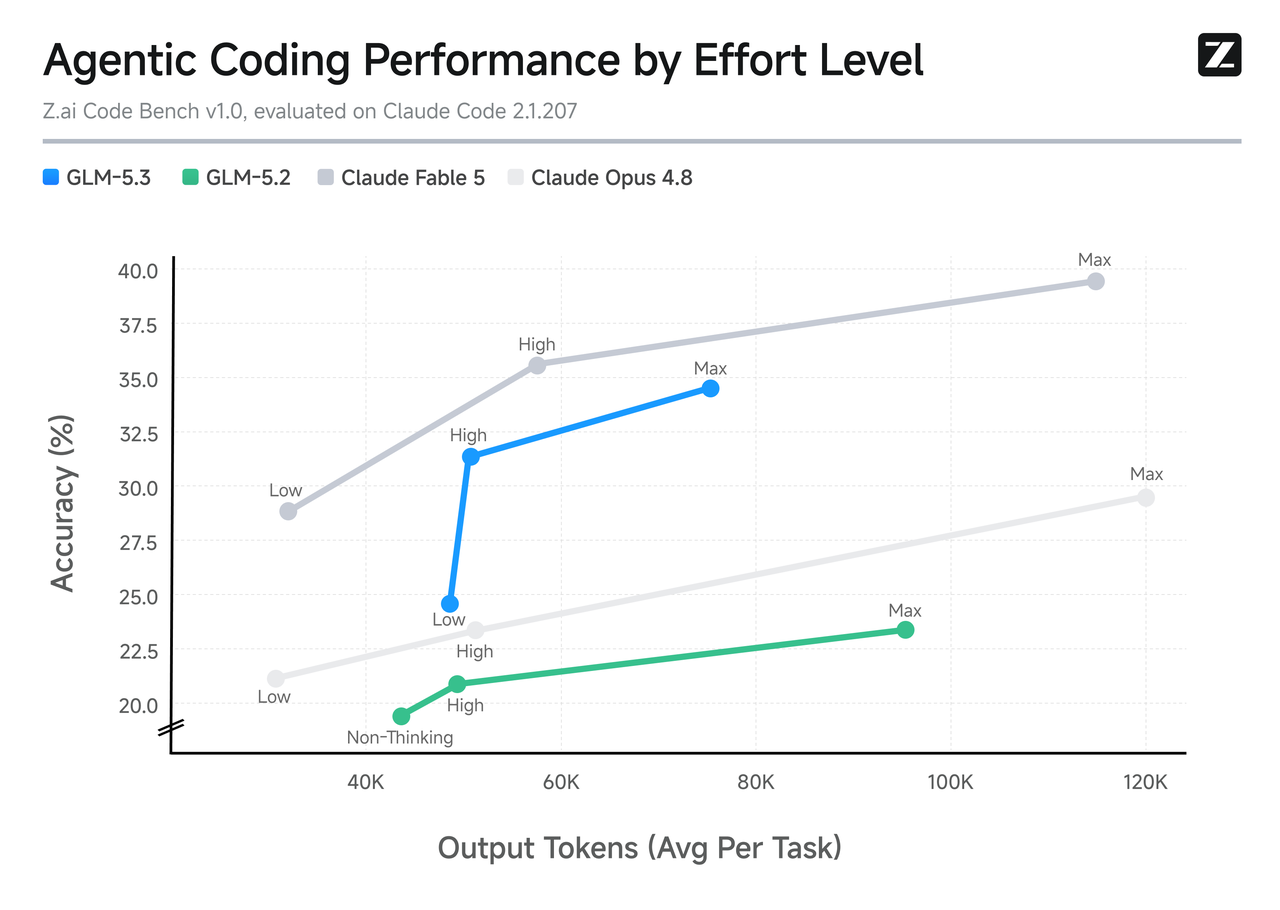
Model utama mempunyai siling prestasi yang lebih tinggi. Ia mendahului Flash sebanyak 3.5 mata pada DeepSWE dan 1.7 mata pada NL2Repo. Pada Z.ai Code Bench v1.0, dengan kedua-dua model dinilai menggunakan Claude Code 2.1.207, model utama mencapai 34.5% pada usaha maksimum, manakala Flash mencapai 29.0% — kelebihan 5.5 mata.
Flash masih cukup berdaya saing untuk menjadi model pertama yang diuji bagi penyelenggaraan repositori rutin, penjanaan ujian, penyahpepijatan, pembaikan semula, dan ejen pengekodan volum tinggi. Tingkatkan hanya tugasan paling sukar atau trajektori yang gagal kepada model utama.
Penilaian enam penanda aras Z.ai bagi GLM-5.3-Flash dan model pengekodan/ejen lain.
Sumber: dokumentasi Flash rasmi Z.ai
Ketepatan pengekodan ejen GLM-5.3 dan penggunaan token output merentasi tahap usaha penalaran.
Sumber: dokumentasi model utama rasmi Z.ai
Penggunaan Alat, Automasi, dan Kerja Pengetahuan
Flash bukanlah lebih lemah secara seragam. Ia memperoleh 78.4 pada Toolathlon Verified berbanding 73.0 untuk model utama, dan mendahului AutomationBench 48.8 berbanding 48.2. Ia pada asasnya terikat pada GDPval-AA v2. Ini menjadikan Flash amat menarik apabila tugas kurang tentang satu rantaian penalaran yang sangat sukar dan lebih kepada penyelarasan alat yang boleh diharap merentasi banyak permintaan berkos rendah.
Kecerdasan, Kelajuan, dan Kependaman Bebas
| Ukuran bebas | GLM-5.3 Flash | GLM-5.3 (maks) | Keputusan |
|---|---|---|---|
| Indeks Kecerdasan Artificial Analysis | 57 | 60 | GLM-5.3 |
| Kelajuan output | 50.2 token/s | 76.6 token/s | GLM-5.3 |
| Masa ke token pertama | 1.49 s | 1.61 s | Flash |
| Tetingkap konteks | 1M | 1M | Seri |
| Harga campuran dalam perbandingan AA | $0.10 / 1M token | $0.90 / 1M token | Flash |
Sumber: perbandingan API dipadankan Artificial Analysis.
Keputusan bebas menambah pembetulan penting kepada andaian “Flash bermakna lebih pantas.” Flash bertindak balas sedikit lebih awal, tetapi titik akhir model utama yang diuji menjana token lebih pantas setelah output bermula. Anggap ukuran ini sebagai petikan khusus penyedia, bukan sifat model yang tidak berubah.
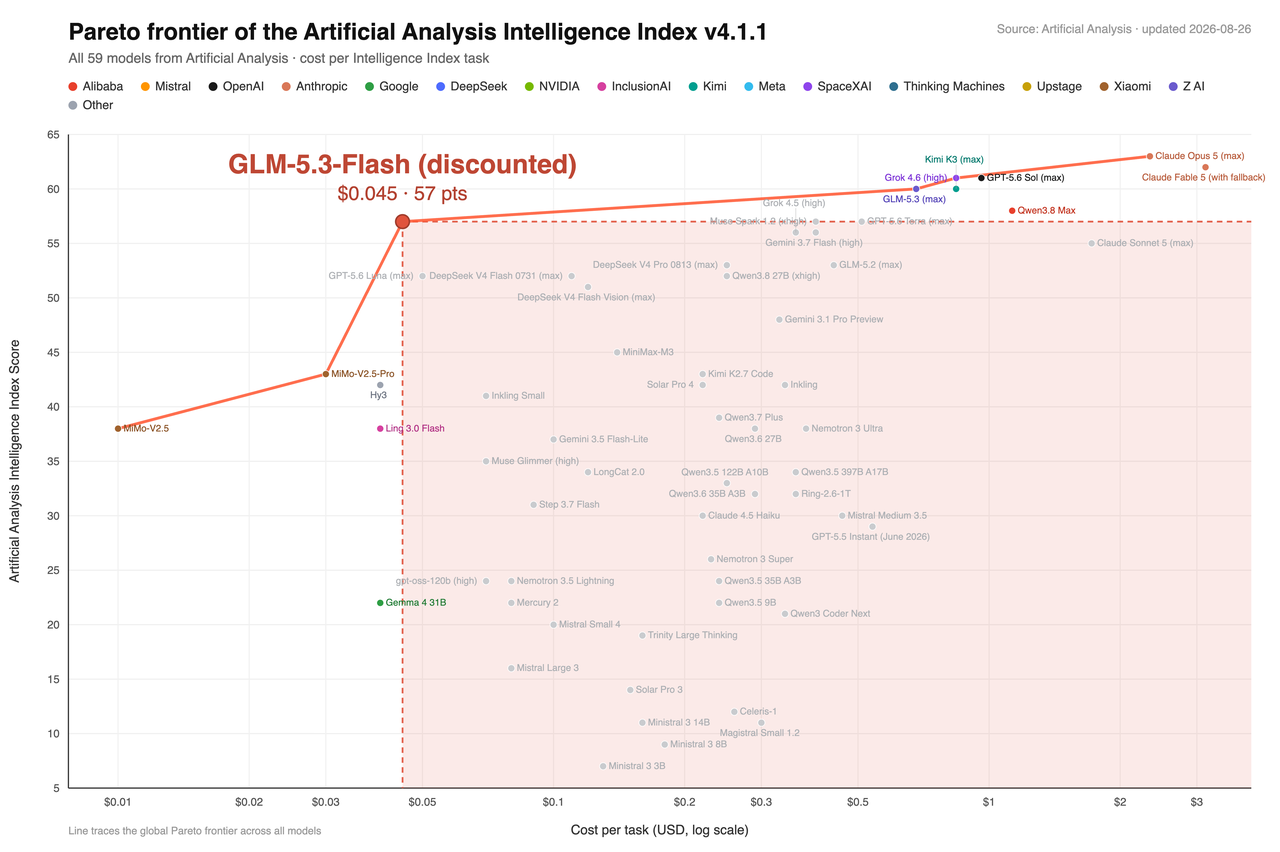
Hadapan kos–kecerdasan Artificial Analysis yang diulang dalam dokumentasi Flash rasmi Z.ai.
Sumber: dokumentasi Flash rasmi Z.ai
Multimodaliti: Flash Mempunyai Kelebihan Jelas
Flash menerima input visual dan menyepadukannya ke dalam aliran kerja ejen. Ia boleh memeriksa tangkapan skrin, imej halaman, carta, keadaan antara muka, rakaman skrin, dan fail yang disokong, kemudian menggunakan bukti visual semasa mengekod atau mengendalikan alat. Model utama ketika ini menyokong input teks sahaja.
- Frontend dan reka bentuk-ke-kod: Flash boleh memeriksa tangkapan skrin rujukan dan mengesahkan pelaksanaan yang dipaparkan.
- Dokumen dan aliran kerja Office: Flash boleh menalar tentang struktur halaman, carta, susun atur, dan penempatan imej.
- Pelayar dan penggunaan komputer: Flash boleh menggabungkan keadaan visual dengan panggilan alat dan pembetulan berulang.
- Kerja repositori berasaskan teks: model utama kekal lebih sesuai apabila input ialah kod dan teks serta tugas memerlukan kedalaman penalaran maksimum.
Konteks Panjang dan Kawalan Penalaran
GLM-5.3 Flash menyokong tetingkap konteks 1M token dan sehingga 128K token output; GLM-5.3 menyediakan had yang sama. Kedua-duanya mengekalkan penalaran diaktifkan dan menerima tahap usaha rendah, tinggi, dan maksimum. Z.ai mengesyorkan maksimum untuk pengekodan sukar dan pembiakan penanda aras.
Kapasiti konteks oleh itu bukan pembeza utama. Perbezaannya ialah betapa ekonomik setiap model melayani jujukan panjang dan berapa banyak kapasiti penalaran yang boleh dibawa kepada tugas paling sukar. Flash secara senibina lebih murah pada konteks panjang; model utama mempunyai siling kualiti yang lebih tinggi.
Keselamatan Siber: GLM-5.3 Adalah Pakar
Keselamatan siber ialah keupayaan paling tersendiri model utama. Z.ai melaporkan 84.5 pada CyberGym dan 54.4 pada ExploitBench. Di bawah bajet ternormal dua jam dan enam jam, ia menyiapkan 105 dan 130 tugas ExploitGym.
Flash tidak mempunyai penekanan pelancaran setara atau suite siber awam yang sepadan. Untuk semakan kod, pembangunan selamat, dan penemuan kelemahan yang dibenarkan, gunakan model utama sebagai model primer dan kekalkan kelulusan manusia, peralatan terasing, log audit, dan kawalan pendedahan dalam aliran kerja.
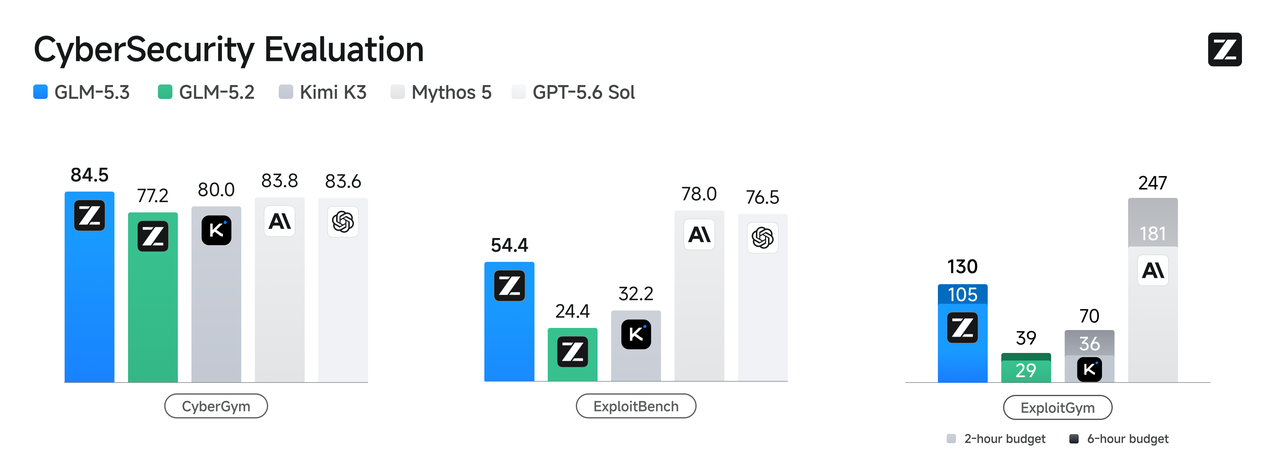
Prestasi GLM-5.3 merentasi penanda aras penemuan kelemahan dan eksploitasi.
Sumber: dokumentasi keselamatan siber rasmi Z.ai
Kos dan Penyebaran
Harga API
Z.ai menyenaraikan Flash pada $0.15 per sejuta token input dan $0.50 per sejuta token output sebelum promosi, berbanding $1.40 dan $4.40 untuk model utama.
| Laluan akses | Input Flash | Flash cache | Output Flash | Input 5.3 | 5.3 cache | Output 5.3 |
|---|---|---|---|---|---|---|
| Senarai standard Z.ai | $0.15 | $0.03 | $0.50 | $1.40 | $0.26 | $4.40 |
| Kadar promosi Flash Z.ai | $0.075 | $0.015 | $0.25 | $1.40 | $0.26 | $4.40 |
| Laluan CometAPI | $0.06 | Semak laluan langsung | $0.20 | $1.12 | Semak laluan langsung | $3.528 |
Harga dalam USD per 1M token. Sumber: harga Z.ai, laluan Flash, dan laluan GLM-5.3. Promosi boleh berubah.
Contoh Kos Bulanan
Untuk beban kerja menggunakan 100M token input dan 20M token output, kadar CometAPI semasa menghasilkan anggaran $10.00 untuk Flash berbanding $182.56 untuk model utama, sebelum kesan cache atau caj alat. Flash mengurangkan bil token kira-kira 94.5% dalam contoh ini.
| Komponen kos | GLM-5.3 Flash | GLM-5.3 |
|---|---|---|
| Kos input | 100 × $0.06 = $6.00 | 100 × $1.12 = $112.00 |
| Kos output | 20 × $0.20 = $4.00 | 20 × $3.528 = $70.56 |
| Jumlah | $10.00 | $182.56 |
Berat Terbuka dan Hos Kendiri
Kedua-dua model mempunyai checkpoint FP8 dan BF16 yang boleh dimuat turun. Berat GLM-5.3 Flash dikeluarkan di bawah Lesen MIT. GLM-5.3 menggunakan Lesen GLM-5.3 berasingan, yang memerlukan semakan keselamatan sebelum penggunaan komersial oleh pengendali Model-sebagai-Perkhidmatan yang hasil agregatnya melebihi US$10 bilion dalam mana-mana 12 bulan berturutan. Repositori GLM-5 GitHub diselesaikan di bawah Apache-2.0.
Flash lebih mudah dilayan daripada model utama, tetapi ia bukan model GPU pengguna. Checkpoint 320B, komponen multimodal, cache KV, dan konteks 1M masih memerlukan infrastruktur serius. Hos kendiri paling menarik apabila kawalan data, pelayan tersuai, atau penggunaan berterusan berintensif tinggi membenarkan kos operasi.
Model Manakah Patut Anda Pilih?
Pilih GLM-5.3 Flash jika?
- Anda memerlukan pemahaman imej, tangkapan skrin, carta, dokumen, pelayar, atau GUI.
- Anda menjalankan ejen pengekodan volum tinggi, aliran kerja penyelidikan, atau automasi perniagaan.
- Anda mahukan prestasi penggunaan alat dan kerja profesional yang kukuh pada kos token terendah.
- Anda memerlukan tetingkap konteks 1M tetapi tidak mahu ekonomi model utama pada setiap permintaan.
- Anda bercadang untuk hos kendiri dan 320B/18B lebih praktikal daripada 744B/40B.
Pilih GLM-5.3 jika?
- Anda menyelesaikan tugas pengekodan skala repositori yang paling sukar atau kejuruteraan jangka panjang.
- Penilaian anda memberi ganjaran kepada penalaran lebih dalam berbanding kos seunit yang rendah.
- Anda memerlukan keputusan lebih kukuh pada DeepSWE, HLE dengan alat, atau Agents’ Last Exam.
- Anda membina aliran kerja keselamatan defensif atau penemuan kelemahan yang dibenarkan.
- Kadar kejayaan lebih tinggi boleh mengimbangi premium token kira-kira satu tertib magnitud.
Matriks Keputusan mengikut Kes Penggunaan
| Beban kerja | Model permulaan yang disyorkan | Sebab |
|---|---|---|
| Sembang dan automasi volum tinggi | GLM-5.3 Flash | Kos jauh lebih rendah; penggunaan alat kukuh |
| Pengekodan visual dan penyahpepijatan UI | GLM-5.3 Flash | Input visual natif |
| Analisis dokumen, carta, dan Office | GLM-5.3 Flash | Aliran kerja profesional multimodal |
| Penyelenggaraan repositori rutin | Mulakan dengan Flash | Tingkatkan tugasan gagal atau luar biasa sukar |
| Kejuruteraan skala repositori sukar | GLM-5.3 | Siling pengekodan lebih tinggi |
| Penyelidikan jangka panjang dengan alat | GLM-5.3 | Keputusan HLE-dengan-alat yang lebih kuat |
| Keselamatan defensif dan penemuan kelemahan | GLM-5.3 | Latihan dan penanda aras siber khusus |
| Hos kendiri peka kos | GLM-5.3 Flash | Jejak jumlah dan aktif lebih kecil |
| Beban kerja campuran tidak pasti | Penghalaan hibrid | Flash lalai; peningkatan ke model utama |
Strategi Pengeluaran yang Lebih Baik: Hala, Jangan Ganti
Bagi kebanyakan pasukan, reka bentuk terkuat bukan pilihan eksklusif. Gunakan Flash sebagai laluan lalai, kemudian tingkatkan hanya tugas dengan kerumitan tinggi, pengesahan gagal, sensitiviti keselamatan, atau nilai ekonomi dijangka yang membenarkan premium model utama.
- Hantarkan tugas visual, rutin, dan volum tinggi kepada Flash.
- Ukur kadar penerimaan, token, kependaman, kegagalan alat, dan campur tangan manusia.
- Tingkatkan tugas teks yang gagal atau berisiko tinggi kepada model utama.
- Lalukan kerja sensitif keselamatan melalui kebenaran tambahan dan kawalan sandbox.
- Optimumkan kos per hasil yang diterima bukannya pangkat penanda aras atau harga semata-mata.
Cara Menguji Kedua-dua Model Melalui CometAPI
CometAPI menyenaraikan laluan GLM-5.3 Flash dan laluan GLM-5.3 di belakang URL asas serasi OpenAI yang sama. Cipta kunci API, kemudian jalankan tugas teks yang sama melalui kedua-dua ID model. Untuk ujian adil, kekalkan prompt, usaha penalaran, definisi alat, output maksimum, dan rubrik penerimaan yang sama.
Python
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["glm-5.3-flash", "glm-5.3"]

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[
            {
                "role": "user",
                "content": "Review this migration plan and identify its three highest-risk assumptions.",
            }
        ],
    )
    print(model, response.choices[0].message.content)
Untuk penilaian multimodal, gunakan dokumentasi laluan Flash langsung untuk mengesahkan skema kandungan imej yang disokong. Perbandingan dengan model utama harus menggunakan setara berasaskan teks kerana ia tidak menerima input visual.
Keterbatasan Perbandingan Ini
- Beberapa skor pengekodan dan ejen dilaporkan vendor. Pembiakan bebas mungkin menggunakan alat, prompt, dan tetapan inferens yang berbeza.
- Nama penanda aras yang sepadan tidak selalu menjamin versi harness atau strategi pengurusan konteks yang sama.
- Pengurangan pada peringkat senibina dalam pengiraan perhatian dan cache KV tidak meramalkan kependaman API secara langsung.
- Harga, promosi, ketersediaan model, had kadar, dan keupayaan laluan boleh berubah; sahkan halaman model langsung sebelum penerapan.
- Berat terbuka tidak menjadikan mana-mana checkpoint murah untuk hos kendiri pada konteks penuh.
- Keupayaan keselamatan siber bersifat dua guna dan memerlukan kebenaran, sandboxing, pembalakan, semakan pakar, dan pendedahan bertanggungjawab.
Kesimpulan
GLM-5.3 Flash ialah lalai yang praktikal. Ia mengekalkan konteks panjang, menambah penglihatan natif, berprestasi kukuh pada penggunaan alat dan kerja profesional, dan mengubah ekonomi secukupnya untuk menyokong penerapan yang jauh lebih meluas. GLM-5.3 ialah model peningkatan khusus: lebih mahal, berasaskan teks sahaja, tetapi lebih kuat pada tugas pengekodan, penalaran, dan keselamatan siber yang paling sukar.
Keputusan akhir oleh itu bergantung kepada beban kerja: mulakan dengan Flash, ukur kadar penerimaan sebenar, dan lalukan ke model utama hanya apabila kapasiti penalaran tambahannya menghasilkan cukup hasil berjaya tambahan untuk membenarkan premium.
Soalan Lazim
Adakah GLM-5.3 Flash lebih baik daripada GLM-5.3?
Tidak secara universal. Flash lebih baik dari segi harga, multimodaliti, dan beberapa penanda aras alat/automasi. Model utama lebih kuat pada tugas pengekodan paling sukar, penalaran dibantu alat yang sukar, dan beban kerja keselamatan siber.
Adakah GLM-5.3 Flash model kecil?
Tidak. Ia mempunyai 320B parameter jumlah dan mengaktifkan 18B setiap token. Ia lebih cekap daripada model utama 744B/40B, tetapi masih memerlukan perkakasan yang besar untuk hos kendiri.
Model mana lebih murah?
Flash jauh lebih murah. Harga senarai standard Z.ai kira-kira satu per sepuluh daripada harga model utama, dan laluan CometAPI semasa menunjukkan jurang lebih besar sementara harga promosi aktif.
Model mana lebih pantas?
Ia bergantung pada metrik dan penyedia. Artificial Analysis mengukur masa ke token pertama sedikit lebih rendah untuk Flash tetapi kelajuan output lebih tinggi untuk model utama.
Model mana yang menyokong imej?
Flash menyokong input visual natif. Model utama ketika ini menyokong input teks sahaja.
Adakah kedua-dua model menyokong konteks 1M token?
Ya. Flash menyokong konteks 1M dan sehingga 128K output; model utama menyediakan had yang sama.
Model mana lebih baik untuk pengekodan?
Gunakan Flash untuk ejen pengekodan rutin dan volum tinggi. Gunakan model utama untuk tugas kejuruteraan skala repositori paling sukar atau apabila kos kegagalan lebih tinggi daripada perbezaan harga.
Model mana lebih baik untuk keselamatan siber?
Model utama. Z.ai melatih dan menilainya khusus untuk penemuan kelemahan dan penalaran rantaian eksploitasi. Gunakannya hanya dalam persekitaran yang dibenarkan dan terkawal.
Bolehkah kedua-dua model dihoskan sendiri?
Ya. Repositori Z.ai menyenaraikan checkpoint yang boleh dimuat turun dan rangka kerja pelayan yang disokong, tetapi kedua-duanya kekal sebagai projek infrastruktur besar.
Apakah strategi penyebaran terbaik?
Gunakan Flash sebagai laluan lalai dan tingkatkan tugas teks yang sukar, gagal, atau sensitif keselamatan kepada model utama. Ukur kos per hasil yang diterima.