
TL;DR
GPT-6.1 Sol bukan pengganti GPT-6 Sol yang mempunyai konteks lebih besar atau lebih mahal. Ia mengekalkan tetingkap konteks 1.05 juta token, output maksimum 128K, dan harga API Standard $2/$10, sambil menambah baik pengekodan, penggunaan komputer, aliran kerja profesional, kebolehpercayaan fakta, dan tingkah laku agen. Perubahan harga paling jelas ialah cache prompt: kadar input yang di-cache turun daripada $0.20 kepada $0.10 per juta token.
Hasil praktikalnya ialah GPT-6.1 Sol kurang mengubah bentuk API dan lebih kepada mendapatkan kerja yang jauh lebih berguna dengan bajet token yang kurang lebih sama.
Ringkasan Utama
- GPT-6.1 Sol ialah peningkatan keupayaan kepada GPT-6 Sol, dengan tetingkap konteks 1,050,000 token dan siling output 128,000 token yang sama.
- Harga input dan output API Standard kekal $2/M dan $10/M; input yang di-cache turun daripada $0.20/M kepada $0.10/M.
- Penilaian rasmi menunjukkan pengekodan, penggunaan komputer, automasi perniagaan, dan aliran kerja saintifik yang lebih kukuh; hasil bergantung pada penanda aras dan tetapan penaakulan.
- Migrasi memerlukan semakan usaha penaakulan dan keserasian endpoint API: GPT-6.1 Sol tidak menyingkirkan apa-apa dan memerlukan Responses API untuk panggilan alat.
- Sahkan kejayaan tugas, kependaman, hit cache sebenar, dan kos hujung-ke-hujung sebelum menggantikan deployment GPT-6 Sol yang stabil.
Apakah GPT-6.1 Sol, dan Mengapa Ia Hadir Begitu Cepat Selepas GPT-6 Sol?
OpenAI memperkenalkan GPT-6 Sol pada 22 September 2026. Seminggu kemudian, addendum kad sistem bertarikh 29 September mengumumkan GPT-6.1 Sol. OpenAI menyajikan keluaran baharu ini sebagai peningkatan kepada GPT-6 Sol dan bukannya lapisan harga berasingan.
Selang keluaran yang singkat penting kerana GPT-6.1 Sol tidak diposisikan sebagai lapisan produk baharu. OpenAI mengekalkan lapisan harga Sol dan memfokuskan kemas kini ini pada keupayaan tugas sukar, kecekapan kos, dan kebolehpercayaan agen.
OpenAI memposisikan GPT-6.1 Sol di sekitar pengekodan agen, penggunaan komputer, dan kerja profesional. Perbandingan penting ialah kejayaan tugas pada kos tertentu, bukannya nama model semata-mata. Ringkasan penanda aras rasmi di bawah memisahkan peningkatan keupayaan daripada spesifikasi API yang tidak berubah.
Ini menjadikan perbandingan luar biasa ringkas: GPT-6.1 Sol terutamanya merupakan peningkatan keupayaan dan kecekapan, bukan peningkatan tetingkap konteks atau harga asas.
GPT-6.1 Sol vs. GPT-6 Sol: Apa Yang Kekal Sama?
Kedua-dua model mengekalkan kapasiti utama yang sama, modaliti input/output yang disokong, dan harga Standard input/output. Jadual ini juga merekodkan perbezaan dalam tarikh cutoff, pilihan penaakulan, panggilan alat, dan kadar input cache; perbezaan tersebut tidak boleh disalah anggap sebagai spesifikasi yang dikongsi.
Spesifikasi Dikongsi dan Perbezaan Keserasian
| Spesifikasi | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| ID model | gpt-6.1-sol | gpt-6-sol |
| Tarikh keluaran | 29 Sep. 2026 | 22 Sep. 2026 |
| Tetingkap konteks | 1,050,000 token | 1,050,000 token |
| Output maksimum | 128,000 token | 128,000 token |
| Had pengetahuan | 30 Apr. 2026 | 20 Apr. 2026 |
| Input / output teks | Ya / Ya | Ya / Ya |
| Input imej | Ya | Ya |
| Harga input Standard | $2.00 / 1M | $2.00 / 1M |
| Input yang di-cache | $0.10 / 1M | $0.20 / 1M |
| Penulisan cache | $2.50 / 1M | $2.50 / 1M |
| Harga output | $10.00 / 1M | $10.00 / 1M |
| Usaha penaakulan | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Output berstruktur | Ya | Ya |
| Panggilan fungsi | Ya melalui Responses API; tidak tersedia melalui Chat Completions | Ya melalui Responses API; Chat Completions hanya dengan reasoning_effort=none |
| Penalaan halus | Tidak | Tidak |
| Input audio / video | Tidak disokong | Tidak disokong |
| Output imej asli | Tidak disokong; penjanaan imej ialah alat berasingan | Tidak disokong; penjanaan imej ialah alat berasingan |
Dua lajur model rasmi di atas mendokumentasikan had konteks dan output yang sama. Nombor ini menerangkan kapasiti; ia tidak menetapkan ketepatan pengambilan atau kependaman yang sama merentas setiap beban kerja konteks panjang.
Had pengetahuan bergerak sedikit ke hadapan, daripada 20 April kepada 30 April 2026. Yang lebih penting, GPT-6.1 Sol tidak lagi menyokong reasoning.effort="none"; tetapan penaakulan yang tersedia bermula pada low.
Untuk pembangun yang bergantung pada tingkah laku kependaman minimum, butiran keserasian ini patut diuji kerana GPT-6 Sol masih menyokong reasoning effort none.
Seni bina: Apa Yang Masih Tidak Didedahkan
Tiada halaman model yang digunakan untuk perbandingan ini menyediakan kiraan parameter atau pecahan seni bina terperinci. Addendum kad sistem rasmi menyatakan GPT-6.1 Sol menggunakan jenis data dan latihan yang sama seperti Astra; pernyataan itu tidak membuktikan bahawa Sol dan Astra mempunyai seni bina yang sama. Perbezaan seni bina dan skala parameter oleh itu kekal tidak didedahkan dalam bahan yang dirujuk.
Harga Asas Tidak Berubah; Bacaan Daripada Cache Lebih Murah
Bagi token biasa yang tidak di-cache, tidak. Kadar input dan output Standard tidak berubah. Penambahbaikan harga utama ialah input yang di-cache.
| Harga rasmi API — USD per 1M token | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Input / 1M token | $2.00 | $2.00 |
| Input di-cache / 1M | $0.10 | $0.20 |
| Penulisan cache / 1M | $2.50 | $2.50 |
| Output / 1M token | $10.00 | $10.00 |
GPT-6.1 Sol mengurangkan input yang di-cache kepada $0.10 per juta token, atau 5% daripada kadar input tidak di-cache.
Sebagai contoh, menggunakan semula 100 juta token input yang di-cache berharga kira-kira $10 pada GPT-6.1 Sol berbanding $20 pada GPT-6 Sol. Perbezaan itu sederhana untuk prompt satu kali tetapi lebih bermakna untuk agen volum tinggi dengan prefiks prompt yang stabil.
Syarat harga rasmi yang ditunjukkan dalam dokumentasi model juga terpakai: permintaan melebihi 272K token input menggunakan kadar input dan cache 2x serta harga output 1.5x untuk keseluruhan permintaan. Mod Fast bagi GPT-6.1 Sol ialah 2x Standard; Batch dan Flex ialah 50% di bawah Standard. Pemprosesan serantau menambah premium 10% di lokasi yang tersedia, dan mod Fast tidak tersedia dengan pemastautinan data EU. Caj alat berasingan mungkin terpakai. Bajetkan mengikut mod pemprosesan terpilih, wilayah, dan hit cache sebenar.
Apa Yang Telah Diperbaiki dalam GPT-6.1 Sol?
Peningkatan paling baik dinilai merentas pengekodan, aliran kerja agen, kerja profesional, sains, kefaktualan, dan pemulihan kegagalan. Bahagian di bawah mengumpulkan peningkatan tersebut sambil mengekalkan syarat penanda aras dan batasan asal.
Gambaran Penanda Aras: Keuntungan Dilaporkan dan Syarat Penilaian
Kes terkuat untuk GPT-6.1 Sol datang daripada prestasi peringkat tugas dan bukannya spesifikasi mentah. OpenAI melaporkan penambahbaikan merentas kejuruteraan perisian, automasi perniagaan, interaksi komputer, aliran kerja saintifik, kefaktualan, dan penjajaran agen.
| Keputusan penanda aras / penilaian rasmi | GPT-6.1 Sol vs. GPT-6 Sol | Maksud Perubahan |
|---|---|---|
| DeepSWE v1.1 | +6.4 mata peratusan berbanding keputusan terbaik GPT-6 Sol, pada usaha penaakulan dan kos tugas yang lebih rendah; bukan perbandingan usaha setara | Kejuruteraan perisian ufuk panjang lebih kukuh |
| AutomationBench 1.0.6 | +4.8 mata peratusan pada usaha medium bagi kedua-dua model Sol; +2.2 mata berbanding Opus 5.5 pada usaha medium | Pelaksanaan agen perniagaan berbilang langkah lebih baik |
| OSWorld 2.0 offline | +7 mata peratusan pada usaha max; ganjaran separa pada set offline, keluaran v2026.08.08; kurang daripada separuh kos tugas | Aliran kerja penggunaan komputer lebih baik |
| Terminal-Bench Science 0.1 | Lebih 2x skor GPT-6 Sol pada usaha max, dengan kurang daripada separuh kos per tugas | Lonjakan besar dalam aliran kerja agen sains |
| Penilaian kefaktualan sukar | Pada usaha low, respons mengandungi ralat turun daripada 11.4% kepada 7.7%; penilaian prompt sukar terpilih | Kurang kesilapan fakta pada prompt sukar |
| Ujian penjajaran carian rosak | Pada usaha maksimum, kegagalan mendedahkan carian rosak turun daripada 4.9% kepada 2.1%; tugas sengaja adversarial | Pengecaman kegagalan alat yang lebih baik |
Ini ialah hasil yang dilaporkan OpenAI, bukan pengukuran CometAPI bebas. OpenAI menilai modelnya dalam persekitaran penyelidikannya atau melalui API; tingkah laku produksi boleh berbeza dengan prompt sistem dan alat yang tersedia. Angka pesaing datang daripada laporan awam. Kos tugas mencerminkan konfigurasi ujian dan bukan harga token. Butiran yang tidak dilaporkan seperti bajet per larian atau scaffold tidak harus disimpulkan.
Keputusan rasmi dalam jadual penanda aras membandingkan GPT-6.1 Sol pada usaha lebih rendah dengan skor terbaik GPT-6 Sol. Ia tidak harus digambarkan sebagai perbandingan kelajuan usaha setara yang terkawal. DeepSWE v1.1 menilai tugas kejuruteraan perisian asal dalam kod asas sebenar.
Untuk konteks, pelancaran GPT-6 Sol asal melaporkan 68.8% pada usaha maksimum di DeepSWE v1.1.
Pengekodan: Kejuruteraan Perisian Ufuk Panjang Lebih Kuat
Pengekodan mungkin peningkatan paling jelas. DeepSWE v1.1 menilai agen pada tugas kejuruteraan perisian asal dalam kod asas sebenar yang memerlukan kerja berterusan dan berbilang langkah.
Peningkatan DeepSWE yang diringkaskan di atas relevan apabila agen perlu memeriksa repositori, merancang perubahan, menggunakan alat, dan membaiki kegagalan sepanjang banyak langkah. Pembangun boleh membandingkan peningkatan ini dengan GPT-6 Astra API di CometAPI apabila memutuskan sama ada tugas paling sukar membenarkan model kos lebih tinggi.
Ini lebih penting daripada penanda aras pengekodan pendek kerana agen pengekodan jangka panjang mengumpulkan kos melalui penaakulan berulang, panggilan alat, bacaan fail, tampalan, dan penggunaan semula konteks. GPT-6.1 Sol menambah baik kedua-dua penyempurnaan tugas dan ekonomi konteks berulang tanpa menaikkan kadar token Standard $2/$10.
GPT-6 Sol API di CometAPI kekal berguna untuk deployment sedia ada dan menyediakan laluan serasi OpenAI untuk beban kerja pengekodan dan agen.
Agen AI dan Aliran Kerja Perniagaan: Automasi dan Penggunaan Komputer
Ya, dan peningkatan ini melangkaui pengekodan. AutomationBench menilai sama ada agen boleh menyelesaikan aliran kerja hujung-ke-hujung menggunakan banyak alat merentas jualan, pemasaran, operasi, sokongan, kewangan, dan HR.
Keputusan AutomationBench pada usaha medium yang sepadan dalam ringkasan penanda aras relevan untuk aliran kerja perniagaan yang sarat alat. Ia tetap keputusan penanda aras, bukan jaminan kejayaan dalam set alat syarikat sendiri. Perbandingan juga merangkumi Claude Opus 5.5 API di CometAPI; nilai semua calon dengan alat dan kriteria kejayaan yang sama sebelum memilih.
Bagi penggunaan komputer, keputusan OSWorld di atas menggunakan set offline dan ganjaran separa. Skor ganjaran separa yang lebih tinggi tidak semestinya bermaksud setiap tugas disiapkan hujung-ke-hujung. Keadaan pelayar, kebenaran, tingkah laku pemulihan, dan kualiti integrasi alat masih mempengaruhi hasil deployment.
Dokumen Profesional dan Sains: Keupayaan Tugas Kompleks yang Lebih Luas
GPT-6.1 Sol juga menolak lagi lapisan Sol ke dalam kerja pengetahuan profesional. OpenAI menilai pemahaman dokumen kompleks dengan GDP.pdf, di mana model menjawab soalan realistik berdasarkan PDF yang mengandungi jadual, carta, gambar rajah, format padat, dan butiran nota kaki merentas bidang termasuk kewangan, penjagaan kesihatan, dan undang-undang.
GDP.pdf menambah bukti untuk analisis PDF profesional di luar soal jawab teks semata-mata. Anggap hasilnya dalam pengumuman pelancaran sebagai penilaian pemahaman dokumen, bukan jaminan bahawa setiap carta, nota kaki, atau halaman imbas akan ditafsirkan dengan betul.
Keputusan Terminal-Bench Science dalam ringkasan penanda aras rasmi merangkumi aliran kerja seperti analisis data, simulasi, dan pembuktian teorem. Penilaian tempatan yang berguna harus menilai ketepatan dan kebolehulangan output akhir, sambil mengukur jumlah kos alat dan model.
Ini tidak bermakna GPT-6.1 Sol menggantikan Astra secara universal. OpenAI terus memposisikan Astra sebagai model berkeupayaan tertinggi untuk kerja hujung-ke-hujung paling sukar. Perubahan penting ialah jurang prestasi antara Sol dan Astra semakin mengecil sementara jurang harga token mereka kekal besar.
Kefaktualan dan Kebolehpercayaan Agen: Kurang Ralat dan Pengendalian Kegagalan Lebih Baik
Data kefaktualan OpenAI menghala ke arah itu, walaupun penilaian tidak boleh ditafsirkan sebagai kadar halusinasi universal.
Pengumuman rasmi terus melaporkan penambahbaikan kefaktualan pada usaha rendah: respons yang mengandungi ralat turun daripada 11.4% dengan GPT-6 Sol kepada 7.7% dengan GPT-6.1 Sol, penurunan 3.7 mata peratusan, atau kira-kira 32% pengurangan relatif. Perbualan terpilih ini sebelum ini mencetuskan ralat; angka ini bukan kadar halusinasi universal.
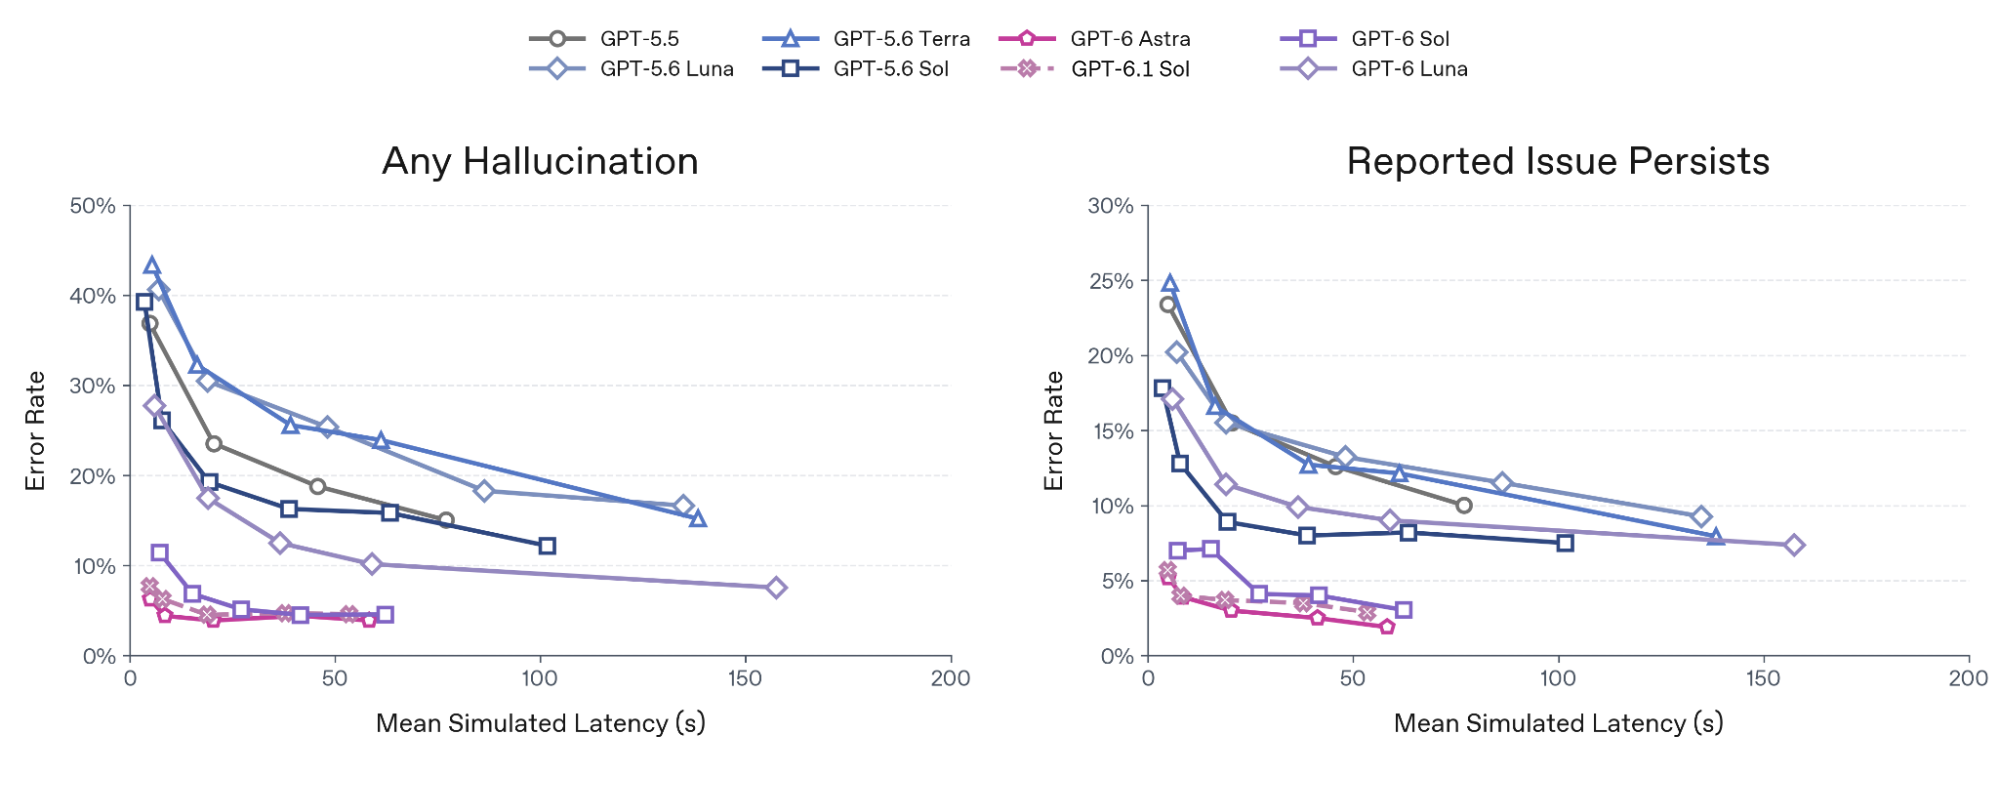
Carta asal di atas diekstrak terus daripada PDF kad sistem OpenAI tanpa dilukis semula. Ia memplot penilaian perbualan sukar terpilih terhadap kependaman simulasi; dua panel mengukur sebarang halusinasi dan keterusan isu yang dilaporkan. Ia tidak boleh dibaca sebagai anggaran ralat menyeluruh produksi.
| Model | Kadar Kegagalan Carian Rosak — usaha maksimum |
|---|---|
| GPT-6.1 Sol | 2.1% |
| GPT-6 Sol | 4.9% |
| GPT-6 Astra | 1.5% |
| GPT-6 Luna | 28.7% |
GPT-6 Luna API di CometAPI ialah pilihan berorientasikan kos lain, tetapi keputusan carian rosaknya di sini menggambarkan mengapa agen mesti diuji pada pengendalian kegagalan serta pelaksanaan alat yang berjaya.
Ini ialah penilaian yang sengaja adversarial dan bukannya kadar kegagalan produksi yang mewakili. Ia berguna sebagai bukti bahawa GPT-6.1 Sol lebih baik mengenali apabila alat tidak tersedia atau rosak dan bukannya meneruskan dengan yakin menggunakan dakwaan yang tidak disokong.
GPT-6.1 Sol vs. GPT-6 Sol: Patutkah Anda Naik Taraf?
Untuk aliran kerja kompleks baharu, GPT-6.1 Sol ialah calon penilaian yang kuat. Untuk deployment GPT-6 Sol yang stabil, naik taraf hanya apabila keuntungan terukur membenarkan migrasi. Had konteks bersama dan harga token asas menjadikan perbandingan adil mungkin, tetapi penanda aras awam tidak boleh memutuskan sama ada aplikasi anda sendiri akan menjadi lebih pantas, lebih boleh dipercayai, atau lebih murah.
Bila Naik Taraf Berbaloi Diuji
Utamakan percubaan apabila pengekodan skala repositori, automasi perniagaan berbilang langkah, penggunaan komputer, atau analisis dokumen sukar menyumbang bahagian besar beban kerja anda. Peningkatan yang dilaporkan dalam bahagian terdahulu relevan untuk kes penggunaan ini. Anggap ia sebagai sebab untuk diuji, bukannya jaminan bahawa kadar kejayaan produksi anda akan naik dengan jumlah yang sama.
Aplikasi konteks berulang ialah satu lagi kes ujian yang berguna. Kadar bacaan cache yang lebih rendah boleh mengurangkan bahagian bil input apabila permintaan benar-benar menggunakan semula prefiks yang stabil. Jika sebahagian besar perbelanjaan datang daripada token yang dijana, alat, atau percubaan gagal, diskaun cache sahaja mungkin mempunyai kesan kecil. Bandingkan kos keseluruhan per hasil diterima, termasuk percubaan semula dan masa semakan.
Bila Mengekalkan GPT-6 Sol Adalah Munasabah
Kekalkan GPT-6 Sol apabila ia sudah memenuhi sasaran kualiti, kependaman, dan bajet anda serta model baharu tidak menghasilkan manfaat material dalam penilaian yang mewakili. Integrasi yang berfungsi juga ada nilainya: elakkan menggantikan laluan stabil semata-mata kerana nama model lebih baharu.
Keserasian boleh menjadi penentu. GPT-6 Sol menyokong penaakulan none; GPT-6.1 Sol bermula pada low. Aplikasi yang menggunakan panggilan fungsi Chat Completions Sol pada none mesti memindahkan gelung alatnya ke Responses untuk menggunakan 6.1 Sol. Juga audit parameter pensampelan dan penghuraian respons. Ini ialah perubahan migrasi, bukan pertukaran ID model semata-mata. Lihat panduan migrasi OpenAI.
Cara Membuat Keputusan Naik Taraf
Cipta set penilaian tetap dengan tugas rutin, kes sukar, dan kegagalan alat daripada aliran kerja yang dimaksudkan. Kekalkan definisi tugas, kebenaran alat, dan kriteria penerimaan secara konsisten. Bandingkan garis dasar Sol yang disahkan dengan konfigurasi 6.1 Sol yang sah; rekod tetapan penaakulan dengan jelas dan jangan menyamakan none dan low.
- Kualiti: ukur penyempurnaan diterima, pembetulan fakta, panggilan alat tidak sah, dan usaha semakan manusia.
- Kelajuan: bandingkan kependaman p50/p95 hujung-ke-hujung, termasuk percubaan semula dan masa menunggu alat.
- Kos: rekod input tidak di-cache, bacaan cache, penulisan cache, token output/penaakulan, caj alat, dan usaha kejuruteraan.
- Pengembangan: mulakan dengan hirisan trafik kecil, kekalkan laluan Sol sandaran, dan kembangkan hanya apabila ambang yang ditakrifkan dipenuhi.
Syor praktikal: pilih GPT-6.1 Sol apabila percubaan memberikan ekonomi tugas diterima yang lebih baik atau peningkatan keupayaan yang diperlukan tanpa regresi yang tidak boleh diterima. Kekalkan GPT-6 Sol untuk laluan di mana keserasian dan keputusan terbukti mengatasi manfaat terukur. Deployment campuran adalah wajar apabila hanya beberapa kelas tugas meningkat. Ini ialah saranan berasaskan beban kerja, bukan dakwaan bahawa mana-mana model menang secara universal.
Bagaimana Anda Bermigrasi Dari GPT-6 Sol ke GPT-6.1 Sol?
Pada tahap paling ringkas, pengecam model berubah daripada gpt-6-sol kepada gpt-6.1-sol.
Permintaan Responses API boleh kelihatan seperti ini:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Analyze this repository and identify the cause of the failing tests."
)

print(response.output_text)
Menukar pengecam model hanyalah langkah pertama. GPT-6.1 Sol menyokong low, medium, high, xhigh, dan max, manakala GPT-6 Sol turut menyokong none. Keluarkan sebarang tetapan none yang jelas dan pilih usaha yang dibenarkan. Aplikasi yang menggunakan alat juga memerlukan Responses API: GPT-6.1 Sol Chat Completions tidak menyokong panggilan alat, manakala GPT-6 Sol Chat Completions menyokong panggilan fungsi hanya dengan none. Lajur model rasmi dalam jadual spesifikasi mendokumentasikan sekatan endpoint ini.
Pasukan harus menguji semula aliran kerja sensitif kependaman, panggilan alat, cache prompt, tingkah laku konteks panjang, dan sebarang logik yang secara jelas menghantar reasoning.effort="none".
Contoh ini menyasarkan OpenAI secara langsung menggunakan OPENAI_API_KEY; ia bukan contoh endpoint CometAPI yang disahkan. Kekalkan laluan GPT-6 Sol anda tersedia semasa pengeluaran berperingkat, rekod kejayaan tugas dan kependaman p95, dan undur jika kriteria penerimaan aplikasi anda tidak dipenuhi.
Beban Kerja Mana GPT-6.1 Sol Paling Beri Manfaat Daripada Peningkatan?
| Beban kerja | Kelebihan GPT-6.1 Sol |
|---|---|
| Agen pengekodan | Prestasi DeepSWE lebih tinggi |
| Penyahpepijatan skala repo | Kejuruteraan perisian ufuk panjang lebih baik |
| Agen pelayar/komputer | +7 mata pada OSWorld 2.0 |
| Automasi perusahaan | Prestasi AutomationBench lebih tinggi |
| Agen konteks berulang | Input yang di-cache 50% lebih murah |
| Analisis PDF kompleks | Prestasi dokumen profesional hampir setara Astra |
| Aliran kerja saintifik | Lebih 2x skor GPT-6 Sol dalam penilaian Terminal-Bench Science OpenAI |
| Aliran kerja sensitif fakta | Kadar ralat fakta pada prompt sukar lebih rendah |
| Agen sarat alat | Tingkah laku lebih baik apabila alat gagal |
GPT-6 Sol kekal berguna di tempat integrasi sedia ada sudah stabil atau di mana pembangun secara khusus memerlukan tetapan penaakulan none. Untuk deployment baharu yang berpusat pada agen, pengekodan, penggunaan komputer, atau aliran kerja konteks berulang, GPT-6.1 Sol mengubah persamaan kos-prestasi tanpa mengubah harga token input/output biasa.
Bagaimana CometAPI Boleh Membantu Anda Naik Taraf Dari GPT-6 Sol ke GPT-6.1 Sol?
Bagi pembangun yang sudah menggunakan GPT-6 Sol API di CometAPI, naik taraf kepada GPT-6.1 Sol boleh dikendalikan sebagai migrasi yang agak kecil dan bukannya penulisan semula integrasi penuh.
GPT-6.1 Sol kini tersedia melalui CometAPI dengan pengecam model gpt-6.1-sol. CometAPI pada masa ini menunjukkan harga input konteks pendek bermula pada $1.60 per juta token, berbanding kadar rasmi $2.00 OpenAI, manakala harga output bermula pada $8.00 per juta token. Ini mengekalkan model Sol yang lebih baharu dalam struktur harga diskaun yang sama seperti GPT-6 Sol sambil memberikan pembangun akses kepada prestasi pengekodan, agen, dan penggunaan komputer yang lebih kukuh.
Memandangkan CometAPI menyediakan antara muka yang serasi OpenAI, aplikasi GPT-6 Sol sedia ada biasanya boleh mengekalkan struktur SDK dan aliran permintaan yang sama sambil menukar ID model kepada gpt-6.1-sol. CometAPI juga menyediakan alat untuk membandingkan model, menguji prompt, menganggar kos beban kerja, dan memeriksa tingkah laku migrasi sebelum pengeluaran produksi.
Proses naik taraf yang lebih selamat ialah menjalankan prompt perwakilan yang sama terhadap GPT-6 Sol dan GPT-6.1 Sol terlebih dahulu, kemudian membandingkan kualiti output, kependaman, tingkah laku alat, dan jumlah kos. Ini amat penting untuk aplikasi yang bergantung pada tetapan penaakulan, output berstruktur, panggilan alat, atau agen jangka panjang, kerana keserasian model tidak menjamin tingkah laku yang sama pada setiap beban kerja.
Untuk pasukan yang menjalankan beban kerja konteks berulang atau sarat agen, laluan yang lebih baharu juga boleh memperbaiki ekonomi. CometAPI pada masa ini menetapkan harga bacaan cache konteks pendek GPT-6.1 Sol pada $0.08 per juta token, berbanding kadar rasmi $0.10, manakala kadar input dan output konteks pendek disenaraikan 20% di bawah harga rasmi.
Dalam praktiknya, CometAPI boleh menjadikan peralihan GPT-6 Sol → GPT-6.1 Sol sebagai proses tiga langkah:
- Gantikan
gpt-6-soldengangpt-6.1-sol. - Tanda aras prompt produksi dan aliran kerja agen yang sama sebelum menukar trafik.
- Pindahkan beban kerja secara beransur-ansur sebaik sahaja kualiti output, tingkah laku alat, kependaman, dan kos memenuhi keperluan anda.
Pendekatan ini membolehkan pembangun menerima pakai GPT-6.1 Sol tanpa membina semula aplikasi mereka di sekitar timbunan API baharu, sambil tetap mengesahkan perbezaan tingkah laku yang diperkenalkan oleh model yang lebih baharu.
Kesimpulan
GPT-6 Sol tidak lapuk secara teknikal. Ia mengekalkan tetingkap konteks 1.05M, siling output 128K, output berstruktur, input imej, dan harga Standard $2/$10. Opsyen penaakulan none juga boleh penting untuk integrasi sedia ada. Keputusan naik taraf harus bergantung pada hasil tugas yang diukur dan keserasian, bukan nombor versi semata-mata.
Walau bagaimanapun, dokumentasi GPT-6 Sol OpenAI kini mengarahkan pembangun kepada GPT-6.1 Sol sebagai model Sol yang lebih baharu.
Bagi kebanyakan beban kerja kompleks, soalan utama oleh itu bukan sama ada GPT-6.1 Sol mempunyai tetingkap konteks lebih besar atau kadar token lebih tinggi—jawapannya tidak. Soalannya ialah sama ada kejayaan tugas lebih tinggi, bacaan cache lebih murah, kefaktualan yang lebih baik, dan tingkah laku agen yang lebih kukuh membenarkan menukar pengecam model dan menguji semula beban kerja.
Soalan Lazim
Bagaimana anda bermigrasi dari GPT-6 Sol ke GPT-6.1 Sol dengan panggilan alat?
Tidak. Audit dahulu endpoint dan medan permintaan, kemudian pindahkan gelung alat ke Responses API dan uji penghuraian panggilan alat, pengesahan argumen, percubaan semula, dan pengendalian ralat. Jalankan canary pada tugas perwakilan sebelum meningkatkan trafik; permintaan teks sahaja yang berjaya tidak mengesahkan gelung alat yang berfungsi.
Adakah GPT-6.1 Sol lebih murah dalam beban kerja sebenar?
Log token input di-cache dan tidak di-cache, penulisan cache, token penaakulan dan output, mod pemprosesan, dan caj alat. Bandingkan kos per tugas diterima dan bukannya harga token di-cache semata-mata. Prefiks yang stabil membantu hanya apabila permintaan benar-benar terkena cache, dan gelung alat lebih panjang atau percubaan gagal boleh mengimbangi penjimatan cache.
Bagaimana anda harus menguji GPT-6.1 Sol sebelum beralih dari GPT-6 Sol?
Gunakan set tugas seperti produksi yang tetap dan rekod penyempurnaan berjaya, pembetulan fakta, panggilan alat tidak sah, kependaman p50/p95, dan jumlah kos. Tentukan ambang boleh diterima sebelum ujian. Kekalkan laluan perutean model untuk undur dan kembangkan trafik hanya selepas konfigurasi baharu memenuhi ambang tersebut.
Bagaimana anda menguji GPT-6.1 Sol dengan PDF?
Bina korpus kecil dengan jadual padat, nota kaki, carta, dan halaman imbas yang mewakili aliran kerja yang dimaksudkan. Tanyakan soalan dengan jawapan yang boleh disahkan dan minta bukti halaman atau jadual. Skor ketepatan pengiraan, kaveat yang hilang, dan jawapan tidak disokong secara berasingan; kekalkan semakan manusia untuk output yang kesilapannya membawa akibat material.