
GPT-6 Astra dan Claude Fable 5.1 tiba hanya dua hari berbeza: Astra dilancarkan pada 3 September, manakala Fable 5.1 dilancarkan pada 1 September. Walaupun masa pelancaran hampir, perbezaan paling penting muncul pada bentuk penanda aras, pelaksanaan alat, dan ekonomi cache.
Persamaan berakhir sebaik beban kerja bermula. Penilaian pelancaran OpenAI meletakkan Astra di hadapan merentasi beberapa ujian pengekodan, sains, penggunaan komputer, dan kerja profesional, manakala penanda aras yang diterbitkan Anthropic menunjukkan Fable 5.1 mendahului pada Humanity’s Last Exam. Fable 5.1 juga mempunyai harga bacaan cache rasmi yang lebih rendah, yang boleh mengubah ekonomi agen yang berjalan lama secara material.
Jadi soalan berguna bukan sekadar model mana mempunyai skor penanda aras yang lebih tinggi. Soalan praktikal ialah model mana yang menyiapkan beban kerja anda dengan lebih boleh dipercayai dan lebih ekonomik.
Jawapan ringkas: Astra ialah pilihan lalai yang lebih kukuh untuk agen berintensif pelaksanaan, pengekodan, penggunaan komputer, dan aliran kerja saintifik yang dipacu alat. Fable 5.1 amat menarik untuk penaakulan sukar yang luas, kerja tak segerak jangka panjang, dan aplikasi yang berulang kali menggunakan semula konteks cache yang sangat besar.
GPT-6 Astra vs Claude Fable 5.1 Sekilas Pandang
| Spesifikasi | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Pembangun | OpenAI | Anthropic |
| Tarikh keluaran | 3 Sep, 2026 | 1 Sep, 2026 |
| ID model API | gpt-6-astra | claude-fable-5-1 |
| Tetingkap konteks | 1,050,000 token | 1,000,000 token |
| Output maksimum | 128,000 token | 128,000 token |
| Modaliti input | Teks, imej | Teks, imej |
| Modaliti output | Teks | Teks |
| Tarikh pemotongan pengetahuan | 30 Apr, 2026 | Jun 2026 |
| Penaakulan | low / medium / high / xhigh / max | Adaptif, sentiasa diaktifkan |
| Usaha lalai | — | tinggi |
| Input / output rasmi | $10 / $50 per MTok | $10 / $50 per MTok |
| Bacaan cache rasmi | $1 / MTok | $0.25 / MTok |
| Harga konteks panjang | Aras lebih tinggi di atas 272K input | Kadar model standard merentas 1M konteks |
| Pemosisian utama | Pelaksanaan hujung-ke-hujung, pengekodan, penggunaan komputer | Penaakulan mencabar, agen ufuk panjang |
Maklumat dan harga disahkan pada 7 September, 2026. Spesifikasi dan harga penyedia boleh berubah selepas penerbitan.
Sumber: Penanda aras rasmi OpenAI
Apakah GPT-6 Astra?
OpenAI memperkenalkan GPT-6 Astra pada 3 September, 2026 sebagai model paling berkeupayaan untuk kerja profesional hujung-ke-hujung yang sukar. Daripada menumpukan pada soal jawab berasingan, Astra direka untuk menyiapkan aliran kerja kompleks yang menggabungkan penaakulan, pengekodan, penyelidikan, interaksi komputer, dan penciptaan dokumen. Ia boleh bekerja merentas berbilang langkah, menggunakan alat dan konteks yang dibekalkan, dan menyesuaikan diri apabila pengguna menyemak arahan atau menukar haluan semasa tugas. Nota keluaran OpenAI menyerlahkan aplikasi seperti menghasilkan dokumen, hamparan, dan pembentangan yang mengikut arahan dan templat khusus.
Model ini menyediakan tetingkap konteks 1,050,000 token dan output maksimum 128,000 token, membolehkannya memproses pangkalan kod besar, koleksi dokumen meluas, atau sejarah agen yang berjalan lama dalam satu aliran kerja. Usaha penaakulan boleh dikonfigurasikan pada low, medium, high, xhigh, atau max, membolehkan pembangun mengimbangi kelajuan respons dan kedalaman pengiraan mengikut kesukaran setiap tugas.
Apakah Claude Fable 5.1?
Anthropic melancarkan Claude Fable 5.1 pada 1 September, 2026 sebagai model peringkat tertinggi untuk penaakulan menuntut dan kerja agen ufuk panjang. Ia dibina atas Claude Fable 5 dengan penambahbaikan dalam tugas pengekodan yang berjalan lama, penyelidikan berbilang langkah, dan penciptaan atau analisis dokumen, hamparan, serta pembentangan. Anthropic mengesyorkannya untuk beban kerja di mana penaakulan berterusan dan pelaksanaan yang boleh dipercayai lebih penting daripada kelajuan respons mentah—khususnya apabila Claude Opus 5 pada tetapan usaha lebih tinggi tidak memberikan prestasi mencukupi.
Menurut spesifikasi rasmi Claude Fable 5.1, model ini menawarkan tetingkap konteks 1 juta token dan output maksimum 128,000 token. Ini memberinya kapasiti mencukupi untuk meneliti repositori besar, rekod perniagaan panjang, koleksi penyelidikan, atau trajektori agen yang panjang tanpa perlu membahagikan bahan secara agresif kepada permintaan berasingan. Ia menerima input teks dan imej serta menghasilkan output teks, dengan tarikh pemotongan pengetahuan Jun 2026.
Perbandingan Penanda Aras: Astra Menang Lebih Banyak Baris, tetapi Tidak Semua yang Penting
Perbandingan penanda aras antara vendor bersaing memerlukan lebih banyak berhati-hati daripada perbandingan generasi demi generasi biasa. OpenAI menguji Fable 5.1 pada beberapa penilaian pelancaran Astra, manakala Anthropic menggunakan rangka kerjanya sendiri dan, dalam beberapa kes, keluaran tugas yang lebih baharu. Itu menjadikan perbandingan paling bersih ialah ujian di mana definisi dan tetapan dilaporkan sejajar dengan cukup baik untuk menyokong keputusan langsung.
GPT-6 Astra vs Claude Fable 5.1: yang mana lebih baik untuk Pengekodan dan Perisian Berorientasikan Agen
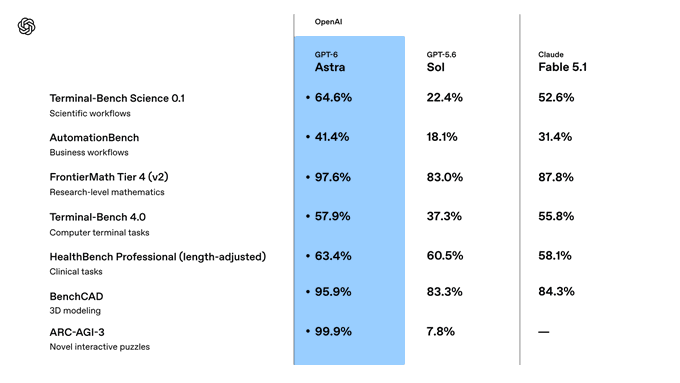
Pengekodan ialah salah satu bidang kekuatan paling jelas untuk Astra. Pada jadual pelancaran yang diterbitkan OpenAI, Astra mencatat 57.9% berbanding 55.8% pada Terminal-Bench 4.0, 74.1% berbanding 67.4% pada DeepSWE v1.1, dan 63.9% berbanding 57.8% pada penilaian migrasi pangkalan data dalaman.
| Penanda aras pengekodan | GPT-6 Astra | Claude Fable 5.1 | Keputusan |
|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 55.8% | Astra +2.1 mata |
| DeepSWE v1.1 | 74.1% | 67.4% | Astra +6.7 mata |
| FrontierCode 1.1 Extended | 64.5% | 63.6% | Astra +0.9 mata |
| FrontierCode 1.1 Main | 53.3% | 50.9% | Astra +2.4 mata |
| Migrasi pangkalan data, dalaman | 63.9% | 57.8% | Astra +6.1 mata |
Astra mewakili kemajuan besar untuk model berfokus pelaksanaan: keputusan yang diterbitkan mendahului Fable 5.1 pada Terminal-Bench 4.0, DeepSWE v1.1, dan penilaian migrasi pangkalan data, mengukuhkan kelebihannya apabila kod perlu dilaksanakan, diuji, dan disahkan merentas alat.
Kesimpulannya bukan bahawa Fable 5.1 lemah dalam pengekodan. Anthropic menerangkannya sebagai model paling berkeupayaan untuk projek pengekodan bercita-cita tinggi, dan keputusan CursorBench 3.2.0nya mencapai 73.4%. Bezanya ialah bentuk beban kerja: kelebihan Astra menjadi lebih meyakinkan apabila pengekodan dicampur dengan pelaksanaan shell, navigasi repositori, pengesahan, dan alat lain.
Pemenang untuk kejuruteraan perisian berintensif pelaksanaan: Astra. Agen repositori yang berjalan lama ialah keputusan yang lebih rapat kerana koheren berterusan, gelagat cache, dan kecekapan token boleh sama pentingnya dengan satu skor penanda aras.
GPT-6 Astra vs Fable 5.1: yang mana lebih baik untuk Penaakulan dan Sains
Perbandingan penaakulan lebih menarik kerana tiada kemenangan menyeluruh. Penilaian yang diterbitkan OpenAI melaporkan Astra pada 97.6% untuk FrontierMath Tier 4, 96.0% untuk GPQA Diamond, dan 64.6% untuk Terminal-Bench Science 0.1. Fable 5.1 mencatat masing-masing 87.8%, 93.7%, dan 52.6% dalam perbandingan yang sama.
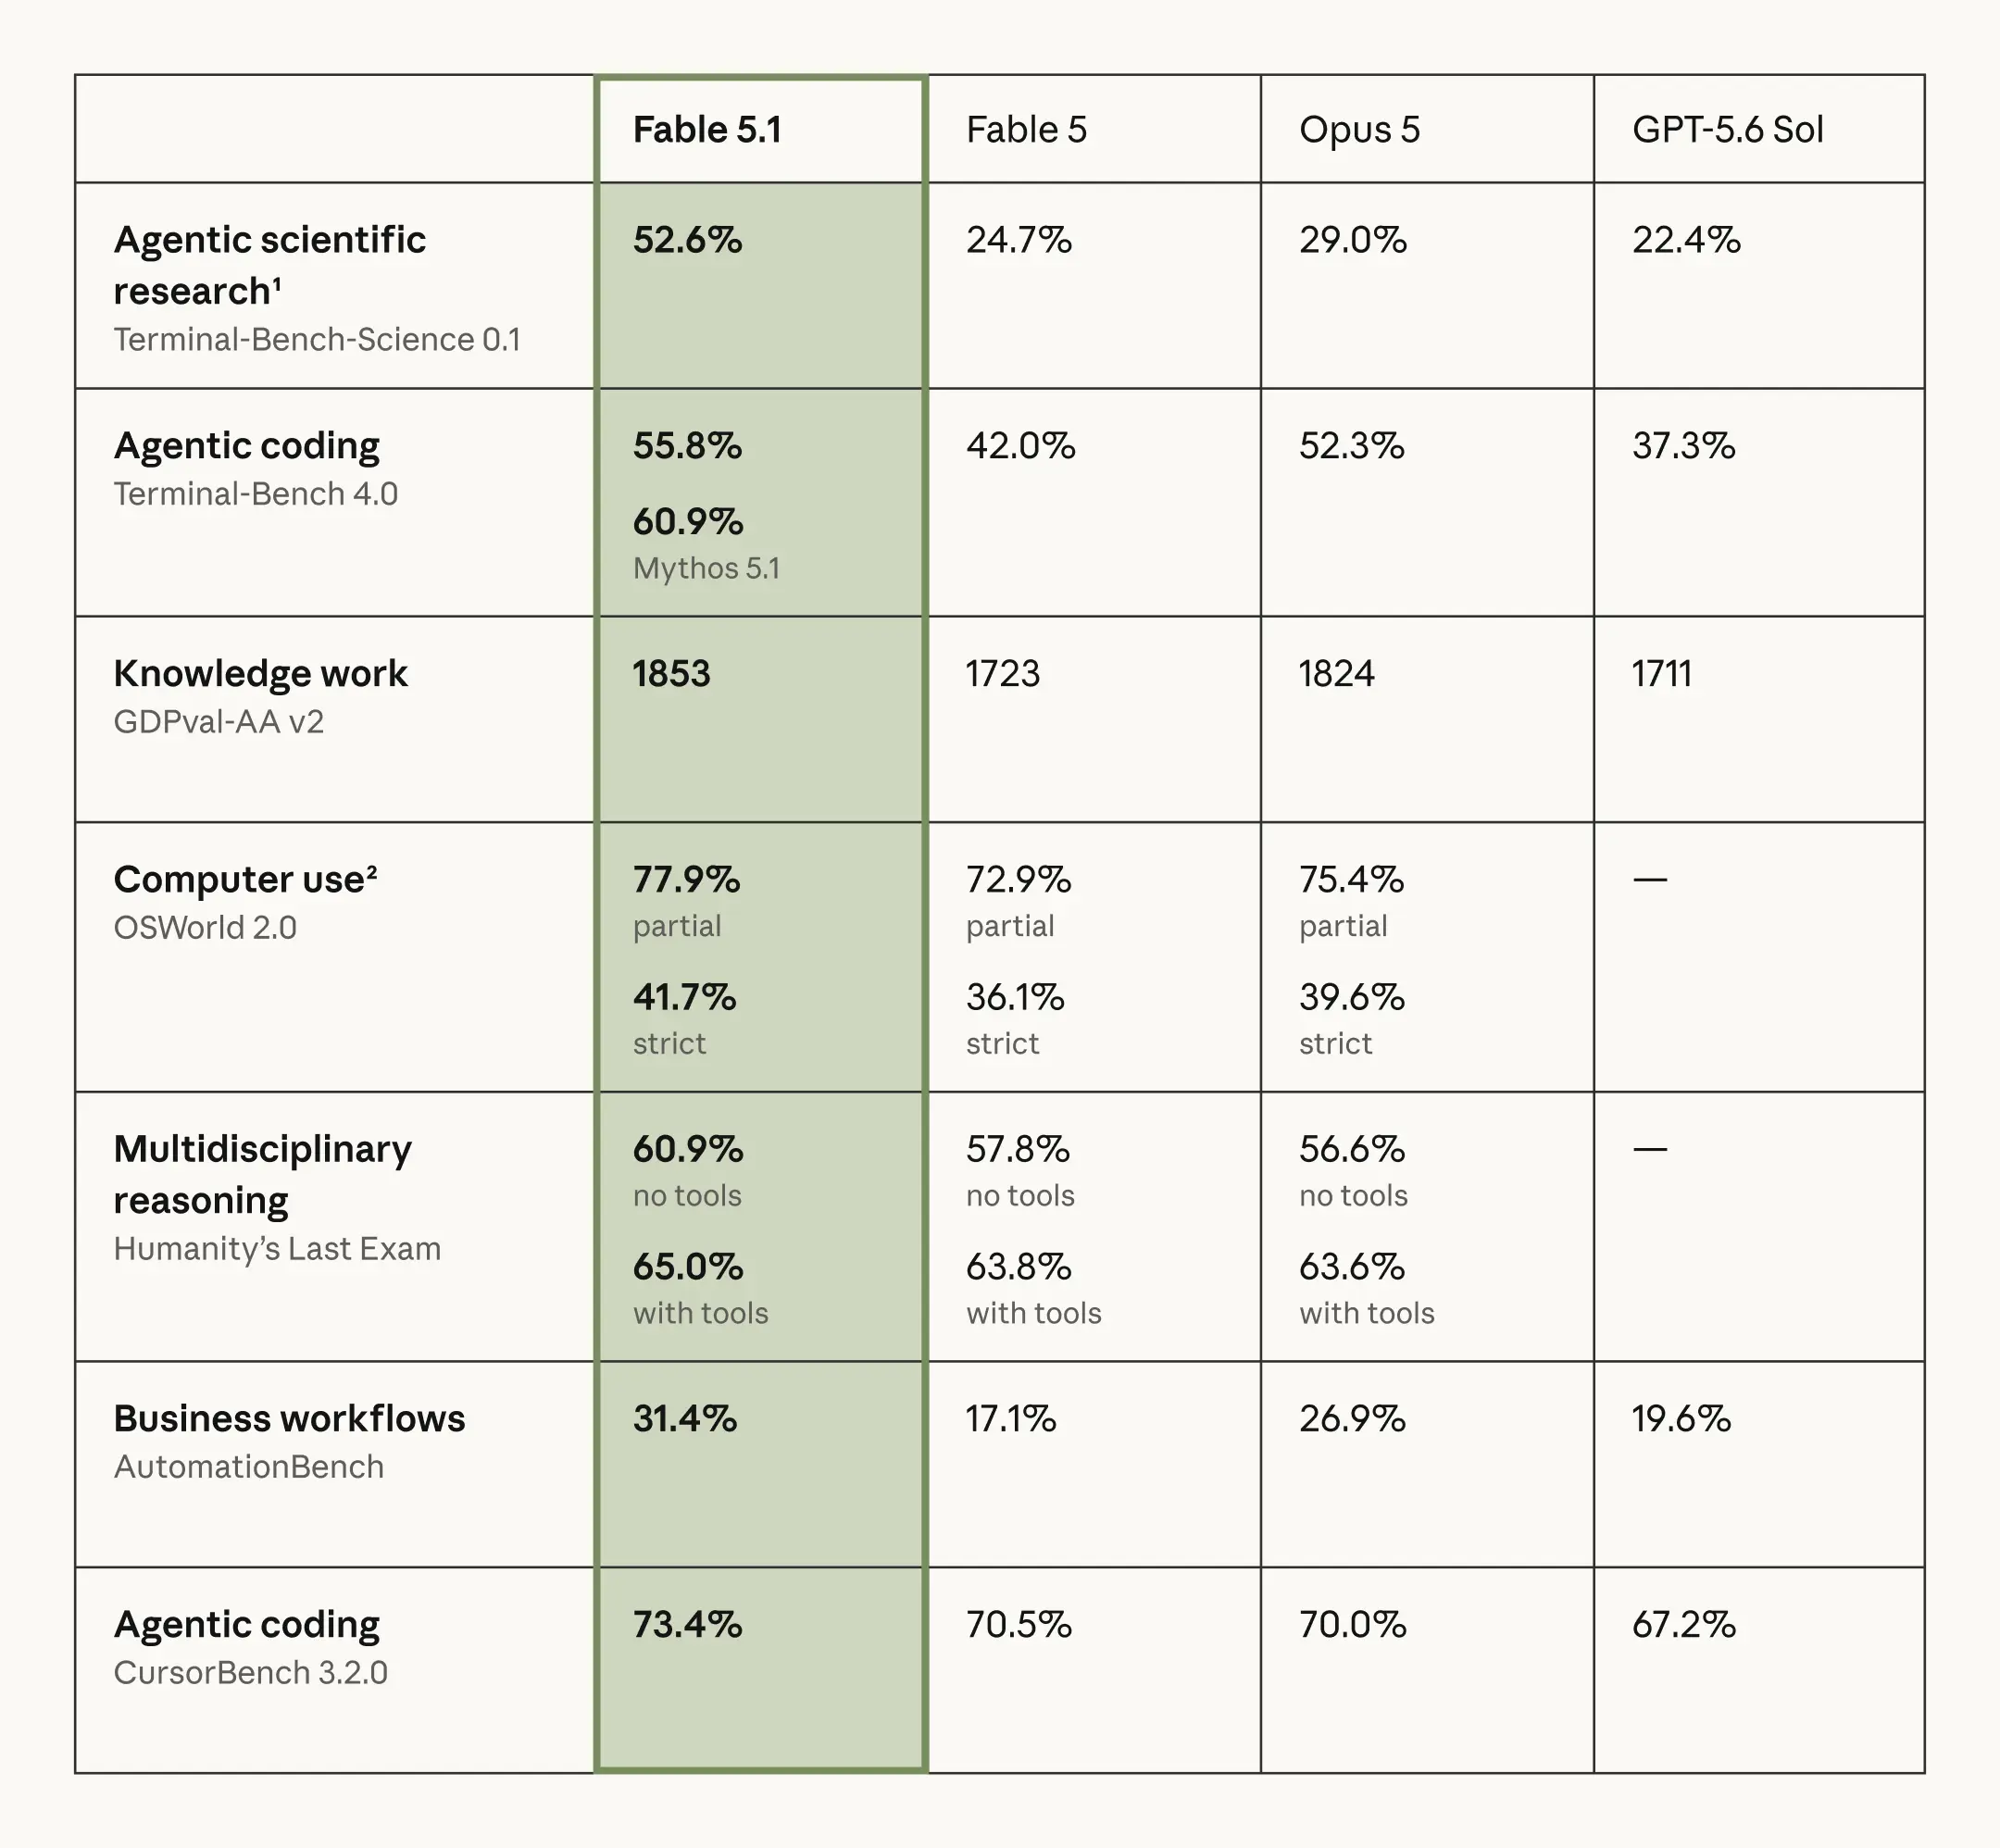
Fable 5.1 membalikkan keputusan pada Humanity’s Last Exam dengan alat, mencatat 65.0% berbanding 57.2% untuk Astra. Jadual penanda aras rasmi Anthropic secara bebas melaporkan keputusan 65.0% yang sama untuk Fable 5.1.
| Penanda aras penaakulan/sains | GPT-6 Astra | Claude Fable 5.1 | Pemenang |
|---|---|---|---|
| FrontierMath Tier 4 v2 | 97.6% | 87.8% | Astra |
| GPQA Diamond | 96.0% | 93.7% | Astra |
| Terminal-Bench Science 0.1 | 64.6% | 52.6% | Astra |
| Humanity's Last Exam, dengan alat | 57.2% | 65.0% | Fable 5.1 |
| Artificial Analysis Intelligence Index | 61.2 | 65.7 | Fable 5.1 |
Perbezaan ini penting. FrontierMath dan Terminal-Bench Science menekankan penyelesaian masalah matematik atau saintifik khusus, terutamanya apabila penaakulan berinteraksi dengan alat dan persekitaran luaran. Humanity’s Last Exam lebih luas dan pelbagai disiplin. Bacaan praktikal ialah Astra kelihatan lebih kuat dalam penaakulan teknikal yang mendalam dan dilaksanakan oleh alat, manakala Fable 5.1 mengekalkan kelebihan pada penilaian penaakulan sempadan yang lebih luas.
Sumber: Penanda aras rasmi Anthropic
Penggunaan Komputer dan Kerja Profesional Memihak kepada GPT-6 Astra
Perbandingan OSWorld Astra-versus-Fable 5.1 secara langsung akan mengelirukan. Nota penanda aras Anthropic menyatakan Fable 5.1 menggunakan keluaran tugas Ogos 2026 oleh pengarang. Cartanya melaporkan 77.9% separa dan 41.7% ketat, tetapi angka tersebut tidak setara dengan keputusan OpenAI 72.6%.
| Penanda aras profesional | GPT-6 Astra | Claude Fable 5.1 | Keputusan |
|---|---|---|---|
| AutomationBench | 41.4% | 31.4% | Astra +10.0 mata |
| BenchCAD | 95.9% | 84.3% | Astra +11.6 mata |
| Terminal-Bench Science | 64.6% | 52.6% | Astra +12.0 mata |
OpenAI juga secara khusus melatih Astra untuk menghasilkan dokumen, hamparan, dan pembentangan serta menyatakan ia direka untuk melaksanakan aliran kerja profesional berbilang langkah dan bukan sekadar menjana komponen teks. Fable 5.1 juga dibina untuk agen yang berjalan lama, operasi pelayar, penyelidikan, pengekodan, dan aliran kerja dokumen profesional, tetapi Astra kini mempunyai bukti yang lebih kukuh yang diterbitkan untuk pelaksanaan bermediasi komputer dan penghasilan artifak.
Pemenang untuk agen penggunaan komputer dan automasi profesional: Astra.
Konteks Panjang GPT-6 Astra vs Claude Fable 5.1: 1.05M vs 1M ialah Perbandingan yang Salah
Astra secara teknikal mempunyai tetingkap konteks yang lebih besar: 1.05 juta token berbanding 1 juta untuk Fable 5.1. Perbezaan 5% itu tidak mungkin menentukan seni bina produksi. Harga di dalam tetingkap konteks boleh melakukannya.
Peraturan harga konteks panjang OpenAI terpakai apabila permintaan mengandungi lebih daripada 272K token input: kadar input dan cache berganda, manakala kadar output meningkat sebanyak 1.5 kali untuk keseluruhan permintaan. Oleh itu, kadar efektif Astra menjadi $20 input, $2 input cache, dan $75 output per MTok.
Spesifikasi Fable 5.1 mendokumenkan tetingkap konteks 1M dengan $10 input, $50 output, dan $0.25 bacaan cache per MTok. Untuk aplikasi yang secara rutin memuatkan 300K, 500K, atau 900K token ke dalam permintaan, saiz tetingkap konteks nominal hanya memberitahu separuh cerita.
Untuk konteks yang sangat besar, Fable 5.1 mempunyai ekonomi kad kadar yang lebih bersih, terutamanya apabila sebahagian besar konteks boleh di-cache.
Harga GPT-6 Astra vs Claude Fable 5.1: Harga Tajuk Sama, Ekonomi Agen Sangat Berbeza
Pada kadar Standard rasmi, kedua-dua model bermula dengan seri tepat pada input teks tidak di-cache dan output.
| Komponen harga | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Input / MTok | $10.00 | $10.00 |
| Output / MTok | $50.00 | $50.00 |
| Tulisan cache 5 minit / MTok | $12.50 | $12.50 |
| Bacaan cache / MTok | $1.00 | $0.25 |
| Diskaun input/output kelompok | 50% | 50% |
| Caj tambahan konteks panjang | Di atas 272K input | Tiada merentas konteks piawai 1M |
Angka utama bukan $10 atau $50. Ia ialah $0.25. Anthropic menurunkan kadar bacaan cache Fable 5.1 kepada $0.25 per juta token, satu per empat daripada harga input cache standard $1 untuk Astra dan satu per lapan daripada kadar cache konteks panjang $2 Astra.
Ini boleh memberi kesan besar untuk gelung agen. Aplikasi yang berjalan lama mungkin berulang kali membawa prompt sistem besar, definisi alat, konteks repositori, dan dokumen rujukan merentas berpuluh-puluh giliran. Apabila prefiks stabil berulang kali dibaca daripada cache, harga cache berkompaun dengan cara yang penanda aras satu giliran tidak pernah tangkap.
Anggaran beban kerja Anthropic menyatakan harga cache yang lebih rendah boleh mengurangkan kos beban kerja tipikal Fable 5.1 sekitar 25% dan kos beban kerja yang sangat agen sehingga kira-kira 45%. Ini ialah anggaran vendor dan bukannya jaminan sejagat, tetapi ia menunjukkan mengapa ekonomi cache wajar mempunyai dimensi perbandingan tersendiri.
Adakah Itu Menjadikan Fable 5.1 Lebih Murah?
Tidak secara automatik. Model dengan token lebih mahal masih boleh menghasilkan bil yang lebih rendah jika ia menyelesaikan tugas dengan lebih sedikit token, lebih sedikit percubaan semula, lebih sedikit panggilan alat gagal, atau masa dinding yang lebih pendek. Inilah sebabnya kos per tugas yang berjaya lebih bermaklumat daripada harga per juta token.
Keputusan harga praktikal berpecah: Fable 5.1 menang kad kadar untuk beban kerja yang berat cache dan konteks yang sangat panjang. Astra masih boleh menang dari segi kos setiap tugas siap apabila kelebihan pelaksanaannya mengurangkan percubaan semula, penggunaan token, atau masa jalan secara material.
Harga CometAPI Mengecilkan Keputusan kepada Kualiti Beban Kerja
Kedua-dua model tersedia melalui CometAPI. API GPT-6 Astra dalam CometAPI bermula pada $8 per juta token input, manakala API Claude Fable 5.1 dalam CometAPI bermula pada kadar input $8 yang sama. Itu 20% di bawah kadar input asas penyedia.
| Harga API | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Input / output rasmi | $10 / $50 | $10 / $50 |
| Input / output CometAPI | $8 / $40 | $8 / $40 |
| Pengurangan vs kadar asas rasmi | 20% | 20% |
Ini mewujudkan persediaan produksi yang berguna: daripada memutuskan semata-mata berdasarkan jadual penanda aras awam, pembangun boleh menilai beban kerja yang sama terhadap kedua-dua ID model melalui satu persekitaran API dan membandingkan kadar keputusan yang diterima, penggunaan token, kependaman, kegagalan alat, dan jumlah perbelanjaan. Harga dan peraturan bil boleh berubah, jadi pembajetan produksi harus menggunakan konfigurasi API langsung dan bukannya mengkod nilai dalam artikel ini.
Penggunaan Alat dan Reka Bentuk Agen: Matlamat Serupa, Falsafah Berbeza
Kedua-dua model direka untuk agen, tetapi API mereka mendedahkan falsafah yang berbeza. GPT-6 Astra menyokong persekitaran Responses API yang kaya alat. Set alat yang disokong OpenAI termasuk web search, file search, image generation, code interpreter, hosted shell, Apply Patch, computer use, MCP, dan tool search. Usaha penaakulan boleh dikonfigurasikan membolehkan aplikasi memutuskan berapa banyak pengiraan untuk digunakan.
Model penaakulan Fable 5.1 berbeza: pemikiran adaptif sentiasa diaktifkan, dengan effort digunakan untuk mengemudi kedalaman. Anthropic juga menambah usaha per mesej, mesej sistem berskala giliran, dan kemas kini kemajuan yang boleh dibaca antara panggilan alat, yang amat berguna dalam sesi autonomi panjang.
Oleh itu, GPT-6 Astra terasa dioptimumkan sekitar keluasan alat dan kawalan persekitaran hujung-ke-hujung, manakala Fable 5.1 terasa dioptimumkan sekitar penaakulan berterusan ufuk panjang dan kesinambungan agen. Tiada gaya seni bina yang unggul secara universal; lapisan orkestrasi anda sama pentingnya dengan model mentah.
Mengapa Keselamatan dan Kekangan Penerapan Penting untuk GPT-6 Astra dan Claude Fable 5.1
OpenAI menggambarkan Astra sebagai model pertamanya yang mencapai ambang keselamatan siber Critical syarikat dan mengerahkan perlindungan tambahan sekitar aliran kerja berkeupayaan tinggi. Pengumuman yang sama menerangkan pemantauan produksi dan gangguan tugas apabila agen mungkin melebihi skop yang dibenarkan.
Fable 5.1 menggunakan seni bina perlindungan yang berbeza. Anthropic menyatakan beberapa permintaan keselamatan siber dan biologi yang dikenal pasti oleh perlindungannya boleh diarahkan kepada model yang kurang berkeupayaan. Ini bermakna skor produksi boleh mencerminkan kedua-dua model asas dan perlindungan yang mengelilinginya.
Ini satu lagi sebab jadual penanda aras merentas vendor tidak harus dianggap sebagai perbandingan makmal yang dikawal sempurna. Penilaian perusahaan harus merangkumi penolakan, gelagat fallback, gangguan tugas, keperluan audit, pengekalan data, dan kawalan privasi bukannya mempertimbangkannya hanya selepas pemilihan model.
GPT-6 Astra vs Claude Fable 5.1: Model Mana Harus Anda Pilih?
| Beban kerja | Model disyorkan | Sebab |
|---|---|---|
| Agen penggunaan komputer autonomi | Astra | Bukti penggunaan komputer dan pelaksanaan profesional yang lebih kukuh |
| Terminal berorientasikan agen / kejuruteraan perisian | Astra | Mendahului keputusan Terminal-Bench, DeepSWE, dan migrasi pangkalan data |
| Aliran kerja alat saintifik | Astra | Keputusan FrontierMath, GPQA, dan Terminal-Bench Science yang kukuh |
| Penaakulan sempadan yang luas | Fable 5.1 | Mendahului HLE dengan alat dan Intelligence Index |
| Agen tak segerak yang berjalan lama | Fable 5.1 | Direka sekitar kerja agen ufuk panjang dan kemas kini kemajuan |
| Permintaan 300K–1M token | Fable 5.1 | Mengelakkan caj tambahan konteks panjang 272K Astra pada harga standard |
| Guna semula cache prompt yang berat | Fable 5.1 | Bacaan cache rasmi $0.25/MTok |
| Automasi dokumen / hamparan / pembentangan | Astra | Pemosisian kerja profesional dan penghasilan artifak yang kukuh |
| Repositori besar dengan konteks di-cache berulang | Fable 5.1 | Ekonomi cache boleh mendominasi gelung agen berulang |
| Beban kerja produksi bercampur-campur | Uji kedua-duanya | Kekuatan berbeza menjadikan penghalaan beban kerja lebih berguna daripada pemenang sejagat |
Jika aplikasi anda meminta model untuk bertindak, Astra biasanya harus menjadi model pertama untuk diuji. Jika aplikasi meminta model untuk berfikir untuk tempoh yang panjang ke atas konteks yang sangat besar dan berulang kali diguna semula, Fable 5.1 wajar mendapat perhatian yang sama atau lebih.
GPT-6 Astra vs Claude Fable 5.1: Yang Mana Lebih Baik Secara Keseluruhan?
Tiada keputusan 10–0 yang bersih. Astra menang lebih banyak baris yang diterbitkan vendor yang boleh dibandingkan secara langsung, dengan kelebihan yang konsisten terutamanya merentasi pelaksanaan pengekodan, alatan saintifik, penggunaan komputer, dan automasi profesional. Untuk pembangun yang membina agen yang mesti mengendalikan perisian dan bukannya sekadar membincangkan apa yang perlu dilakukan, itu ialah kelebihan yang besar.
Kemenangan Fable 5.1 lebih sempit tetapi strategik penting. Keputusan Humanity’s Last Exam 65.0% dan skor Intelligence Index yang lebih kukuh menunjukkan Astra tidak semata-mata mendominasi penaakulan umum. Fable 5.1 juga mempunyai kelebihan harga struktur untuk agen berat cache dan permintaan yang menggunakan sebahagian besar tetingkap konteks sejuta token.
Perubahan yang lebih mendalam ialah pemilihan model sempadan beralih daripada “chatbot mana memberi jawapan paling pintar?” kepada “sistem mana menyiapkan kerja ini dengan betul pada jumlah kos terendah?”
Cara Membandingkan Mereka untuk Aplikasi Anda Sendiri
Papan pendahulu awam harus menyempitkan senarai pendek anda, bukan membuat keputusan produksi anda. Bina set penilaian tetap daripada tugas sebenar. Jalankan bahan input yang sama terhadap kedua-dua model, kekalkan kebenaran alat yang setara, dan ukur bukan sahaja sama ada jawapan akhir nampak baik tetapi sama ada tugas benar-benar berjaya.
Untuk aplikasi berasaskan agen, metrik berguna termasuk kejayaan tugas keseluruhan, kadar penerimaan manusia, kegagalan panggilan alat, percubaan semula, masa ke penyiapan, input tidak di-cache, bacaan cache, token output, dan jumlah perbelanjaan API.
Metrik penerapan mudah ialah jumlah perbelanjaan API ÷ tugas siap yang diterima.
Angka itu boleh membalikkan keputusan berasaskan penanda aras. Model yang mengenakan lebih per token boleh jadi lebih murah jika ia memerlukan lebih sedikit percubaan semula. Model dengan cache murah boleh menjadi jauh lebih murah merentas gelung agen 50 giliran. Model yang mendapat skor lebih tinggi secara terasing boleh tewas sebaik sahaja alat anda, lapisan pengambilan, dan kriteria penerimaan sebenar diperkenalkan.
Memandangkan Astra dan Fable 5.1 tersedia melalui CometAPI, strategi produksi yang paling kukuh bukan semestinya untuk komited secara kekal kepada satu penyedia. Kekalkan model boleh dikonfigurasi, nilai kedua-duanya terhadap kriteria penerimaan yang sama, dan halakan setiap beban kerja kepada model yang benar-benar berprestasi terbaik.
Soalan Lazim
Adakah GPT-6 Astra lebih baik daripada Claude Fable 5.1?
Astra lebih kuat pada beberapa penanda aras pengekodan, sains, dan kerja profesional yang boleh dibandingkan secara langsung, termasuk Terminal-Bench, DeepSWE, FrontierMath, dan AutomationBench. Fable 5.1 mendahului pada Humanity’s Last Exam dengan alat dan Artificial Analysis Intelligence Index. Tiada model yang menang pada setiap dimensi.
Model mana lebih baik untuk pengekodan?
GPT-6 Astra ialah model yang lebih baik untuk pengekodan, terutamanya untuk pengekodan berorientasikan agen dan pelaksanaan. Perbandingan yang diterbitkan OpenAI melaporkan 57.9% untuk Astra berbanding 55.8% untuk Fable 5.1 pada Terminal-Bench 4.0, dengan jurang Astra lebih besar pada DeepSWE dan penilaian migrasi pangkalan data. Claude Fable 5.1 kekal sangat kompetitif untuk kerja repositori yang berjalan lama, tetapi Astra mempunyai bukti pengekodan keseluruhan yang lebih kukuh.
Model mana lebih baik untuk konteks panjang?
Claude Fable 5.1 ialah pilihan yang lebih baik untuk beban kerja konteks panjang, terutamanya untuk permintaan yang sangat besar dan penggunaan semula cache prompt berulang. Kedua-dua model menyediakan kira-kira sejuta token konteks, tetapi GPT-6 Astra mengenakan kadar lebih tinggi apabila input melebihi 272K token, manakala Fable 5.1 mengekalkan struktur kadar yang lebih ringkas dan menawarkan bacaan cache prompt yang jauh lebih murah.
Yang mana lebih murah?
Tiada model yang lebih murah pada kadar asas standard—mereka seri; Claude Fable 5.1 lebih murah untuk beban kerja yang berat cache dan konteks yang sangat panjang. Harga asas rasmi ialah $10 per juta token input dan $50 per juta token output untuk kedua-dua model. Melalui CometAPI, GPT-6 Astra dan Fable 5.1 kedua-duanya kini bermula pada $8 per juta token input dan $40 per juta token output. Fable 5.1 memperoleh kelebihan kos apabila bacaan cache prompt atau caj tambahan konteks panjang Astra menjadi material.
Patutkah pembangun menggunakan hanya satu daripadanya?
Tidak semestinya. Kekuatan mereka cukup saling melengkapi sehingga strategi penilaian atau penghalaan berbilang model boleh mengatasi memilih satu model untuk setiap permintaan. Uji beban kerja produksi sebenar dan bandingkan kos per tugas siap yang diterima bukannya bergantung pada satu skor penanda aras.