
Ringkasan Pantas
Grok 4.7 dan Xiaomi MiMo-V2.6 dilancarkan selang sehari, namun mewakili dua pendekatan berbeza kepada AI barisan hadapan. Grok 4.7 menekankan tindanan agen proprietari yang terintegrasi ketat untuk pengekodan dan kerja pengetahuan profesional, manakala MiMo-V2.6-Pro menggabungkan berat model terbuka, tetingkap konteks lebih besar, pemahaman multimodal asli, dan harga API yang agresif.
SpaceXAI memposisikan Grok 4.7 sebagai model barisan hadapan untuk pengekodan, tugas berautonomi, dan kerja pengetahuan dengan tetingkap konteks 500K token dan usaha penaakulan boleh dikonfigurasi.
Xiaomi memposisikan MiMo-V2.6-Pro sebagai flagship multimodal 1M-konteks dengan berat model terbuka serta sokongan untuk pemahaman teks, imej, audio, dan video.
Ringkasnya: Grok 4.7 ialah produk agen terurus yang lebih bersepadu menegak; MiMo-V2.6-Pro memberi pembangun kawalan penggelaran yang lebih besar dan harga token mentah yang jauh lebih rendah. Padanan terbaik bergantung pada beban kerja, bukan satu skor penanda aras.
Perkara Utama
- Grok 4.7 dibina untuk pengekodan jangka panjang dan agen profesional. Dalam penilaian yang diterbitkan vendor oleh SpaceXAI, ia mencatat 46.3% pada CursorBench 4.0, 71.0% pada DeepSWE v1.1 pada usaha tinggi, dan 1,657 pada AA Briefcase v1.1.
- MiMo-V2.6-Pro luar biasa kompetitif untuk model terbuka. Xiaomi menerbitkan berat model dan melaporkan hasil hampir dengan sistem proprietari barisan hadapan pada beberapa penanda aras pengekodan dan agen, namun skor lintas-vendor tidak boleh ditukar ganti secara langsung.
- MiMo mempunyai kelebihan konteks dan multimodal. MiMo-V2.6-Pro menyokong tetingkap konteks 1M token serta pemahaman teks, imej, audio, dan video, berbanding konteks 500K Grok 4.7 dengan input teks dan imej.
- MiMo jauh lebih murah pada token API mentah. Harga piawai rasmi ialah $0.435/$0.87 per sejuta token input/output tidak dicache untuk MiMo-V2.6-Pro berbanding $2/$6 untuk Grok 4.7.
- Seni bina penggelaran ialah pertukaran yang menentukan. Grok menawarkan tindanan alat hos pihak pertama yang lebih kukuh; berat model terbuka MiMo membolehkan penggelaran peribadi, penyajian tersuai, dan kawalan infrastruktur yang lebih mendalam.
Grok 4.7 vs MiMo-V2.6-Pro Sekilas Pandang
| Dimensi | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Keluaran | 21 September 2026 | 22 September 2026 |
| Akses dan kawalan | API proprietari dan ekosistem agen terurus | Berat model terbuka, pilihan hos sendiri, dan akses API |
| Bukti prestasi | Kekuatan dilaporkan penyedia dalam pengekodan dan tugas agen jangka panjang; sahkan pada rangka tugas yang sama | Kekuatan dilaporkan penyedia merentas penaakulan, pengekodan, dan tugas multimodal; sahkan pada rangka tugas yang sama |
| Kekuatan tersendiri | Alat pihak pertama, aliran kerja terurus, dan agen tersambung web/X | Kawalan penggelaran, konteks 1M token, dan pemahaman teks/imej/audio/video |
| Tetingkap konteks | 500K token | 1M token |
| Modaliti input | Teks dan imej | Teks, imej, audio, dan video |
| Harga piawai rasmi input/output tidak dicache per 1M token | $2 / $6 | $0.435 / $0.87 |
| Penaakulan | Rendah hingga xTinggi | Penaakulan mendalam |
| Berat model terbuka | Tidak | Tidak |
| Padanan terbaik | Aliran kerja pengekodan dan agen terurus | Penggelaran peribadi, input multimodal, dan kos token mentah lebih rendah |
Apakah Grok 4.7?
SpaceXAI secara rasmi melancarkan Grok 4.7 pada 21 September 2026 sebagai model paling berkeupayaan untuk pengekodan dan kerja pengetahuan. Pelancaran ini penting kerana laporan pra-keluaran mencampur fakta yang disahkan dengan dakwaan seni bina yang bocor. Dokumentasi pelancaran akhir tidak menerbitkan jumlah atau kiraan parameter aktif, jadi anggaran parameter pra-keluaran tidak harus dianggap sebagai spesifikasi rasmi.
Menurut siaran pelancaran rasmi, Grok 4.7 menggunakan model asas baharu yang lebih besar berbanding Grok 4.6 dan dilatih dengan larian pembelajaran pengukuhan yang lebih panjang dan dibobotkan ke arah masalah yang mengambil masa berjam-jam untuk diselesaikan.
Model ini mengoptimumkan lapisan tindanan yang berbeza. Grok 4.7 menyediakan persekitaran terurus yang lebih kaya di sekeliling model; MiMo-V2.6-Pro mendedahkan lebih banyak lapisan model dan penggelaran kepada pembangun.
Untuk prompt melebihi 200K token, SpaceXAI mengenakan harga konteks lebih tinggi. Tahap yang diterbitkan ialah $4 per sejuta token input, $1 per sejuta token input dicache, dan $12 per sejuta token output.
Perubahan dalam Grok 4.7
Perubahan paling bermakna ialah objektif latihan, bukan semata-mata nombor penanda aras yang lebih tinggi. SpaceXAI menyatakan campuran pembelajaran pengukuhan beralih ke arah tugas lebih panjang berjam-jam, sementara model dilatih untuk mengesahkan kerjanya sendiri dengan lebih teliti dan memahami kerangka Grok Bot secara asli. Gabungan itu menyasarkan pelaksanaan agen sebenar: mengekalkan keadaan, menggunakan alat, menyemak kerja perantaraan, dan kekal koheren sepanjang trajektori tugas yang panjang.
Prestasi Grok 4.7
| Penanda aras diterbitkan SpaceXAI | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0%* | 65.2% | 72.7% | 70.0% |
| EEBench | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1 | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0 | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
SpaceXAI menanda Grok 4.7 DeepSWE sebagai usaha tinggi. Ini ialah penilaian yang diterbitkan vendor dan harus ditafsir mengikut rangka dan tetapan penaakulan yang didokumenkan.
SpaceXAI membentangkan carta pelancaran sebagai kandungan web asli di halaman pengumuman rasmi; jadual sumber di atas mengekalkan nilai penanda aras yang didedahkan tanpa menggantikan carta yang dilukis semula.
Apakah Xiaomi MiMo-V2.6?
Xiaomi secara rasmi melancarkan dan sumber terbuka MiMo-V2.6 pada 22 September 2026. Keluarga ini merangkumi MiMo-V2.6-Pro dan MiMo-V2.6-Flash, dengan pilihan penyajian Pro-UltraSpeed untuk beban kerja sensitif latensi. Untuk perbandingan langsung dengan Grok 4.7, MiMo-V2.6-Pro ialah pasangan flagship yang sesuai.
Bahan rasmi Xiaomi secara berasingan mendokumenkan berat model terbuka, input multimodal asli, dan harga API. Gabungan ini menjadikan MiMo-V2.6 relevan melangkaui papan pendahulu penanda aras.
MiMo-V2.6 vs MiMo-V2.5: Apa yang ditambah baik?
Tajuk utama seni bina bukan sekadar titik semak lebih besar. Keluaran awam Xiaomi memberi tumpuan besar kepada pascalatihan dan Live RL. Menurut nota keluaran rasmi, Pro dan Flash masing-masing melengkapkan 30 langkah pembelajaran pengukuhan dan bersama-sama menjana kira-kira 750,000 trajektori; kos peringkat RL yang didedahkan adalah kira-kira $2.62 juta untuk Pro dan $850,000 untuk Flash.
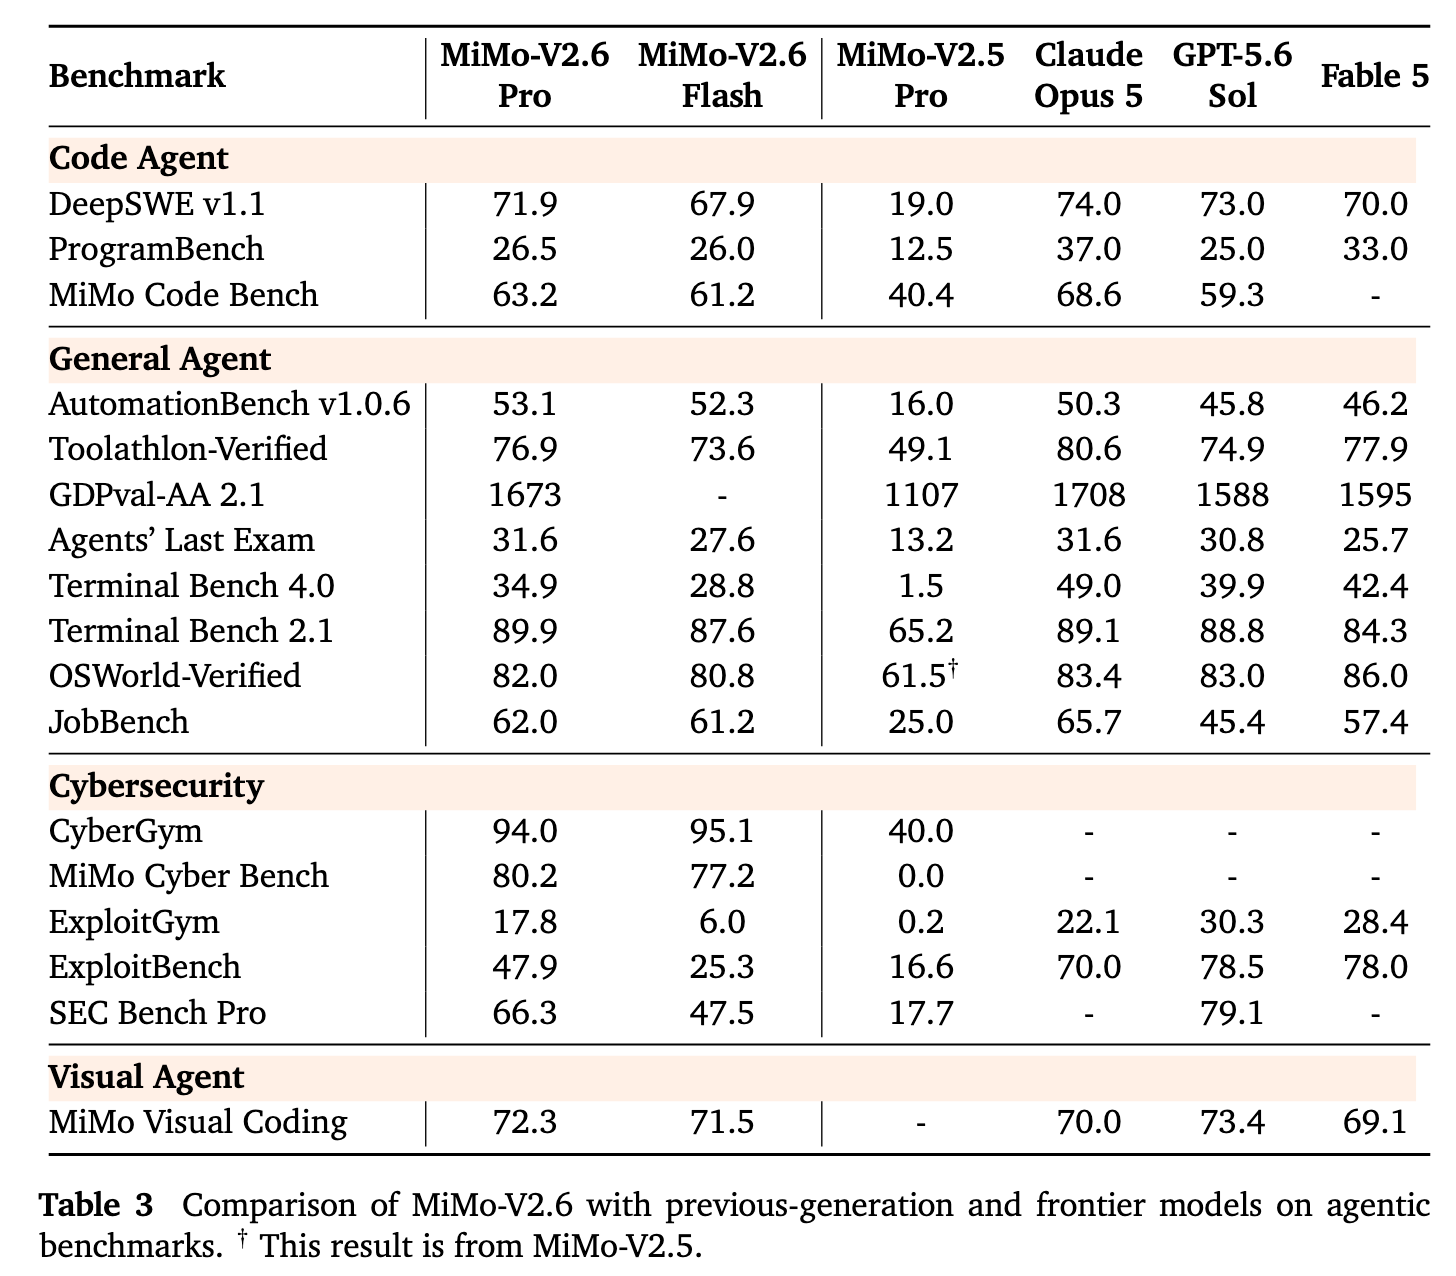
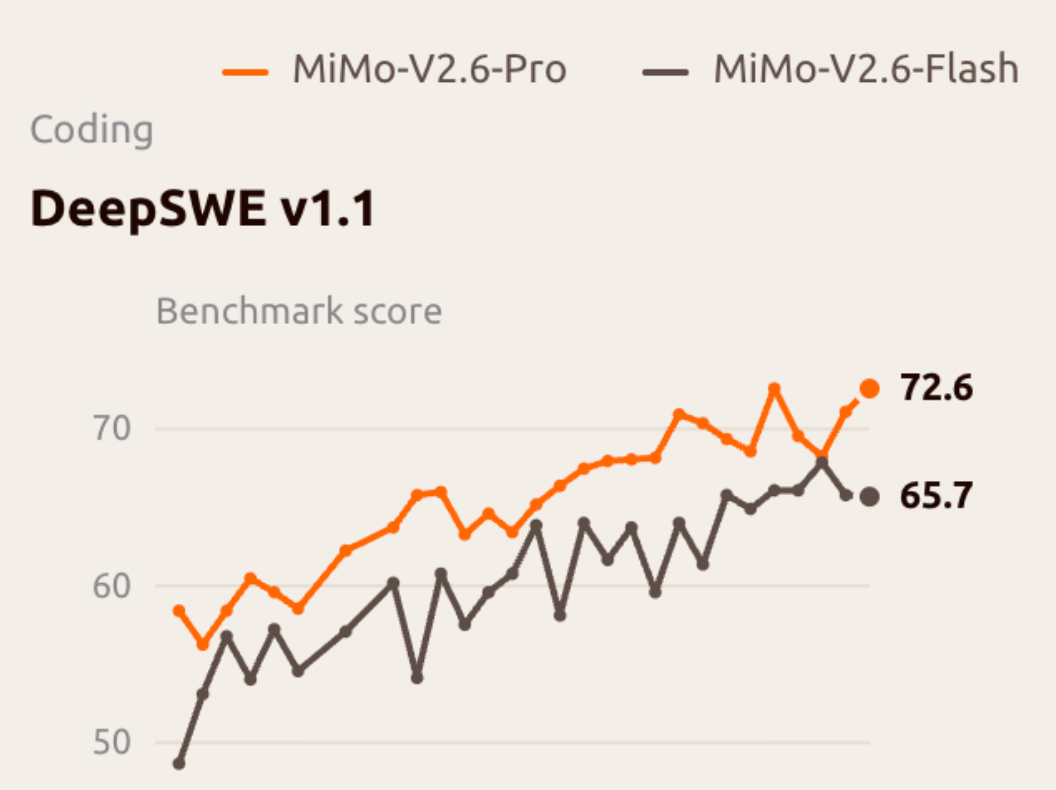
Satu butiran penanda aras memerlukan pengendalian teliti: lengkung Live RL Xiaomi menunjukkan MiMo-V2.6-Pro mencapai kira-kira 72.6 pada DeepSWE v1.1 semasa larian latihan, manakala jadual perbandingan akhir melaporkan 71.9. Nombor ini merujuk konteks penilaian dilaporkan yang berbeza dan tidak harus digabungkan secara senyap.
Grok 4.7 vs MiMo-V2.6-Pro: Perbandingan Penanda Aras
Perbandingan penanda aras langsung memerlukan berhati-hati. Vendor tidak semestinya menggunakan rangka, bajet penaakulan, titik semak, atau konfigurasi alat yang sama. Walaupun nama penanda aras sepadan, perbezaan skor kecil boleh kurang bermakna daripada kelihatannya. Perbandingan paling selamat ialah memisahkan ukuran yang benar-benar sejajar daripada bukti berarah.
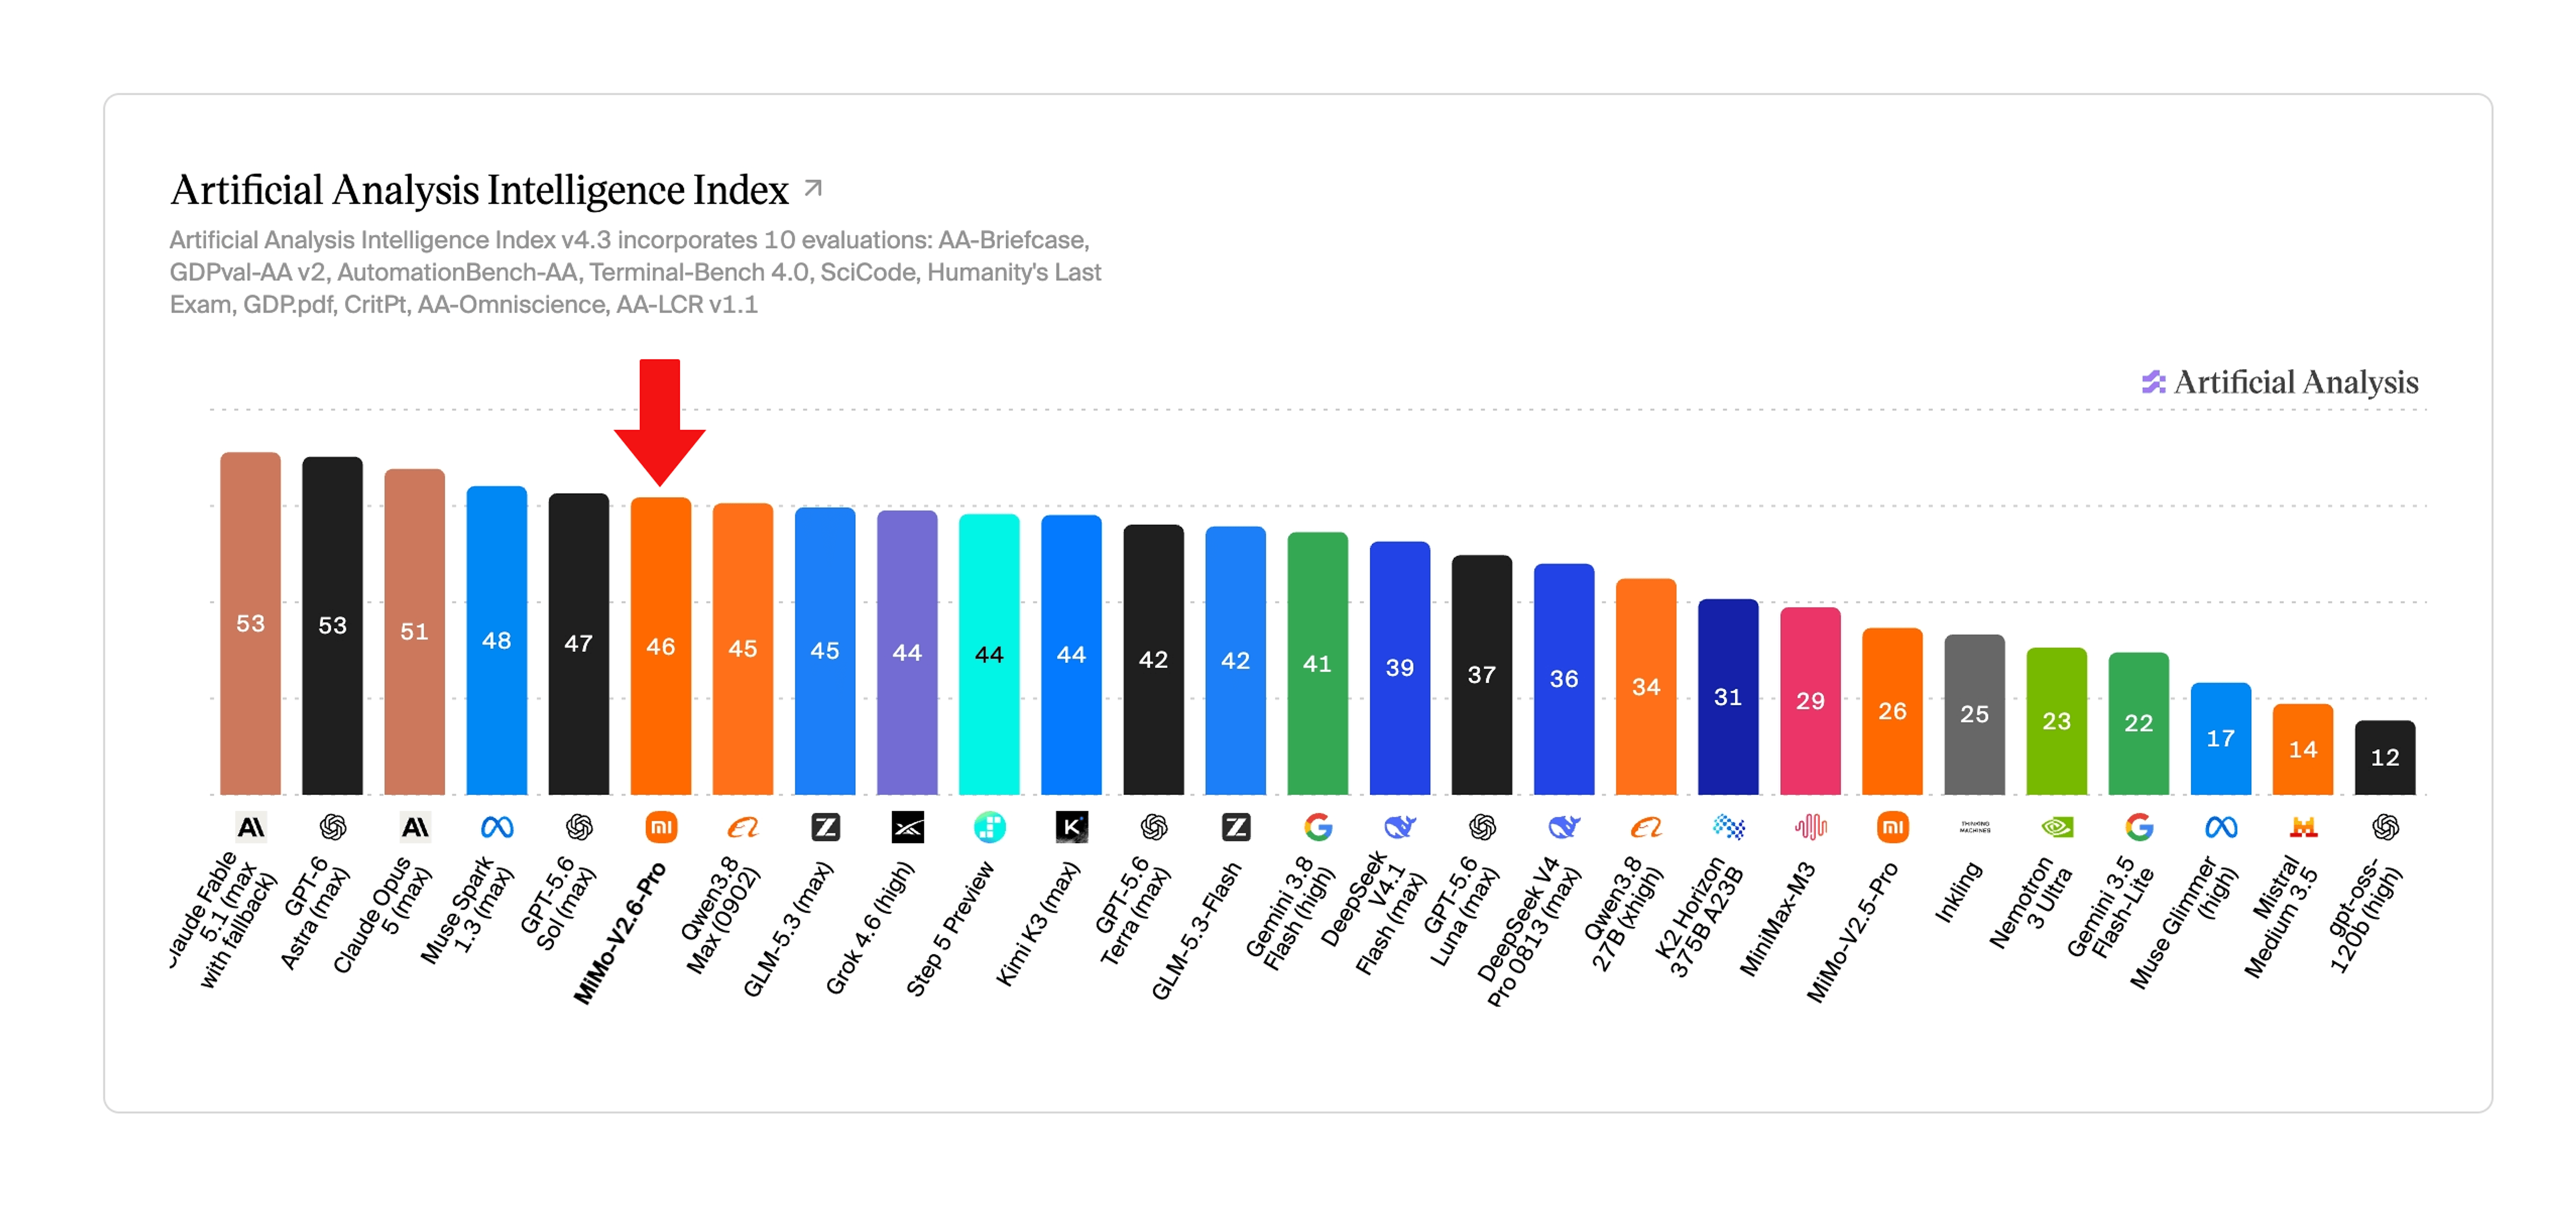
Artificial Analysis Intelligence Index
Xiaomi melaporkan 46.32 untuk MiMo-V2.6-Pro pada indeks komposit Artificial Analysis. Sebarang perbandingan Grok harus diikat pada snapshot Artificial Analysis dan konfigurasi model yang digunakan; dakwaan kesetaraan dibundarkan tidak harus dikemukakan tanpa sumber tersebut.
Prestasi Pengekodan dan Agen
| Penanda aras | Grok 4.7 — SpaceXAI | MiMo-V2.6-Pro — Xiaomi | Tafsiran |
|---|---|---|---|
| DeepSWE v1.1 | 71.0* | 71.9** | Hampir numerik; larian dan tetapan yang diterbitkan berbeza |
| GDPval-AA | Lihat carta SpaceXAI | 1,673 | Berarah sahaja melainkan rangka sejajar |
| AA Briefcase | 1,657 | Lihat carta Xiaomi | Guna nilai dilaporkan vendor dengan konteks sumber |
| Terminal-Bench 4.0 | 38.0 | 34.9 | Arah serupa; rangka penting |
| Tetingkap konteks | 500K | 1M | MiMo menyokong konteks kerja lebih besar |
SpaceXAI melaporkan Grok 4.7 DeepSWE pada usaha tinggi. ** Jadual perbandingan akhir Xiaomi melaporkan 71.9; lengkung latihan Live RL-nya mencapai kira-kira 72.6. Angka ini datang daripada konteks penilaian berbeza.
Padanan Aliran Kerja Pengekodan
Untuk pengekodan, perbezaan bergantung pada sama ada “pengekodan” bermaksud penyelesaian masalah repositori mentah atau pengalaman agen pengekodan terurus yang lengkap. Pada DeepSWE v1.1, nombor yang diterbitkan cukup rapat sehingga jurang kurang satu mata tidak sepatutnya menentukan pemilihan produksi dengan sendirinya.
Kelebihan Grok 4.7 lebih tinggi dalam tindanan. Ia disepadukan dengan Grok Build, tersedia dalam Cursor, direka untuk memahami kerangka Grok Bot, dan dipasangkan dengan alat pelaksanaan kod dan carian pihak pertama.
Kelebihan MiMo-V2.6-Pro lebih rendah dalam tindanan. Berat model terbuka menjadikannya praktikal untuk membina pembantu pengekodan peribadi, menyesuaikan penyajian, menguatkuasakan kawalan pemastautinan data, atau bereksperimen dengan kerangka agen proprietari.
Bagi pasukan yang memilih antara keduanya, ujian A/B produksi pada repositori representatif akan lebih bermakna daripada satu penanda aras pengekodan awam.
Grok 4.7 vs MiMo-V2.6-Pro: Perbezaan Keupayaan Multimodal
Ini salah satu perbezaan paling jelas. Grok 4.7 menerima input teks dan imej serta menghasilkan teks. Platform Grok yang lebih luas menawarkan produk media berasingan, tetapi itu tidak harus dikelirukan dengan liputan modaliti model grok-4.7 itu sendiri.
MiMo-V2.6-Pro menyokong pemahaman teks, imej, audio, dan video. Digabungkan dengan tetingkap konteks 1M token, ini mengembangkan julat aliran kerja yang boleh ditangani dalam satu konteks model.
- Analisis tangkapan skrin dan kod dalam tugas yang sama
- Pemahaman video dengan arahan pengiring
- Pemprosesan audio bentuk panjang
- Agen penggunaan komputer dengan maklum balas visual
- Pembantu penyelidikan multimodal
- Pengekstrakan dan QA multimodal berskala besar
Grok 4.7 vs MiMo-V2.6-Pro: Perbandingan Harga API
| Harga API rasmi | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Input / 1M token | $2.00 | $0.435 |
| Input dicache / 1M | $0.50 | $0.0036 |
| Output / 1M | $6.00 | $0.87 |
| Caj tambahan konteks panjang | Ya, melebihi 200K token prompt | Tiada tier piawai sebanding diterbitkan |
| Opsyen berat terbuka/hos sendiri | Tidak | Ya |
Pada harga pelekat, MiMo-V2.6-Pro beberapa kali lebih murah pada input biasa dan output terjana, dengan perbezaan yang amat ketara untuk konteks dicache. Itu boleh menjejaskan ekonomi agen yang berulang kali memproses repositori, dokumen panjang, atau konteks berterusan.
Nota harga penting: Tetingkap konteks 500K Grok 4.7 tidak bermaksud keseluruhan konteks dibilkan pada kadar piawai. Permintaan melebihi 200K token prompt dicaj pada tier konteks panjang.
Setakat 24 September 2026, CometAPI menyenaraikan Grok 4.7 pada $1.60 input dan $4.80 output per 1M token, berbanding rasmi $2.00 dan $6.00. Ia menyenaraikan MiMo-V2.6-Pro pada $0.348 input dan $0.696 output, berbanding rasmi $0.435 dan $0.87. Kadar piawai yang disenaraikan itu 20% di bawah kadar rasmi sepadan. Harga dan kelayakan boleh berubah; sahkan halaman model langsung sebelum pembajetan.
Harga token tidak sama dengan kos per tugas siap. Model penaakulan boleh menggunakan volum token berbeza, menggunakan bilangan panggilan alat berbeza, dan memerlukan kadar cuba semula berbeza. Penilaian produksi oleh itu harus menjejak kos tugas siap, latensi, dan kadar kejayaan bersama-sama.
Grok 4.7 vs MiMo-V2.6-Pro: Akses dan Ketersediaan
Perbezaan akses adalah jelas: Grok 4.7 tersedia melalui API dan aliran kerja Grok terurus, manakala berat modelnya tidak ditawarkan untuk hos sendiri. MiMo-V2.6-Pro tersedia melalui API dan sebagai berat model terbuka, memberi pasukan laluan hos sendiri tambahan.
Ketersediaan berasingan daripada pelesenan atau fleksibiliti penggelaran. Setakat 24 September 2026, kedua-dua model juga mempunyai halaman katalog CometAPI langsung. Pasukan harus mengesahkan titik akhir, wilayah, had kadar, dan kelayakan akaun sebelum pengeluaran; model yang tersenarai tidak menjamin ketersediaan atau tahap perkhidmatan yang sama untuk setiap akaun.
| Soalan ketersediaan | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| API rasmi | Tersedia melalui xAI | Tersedia melalui Xiaomi MiMo |
| Katalog CometAPI | Disenaraikan sebagai tersedia | Disenaraikan sebagai tersedia |
| Berat hos sendiri | Tidak tersedia | Opsyen berat model terbuka |
| Semakan operasi | Sahkan akses akaun, wilayah, had kadar, dan ketersediaan alat | Sahkan akses akaun, kesediaan titik akhir, dan keperluan hos sendiri |
Berat Terbuka dan Akses Proprietari
MiMo-V2.6-Pro yang mempunyai berat model terbuka mengubah perbandingan lebih daripada jurang satu mata penanda aras. Ia mewujudkan pilihan untuk penggelaran peribadi, penalaan enjin inferens, pascalatihan tersuai, kawalan pemastautinan data, dan integrasi infrastruktur yang lebih mendalam.
Grok 4.7 mengambil pertukaran sebaliknya: kurang kawalan ke atas dalaman model sebagai pertukaran untuk perkhidmatan terurus yang dikendalikan berterusan dan ekosistem pihak pertama yang terintegrasi ketat. Bagi banyak organisasi, tadbir urus dan keperluan infrastruktur akan menentukan senarai pendek sebelum prestasi penanda aras.
Cara Menggunakan API Grok 4.7 dan MiMo V2.6 dalam CometAPI
Pembangun boleh mengakses API Grok 4.7 dalam CometAPI melalui aliran kerja API bersatu, mengurangkan keperluan menyelenggara integrasi khusus penyedia yang berasingan.
Bagi pasukan yang menanda aras berbilang model barisan hadapan, lapisan API bersatu amat berguna kerana prompt produksi yang sama, rangka ujian, perakaunan token, dan kod aplikasi boleh dimainkan semula merentas model dengan lebih sedikit pemboleh ubah integrasi.
CometAPI kini menyenaraikan MiMo-V2.6-Pro sebagai tersedia, dengan ketersediaan API disahkan pada 22 September 2026. Semak katalog langsung dan akses akaun sebelum penggunaan produksi.
Dengan kedua-dua halaman model kini disenaraikan sebagai tersedia, ujian A/B peringkat aplikasi boleh mengekalkan prompt, alat, tetapan penaakulan, dan kriteria kejayaan se-konsisten yang mungkin, kemudian membandingkan penyiapan tugas, latensi, penggunaan token, dan mod kegagalan.
Grok 4.7 vs MiMo-V2.6-Pro: Padanan Model mengikut Kes Penggunaan
| Keperluan | Padanan model / panduan penilaian |
|---|---|
| Carian web dan X pihak pertama | Grok 4.7 |
| Agen jangka panjang terurus | Grok 4.7 |
| Aliran kerja Grok Build / Cursor | Grok 4.7 |
| Tetingkap konteks 1M | MiMo-V2.6-Pro |
| Pemahaman audio/video asli | MiMo-V2.6-Pro |
| Berat terbuka, hos sendiri, dan kawalan model | MiMo-V2.6-Pro |
| Kos token API mentah terendah | MiMo-V2.6-Pro |
| Pengekodan repositori | Tanda aras kedua-duanya pada repositori representatif |
| Agen pengetahuan profesional | Tanda aras kedua-duanya pada tugas produksi |
Keputusan oleh itu harus dirangka sekitar seni bina beban kerja. Grok 4.7 direka untuk menjadikan tindanan agen terurus lebih berkeupayaan; MiMo-V2.6-Pro direka untuk menjadikan kecerdasan tahap tinggi lebih murah, lebih multimodal, dan lebih mudah dikawal.
Yang mana patut anda pilih?
Pilih Grok 4.7 jika anda mahukan pengalaman agen terurus dengan carian web dan X pihak pertama, pelaksanaan kod asli, dan kurang infrastruktur untuk dioperasikan. Ia pilihan yang lebih praktikal untuk pasukan yang menghargai tindanan alat bersepadu dan aliran kerja profesional atau pengekodan jangka panjang.
Pilih MiMo-V2.6-Pro jika anda memerlukan berat model terbuka, penggelaran peribadi, tetingkap konteks 1M token, pemahaman audio dan video asli, atau harga API mentah yang jauh lebih rendah. Ia pilihan lebih kukuh apabila kawalan penggelaran, liputan multimodal, dan kecekapan kos ialah kekangan utama.
Jika pilihan masih tidak jelas, jalankan kedua-dua model pada tugas representatif yang sama dengan prompt, alat, bajet penaakulan, had masa, dan dasar cuba semula yang sama. Pilih model yang memberikan gabungan terbaik kadar penyiapan, latensi, jumlah kos per tugas berjaya, dan usaha semakan manusia.
Kesimpulan
Grok 4.7 vs MiMo V2.6 mendedahkan kerana kecerdasan mentah bukan lagi satu-satunya pembeza bermakna. Kedua-dua model menduduki jalur keupayaan tinggi yang serupa dalam penilaian awam semasa, namun strategi produk mereka berbeza dengan ketara.
Grok 4.7 menggabungkan tetingkap konteks 500K, penaakulan boleh dikonfigurasi, latihan agen jangka panjang yang kukuh, dan tindanan carian serta pelaksanaan pihak pertama yang matang. MiMo-V2.6-Pro menggabungkan tetingkap konteks 1M, input multimodal asli, berat model terbuka, dan harga API jauh di bawah banyak sistem proprietari barisan hadapan.
Bagi pembangun, soalan praktikalnya bukan lagi “skor penanda aras mana lebih tinggi?” tetapi “di mana kecerdasan patut berada?” Ekosistem agen terurus dan tindanan model terbuka yang boleh disesuaikan menyelesaikan masalah operasi yang berbeza. Pilihan tepat ialah yang paling sesuai dengan beban kerja produksi, kekangan infrastruktur, dan model kos.
Soalan Lazim
Adakah Grok 4.7 model 2.1 trilion parameter?
Angka kira-kira 2.1T tersebar sebelum keluaran, tetapi dokumentasi akhir SpaceXAI Grok 4.7 tidak menerbitkan jumlah atau kiraan parameter aktif. Pernyataan yang disahkan ialah Grok 4.7 menggunakan model asas lebih besar daripada Grok 4.6.
Adakah MiMo-V2.6 sumber terbuka?
Xiaomi melancarkan MiMo-V2.6 sebagai keluarga model terbuka dengan berat boleh dimuat turun dan sumber penyelidikan berkaitan. Dalam perancangan produksi, pasukan masih harus menyemak lesen model tepat dan terma pengagihan semula untuk penggunaan yang dimaksudkan.
Berapakah kos Grok 4.7 vs MiMo-V2.6-Pro per tugas agen siap?
Samakan set tugas, prompt, kebenaran alat, dasar cuba semula, dan kriteria kejayaan. Jejak jumlah input, input cache, token penaakulan dan output, panggilan alat, latensi, cuba semula, dan masa semakan manusia. Harga token mentah hanyalah satu komponen kos per tugas siap.
Seberapa boleh dipercayai perbandingan penanda aras Grok 4.7 vs MiMo-V2.6-Pro?
Gunakan repositori atau set tugas yang sama, kerangka agen, alat, bajet penaakulan, had masa, dasar cuba semula, dan rubrik pemarkahan. Laporkan selang keyakinan atau variasi larian berulang, dan kekalkan angka yang diterbitkan vendor berasingan daripada hasil dalaman.
Adakah Grok 4.7 mengenakan caj lebih untuk prompt konteks panjang?
SpaceXAI mendokumenkan kadar lebih tinggi apabila token prompt melebihi 200K. Oleh kerana tier lebih tinggi terpakai pada permintaan, pasukan yang menggunakan repositori besar atau konteks agen berterusan harus memodelkan ambang itu secara eksplisit.