
TL;DR
Kimi K3 ialah open-weight tetapi bukan berskala stesen kerja: melayan model natif memerlukan GPU kelas pusat data dan memori teragih. Gunakan vLLM untuk laluan produksi paling langsung, atau SGLang apabila topologi, paralelisme pakar, dan kawalan cache penting. Binaan GGUF komuniti merendahkan ambang perkakasan, tetapi masih memerlukan kira-kira 500 GB sehingga jauh melebihi 1 TB memori boleh dialamatkan dan menukar kelajuan atau kualiti demi kebolehlaksanaan. Untuk PC dan Mac biasa, uji melalui API dihoskan terlebih dahulu dan hoskan sendiri hanya apabila privasi, penggunaan berterusan, atau kawalan infrastruktur membenarkan kosnya.
What Is Kimi K3?
Kimi K3 ialah model multimodal natif open-weight terulung Moonshot AI untuk pengekodan jangka panjang, kerja pengetahuan beragent, penaakulan, dan kefahaman visual.
Moonshot menggambarkannya sebagai model 3T-class open pertama di dunia. Senibinanya menggabungkan Kimi Delta Attention dan Attention Residuals dengan reka bentuk MoE jarang yang memilih hanya subset pakar bagi setiap token.
Skalanya luar biasa walaupun mengikut piawaian model garisan hadapan. Daripada mengaktifkan semua 2.8T parameter bagi setiap token, K3 memilih 16 daripada 896 pakar berhaluan, serta pakar dikongsi. Ini mengurangkan pengiraan per token dengan ketara, walaupun semua pemberat model masih perlu tersedia di suatu tempat dalam sistem inferens.
| Specification | Kimi K3 — official model specifications |
|---|---|
| Architecture | Campuran Pakar |
| Total parameters | 2.8T |
| Activated parameters | 104B |
| Experts | 896 |
| Selected experts per token | 16 |
| Context length | 1,048,576 tokens |
| Vision encoder | MoonViT-V2 |
| Native quantization | berat MXFP4 / pengaktifan MXFP8 |
| Formal model-card modalities | Teks + imej |
K3 juga menggunakan latihan peka kuantisasi dari peringkat SFT, bukannya menganggap penyajian ketepatan rendah semata-mata sebagai langkah pemampatan pascalatihan.
Oleh itu, senibinanya dioptimumkan untuk penyajian berskala sangat besar—tetapi “pengiraan jarang” tidak boleh dikelirukan dengan “jejak memori kecil.” Hanya sebahagian rangkaian mengira setiap token, namun keseluruhan kumpulan pakar masih perlu boleh diakses.
How Does Kimi K3 Perform?
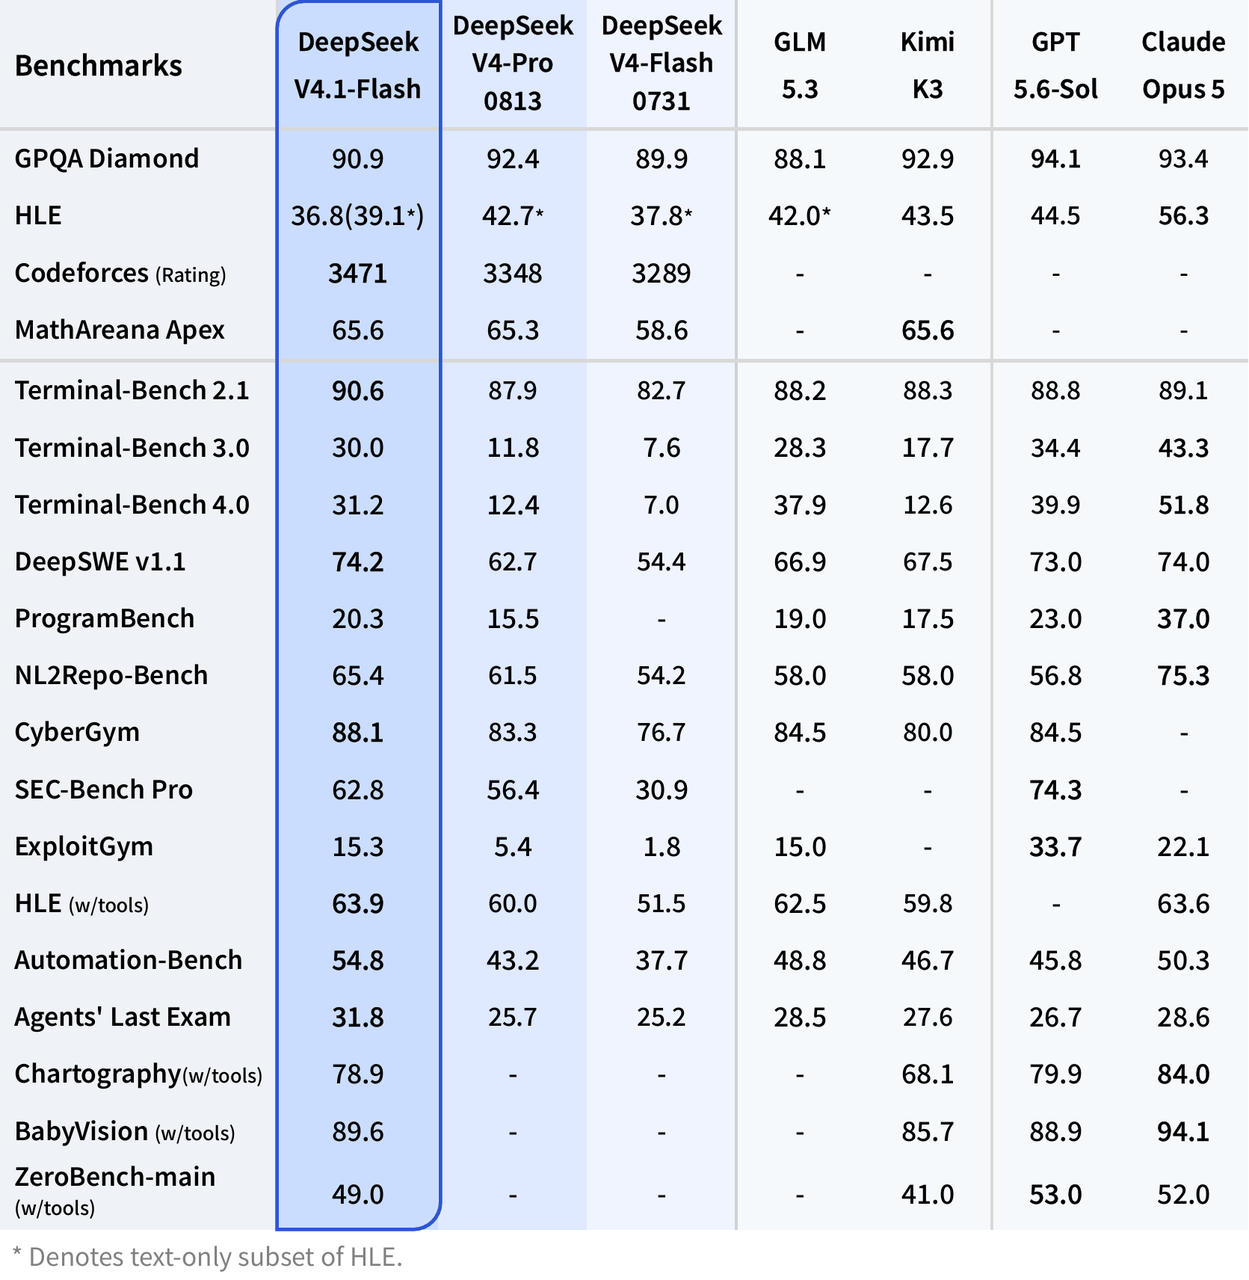
Sut penanda aras rasmi Kimi K3 daripada Moonshot meletakkan model ini hampir dengan model proprietari terulung, khususnya pada kejuruteraan perisian jangka panjang dan beban kerja beragent.
Pemilihan berikut merangkumi penaakulan, pengekodan, agen, dan visi. Lebih tinggi lebih baik untuk semua skor yang ditunjukkan.
| Benchmark — Moonshot official results | Kimi K3 | GPT-5.6 Sol | Claude Fable 5 | Claude Opus 4.8 |
|---|---|---|---|---|
| GPQA Diamond | 93.5 | 94.1 | 92.6 | 91.0 |
| ProgramBench | 77.8 | 77.6 | 76.8 | 71.9 |
| Terminal-Bench 2.1 | 88.3 | 88.8 | 88.0 | 84.6 |
| FrontierSWE | 81.2 | 71.3 | 86.6 | 66.7 |
| SWE-Marathon | 42.0 | 39.0 | 35.0 | 40.0 |
| BrowseComp | 91.2 | 90.4 | 88.0 | 84.3 |
| OmniDocBench | 91.1 | 85.8 | 89.8 | 87.9 |
| PerceptionBench | 58.5 | 59.7 | 57.2 | 47.2 |
Skor rasmi meletakkan Kimi K3 hampir dengan GPT-5.6 Sol, Claude Fable 5, dan Claude Opus 4.8 merentas tugas penaakulan, pengekodan, agen, dan visi. Anggap hasil yang dilaporkan penyedia ini sebagai konteks keupayaan, bukan kedudukan sejagat; analisis penanda aras terperinci dibincangkan berasingan. Untuk panduan ini, poin operasinya ialah self-hosting menawarkan keupayaan kelas terulung dan kawalan infrastruktur, tetapi bukan jalan pintas desktop berkos rendah.
Can You Actually Run Kimi K3 Locally?
Ya, tetapi terdapat dua definisi “setempat” yang sangat berbeza.
Pelayan setempat / pusat data peribadi: realistik.
Desktop atau komputer riba biasa: boleh dieksperimen secara teknikal dengan binaan komuniti yang sangat dikuantumkan, tetapi umumnya tidak praktikal untuk penggunaan interaktif.
Resipi vLLM Kimi K3 semasa menetapkan garis dasar yang sangat tinggi:
- NVIDIA: sekurang-kurangnya 8× GB300
- AMD ROCm: sekurang-kurangnya 8× MI355X atau MI350X
- Pemacu NVIDIA: R580+ untuk imej CUDA 13 K3 semasa
- Infrastruktur multi-nod disyorkan untuk trafik produksi sebenar
Panduan hari-0 vLLM asal juga menunjukkan laluan permulaan pantas 8-GPU B300 atau 8-GPU MI355X. Untuk penyebaran produksi baharu, ikut resipi lebih baharu kerana ia mencerminkan timbunan penyajian selepas pengoptimuman hari pelancaran.
Inilah poin utama: K3 ialah open-weight, tetapi ia bukan model open berskala pengguna.
Official Weights vs Community GGUF Quantizations
Terdapat cara lain untuk mengurangkan ambang perkakasan: kuantisasi komuniti.
Repositori Unsloth K3 semasa menyediakan beberapa varian GGUF yang boleh dijalankan melalui perisian serasi llama.cpp.
Perbandingan terkonsolidasi. Angka memori boleh dialamatkan ialah anggaran perancangan (saiz muat turun tambah kira-kira 10–15% ruang kepala masa jalan), bukan jaminan; tetapan konteks, cache, visi, dan offload boleh memerlukan lebih banyak.
| Variant | Download | Suggested addressable memory | Vision support | Documented runtime | Purpose / quality evidence |
|---|---|---|---|---|---|
| UD-Q1_0 | 466 GB | ≥520 GB | Repositori menyatakan sokongan visi; sahkan laluan runtime yang sepadan. | PR fork llama.cpp Unsloth; laluan Ollama didokumen, versi tidak dipinkan. | Bukti konsep; tiada ujian kualiti khusus varian bebas dikutip. |
| UD-TQ1_0 | 509 GB | ≥570 GB | Kaveat sokongan visi peringkat repositori yang sama. | Laluan runtime didokumen sama. | Eksperimen kelas 1-bit agresif; tiada ujian khusus varian bebas dikutip. |
| UD-IQ1_S | 594 GB | ≥665 GB | Kaveat sokongan visi peringkat repositori yang sama. | Laluan runtime didokumen sama. | Eksperimen setempat ekstrem; tiada ujian khusus varian bebas dikutip. |
| UD-IQ1_M | 649 GB | ≥730 GB | Kaveat sokongan visi peringkat repositori yang sama. | Laluan runtime didokumen sama. | Kompromi 1-bit berkualiti lebih tinggi; tiada ujian khusus varian bebas dikutip. |
| UD-IQ2_XXS | 711 GB | ≥800 GB | Kaveat sokongan visi peringkat repositori yang sama. | Laluan runtime didokumen sama. | Eksperimen kelas 2-bit; tiada ujian khusus varian bebas dikutip. |
| UD-Q2_K_XL | 861 GB | ≥970 GB | Kaveat sokongan visi peringkat repositori yang sama. | Laluan runtime didokumen sama. | Pelayan CPU/GPU besar; tiada penanda aras kuantisasi K3 bebas dikutip. |
| UD-Q4_K_XL | 1.51 TB | ≥1.7 TB | Kaveat sokongan visi peringkat repositori yang sama. | Contoh llama.cpp dan Ollama terus didokumen untuk varian ini. | Penyajian GGUF berfokus kualiti; tiada penanda aras kuantisasi K3 bebas dikutip. |
| UD-Q8_K_XL | 1.56 TB | ≥1.75 TB | Kaveat sokongan visi peringkat repositori yang sama. | Laluan runtime didokumen sama. | Binaan komuniti hampir tanpa kehilangan; sedikit kelebihan storan berbanding Q4. |
Perbezaan ini juga menerangkan mengapa sesetengah artikel penyebaran setempat awal memetik 594 GB: 594 GB kini merujuk kepada binaan komuniti UD-IQ1_S GGUF, bukan gambaran berguna tentang checkpoint natif semasa yang lengkap.
Model 466–649 GB jauh lebih kecil daripada jejak penyebaran asal, tetapi masih sangat besar mengikut piawaian stesen kerja. Anda juga harus meninggalkan memori untuk keadaan runtime, konteks, cache, projektor visi, proses sistem operasi, dan overhead lain.
Kapasiti cakera bukanlah sama dengan memori inferens. Mempunyai SSD 1 TB tidak bermakna model 600 GB akan berjalan pantas pada mesin dengan 64 GB RAM. Offloading SSD boleh menjadikan eksperimen ekstrem boleh dilakukan, tetapi penjanaan token boleh menjadi sangat perlahan.
How to Deploy Kimi K3 with vLLM
Untuk self-hosting yang serius, vLLM ialah titik mula paling mudah.
Moonshot kini menyenaraikan vLLM sebagai salah satu enjin inferens K3 yang disyorkan, dan vLLM menyediakan sokongan khusus model untuk KDA, MXFP4 MoE, penghuraian penaakulan, panggilan alat, cache awalan, dan penyebaran teragih.
Check the prerequisites
Untuk penyebaran produksi NVIDIA, resipi diuji semasa menggunakan kontena vllm/vllm-openai:kimi-k3.
Semak GPU:
nvidia-smi
Sahkan Docker:
docker --version
Sahkan NVIDIA Container Toolkit boleh melihat pemecut:
docker run --rm --gpus all nvidia/cuda:13.0.0-base-ubuntu24.04 nvidia-smi
Jika arahan terakhir tidak dapat melihat semua GPU, betulkan runtime GPU hos/kontena sebelum memuat turun model berbilang terabait.
Set your Hugging Face token
Jika pengesahan diperlukan untuk repositori model, simpan token dalam pemboleh ubah persekitaran dan jangan kod keras ke dalam skrip.
export HF_TOKEN="YOUR_HUGGING_FACE_TOKEN"
Pull the K3 vLLM container
docker pull vllm/vllm-openai:kimi-k3
Resipi semasa menentukan binaan CUDA 13 dan pemacu NVIDIA R580 atau lebih baharu.
Launch Kimi K3
Templat permulaan Blackwell TP8 semasa (resipi vLLM dikemas kini 2026-09-10): gunakan ini sebagai garis dasar, kemudian jana semula atau tanda aras profil untuk perkakasan dan trafik anda tepat.
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e HF_TOKEN="$HF_TOKEN" \
  -e VLLM_USE_V2_MODEL_RUNNER=1 \
  vllm/vllm-openai:kimi-k3 \
  --model moonshotai/Kimi-K3 \
  --tensor-parallel-size 8 \
  --gpu-memory-utilization 0.95 \
  --kv-cache-dtype fp8 \
  --attention-backend TOKENSPEED_MLA \
  --attention-config '{"use_prefill_query_quantization":true,"mla_prefill_backend":"TOKENSPEED_MLA"}' \
  --prefix-match-unit 128 \
  --enable-prefix-caching \
  --max-model-len 131072 \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3
Resipi semasa memerlukan imej K3 CUDA 13 dan pemacu NVIDIA R580 atau lebih baharu. Cache KV FP8 mesti digandingkan dengan backend MLA prefill/decode serasi; tandaaras alternatif sebelum menukar konfigurasi attention.
Sumber: resipi vLLM Kimi K3. Ini menggantikan arahan hari-0 terdahulu dan bukannya menyampaikannya sebagai resipi produksi semasa.
Untuk larian pengesahan pertama, pertimbangkan untuk mengehadkan panjang model maksimum dan bukannya serta-merta memperuntukkan sekitar keupayaan 1,048,576 token penuh. Resipi vLLM semasa secara jelas mengesyorkan melaraskan max-model-len mengikut beban kerja.
Contohnya:
--max-model-len 131072
Ini tidak mengubah had konteks seni bina K3. Ia hanya memberi enjin penyajian lingkungan operasi yang lebih mudah diurus untuk ujian awal anda.
Test the local endpoint
vLLM mendedahkan API serasi OpenAI pada port 8000.
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moonshotai/Kimi-K3",
    "messages": [
      {
        "role": "user",
        "content": "Terangkan perbezaan antara paralelisme tensor dan paralelisme pakar."
      }
    ],
    "max_tokens": 512
  }'
Atau gunakan OpenAI Python SDK:
python
from openai import OpenAI

 client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="EMPTY",
    timeout=3600,
 )

response = client.chat.completions.create(
    model="moonshotai/Kimi-K3",
    messages=[
        {
            "role": "user",
            "content": "Tulis fungsi Python yang mengesahkan skema JSON.",
        }
    ],
    max_tokens=1024,
 )

print(response.choices[0].message.content)
Resipi vLLM rasmi menggunakan corak serasi OpenAI localhost yang sama, menjadikannya agak mudah untuk menukar aplikasi antara inferens setempat dan dihoskan.
How to Deploy Kimi K3 with SGLang
SGLang ialah laluan penyebaran utama lain yang disyorkan oleh Moonshot.
Ia sangat relevan apabila anda mahukan kawalan lebih mendalam ke atas penyajian teragih, paralelisme pakar, kernel khusus perkakasan, atau topologi produksi yang kompleks.
Gunakan Cookbook Kimi K3 SGLang khusus dan pilih topologi khusus perkakasan. Berikut ialah profil Unified/Balanced 8×B300 satu nod yang disahkan daripada buku masakan; ia diukur dengan SGLang v0.5.18 pada commit 71de97b2.
Pasang binaan serasi K3:
pip install --upgrade pip
pip install uv
uv pip install --prerelease=allow sglang
Lancar profil B300 TP8/DCP8 yang disahkan:
sglang serve \
  --trust-remote-code \
  --model-path moonshotai/Kimi-K3 \
  --tp-size 8 \
  --dcp-size 8 \
  --mem-fraction-static 0.85 \
  --mamba-full-memory-ratio <value-from-official-calculator> \
  --reasoning-parser kimi_k3 \
  --tool-call-parser kimi_k3 \
  --host 0.0.0.0 \
  --port 30000
--mamba-full-memory-ratio bergantung pada beban kerja: kira daripada purata panjang input tambah output dalam cookbook rasmi. Jangan salin topologi B300 ini ke H100/H200, GB200/GB300, AMD, atau penyebaran multi-nod; profil-profil tersebut menggunakan susun atur TP/PP/DCP/EP yang berbeza.
Uji pelayan:
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moonshotai/Kimi-K3",
    "messages": [{"role": "user", "content": "Beri saya pelan nyahpepijat lima langkah untuk aplikasi Python teragih."}]
  }'
Untuk penyebaran sebenar, sahkan kapasiti, kualiti output, dan pemulihan kegagalan pada versi SGLang, topologi, panjang konteks, dan campuran trafik tepat yang anda ingin jalankan.
vLLM vs SGLang vs llama.cpp
Memilih enjin inferens bergantung terutamanya pada perkakasan anda dan tujuan penyebaran.
| Deployment method | Hardware class | Official native weights | OpenAI-compatible API | Distributed production | Ease of setup | Best fit |
|---|---|---|---|---|---|---|
| vLLM | Kluster GPU pusat data | Ya | Ya | Cemerlang | Sederhana | Pilihan produksi lalai |
| SGLang | Kluster GPU pusat data | Ya | Ya | Cemerlang | Sederhana–Tinggi | Penyajian teragih lanjutan |
| llama.cpp + GGUF | Stesen kerja/pelayan bermemori besar | Kuantisasi komuniti | Ya | Terhad berbanding vLLM/SGLang | Rendah–Sederhana | Eksperimen setempat |
| Ollama + GGUF | Stesen kerja/pelayan bermemori besar | Kuantisasi komuniti | Ya | Bukan sasaran utama | Mudah | Pengujian berorientasi kemudahan |
| CometAPI | Tiada GPU setempat diperlukan | Dihoskan | Ya | Diurus | Sangat mudah | Pembangun tanpa perkakasan kelas K3 |
Jika anda memiliki pelayan 8-GPU kelas Blackwell/MI35x, mulakan dengan vLLM.
Jika anda mereka bentuk kluster inferens teragih khusus dan mahukan lebih banyak kawalan penyajian aras rendah, nilaikan juga SGLang.assistant_message
Jika matlamat anda sekadar “Saya mahu membuktikan bahawa K3 boleh berfungsi pada perkakasan yang saya miliki,” GGUF bersama llama.cpp jauh lebih mudah didekati—dengan syarat mesin anda mempunyai jumlah memori yang benar-benar luar biasa.
How to Run a Quantized Kimi K3 with llama.cpp or Ollama
Repositori Kimi K3 GGUF komuniti kini menyediakan varian serasi llama.cpp.
Laluan ini menurunkan halangan kemasukan dengan ketara berbanding penyebaran berat natif pusat data, tetapi “dengan ketara” adalah relatif: malah binaan yang lebih kecil adalah ratusan gigabait.
Install llama.cpp on macOS or Linux
Kad model GGUF semasa menyediakan:
curl -LsSf https://llama.app/install.sh | sh
Pada Windows:
winget install llama.cpp
Start an OpenAI-compatible server
Repositori pada masa ini mendokumenkan UD-Q4_K_XL sebagai contoh:
llama serve \
  -hf unsloth/Kimi-K3-GGUF:UD-Q4_K_XL
Anda juga boleh jalankan CLI secara terus:
llama cli \
  -hf unsloth/Kimi-K3-GGUF:UD-Q4_K_XL
Perintah tersebut datang terus daripada kad model Kimi K3 GGUF semasa.
Walau bagaimanapun, UD-Q4_K_XL adalah sekitar 1.51 TB, jadi ia bukan varian yang akan dipilih oleh kebanyakan pengguna stesen kerja. Jika keutamaan anda ialah mengurangkan keperluan memori berbanding mengekalkan sebanyak mungkin kualiti, teliti dahulu varian 1-bit dan 2-bit yang lebih kecil.
Contohnya:
llama serve \
  -hf unsloth/Kimi-K3-GGUF:UD-IQ1_M
Direktori UD-IQ1_M semasa adalah kira-kira 649 GB.
Model 649 GB masih bukan model komputer riba biasa. Sebaiknya, keadaan model yang kerap diakses harus berada dalam memori pantas. Offloading SSD yang berat mungkin menjadikan eksperimen ekstrem secara teknikal boleh dilakukan tanpa menjadikannya berguna untuk kerja interaktif.
Run the Same GGUF Build with Ollama
Ollama ialah lapisan kemudahan untuk laluan penyebaran GGUF yang sama, bukan kaedah self-hosting bebas keempat.
Repositori K3 GGUF turut mendedahkan laluan Ollama.
Contohnya:
bash
ollama run hf.co/unsloth/Kimi-K3-GGUF:UD-Q4_K_XL
Ollama memudahkan pengurusan model dan pengalaman API, tetapi ia tidak mengubah keperluan memori K3 yang mendasari.
Menukar pelancar daripada llama.cpp kepada Ollama tidak boleh mengubah kuantisasi beratus gigabait menjadi model GPU 24 GB. Data model asas masih perlu disimpan dan diakses.
Atas sebab ini, Ollama sebaiknya dilihat sebagai pembungkus runtime yang mudah, bukan sebagai jalan pintas perkakasan.
Which Kimi K3 Quantization Should You Choose?
Untuk eksperimen, pilihan utamanya ialah pertukaran antara saiz model dan fideliti.
| GGUF quantization choices | Size | Relative memory pressure | Quality expectation | Recommended use |
|---|---|---|---|---|
| UD-Q1_0 | 466 GB | Terendah | Risiko degradasi paling agresif | Bukti konsep |
| UD-IQ1_S | 594 GB | Sangat tinggi | Agresif | Eksperimen setempat ekstrem |
| UD-IQ1_M | 649 GB | Sangat tinggi | Kompromi 1-bit lebih baik | Pelayan eksperimen bermemori besar |
| UD-Q2_K_XL | 861 GB | Ekstrem | Fideliti lebih baik | Pelayan CPU/GPU besar |
| UD-Q4_K_XL | 1.51 TB | Kelas pusat data | Fideliti lebih tinggi | Self-hosting berfokus kualiti |
| Native K3 serving | Kelas pusat data | Kelas pusat data | Kelakuan model yang dimaksudkan | Produksi |
Important Kimi K3 Serving Behavior
Terdapat satu butiran pelaksanaan khusus K3 yang mudah terlepas pandang.
K3 menggunakan sejarah pemikiran terpelihara. Moonshot menyatakan perbualan berbilang giliran dan aliran kerja panggilan alat harus menghantar semula keseluruhan mesej pembantu terdahulu, termasuk reasoning_content dan tool_calls, bukannya mengekalkan hanya kandungan yang dapat dilihat.
Corak aplikasi ringkas kelihatan seperti ini:
messages = [
    {
        "role": "user",
        "content": "Periksa projek ini dan cadangkan rancangan migrasi.",
    }
 ]

first = client.chat.completions.create(
    model="moonshotai/Kimi-K3",
    messages=messages,
    max_tokens=2048,
 )

assistant_message = first.choices[0].message

 # Kekalkan keseluruhan objek mesej, bukan hanya assistant_message.content.
 messages.append(
    assistant_message.model_dump(exclude_none=True)
 )

messages.append(
    {
        "role": "user",
        "content": "Sekarang kenal pasti bahagian paling berisiko dalam rancangan itu.",
    }
 )

second = client.chat.completions.create(
    model="moonshotai/Kimi-K3",
    messages=messages,
    max_tokens=2048,
 )
Ini menjadi sangat penting untuk agen pengekodan, gelung alat, dan sesi autonomi jangka panjang.
K3 juga mengekalkan penaakulan diaktifkan dan menyokong usaha penaakulan rendah, tinggi, dan maksimum. Apabila lapisan penyajian anda mendedahkan parameter tersebut, anggap usaha penaakulan sebagai satu lagi kawalan latensi/kualiti dan bukan sentiasa memaksimumkannya untuk setiap permintaan.
How to Optimize a Local Kimi K3 Deployment
Do not allocate the full 1M context immediately
K3 menyokong 1,048,576 token, tetapi keupayaan maksimum model dan konfigurasi pelayan yang munasabah adalah perkara berbeza.
Untuk pembangunan, mulakan pada sesuatu seperti:
--max-model-len 131072
Kemudian tingkatkan konteks hanya selepas mengukur memori tersedia, masa ke token pertama, throughput, dan kebersamaan yang dijangka.
Enable prefix caching
Agen pengekodan kerap menggunakan semula arahan repositori, skema alat, gesaan sistem, dan awalan panjang.
Dengan vLLM:
--enable-prefix-caching
Seni bina attention hibrid K3 memerlukan pengendalian khas untuk cache awalan, dan vLLM telah melaksanakan sokongan khusus model untuknya.
Use the K3 parsers
Untuk beban kerja agen, sertakan:
--tool-call-parser kimi_k3 \
--reasoning-parser kimi_k3
Ini memastikan panggilan alat dan output penaakulan sejajar dengan format penyajian K3.
Keep storage fast
Model pada skala ini meletakkan tekanan luar biasa pada storan setempat semasa muat turun pertama, pemuatan checkpoint, kemas kini, dan pemulihan.
Storan NVMe lebih digemari berbanding cakera rangkaian perlahan. Jika berbilang mesin berkongsi fail model, topologi cache model dan lebar jalur rangkaian menjadi sebahagian daripada seni bina inferens dan bukan sekadar butiran penyebaran.
Monitor more than GPU utilization
Jejaki:
- Penggunaan HBM/VRAM
- RAM CPU
- kadar hit cache
- masa ke token pertama
- token ternyahkod sesaat
- kedalaman baris gilir permintaan
- komunikasi antara GPU
- lebar jalur antara nod
- kegagalan penghuraian panggilan alat
- masa pemuatan model
Pada skala K3, angka penggunaan GPU yang kelihatan sihat tidak memberitahu anda sama ada topologi penyajian cekap.
Local Kimi K3 vs Hosted Kimi K3
Self-hosting memberikan pasukan kawalan maksimum ke atas laluan data, runtime, dan pemberat model, sambil turut menjadikan mereka bertanggungjawab untuk kapasiti GPU, penskalaan, naik taraf, pemantauan, dan pemulihan. Akses dihoskan mengalih keluar kebanyakan kerja infrastruktur dan lazimnya laluan lebih pantas untuk penilaian atau permintaan berubah-ubah.
Untuk analisis penuh perkakasan dan titik pulang modal, baca Kimi K3 Self-Hosting vs API. Untuk harga token, caching, dan perbandingan K2.7, gunakan panduan harga Kimi K3. Artikel ini oleh itu mengekalkan perbandingan secara ringkas dan menumpukan pada arahan penyebaran, konfigurasi, dan penyelesaian masalah.
Common Kimi K3 Local Deployment Problems
The model does not fit in GPU memory
Ini ialah kegagalan paling boleh dijangka.
Jangan kira memori daripada 104B parameter diaktifkan. Angka itu menerangkan pengiraan per token, bukan jumlah data pemberat pakar yang perlu disediakan oleh sistem penyajian.
Gunakan topologi teragih yang disokong, kuantisasi GGUF yang lebih kecil, atau perkhidmatan dihoskan.
CUDA or NVIDIA driver errors
Imej vLLM K3 semasa berdasarkan CUDA 13 dan memerlukan pemacu hos R580+.
Jika hos masih pada timbunan R575/CUDA 12.9, kemas kini atau ikut laluan bina-dari-sumber yang diterangkan oleh vLLM dan jangan anggap kontena akan membetulkan ketidakserasian pemacu hos.
The first request is extremely slow
Semak sama ada checkpoint masih dimuatkan, kernel dikompil, cache dipanaskan, atau fail sedang ditarik.
Dengan aset kelas berbilang terabait, “proses pelayan bermula” dan “model sedia untuk trafik produksi” bukan keadaan yang setara.
Tool calls fail intermittently
Resipi vLLM semasa menyatakan bahawa K3 kadangkala menghasilkan bentuk panggilan alat yang tidak dijangka oleh penghuraianya. Sistem produksi oleh itu harus mengesahkan skema panggilan alat dan melaksanakan cubaan semula dan bukannya mempercayai setiap panggilan yang dihasilkan secara membuta tuli.
Long conversations become less stable
Pastikan anda memulangkan keseluruhan mesej pembantu—termasuk maklumat penaakulan dan alat—kepada giliran K3 seterusnya.
Menggugurkan medan keadaan penaakulan tersembunyi boleh memecahkan corak sejarah pemikiran terpelihara yang dilatih oleh K3.
So, What Is the Best Way to Deploy Kimi K3 Locally?
Untuk kebanyakan organisasi dengan perkakasan sesuai, vLLM ialah laluan penyebaran pertama terbaik. Ia mempunyai sokongan khusus K3, API serasi OpenAI, penghuraian khusus model, cache awalan, sokongan decoding spekulatif, dan resipi perkakasan semasa.
Pilih SGLang apabila kejuruteraan inferens teragih dan kawalan penyajian terperinci lebih penting daripada laluan persediaan terpantas.
Pilih llama.cpp bersama kuantisasi GGUF komuniti hanya apabila objektif anda ialah eksperimen stesen kerja/pelayan dan anda faham bahawa walaupun versi 1-bit masih kekal beratus gigabait.
Untuk stesen kerja pembangun konvensional, kesimpulan paling praktikal berbeza: jangan beli beratus gigabait RAM semata-mata untuk memaksa K3 ke desktop. Uji Kimi K3 melalui CometAPI terlebih dahulu, kuantifikasikan manfaatnya pada tugas anda sendiri, dan beralih ke self-hosting hanya apabila privasi, penggunaan berterusan, atau kawalan infrastruktur menjadikan ekonomi berbaloi.
FAQ
Can Kimi K3 run on a single consumer GPU?
Tidak secara realistik. Model ini jauh melebihi kapasiti VRAM GPU pengguna. Kuantisasi GGUF bit rendah komuniti mengurangkan jejak dengan ketara, tetapi varian semasa terkecil masih beratus gigabait.
Can I run Kimi K3 on a Mac?
Pelaksanaan CPU/Apple-Silicon eksperimen dengan GGUF dan offloading storan boleh dilakukan pada prinsipnya, tetapi prestasi interaktif dan kapasiti memori ialah faktor pembatas. MacBook tipikal tidak seharusnya dianggap sebagai platform penyajian K3 yang praktikal.
Does Kimi K3 support Ollama?
Build GGUF komuniti boleh dilancarkan melalui Ollama. Runtime memudahkan persediaan tetapi tidak mengubah keperluan memori asas.
Is vLLM or SGLang better for Kimi K3?
vLLM ialah lalai yang lebih mudah untuk penyebaran produksi baharu. SGLang menarik untuk pasukan yang membina topologi penyajian teragih sofistikated. Kedua-duanya adalah antara enjin inferens K3 yang disyorkan Moonshot.
How much context does Kimi K3 support?
Spesifikasi model rasmi menyokong 1,048,576 token. Pelayan setempat tidak perlu mendedahkan keseluruhan tetingkap konteks; menetapkan max-model-len yang lebih rendah boleh jadi lebih praktikal untuk penyebaran awal dan kebersamaan lebih tinggi.
Is Kimi K3 open source?
Huraian yang lebih tepat ialah open-weight. Moonshot telah melepaskan pemberat model di bawah Kimi K3 License. Semak lesen itu secara langsung sebelum pengagihan komersial atau penggunaan lain di mana terma lesen penting.
What is the easiest way to use Kimi K3 without local GPUs?
API dihoskan ialah laluan termudah. Kimi K3 tersedia melalui CometAPI dengan antara muka chat-completions serasi OpenAI, jadi kod aplikasi boleh kekal hampir sama seperti yang anda gunakan terhadap pelayan vLLM atau SGLang setempat.