

TL;DR
MiMo-V2.5 ialah pilihan lalai yang lebih kuat untuk kerja multimodal, ejen rutin, dan produksi sensitif kos. MiMo-V2.5-Pro ialah pilihan pakar untuk penaakulan sukar, pengekodan skala repositori, dan penggunaan alat jangka panjang. Kedua-duanya menyediakan tetingkap konteks 1M token dan sehingga 128K token keluaran, tetapi Pro menggunakan rangka bahasa yang jauh lebih besar dan menelan kos kira-kira 3.1× ganda untuk token input dan output biasa.
MiMo-V2.5 vs. Pro: Quick Decision
| Spesifikasi — keluaran rasmi | MiMo-V2.5 | MiMo-V2.5-Pro | Model yang disyorkan | Sebab |
|---|---|---|---|---|
| Pemposisian utama | Model omni-modal dan ejen cekap | Ejen utama dan pengekodan kompleks | Pilih mengikut beban kerja | Input omni-modal memihak kepada V2.5; kerja teks sukar berterusan memihak kepada Pro. |
| Seni bina | Sparse MoE | Sparse MoE | Pilih mengikut beban kerja | Saiz model semata-mata tidak menentukan pilihan lebih baik untuk setiap tugas. |
| Jumlah parameter | 310B | 1.02T | Pilih mengikut beban kerja | Model yang lebih besar menyasarkan penaakulan sukar, tetapi saiz total bukan hasil tugas. |
| Parameter diaktifkan | 15B | 42B | Pilih mengikut beban kerja | Gunakan penyiapan tugas dan kos untuk membuat keputusan. |
| Lapisan LLM | 48 | 70 | Pilih mengikut beban kerja | Kiraan lapisan menerangkan seni bina, bukan kemenangan sejagat. |
| Pakar dirutekan | 256 | 384 | Pilih mengikut beban kerja | Perbezaan hanya penting jika ia memperbaiki beban kerja sasaran. |
| Pakar diaktifkan per token | 8 | 8 | Sama ada | Kedua-duanya mengaktifkan lapan pakar bagi setiap token. |
| Tetingkap konteks | 1M token | 1M token | Sama ada | Kedua-duanya mengiklankan tetingkap 1M token; uji pengambilan berkesan. |
| Keluaran maksimum | 128K token | 128K token | Sama ada | Kedua-duanya mengiklankan sehingga 128K token keluaran. |
| Modaliti input | Teks, imej, video dan audio | Teks | MiMo-V2.5 | Ia menerima input imej, video dan audio; Pro memfokus pada input teks. |
| Panggilan alat | Ya | Ya | Pilih mengikut beban kerja | Kedua-duanya memanggil alat; uji kadar kejayaan pada trajektori sebenar. |
| Berat terbuka dan lesen | Ya; MIT | Ya; MIT | Sama ada | Kedua-duanya menawarkan berat terbuka di bawah MIT; kos penyajian berbeza. |
Perbezaan Penentu: Multimodal vs Utamakan Ejen
V2.5 menerima teks, imej, video dan audio secara asli. Xiaomi memasangkan rangka bahasa dengan penyandi visi 729M parameter dan penyandi audio 261M parameter, membolehkan maklumat multimodal mengambil bahagian secara langsung dalam aliran kerja penaakulan yang sama.
- Analisis tangkapan skrin sebelum memanggil alat.
- Memahami video dan trek audionya secara serentak.
- Menarik maklumat daripada rajah dan imej dokumen.
- Mengendalikan ejen antara muka visual dan sokongan multimodal.
- Membuat penaakulan ke atas jujukan video yang panjang.
V2.5-Pro mengikuti reka bentuk berbeza. Xiaomi ketika ini menyatakan teks sebagai modaliti input dan menekankan penaakulan mendalam, pembangunan kod, serta orkestrasi alat jangka panjang.
Jika aliran kerja itu sendiri mengandungi input imej, video atau audio, mulakan dengan V2.5. Uji Pro apabila bahagian sukarnya ialah penaakulan ke atas teks, kod sumber, alat, atau trajektori ejen yang panjang.

Perbandingan penanda aras multimodal rasmi Xiaomi.
Mengapa V2.5-Pro Boleh Lebih Baik untuk Tugas Sukar
Skala Model: 310B/15B vs. 1.02T/42B
Kedua-dua model menggunakan rangka belakang Sparse Mixture-of-Experts, perhatian hibrid tetingkap gelongsor dan global, serta tiga modul Multi-Token Prediction. Kad model V2.5 Xiaomi mendokumentasikan rangka belakang jumlah 310B, 15B aktif; kad model Pro meningkatkan skala kepada 1.02T parameter jumlah dengan 42B diaktifkan per token.
| Seni bina — kad model rasmi | V2.5 | Pro | Perbezaan |
|---|---|---|---|
| Jumlah parameter | 310B | 1.02T | Kira-kira 3.3× |
| Parameter aktif | 15B | 42B | 2.8× |
| Saiz tersembunyi | 4,096 | 6,144 | 1.5× |
| Lapisan LLM | 48 | 70 | Tambahan 22 |
| Kepala perhatian | 64 | 128 | 2× |
| Pakar dirutekan | 256 | 384 | 1.5× |
| Pakar per token | 8 | 8 | Sama |
| Lapisan MTP | 3 | 3 | Sama |
V2.5 menggunakan pola perhatian 5:1, manakala Pro beralih kepada pola setempat-ke-global 6:1. Xiaomi menyatakan reka bentuk ini mengurangkan keperluan cache KV hampir 6× dan 7× masing-masing berbanding perhatian penuh sepanjang rangkaian.
Jumlah parameter tidak diterjemah secara linear kepada kualiti jawapan. Rangka belakang lebih besar Pro paling ketara apabila kesukaran penaakulan atau panjang trajektori menyebabkan peningkatan kebolehpercayaan kecil per langkah menjadi berlipat ganda.
Mengapa Peningkatan Kebolehpercayaan Kecil Berkumulatif
Tugas ejen yang panjang mempunyai banyak langkah saling bergantung. Ralat pada panggilan alat awal boleh memaksa percubaan semula atau membatalkan kerja seterusnya, jadi peningkatan sederhana dalam kebolehpercayaan setiap langkah boleh memberi kesan lebih besar pada penyiapan hujung ke hujung. Nilai kesan itu pada tugas yang mewakili, bukannya menganggap saiz model menjaminnya.
Di Mana V2.5-Pro Sebenarnya Meningkat?
Perbandingan berangka paling bersih ialah evaluasi model asas Xiaomi, di mana kedua-dua model muncul di bawah tetapan yang sama. Ini mengelakkan penggabungan hasil yang dihasilkan oleh rangka kerja tidak berkaitan atau konfigurasi pascalatih.
Pengetahuan Am: Peningkatan Kecil hingga Sederhana
Dalam perbandingan model asas Xiaomi, Pro memperoleh 1.2 mata pada BBH, 3.1 pada MMLU, dan 2.7 pada MMLU-Pro. Ini boleh diukur tetapi lebih kecil berbanding peningkatan pada tugas penaakulan lebih sukar.
Matematik dan Sains: Peningkatan Lebih Besar
Pro memperoleh 8.6 mata pada GPQA-Diamond, 16.3 pada GSM8K, dan 18.5 pada MATH dalam evaluasi model asas yang sama. Ini ialah bukti paling jelas untuk memilih Pro apabila penaakulan sukar memacu kejayaan tugas.
Pengekodan: Lebih Baik, tetapi Tidak Secara Seragam
Peningkatan yang dilaporkan ialah 4.3 mata pada HumanEval+, 3.2 pada MBPP+, 4.1 pada LiveCodeBench v6, dan 4.9 pada SWE-Bench AgentLess. Uji tugas peringkat repositori dan penggunaan alat secara berasingan: skor model asas ini tidak mengukur setiap aliran kerja ejen produksi.
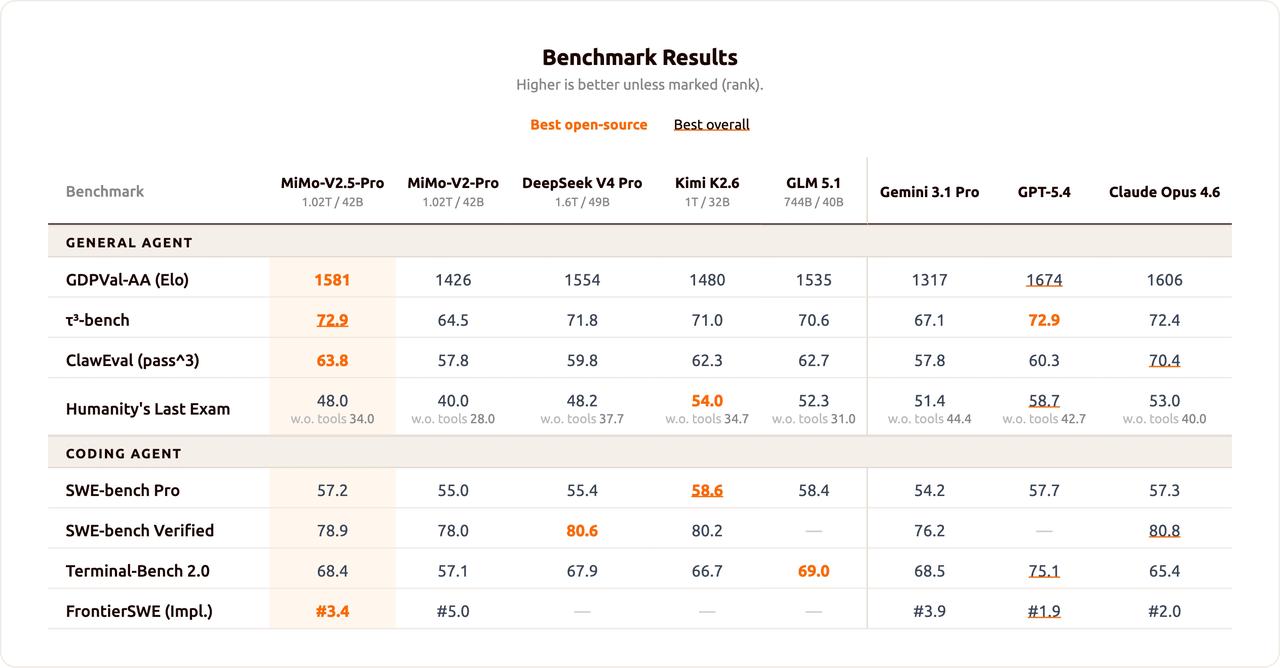
Keputusan penanda aras: Pro bukan tiga kali lebih baik kerana kosnya kira-kira tiga kali ganda. Nilainya meningkat secara progresif apabila kesukaran penaakulan dan tempoh tugas meningkat.
Baris ini ialah evaluasi model asas, bukan janji bahawa API produksi akan menghasilkan skor yang sama. Keputusan ejen bergantung pada alat, prom, percubaan semula, persekitaran pelaksanaan, dan bajet token.
Pascalatih dan Ejen Jangka Panjang
Model produksi menambah penalaan terselia, pembelajaran pengukuhan berorientasikan ejen, dan penyulingan on-policy berbilang guru (Multi-Teacher On-Policy Distillation). Xiaomi melaporkan skor pascalatih 56.1 pada SWE-bench Pro, 65.8 pada Terminal-Bench 2.0, dan 62.1 Pass³ pada bahagian umum Claw-Eval untuk V2.5.
Pro dioptimumkan dengan lebih jelas untuk kejuruteraan perisian jangka panjang. Xiaomi menerangkan ratusan panggilan alat dalam trajektori berterusan dan menerbitkan hasil 78.9% SWE-bench Verified.
Satu kajian kes rasmi menunjukkan Pro menyiapkan penyusun SysY dalam 4.3 jam dengan 672 panggilan alat dan semua 233 ujian lulus. Pengajarannya bukan setiap permintaan pengekodan memerlukan Pro; ia adalah bahawa perbezaan kebolehpercayaan kecil boleh menentukan sama ada aliran kerja dengan ratusan tindakan bergantung diselesaikan.

Rajah penanda aras pengekodan dan ejen rasmi Xiaomi.
Konteks Panjang: Kapasiti Sama, Beban Kerja Berbeza
Kedua-dua model menyediakan tetingkap konteks 1M token dan sehingga 128K token keluaran melalui API Xiaomi semasa. Saiz konteks mentah oleh itu tidak membezakan mereka.
V2.5 menarik apabila konteks panjang merangkumi bahan multimodal seperti video, imej dokumen, atau jejak ejen visual. Pro ialah model untuk diuji apabila konteks itu sendiri menjadi masalah penaakulan: repositori besar, kontrak panjang, korpus penyelidikan, atau trajektori ejen yang mengandungi banyak tindakan berjujukan.
Tetingkap konteks besar menggambarkan kapasiti, bukan kesetiaan penaakulan yang terjamin. Nilai pengambilan, pengekalan arahan, dan penggunaan bukti pada panjang yang penting bagi aplikasi.
Harga dan Kecekapan Kos
Harga bayar-semasa-guna luar negara Xiaomi menjadikan pertukaran jelas.
| Harga — helaian harga rasmi | V2.5 | Pro | Nisbah |
|---|---|---|---|
| Input tanpa cache bagi setiap 1M token | $0.14 | $0.435 | 3.11× |
| Input ber-cache bagi setiap 1M token | $0.0028 | $0.0036 | 1.29× |
| Output bagi setiap 1M token | $0.28 | $0.87 | 3.11× |
| Tetingkap konteks | 1M | 1M | Sama |
| Keluaran maksimum | 128K | 128K | Sama |
Satu permintaan dengan 1M token input tanpa cache dan 200K token output dianggarkan berharga $0.196 pada V2.5 dan $0.609 pada Pro sebelum hit cache, caj carian web, atau pengebilan khusus penyedia.
Perbezaan harga cache adalah lebih kecil: Pro lebih mahal kira-kira 29% untuk input hit cache berbanding 211% lebih mahal. Ejen jangka panjang dengan prom sistem, definisi alat, atau prefiks repositori yang stabil oleh itu harus mengukur kadar hit cache sebenar mereka.
Anggarkan kos bagi setiap tugas berjaya. Ejen Pro yang menyiapkan aliran kerja sukar sekali mungkin menelan kos kurang daripada percubaan gagal berulang pada model yang lebih murah.
Model Mana Patut Anda Gunakan?
| Beban kerja — panduan rasmi | Pilihan lebih baik | Sebab |
|---|---|---|
| Sembang teks rutin | V2.5 | Kos lebih rendah; Pro sering tidak perlu |
| Penjanaan volum tinggi | V2.5 | Harga token standard kira-kira 3.1× lebih rendah |
| Pemahaman imej, video atau audio | V2.5 | Input multimodal asli |
| Panggilan alat rutin | V2.5 | Keupayaan ejen kukuh pada kos lebih rendah |
| Matematik dan sains sukar | Pro | Peningkatan penanda aras lebih besar |
| Pengekodan skala repositori | Pro | Direka untuk kejuruteraan perisian kompleks |
| Ratusan panggilan alat bergantung | Pro | Lebih sesuai untuk pelaksanaan berterusan |
| Konteks 1M sensitif kos | V2.5 | Konteks nominal sama pada kos jauh lebih rendah |
Keputusan pemilihan: V2.5 ialah lalai untuk aplikasi multimodal, ejen rutin, dan beban kerja sensitif kos. Pro ialah naik taraf untuk penaakulan sukar, kejuruteraan perisian kompleks, dan trajektori autonomi panjang.
Strategi Produksi yang Lebih Baik: Halakan Antara Kedua-duanya
Pilihan model global tunggal selalunya tidak perlu. Halakan permintaan multimodal dan rutin ke V2.5, kemudian tingkatkan hanya penaakulan teks sukar, pengekodan kompleks, atau pelaksanaan jangka panjang kepada Pro.
| Dimensi penilaian | Ukuran | Mengapa ia penting | Isyarat penghalaan |
|---|---|---|---|
| Penyiapan | Tugas berjaya / percubaan | Menangkap kebolehpercayaan hujung ke hujung | Tingkatkan kelas penyiapan rendah |
| Kualiti | Skor manusia atau rubrik | Mengelak kos token daripada mendominasi | Tingkatkan tugas berisiko tinggi |
| Kebolehpercayaan alat | Ralat dan percubaan semula | Ralat kecil berkumulatif dalam ejen | Tingkatkan trajektori panjang |
| Kependaman | Masa ke hasil diterima | Termasuk beban percubaan semula | Kekalkan tugas interaktif ringan |
| Kos | Perbelanjaan per tugas diterima | Mencerminkan kegagalan dan ulang larian | Gunakan model termurah yang berjaya |
Uji Kedua-dua API dalam CometAPI
MiMo-V2.5 API dalam CometAPI dan MiMo-V2.5-Pro API dalam CometAPI menyokong evaluasi berdampingan melalui satu lapisan agregasi. Hantar prom yang sama, arahan sistem, alat, dan had output kepada kedua-dua model, kemudian bandingkan kejayaan tugas dan kos.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["mimo-v2.5", "mimo-v2.5-pro"]
prompt = """
Review this implementation plan.
Identify hidden technical risks and propose the three highest-priority fixes.
"""

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2000,
    )
    print(f"\n--- {model} ---")
    print(response.choices[0].message.content)
Jalankan kumpulan perwakilan yang mengandungi permintaan mudah, penaakulan sukar, suntingan kod, tugas konteks panjang, dan panggilan alat ejen. Rekod kadar penyiapan, token, kependaman, ralat alat, percubaan semula, kualiti jawapan, dan kos per tugas berjaya.
Keterbatasan
Had V2.5
Rangka belakang bahasa yang lebih kecil meninggalkan prestasi apabila kesukaran penaakulan meningkat. Jurang adalah sederhana pada BBH tetapi menjadi jauh lebih besar pada GPQA-Diamond dan MATH. Tetingkap konteks 1M token juga tidak boleh disamakan dengan kesetiaan penaakulan 1M token yang dijamin.
Had Pro
Harga input dan output biasa Pro kira-kira 3.1× daripada V2.5, dan input berasaskan teks sahaja menjadikannya tidak sesuai sebagai pengganti segera untuk aplikasi multimodal. Model berat terbuka 1.02T parameter juga merupakan projek hos kendiri yang menuntut walaupun 42B parameter diaktifkan per token.
Keputusan Akhir
Pilih V2.5 untuk aplikasi multimodal, ejen rutin, dan produksi sensitif kos. Pilih Pro untuk penaakulan sukar, kejuruteraan perisian kompleks, dan ejen autonomi jangka panjang. Untuk beban kerja campuran, halakan kebanyakan trafik ke V2.5 dan tingkatkan hanya permintaan yang kesukaran atau panjang trajektorinya membenarkan kos tambahan.
Soalan Lazim
Adakah Pro sentiasa lebih baik daripada V2.5?
Tidak. Pro lebih kuat pada penaakulan teks sukar dan pengekodan, tetapi V2.5 menyokong input imej, video, dan audio serta jauh lebih murah.
Adakah kedua-dua model menyokong tetingkap konteks 1M token?
Ya. Kedua-duanya mengiklankan 1M token konteks dan sehingga 128K token keluaran. Aplikasi masih perlu menguji pengambilan dan penaakulan pada panjang operasi sebenar.
Model manakah yang patut digunakan oleh ejen multimodal?
Mulakan dengan V2.5 kerana ia menerima input visual dan audio secara asli. Pro ketika ini mensasarkan aliran kerja input teks.
Bilakah Pro berbaloi dengan harganya yang lebih tinggi?
Ia paling munasabah apabila kebolehpercayaan penaakulan yang lebih baik mempengaruhi penyiapan matematik sukar, pengekodan skala repositori, atau trajektori panjang yang mengandungi banyak panggilan alat bergantung.
Adakah sistem produksi perlu menggunakan hanya satu model?
Tidak semestinya. Lapisan penghalaan boleh mengekalkan kerja rutin dan multimodal pada V2.5 sambil meningkatkan penaakulan teks sukar dan tugas ejen kepada Pro.