
TL;DR
Claude Haiku 5.5 ialah model kecil terpantas Anthropic pada kelajuan standard untuk tugas volum tinggi yang sensitif terhadap latensi. Ia menggabungkan tetingkap konteks 1 juta token, had output standard 128K, penaakulan adaptif, dan harga asas bermula pada $0.10 per juta token input dan $0.50 per juta token output. Kadar meningkat apabila prompt melebihi 100,000 token. Untuk pengekodan kompleks dan kerja agen yang panjang, Sonnet 5.5 dan Opus 5.5 kekal sebagai pilihan yang lebih kuat. Harga Standard CometAPI adalah 20% di bawah kadar rasmi, bermula pada $0.08 per juta token input dan $0.40 per juta token output. Halaman model CometAPI sudah aktif dan melaporkan akses API produksi.
Key Takeaways
- Keluaran rasmi: 7 Oktober 2026; ID model Claude API: claude-haiku-5-5.
- Kadar API permulaan: $0.10 input dan $0.50 output per juta token untuk prompt sehingga 100K token. CometAPI: $0.08 input dan $0.40 output per juta token pada 80% daripada harga Standard rasmi.
- Konteks dan output: 1M token konteks dan 128K token output standard.
- Fokus: pengelasan, pengekstrakan dokumen, perutean, sokongan, dan tugas agen yang didelegasikan.
- Tokenizer baharu boleh mengira kira-kira 30% lebih banyak token untuk teks yang sama; nilai kos per tugas yang diterima, bukan sekadar harga per token.
What Is Claude Haiku 5.5?
Claude Haiku 5.5 ialah ahli ringan dalam keluarga Claude semasa Anthropic, dibangunkan untuk volum permintaan besar di mana daya tindak dan ekonomi operasi adalah teras. Aplikasi utamanya termasuk pemprosesan dokumen, sokongan perbualan, pengekstrakan maklumat, dan tugasan subagen yang padat. Gambaran model Anthropic mengesahkan tarikh pelancaran, keupayaan, dan pengecam platform.
Claude Haiku 5.5 ialah model Haiku pertama yang menyokong tahap usaha boleh dikonfigurasi, membolehkan pembangun membuat pertukaran antara kedalaman penaakulan, latensi, dan penggunaan token dalam model yang sama.
What Are the Key Features of Claude Haiku 5.5?
Adaptive thinking and adjustable effort
Haiku 5.5 boleh memutuskan bila dan berapa banyak untuk berfikir, manakala parameter effort menawarkan cara kepada pembangun untuk mengimbangi kualiti respons, latensi, dan penggunaan token. Effort lalai ialah medium. Untuk pengelasan ringkas, effort rendah mungkin lebih sesuai; untuk pengekstrakan yang samar atau langkah perancangan alat, tetapan lebih tinggi mungkin wajar.
Large-context processing
Tetingkap konteks 1M token membolehkan dokumen panjang dan sejarah perbualan yang besar dimuatkan dalam satu permintaan. Pembangun masih perlu menggunakan pengambilan, pemangkasan, dan caching apabila sesuai: konteks panjang boleh memperkenalkan kos yang tidak perlu dan pertukaran ketepatan, terutamanya melepasi ambang harga 100K.
Low-cost high-throughput processing
Kadar permulaan baharu $0.10/$0.50 menjadikan permintaan pendek berulang lebih murah dengan ketara berbanding generasi Haiku sebelumnya pada dasar per token. Namun Anthropic mendokumenkan tokenizer yang berubah: teks yang sama menghasilkan kira-kira 30% lebih banyak token berbanding pada Haiku 4.5. Oleh itu, penjimatan sebenar di peringkat tugas mungkin lebih kecil daripada pengurangan kadar utama.
Computer use and delegated agent tasks
Penilaian yang diterbitkan menunjukkan prestasi yang lebih kukuh pada tugas interaksi komputer dan tugas berasaskan alat berbanding model Haiku sebelumnya. Ini menjadikan Haiku 5.5 berguna untuk langkah agen yang terhad, tetapi automasi yang berjaya masih bergantung pada kebenaran alat yang kukuh, pemulihan ralat, dan kelulusan manusia untuk tindakan berisiko.
How Does Claude Haiku 5.5 Perform on Benchmarks?
Anthropic melaporkan peningkatan ketara merentasi tugas pengetahuan profesional, penggunaan komputer, pengekodan, dan penaakulan. Keputusan di bawah menggunakan tetapan penilaian yang dilaporkan; skor daripada penanda aras berbeza tidak sepatutnya digabungkan menjadi satu “skor kecerdasan.”
| Penanda aras | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 735 | 1,620 | 1,840 |
| AA-Briefcase v1.1 (Elo) | 614 | 1,578 | 1,824 |
| OSWorld 2.1, subset luar talian, kredit separa | 15.7% | 72.4% | 83.9% |
| Humanity's Last Exam, tanpa alat | 10.2% | 45.9% | 56.9% |
| Humanity's Last Exam, dengan alat | 18.7% | 57.4% | 64.5% |
| Terminal-Bench 4.0 | 0.0% | 39.2% | 70.6% |
| Chartography, tanpa alat | 6.4% | 46.4% | 61.6% |
Konfigurasi penilaian standard kad sistem Haiku 5.5 menggunakan pemikiran adaptif pada effort maksimum, pensampelan lalai dan lima percubaan kecuali dinyatakan sebaliknya; lalai produk ialah medium, jadi skor utama bukan jaminan tetapan lalai. OSWorld menggunakan 82 tugas luar talian, tiada akses internet, 1080p dan had 500 tindakan. Skor 72.4% ialah kredit separa; kadar lulus ketat ialah 37.1%. GDPval-AA dan AA-Briefcase dilaporkan oleh Anthropic daripada penilaian Artificial Analysis yang dijalankan secara bebas.
Terminal-Bench 4.0 menggunakan Claude Code dalam mod --bare dengan perlindungan diaktifkan. Haiku 5.5 menggunakan effort maksimum, tiada model gantian dan tiada egress internet, dengan 10 percubaan per tugas; Sonnet 5.5 menggunakan lima percubaan dan model gantian untuk beberapa permintaan yang ditanda. Haiku 4.5 menggunakan bajet pemikiran tetap 63,999 token. Perbezaan konfigurasi ini penting apabila mentafsir 39.2% berbanding 70.6%.
Keputusan penanda aras yang diterbitkan oleh Anthropic membekalkan skor di atas. OSWorld menggunakan subset luar talian; Humanity's Last Exam memisahkan larian dengan alat dan tanpa alat, dan Chartography adalah tanpa alat. Ini ialah keputusan vendor yang dilaporkan, bukan ukuran bebas di bawah konfigurasi sejagat. Anthropic menyediakan butiran penilaian dalam kad sistem Haiku 5.5; gandakan semula tetapan effort, alat, scaffold dan bajet yang relevan sebelum membandingkan keputusan anda sendiri. Ringkasan pelancaran tidak menetapkan persekitaran ujian biasa lengkap untuk setiap baris.
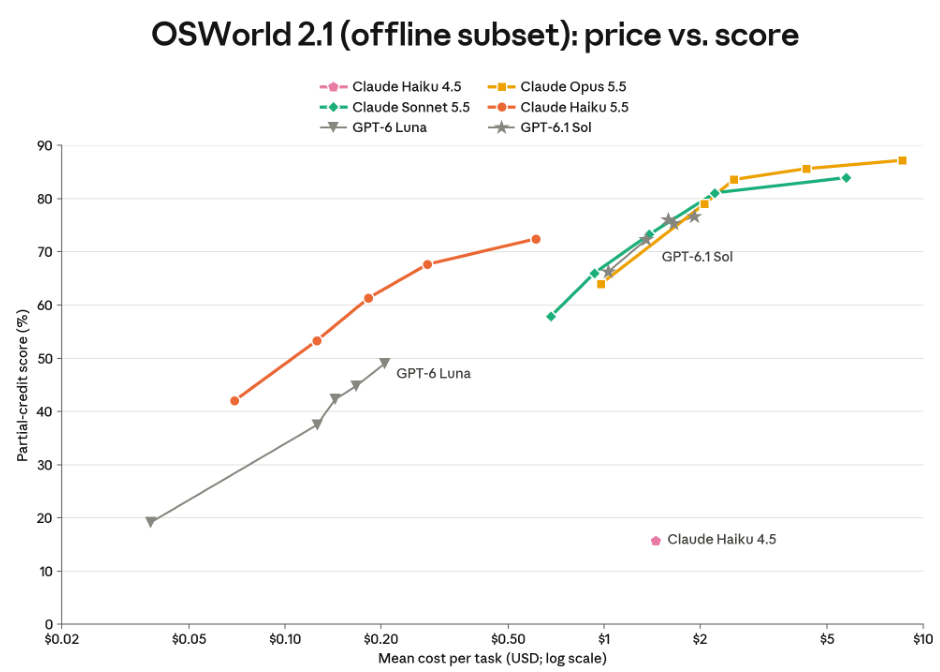
Grafik penilaian rasmi Anthropic di atas diambil daripada kad sistemnya. Ia memberikan bukti tambahan tentang konfigurasi yang dinilai; ia bukan penanda aras baharu yang dihasilkan untuk artikel ini.
Benchmark Interpretation
Peningkatan OSWorld mencadangkan Haiku 5.5 menjadi jauh lebih berguna untuk tugas grafik berstruktur. Walau bagaimanapun, 70.6% Sonnet 5.5 berbanding 39.2% Haiku 5.5 dalam Terminal-Bench menunjukkan kelebihan berterusan untuk pengekodan agen pada model yang lebih besar. Pilih model mengikut kos kegagalan dan kesukaran aliran kerja sebenar.
Claude Haiku 5.5 vs Haiku 4.5 vs Sonnet 5.5
| Dimensi | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| Konteks | 200K | 1M | 1M |
| Output standard maksimum | 64K | 128K | 128K |
| Input standard / MTok | $1 | $0.10 sehingga 100K; $0.50 lebih | $2 |
| Output standard / MTok | $5 | $0.50 sehingga 100K; $2.50 lebih | $10 |
| Penaakulan | Pemikiran lanjutan dengan bajet token tetap | Adaptif; lalai medium | Adaptif; lalai tinggi |
| Kelewatan relatif | Pantas | Paling pantas pada kelajuan standard | Pantas |
| Kedalaman pengekodan | Tugas terhad | Subagen yang lebih kuat | Pengekodan yang lebih kompleks |
| Penggunaan tipikal | Penerapan model kecil legasi | Aliran kerja volum tinggi | Aliran kerja produksi kompleks |
Spesifikasi dikongsi: ketiga-tiga model menerima input teks dan imej serta menghasilkan output teks. Ia boleh diakses melalui Claude API dan platform rakan kongsi yang disokong; pengecam model dan akses akaun bergantung pada penyedia. Dokumentasi produk yang dipetik tidak menetapkan bilangan parameter atau seni bina terperinci.
Haiku 5.5 ialah pilihan pertama yang munasabah untuk tugas yang boleh disahkan dan berulang. Sonnet 5.5 menjadi lebih menarik apabila pertimbangan yang lebih kuat menjimatkan panggilan gagal berulang, percubaan alat, atau pembetulan manusia. Opus 5.5 ialah pilihan untuk tugasan berbilang langkah yang sangat mencabar.
Label latensi perbandingan merujuk kepada mod kelajuan standard. Kelayakan kelajuan Anthropic mengecualikan Opus Fast Mode daripada tuntutan model terpantas. Butiran seni bina seperti bilangan parameter tidak ditetapkan oleh peringkat produk ini. Input teks dan imej dengan output teks adalah berbeza daripada penjanaan imej.
Perbandingan keupayaan mengikuti spesifikasi model Anthropic. Akses platform bergantung pada penyedia dan akaun yang dipilih; tiada peringkat model yang menyiratkan bilangan parameter yang diterbitkan.
Workload Selection
| Beban kerja | Lalai praktikal | Sebab |
|---|---|---|
| Pengelasan e-mel | Haiku 5.5 | Keputusan ringkas, berulang, boleh disahkan |
| Pengekstrakan medan dokumen | Haiku 5.5 | Pemprosesan berstruktur kos efektif |
| Triage sokongan | Haiku 5.5 | Respons pantas dan eskalasi |
| Subagen pengekodan | Haiku 5.5 | Carian fail kos rendah dan suntingan terkawal |
| Nyahpepijat kompleks | Sonnet 5.5 | Prestasi penanda aras pengekodan lebih kukuh |
| Penaakulan berbilang langkah berisiko tinggi | Opus 5.5 | Model peringkat atas yang lebih berupaya |
| Beban kerja campuran | Haiku + Sonnet | Rute mengikut kerumitan dan keyakinan |
How Much Does Claude Haiku 5.5 Cost?
Mengapa Haiku 5.5 diiklankan sebagai “sekitar 75% lebih murah” jika harga tokennya 90% lebih rendah?
Angka 90% menerangkan pengurangan dalam kadar Standard input dan output untuk prompt sehingga 100,000 token; prompt yang lebih panjang menerima pengurangan 50%. Anthropic melaporkan bahawa Haiku 5.5 menelan kos sekitar 75% lebih rendah secara purata, mengambil kira campuran panjang permintaan model terdahulu dan perubahan penggunaan token per tugas. Tokenization ialah satu faktor: input teks yang sama boleh dikira sebagai kira-kira 30% lebih banyak token, jadi anggaran kos harus menggunakan kiraan yang diukur dengan model baharu.
Harga rasmi Anthropic mempunyai dua jalur panjang prompt. Kadar dalam jadual pertama adalah harga rasmi USD per juta token; perbandingan CometAPI di bawah menggunakan diskaun 20% terhadap kadar Standard input dan output rasmi.
| Kategori kadar | Prompt sehingga 100K | Prompt melebihi 100K |
|---|---|---|
| Input | $0.10 | $0.50 |
| Output | $0.50 | $2.50 |
| Tulis cache 5 minit | $0.125 | $0.625 |
| Tulis cache 1 jam | $0.20 | $1.00 |
| Baca cache | $0.01 | $0.05 |
| Input kelompok (diskaun 50%) | $0.05 | $0.25 |
| Output kelompok (diskaun 50%) | $0.25 | $1.25 |
Kadar Standard rasmi, cache dan Batch ditunjukkan di atas, diperiksa pada 8 Oktober 2026. Panjang prompt memilih jalur harga; jalur lebih tinggi digunakan pada permintaan tersebut dan bukannya hanya token yang melebihi 100K. Kadar Standard CometAPI di bawah menyamai kadar Standard rasmi yang sepadan didarabkan dengan 0.8. Perbandingan ini tidak menganggap bahawa diskaun gerbang ditindan dengan diskaun Batch atau caching.
| Panjang prompt | Kategori token | Standard rasmi / MTok | CometAPI / MTok |
|---|---|---|---|
| Sehingga 100K token | Input | $0.10 | $0.08 |
| Sehingga 100K token | Output | $0.50 | $0.40 |
| Melebihi 100K token | Input | $0.50 | $0.40 |
| Melebihi 100K token | Output | $2.50 | $2.00 |
Example: 100,000 short requests per month
Andaikan setiap permintaan menggunakan 2,000 token input dan 500 token output; setiap permintaan kekal di bawah ambang 100K. Abaikan caching prompt, alat, dan percubaan semula, dan anggap kiraan token yang sama merentasi model untuk ilustrasi.
| Model / penyedia | Input/bulan | Output/bulan | Jumlah/bulan |
|---|---|---|---|
| Haiku 4.5 — Standard rasmi | $200 | $250 | $450 |
| Haiku 5.5 — Standard rasmi | $20 | $25 | $45 |
| Sonnet 5.5 — Standard rasmi | $400 | $500 | $900 |
| Haiku 5.5 — CometAPI | $16 | $20 | $36 |
Dalam contoh ini, 100,000 permintaan menggunakan 200 juta token input dan 50 juta token output. Kos input CometAPI ialah 200 × $0.08 = $16 dan kos output ialah 50 × $0.40 = $20, untuk $36 sebulan berbanding $45 rasmi: penjimatan $9, atau 20%. Senario ini mengecualikan caching, alat dan percubaan semula serta menggunakan kiraan token tetap; ukur kos per tugas yang diterima pada input representatif kerana tokenizer baharu mengubah kiraan token.
Perbandingan $450-ke-$45 ialah ilustrasi kadar tetap token bagi pengurangan kadar 90%, bukan janji penjimatan 90% untuk beban kerja sebenar yang setara. Dalam pengumuman pelancarannya, Anthropic melaporkan sekitar 75% kos operasi purata lebih rendah selepas mengambil kira panjang permintaan dan perubahan penggunaan token. Kira semula input representatif dan ukur kos tugas-tugas yang disiapkan sebelum menganggar penjimatan anda sendiri.
Where Can You Access Claude Haiku 5.5?
Official access and cloud platforms
Haiku 5.5 tersedia melalui Claude API dan platform yang disokong di Amazon Web Services, Google Cloud, dan Microsoft Azure, menurut pengumuman ketersediaan Anthropic. ID model Claude API terus ialah claude-haiku-5-5; Amazon Bedrock menggunakan anthropic.claude-haiku-5-5. Gunakan kelayakan yang dikeluarkan oleh penyedia pilihan anda dan semak keperluan akses akaun semasanya.
Third-party access through CometAPI
Halaman model CometAPI menyenaraikan claude-haiku-5-5 sebagai tersedia, dengan kadar Standard bermula pada $0.08 per juta token input dan $0.40 per juta token output untuk prompt sehingga 100K, 20% di bawah kadar Standard rasmi yang sepadan. Gunakan kunci yang dikeluarkan CometAPI dengan endpoint dan format permintaan CometAPI; ia adalah laluan akses berasingan daripada akses langsung Claude API. Semak halaman langsung untuk ketersediaan, jalur harga, dan butiran integrasi.
Apabila menukar penyedia atau menaik taraf daripada Haiku 4.5, sahkan ID model, kira semula token, dan uji had respons serta pengendalian perbualan. Untuk butiran pelaksanaan dan perubahan pemutus, rujuk panduan migrasi Anthropic.
Migration Validation
- Kemas kini ID model dan sahkan medan permintaan khusus endpoint.
- Kira semula token dengan tokenizer yang dikemas kini, termasuk prefiks stabil dan definisi alat.
- Uji tetapan pemikiran adaptif, taburan latensi, dan penghurai blok respons.
- Semak panggilan alat, pemulihan kegagalan, dan sebarang sekatan akaun blok pemikiran tersimpan.
- Bandingkan latensi p50/p95, kadar tugas diterima, dan jumlah token boleh dibil.
- Gunakan pelancaran berperingkat dan laluan rollback untuk aliran kerja kritikal perniagaan.
- Assistant prefill dilarang
Panduan migrasi Haiku 5.5 menerangkan kelakuan tokenizer, ID dan keserasian permintaan. Abaikan temperature, top_p dan top_k. Jika dibekalkan secara eksplisit, temperature mesti 1 dan top_p mesti 0.99; sebarang nilai top_k, atau membekalkan kedua-dua temperature dan top_p, mengembalikan ralat 400.
What Are the Limitations of Claude Haiku 5.5?
Haiku 5.5 bukan pengganti universal untuk model yang lebih besar. Pengekodan kompleks dan penaakulan jangka panjang kekal sebagai pembeza bermakna untuk Sonnet dan Opus. Prompt yang lebih panjang juga lebih mahal, jadi tetingkap 1M token harus digunakan secara selektif. Penaakulan adaptif memperkenalkan varians dalam token yang dijana dan latensi; penanda aras tidak menetapkan jaminan untuk aliran kerja perniagaan individu.
Automasi sensitif risiko harus mengesahkan output berstruktur, mengehadkan kebenaran alat luaran, menyimpan log audit, dan memerlukan semakan sebelum tindakan berakibat. Rute tugas yang tidak pasti ke model yang lebih kuat daripada bergantung semata-mata pada harga token asas Haiku yang lebih rendah.
Conclusion
Untuk pemprosesan volum tinggi dengan kriteria penerimaan yang boleh diukur, Claude Haiku 5.5 ialah peningkatan yang menarik: harga permulaan lebih rendah, konteks lebih besar, penaakulan adaptif, dan penilaian diterbitkan yang lebih kukuh. Untuk pengaturcaraan kompleks dan pembuatan keputusan yang samar, Sonnet 5.5 atau Opus 5.5 mungkin memberikan ekonomi keseluruhan yang lebih baik dengan mengurangkan percubaan semula dan pembetulan. Strategi yang menang ialah menanda aras keseluruhan aliran kerja dan merutekan permintaan mengikut kesukaran.
FAQ
How does Haiku 5.5's 100K pricing boundary affect a cached workflow?
Panjang prompt menentukan jalur kadar yang digunakan; jangan menganggar caj daripada teks baharu sahaja atau menganggap hanya token lebihan menggunakan kadar lebih tinggi. Kira permintaan untuk model yang dipilih, termasuk sejarah dan definisi alat, kemudian perdamaikan penggunaan input, cache-write, cache-read dan output dengan jalur yang berkaitan. Bandingkan invois pada permintaan cache yang representatif sebelum menetapkan bajet produksi.
Can Haiku 5.5 thinking blocks be replayed across accounts?
Ia hanya berfungsi dalam akaun yang menghasilkannya atau akaun yang dipautkan kepadanya. Jika akaun tidak berkaitan menghantar blok pemikiran tersimpan, API membuangnya sebelum model melihatnya; permintaan masih boleh berjaya tanpa penaakulan tersebut. Lihat panduan migrasi rasmi. Kekalkan blok perbualan dan gunakan akaun asal atau yang dipautkan apabila meneruskan alur kerja alat. Perubahan gateway atau akaun harus diuji secara eksplisit; padanan nama model tidak menjamin blok pemikiran tersimpan kekal boleh digunakan.
Why can Haiku 5.5 truncate a response that Haiku 4.5 completed?
Tokenizer baharu boleh mengira lebih banyak token untuk teks yang sama, jadi had max_tokens yang tidak berubah mungkin menampung output setara yang lebih sedikit. Pemikiran adaptif juga boleh menggunakan bajet output. Periksa stop_reason dan usage, kira semula prompt dengan model baharu, dan tala semula peruntukan output pada tugas sebenar dan bukannya menyalin had legasi.
How should Haiku 5.5 routing thresholds be selected?
Gunakan sampel berlabel daripada beban kerja sebenar untuk mengukur kadar tugas diterima, kos pembetulan dan latensi. Rute permintaan yang gagal pengesahan eksplisit atau melebihi skop tugas yang diuji ke model yang lebih kuat. Tala ambang terhadap kos keseluruhan aliran kerja, termasuk percubaan semula dan eskalasi, dan pantau selepas perubahan pada prompt, alat atau effort.