
Ringkasan Pasukan Qwen di Alibaba melancarkan secara rasmi Qwen3.8-Max pada 3 Ogos 2026 — model Mixture-of-Experts jarang (sparse) dengan 2.4 trilion jumlah parameter (95 bilion aktif), tetingkap konteks 1 juta token, dan sokongan multimodal asli (teks + imej + video).
Ini ialah model Qwen kelas Max pertama yang dijadualkan untuk pemberat terbuka (dijangka minggu berikutnya). Diharga agresif pada $2 bagi setiap sejuta token input dan $6 bagi setiap sejuta token output, ia menyampaikan hasil kukuh untuk tugas beragen jangka panjang, kejuruteraan perisian autonomi (termasuk projek pengekodan berkembang sendiri selama 16 hari yang didokumenkan), replikasi penyelidikan, dan penanda aras multimodal. Ia bersaing rapat dengan model seperti Kimi K3 dan berada di atas pilihan lebih ringan seperti DeepSeek V4 Flash dari segi keupayaan, sambil kekal jauh lebih cekap kos berbanding model frontier Barat terulung bagi beban kerja beroutput tinggi. Pembangun boleh mengaksesnya hari ini melalui QwenCloud / Alibaba Cloud Model Studio dan melalui platform bersepadu seperti CometAPI.
Perkara Utama
- Skala dan kecekapan: Seni bina MoE 2.4T keseluruhan / 95B aktif dibina atas asas Qwen 3.5 membolehkan prestasi bertaraf frontier pada kos inferens yang praktikal.
- Kekuatan jangka panjang: Menunjukkan pengkodan autonomi berbilang hari (265 komit, 127 PR sepanjang ~16 hari tanpa campur tangan manusia), replikasi + penambahbaikan kertas penyelidikan, dan operasi e-dagang simulasi selama setahun.
- Sorotan penanda aras: PaperBench 93.0 (mendahului), Terminal Bench 2.1 86.6, skor multimodal dan dokumen yang kukuh; kompetitif tetapi tidak dominan pada setiap papan pendahulu agen pengkodan tulen berbanding Claude Fable 5 atau GPT-5.6 Sol.
- Keunggulan harga: Tetap $2 / $6 bagi setiap 1M token merentasi keseluruhan 1M konteks (input cache ~$0.25), mengatasi Kimi K3 pada output dan banyak model Barat.
- Ketersediaan: Langsung di QwenCloud dan Alibaba Cloud Model Studio (API serasi OpenAI dan Anthropic); pemberat terbuka dirancang; telah disenaraikan di CometAPI sebagai
qwen3.8-maxuntuk akses bersepadu bersama 500+ model lain. Pemberat terbuka akan hadir dalam masa terdekat; varian Qwen3.8-27B yang lebih kecil juga dirancang untuk penyebaran setempat/edge yang praktikal. - Keunggulan praktikal: Cemerlang dalam penghasilan hasil siap hantar hujung ke hujung berbanding jawapan satu pusingan — sesuai untuk agen pengkodan, saluran penyelidikan, aliran kerja pejabat, dan gelung agen berterusan.
Apakah Qwen3.8-Max?
Qwen3.8-Max ialah model terbaru dan paling berkeupayaan dalam siri Qwen oleh Alibaba, dikeluarkan secara rasmi pada 3 Ogos 2026 (selepas pratonton pertengahan Julai di Persidangan AI Dunia di Shanghai). Ia mewakili peralihan yang disengajakan ke arah model yang boleh menyiapkan tugas kompleks, berbilang hari dari hujung ke hujung dengan pengawasan minimum dan menghasilkan deliverable sedia hantar.
Dari sudut seni bina, ia merupakan model Mixture-of-Experts (MoE) jarang yang diskalakan kepada 2.4 trilion jumlah parameter, di mana hanya kira-kira 95 bilion diaktifkan bagi setiap token. Reka bentuk ini, dibina di atas asas Qwen 3.5, mengimbangi kapasiti besar dengan kecekapan inferens. Model ini menyokong tetingkap konteks 1 juta token (input maksimum didokumenkan sekitar 991K token dan output maksimum sekitar 131K token), input multimodal asli (teks, imej, dan video), serta output teks. Ia merangkumi kawalan usaha penaakulan (xhigh / medium / low) dan menyokong kedua-dua protokol OpenAI Chat Completions dan serasi Anthropic, menjadikannya serasi terus sebagai pengganti dalam rangka kerja agen popular seperti Claude Code, Codex, Qoder CLI, Qwen Code, dan OpenClaw.
Berbeza dengan model kelas Max sebelumnya yang kekal tertutup, Alibaba telah komited untuk melepaskan pemberat Qwen3.8-Max (dan varian Qwen3.8-27B yang lebih kecil) pada minggu selepas pelancaran melalui Hugging Face dan ModelScope — kali pertama model Qwen peringkat Max akan tersedia secara terbuka.
Model ini diposisikan untuk agen pengkodan, kerja profesional dunia sebenar (“cowork”), penyelidikan, perancangan jangka panjang, dan gelung agen multimodal. Demo rasmi menekankan tingkah laku berkembang sendiri: model mencipta isu, menetapkannya kepada dirinya sendiri, menulis dan menguji kod, berulang berdasarkan maklum balas, dan menambah baik perkakasan bantuannya dalam tempoh berpanjangan.
Sumber: Blog rasmi Qwen dan pengumuman Alibaba Cloud (Ogos 2026); kad model Artificial Analysis; ulasan bebas yang merumuskan keluaran GA.
Apa Yang Baharu dalam Qwen3.8-Max?
Berbanding pendahulunya Qwen3.7-Max, generasi 3.8 memberikan peningkatan ketara dalam pengkodan beragen, kebolehpercayaan jangka panjang, penaakulan multimodal, dan prestasi dokumen/pejabat. Inovasi utama termasuk:
Autonomi jangka panjang sebenar:
Model boleh mengekalkan pembelajaran adaptif gelung tertutup merentasi ratusan giliran atau berbilang hari. Contoh didokumenkan termasuk projek kejuruteraan perisian autonomi selama 16 hari yang menghasilkan alat CLI berkembang sendiri (oh-my-cli) dengan 265 komit, 127 pull request, dan 151 isu sepenuhnya tanpa campur tangan manusia; replikasi dan penambahbaikan metodologi kertas penyelidikan (termasuk gelung latihan GPU dan peningkatan penanda aras yang boleh diukur); dan satu tahun penuh operasi e-dagang simulasi yang mengatasi garis dasar dengan ketara.
Multimodal sebagai gelung maklum balas berterusan:
Penglihatan bukan sekadar mod input. Model menggunakan pemahaman visual untuk perancangan, pemantauan pelaksanaan, dan pembetulan diri — membolehkan tugas seperti penciptaan semula daripada tangkapan skrin kepada kod, penjanaan permainan/animasi interaktif, dan visualisasi 2D-ke-3D.
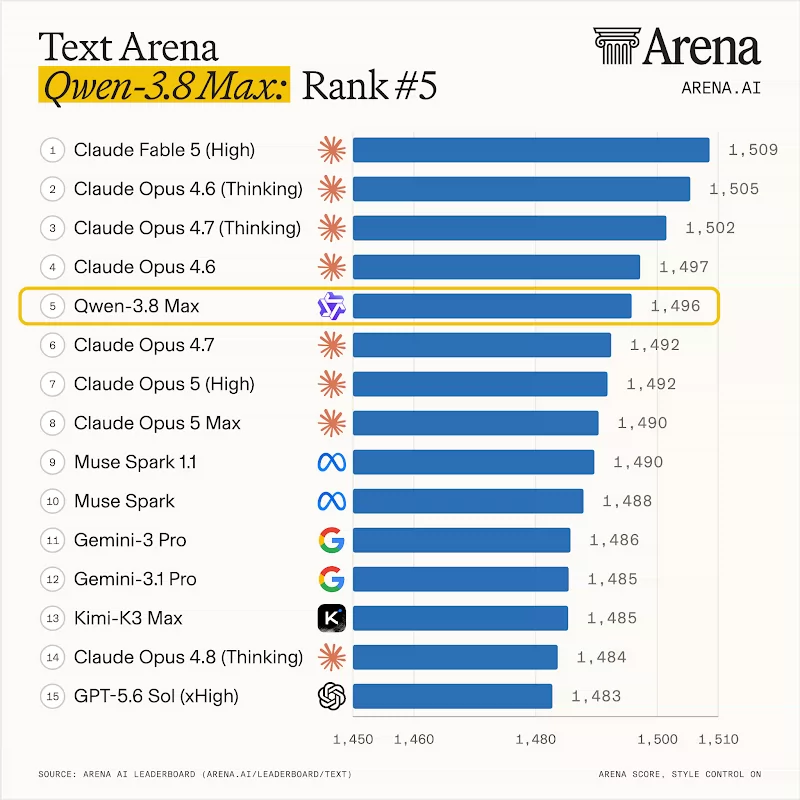
Model berada pada kedudukan tinggi di Text Arena (kelima dilaporkan) dan Vision Arena (kedua dilaporkan) dalam data awal pascakeluar.

Fokus pada deliverable hujung ke hujung:
Penekanan pada penghasilan output berkualiti produksi merentasi ratusan profesion berbanding jawapan terpencil.
Mod Berfikir dan Inferens Pantas
Dua mod: mod berfikir dan mod inferens pantas. Mod berfikir untuk penaakulan lebih mendalam dan perancangan kompleks. Mod pantas untuk tindak balas latensi lebih rendah apabila tugasnya mudah. Dokumentasi OpenCode Alibaba Cloud menunjukkan thinking didayakan untuk laluan Qwen3.8 dan menyenaraikan kawalan penaakulan untuk laluan pratonton, termasuk xhigh, medium, dan low.
Pembahagian ini berguna untuk reka bentuk produk. Pasukan tidak sepatutnya menggunakan mod penaakulan paling berat untuk setiap permintaan. Bot sokongan boleh mengklasifikasikan tiket ringkas dengan murah, meringkaskan dengan model lebih pantas, dan hanya meningkat kepada mod berfikir Qwen3.8-Max apabila pengguna meminta keputusan polisi yang rumit, analisis punca akar, semakan kontrak, atau pelan migrasi kod.
Keupayaan ini telah disahkan melalui eksperimen dalaman yang berjalan lama dan satu set penanda aras komprehensif merangkumi agen pengkodan, agen umum, penaakulan multimodal, pemahaman dokumen, dan tugas persepsi/penambatan.
Penanda Aras: Prestasi pengkuantitian data
Alibaba menerbitkan satu set penanda aras dalaman yang meluas pada GA. Pengesahan bebas (Artificial Analysis Intelligence Index, LMArena, dll.) masih mengejar pada hari-hari terawal selepas keluaran; data awal Artificial Analysis meletakkan Qwen3.8-Max pada Indeks Kecerdasan 53 (kedudukan ~16/186 dalam set yang dijejak), dengan verbosity tinggi dan kelajuan relatif lebih rendah.
Skor rasmi/dilaporkan terpilih (Qwen3.8-Max vs rakan setanding terpilih):
| Penanda aras | Qwen3.8-Max | Claude Fable 5 / Opus 4.8 | GPT-5.6 Sol (max) | Qwen3.7-Max |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 86.6 | 84.6 | 88.8 | 74.5 |
| PaperBench | 93.0 | 88.8 / 80.3 | 90.5 | 64.8 |
| SWE-bench Pro | 67.7 | 80.0 / 69.2 | 64.6 | 60.6 |
| FrontierSWE | 73.5 | 88.8 | — | 40.7 |
| DeepSWE 1.1 | 56.6 | 70.0 | 73.0 | 21.6 |
| IFBench | 82.8 | ~63.5 | — | 79.1 |
| GPQA Diamond | 92.6 | 92.6 | 94.1 | 92.4 |
| OmniDocBench 1.5 | 92.1 | — | — | — |
| OSWorld-Verified | 86.1 | — | — | — |
Qwen3.8-Max kerap mendahului atau berada berhampiran puncak pada penaakulan multimodal, tugas dokumen/pejabat, dan metrik agen pengkodan/penyelidikan tertentu, sambil ketinggalan model tertutup terkuat pada beberapa suit agen kejuruteraan perisian tulen. Lompatan generasi pada FrontierSWE dan DeepSWE amat ketara. Anggap nombor vendor sebagai berarah; larian bebas dan penilaian khusus beban kerja kekal penting.
Harga API Qwen3.8-Max
Harga rasmi Alibaba Cloud Model Studio / QwenCloud untuk Qwen3.8-Max (kadar GA awal Ogos 2026):
- Input: $2.00 bagi setiap 1 juta token
- Output: $6.00 bagi setiap 1 juta token (termasuk token berfikir/penaakulan)
- Input cache: kira-kira $0.25 bagi setiap 1 juta token (penjimatan ketara untuk konteks panjang berulang)
Harga adalah rata merentasi keseluruhan tetingkap konteks 1M — satu kelebihan ketara berbanding ramai pesaing yang mengenakan surcaj konteks panjang. Diskaun pukal dan lain-lain mungkin terpakai bergantung pada wilayah penyebaran dan pelan.
Konteks perbandingan (harga senarai anggaran sekitar tempoh sama):
- Kimi K3: ~$3 / $15
- Model frontier Claude / GPT peringkat lebih tinggi: lazimnya $5+ / $15–25+
- Varian DeepSeek V4 Flash: jauh lebih rendah (sering di bawah $0.50 digabungkan untuk banyak kegunaan)
Bagi pasukan yang sudah menggunakan berbilang penyedia, gerbang agregat seperti CometAPI lazimnya menawarkan diskaun ~20% berbanding kadar rasmi, titik akhir serasi OpenAI tunggal, pengebilan bersepadu, dan penukaran atau failover model yang mudah. Ini menjadikan eksperimen dengan Qwen3.8-Max (dan perbandingan serentak terhadap DeepSeek V4 Flash, model Kimi, atau lain-lain) lebih mudah dari segi operasi dan sering lebih murah. Semak halaman harga CometAPI terkini dan tawaran kredit percuma untuk kadar efektif terkini.
Bagaimana Qwen3.8-Max Menandingi Kimi K3 dan DeepSeek V4 Flash
| Dimensi | Qwen3.8-Max | Kimi K3 | DeepSeek V4 Flash |
|---|---|---|---|
| Jumlah / Parameter aktif | 2.4T / ~95B | ~2.8T / ~104B | 284B / 13B |
| Konteks | 1M | 1M | 1M |
| Multimodal | Teks + Imej + Video | Teks + Imej + Video | Teks sahaja |
| Harga (masuk/keluar) | $2 / $6 | $3 / $15 | ~$0.14 / $0.28 (jauh lebih murah) |
| Pemberat terbuka | Dirancang (minggu depan) | Telah dikeluarkan | MIT, tersedia |
| Kekuatan | Autonomi jangka panjang, multimodal, PaperBench, harga pada output | Skor bebas yang kukuh, mendahului arena pengekodan front-end | Kecekapan kos ekstrem, agen pengkodan mantap untuk saiz |
| Kedudukan relatif | Kompetitif / mendahului pada beberapa penanda aras agen & multimodal | Sedikit kelebihan pada beberapa indeks kecerdasan diaudit | Nilai cemerlang; keupayaan mutlak lebih rendah |
Qwen3.8-Max secara umum menyamai atau mengatasi Kimi K3 pada kecekapan kos untuk kerja beroutput tinggi dan tugas multimodal, manakala DeepSeek V4 Flash kekal sebagai raja bajet untuk beban kerja teks volum tinggi di mana keupayaan puncak adalah sekunder. Ramai pasukan akan menggunakan ketiga-tiganya melalui gerbang bersepadu, menghalakan trafik mudah ke model kelas Flash dan sesi agen kompleks ke Qwen3.8-Max atau Kimi K3.
Adakah Qwen3.8-Max setanding dengan Kimi K3?
Dalam beberapa aspek, ya. Ia menyamai peringkat konteks 1M, mempunyai kedudukan multimodal yang kuat, dan lebih murah pada harga input/output rasmi standard. Ia tidak menyamai kiraan parameter jumlah 2.8T Kimi, dan dokumentasi awam Kimi ketika ini menyediakan panduan alat, cache konteks, output berstruktur, dan penglihatan yang amat terperinci.
Adakah Qwen3.8-Max setanding dengan DeepSeek V4 Flash?
Ia bersaing dalam konteks 1M dan seni bina MoE, tetapi produk menyasar tugas berbeza. DeepSeek V4 Flash ialah laluan pantas yang ekonomik. Qwen3.8-Max ialah laluan berkeupayaan tinggi yang lebih besar untuk kerja di mana pemahaman multimodal, penaakulan lanjutan, dan produktiviti perusahaan lebih penting daripada harga token paling rendah.
Apa yang boleh dilakukan Qwen3.8-Max?
Pengkodan dan Kejuruteraan Perisian
Qwen3.8-Max ialah calon kuat untuk pembangunan full-stack, semakan kod, pemahaman repositori, perancangan migrasi, reka bentuk API, penyahpepijatan, penaakulan ujian, dan seni bina perisian. Konteks panjangnya membantu apabila model perlu mengekalkan banyak fail, log, dan keperluan serentak. Gunakannya untuk tugas kod yang sukar, bukan untuk setiap auto-lengkap atau penjelasan lint ringkas.
Kerja Pejabat dan Pengetahuan
Penempatan “Cowork” model ini penting. Pekerja perusahaan bukan sahaja bertanya soalan chat. Mereka membandingkan PDF, meringkaskan mesyuarat, menyemak slaid, mentafsir hamparan, menyemak kontrak, menulis laporan, dan menyediakan keputusan daripada bukti yang bercelaru. Reka bentuk multimodal dan konteks panjang Qwen3.8-Max menjadikannya sesuai untuk aliran kerja pejabat di mana teks, dokumen, tangkapan skrin, dan data berstruktur perlu ditaakul bersama.
Aliran Kerja Beragen
Qwen3.8-Max berguna untuk perancangan agen: memecahkan matlamat kepada langkah, memutuskan alat untuk dipanggil, menilai hasil, dan menyemak semula pelan. Dalam CometAPI, ini menjadi lebih praktikal kerana aplikasi yang sama boleh menghala langkah mudah kepada model lebih murah dan menyimpan Qwen3.8-Max untuk perancangan atau pengesahan.
Cara Bermula dan Petua Integrasi CometAPI
- Akses terus: Gunakan QwenCloud atau Alibaba Cloud Model Studio dengan ID model
qwen3.8-max. Titik akhir serasi OpenAI dan serasi Anthropic disokong. - Akses bersepadu melalui CometAPI: Daftar di CometAPI.com, dapatkan kunci API, tetapkan
base_urlkepadahttps://api.cometapi.com/v1, dan panggilmodel="qwen3.8-max". Kunci yang sama berfungsi untuk DeepSeek V4 Flash, Kimi K3, Claude, GPT, dan ratusan model lain — sesuai untuk eksperimen, kawalan kos, dan penghalaan produksi. CometAPI menekankan harga kompetitif, latensi rendah, dan penambahan model baharu yang pantas (Qwen3.8-Max disenaraikan sejurus selepas pelancaran). - Rangka kerja agen: Pasangkan terus ke Claude Code, OpenClaw, atau abah-abah tersuai. Dayakan usaha penaakulan lebih tinggi untuk kerja jangka panjang yang kompleks.
- Pemberat terbuka: Pantau Hugging Face / ModelScope untuk keluaran yang bakal tiba jika anda memerlukan penyebaran di premis atau talaan halus.