
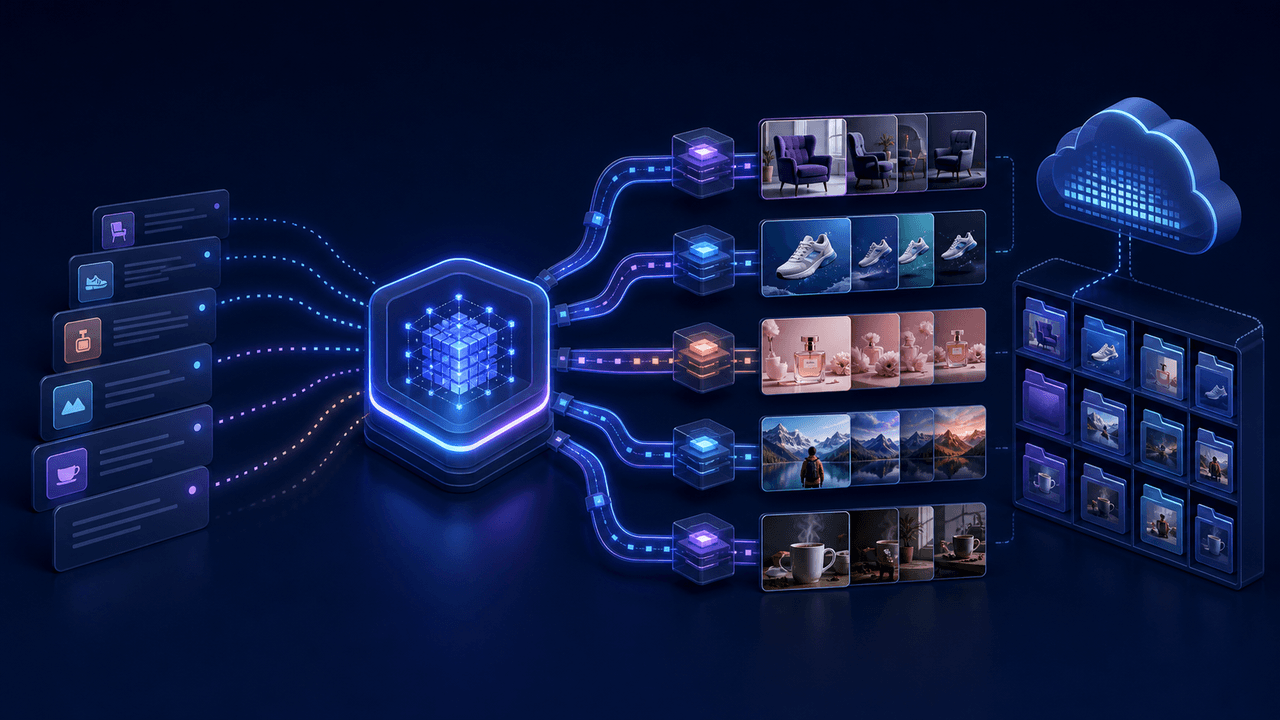
De eenvoudigste manier om beeldgeneratie op schaal te automatiseren zonder meerdere API’s te beheren, is door de workflow los te koppelen van de modelprovider. Plaats elke afbeeldingsaanvraag in één wachtrij, routeer elke taak naar een actueel model-ID en stuur compatibele verzoeken via één CometAPI-sleutel en de OpenAI-compatibele basis-URL https://api.cometapi.com/v1.
Deze tutorial bouwt die pijplijn in Python. Hij accepteert product-, advertentie- en contenttaken uit een JSON Lines-wachtrij; kiest een model; begrenst de paralleliteit; probeert tijdelijke fouten opnieuw; slaat resultaten op als URL of base64; en registreert per taak het gebruik en de geschatte kosten. Het voorbeeld houdt die productiebenodigdheden in één compact blok zodat je de workflow kunt testen zonder het artikel in een codereferentie te veranderen.
Hoe een uniforme afbeeldings-API batchgeneratie vereenvoudigt
Aan het einde ziet de workflow er zo uit:
jobs.jsonl → bounded worker pool → CometAPI /v1/images/generations → object storage → manifest.jsonl
De wachtrij en de opslaglaag blijven van jou. Het wisselen van beeldmodellen verandert de waarde van model, niet het authenticatiesysteem of de hoofdroute. Dat is het praktische voordeel van een uniforme afbeeldings-API: de modelkeuze wordt een routeringsbeslissing binnen één pijplijn in plaats van een aparte providerintegratie.
Wat heb je nodig om het genereren van afbeeldingen te automatiseren?
Je hebt Python 3.10 of later nodig, het pakket requests, een CometAPI-sleutel, een beschrijfbare uitvoerlocatie en ten minste één actueel model-ID voor afbeeldingen.
Installeer de enige afhankelijkheid:
pip install requests
Stel je sleutel in op de server, nooit in browsercode of een repository:
export COMETAPI_KEY="your-key"
De basis-URL is https://api.cometapi.com/v1, en compatibele tekst-naar-afbeeldingstaken gebruiken POST /images/generations. Controleer vóór een uitrol elk model in de live modelcatalogus; de catalogus retourneert het huidige ID, de ondersteunde endpoint, functies en prijsmetadata zonder een autorisatieheader te vereisen.
Per 20 augustus 2026 vermeldde de live catalogus deze twee nuttige routes:
| Workload | Model-ID | Waarom geschikt |
|---|---|---|
| Productafbeeldingen met gecontroleerde output | gpt-image-2 | Levert gebruiksgegevens en base64-afbeeldingscontent op de gedocumenteerde compatibele OpenAI-route |
| Grootschalige advertentie- en contentconcepten | doubao-seedream-4-5-251128 | Gebruikt dezelfde generatieroute en wordt vermeld met prijs per aanvraag |
De tabel is een startpunt, geen claim dat de modellen identieke mogelijkheden hebben. Grootte, kwaliteit, formaat, ondersteuning voor referentieafbeeldingen en responsgedrag blijven modelspecifiek. Controleer het modelrecord en de gekoppelde documentatie voordat je optionele parameters doorgeeft.
Hoe bouw je een workflow voor batchgeneratie van afbeeldingen in Python
1. Geef elke taak een stabiele ID
Gebruik één JSON-object per regel, zodat een wachtrij, database-export of spreadsheettaak dezelfde worker kan voeden:
{"id":"sku-1001","kind":"product","prompt":"Studio product photo of a ceramic coffee dripper on a warm neutral background"}
{"id":"campaign-204","kind":"ad","prompt":"Editorial summer travel image, vivid natural light, wide composition, no text"}
{"id":"blog-088","kind":"content","prompt":"Minimal illustration of a developer automating a creative workflow, no text"}
De ID wordt de bestandsnaam van de output en de sleutel in het manifest. Gebruik in productie deze ID als idempotentiesleutel en sla ID’s die al als succesvol zijn gemarkeerd over bij herverwerking van een wachtrij.
2. Routeer op taaktype en valideer vervolgens tegen de live catalogus
Het voorbeeld mappt productwerk naar gpt-image-2 en advertentie- of contentwerk naar doubao-seedream-4-5-251128. Een taak kan die keuze overschrijven met zijn eigen veld model. Bij het opstarten downloadt de worker de openbare catalogus en wijst een ID af dat niet langer wordt vermeld.
Dit is veiliger dan overal in de applicatie een providerspecifieke SDK hardcoderen. Je kunt een route in één mapping wijzigen nadat je kwaliteit, latentie en prijs voor je eigen prompts hebt geëvalueerd.
3. Begrens de paralleliteit in plaats van de hele batch te starten
De worker begint met vier gelijktijdige verzoeken. Dat aantal is een conservatieve applicatie-instelling, geen universele servicelimiet. Meet latentie en 429-responses voor je account en verhoog of verlaag MAX_WORKERS vervolgens bewust.
Alleen 408-, 429- en 5xx-responses worden opnieuw geprobeerd met exponentiële backoff en jitter. Authenticatiefouten, ongeldige model-ID’s en niet-ondersteunde parameters falen onmiddellijk, omdat het opnieuw proberen van dezelfde foutieve aanvraag alleen vertraging toevoegt.
4. Normaliseer het resultaat vóór opslag
Beeldmodellen retourneren niet altijd dezelfde container. De gedocumenteerde GPT Image-respons bevat data[0].b64_json; andere compatibele modellen kunnen data[0].url retourneren. De worker verwerkt beide, schrijft de afbeelding naar een tijdelijk bestand en hernoemt dit pas nadat de download of decodering is geslaagd.
Gebruik in productie in plaats van de lokale map output/ S3, R2, GCS of een andere objectopslag. Behandel een door een provider gehoste URL niet als permanente opslag, tenzij het retentiebeleid dat expliciet aangeeft.
5. Registreer gebruik, pogingen en geschatte kosten
Elk resultaat wordt een compacte manifestregel met de taak-ID, het model, het opgeslagen pad, de status en de geschatte USD-kosten wanneer de live catalogus voldoende prijsgegevens levert. Mislukte taken behouden de fout in plaats van uit de batch te verdwijnen.
Compleet Python-script voor batchgeneratie van afbeeldingen
Sla het volgende op als batch_image_pipeline.py, plaats de wachtrij ernaast als jobs.jsonl en voer python3 batch_image_pipeline.py uit.
import base64, json, os, random, time
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path
import requests

BASE_URL = "https://api.cometapi.com/v1"
KEY = os.environ["COMETAPI_KEY"]
WORKERS = int(os.getenv("MAX_WORKERS", "4"))
OUT = Path("output")
ROUTES = {
    "product": "gpt-image-2",
    "ad": "doubao-seedream-4-5-251128",
    "content": "doubao-seedream-4-5-251128",
}

catalog = requests.get("https://api.cometapi.com/api/models", timeout=30)
catalog.raise_for_status()
CATALOG = {model["id"]: model for model in catalog.json()["data"]}

def generate(job):
    model = job.get("model", ROUTES[job["kind"]])
    if model not in CATALOG:
        raise ValueError(f"Unknown model: {model}")
    payload = {"model": model, "prompt": job["prompt"], "n": 1}
    if model == "gpt-image-2":
        payload.update(quality="low", size="1024x1024", output_format="jpeg")

    for attempt in range(4):
        response = requests.post(
            f"{BASE_URL}/images/generations",
            headers={"Authorization": f"Bearer {KEY}"},
            json=payload,
            timeout=180,
        )
        if response.status_code not in {408, 429} and response.status_code < 500:
            break
        time.sleep(2**attempt + random.random())
    response.raise_for_status()
    body = response.json()
    item = body["data"][0]

    if item.get("b64_json"):
        data = base64.b64decode(item["b64_json"])
        extension = body.get("output_format", "png")
    else:
        download = requests.get(item["url"], timeout=120)
        download.raise_for_status()
        data = download.content
        extension = {"image/png": "png", "image/webp": "webp"}.get(
            download.headers.get("content-type"), "jpg"
        )
    path = OUT / f"{job['id']}.{extension}"
    path.write_bytes(data)

    price, usage = CATALOG[model].get("pricing") or {}, body.get("usage", {})
    cost = price.get("per_request")
    if cost is None and price.get("input") is not None:
        cost = (usage.get("input_tokens", 0) * price["input"] +
                usage.get("output_tokens", 0) * price["output"]) / 1_000_000
    return {"id": job["id"], "model": model, "path": str(path),
            "estimated_usd": cost * price.get("ratio", 1) if cost is not None else None}

def safe_generate(job):
    try:
        return {"status": "success", **generate(job)}
    except Exception as error:
        return {"id": job["id"], "status": "failed", "error": str(error)}

OUT.mkdir(exist_ok=True)
jobs = [json.loads(line) for line in Path("jobs.jsonl").read_text().splitlines() if line]
with ThreadPoolExecutor(max_workers=WORKERS) as pool:
    results = list(pool.map(safe_generate, jobs))
with (OUT / "manifest.jsonl").open("w") as manifest:
    manifest.writelines(json.dumps(result) + "\n" for result in results)
Het script gebruikt de huidige catalogus tijdens runtime, terwijl de twee fallbackmappings voorbeelden zijn die op 20 augustus 2026 zijn geverifieerd. Controleer ze opnieuw voordat je de code op een andere datum publiceert of uitrolt.
Hoe test je de workflow voor batchgeneratie van afbeeldingen
Begin met één taak en één worker:
MAX_WORKERS=1 python3 batch_image_pipeline.py
Een succesvolle GPT Image-respons heeft deze structuur:
{
  "created": 1776841943,
  "output_format": "jpeg",
  "quality": "low",
  "size": "1024x1024",
  "usage": {
    "input_tokens": 16,
    "output_tokens": 208,
    "total_tokens": 224
  },
  "data": [{"b64_json": "<base64-image-data>"}]
}
De worker decodeert de afbeelding, schrijft output/<job-id>.jpeg en voegt een succesregel toe aan output/manifest.jsonl. Als een model in plaats daarvan een URL retourneert, downloadt de worker deze en slaat het lokale pad op in hetzelfde manifesformaat.
De code is lokaal op syntax gecontroleerd. Een live generatieaanroep vereist nog steeds je CometAPI-sleutel, dus voer de smoketest met één taak uit voordat je de paralleliteit verhoogt.
Wat kost batchgeneratie van afbeeldingen?
Prijzen moeten worden gedateerd, omdat modeltarieven veranderen. Per 20 augustus 2026 retourneerde de live CometAPI-modelcatalogus de volgende basisprijsvelden en een factureringsratio van 0.8:
gpt-image-2: $5 per 1M inputtokens en $30 per 1M outputtokens; met de vermelde ratio worden de effectieve tarieven $4 en $24 per 1M tokens.doubao-seedream-4-5-251128: $0.04 per aanvraag; met de vermelde ratio wordt dit $0.032 per aanvraag.
De CometAPI-prijsgids legt tokengebaseerde facturatie uit voor modellen met officiële prijzen en aanroepgebaseerde facturatie voor modellen die per aanvraag geprijsd zijn. Het script leest de catalogus bij uitvoering en gebruikt dezelfde regel:
token cost = ratio × (input tokens × input rate + output tokens × output rate) / 1,000,000
request cost = ratio × per-request price
Bijvoorbeeld, de hierboven gedocumenteerde GPT Image-respons rapporteert 16 inputtokens en 208 outputtokens. Met de cataloguswaarden van 20 augustus komt dat illustratieve resultaat uit op ongeveer $0.005056. Het echte totaal verandert met model, kwaliteit, grootte, prompt, herhaalpogingen en het gerapporteerde gebruik. Behandel de API-respons en het gebruiksdashboard van je account als het factureringsbewijs, niet een vaste aanname per afbeelding.
Reserveer ook budget voor mislukte werkzaamheden. Een herhaalpoging na een onbevestigde timeout kan een tweede factureerbaar resultaat opleveren, en een technisch succesvolle afbeelding die de review niet haalt, verbruikt toch budget. Volg zowel API-kosten als het acceptatiepercentage:
effective cost per accepted image = total batch spend / approved images
Veelvoorkomende fouten bij afbeeldings-API’s en hoe ze op te lossen
| Symptoom | Waarschijnlijke oorzaak | Oplossing |
|---|---|---|
| 401 | Ontbrekende of ongeldige sleutel | Controleer de serverzijde COMETAPI_KEY |
| 400 | Ongeldig model of niet-ondersteunde optie | Controleer de live catalogus en verwijder modelspecifieke velden |
| 429 | Te veel paralleliteit | Verlaag MAX_WORKERS en behoud exponentiële backoff |
| Herhaalde 5xx | Tijdelijke upstreamfout | Probeer opnieuw met een limiet en verplaats de taak daarna naar een dead-letter-queue |
| Geen opgeslagen afbeelding | Respons gebruikte een andere container | Inspecteer data[0] en ondersteun zowel b64_json als url |
| Dubbele kosten | Taak opnieuw afgespeeld na gedeeltelijke fout | Gebruik stabiele ID’s en bevestig pas nadat opslag slaagt |
Probeer niet elke fout opnieuw. Een permanente 400-aanvraag blijft ongeldig, terwijl een onbeperkte 429-herhaalloop een verkeerspiek kan omzetten in een achterstand.
Best practices voor productie-beeldgeneratie op schaal
Stap over van JSON Lines naar een duurzame wachtrij wanneer meerdere workers betrokken zijn. Stel een visibility-timeout in die langer is dan de maximale generatietijd, bevestig een taak pas nadat de afbeelding en het manifest zijn opgeslagen, en stuur uitgeputte taken naar een dead-letter-queue voor beoordeling.
Houd optionele besturingselementen in modelspecifieke configuratie. Een gedeelde payload moet alleen gemeenschappelijke velden bevatten zoals model, prompt en n: 1; voeg quality, size of output_format alleen toe nadat de documentatie van het geselecteerde model deze bevestigt. Als je fallbackroutering toevoegt, kies dan een model dat dezelfde taak ondersteunt en bouw de payload voor dat model opnieuw op in plaats van providerspecifieke opties blindelings te herhalen.
Sla de API-sleutel op in een secretsmanager, beperk promptinvoer, scan gegenereerde assets volgens je beleid en houd provider-URL’s buiten langdurige productrecords. Log taak-ID, model-ID, latentie, pogingen, gebruik, opslagpad, reviewergebnis en datum van de catalogusmomentopname. Met die velden kun je modellen vergelijken op kosten per geaccepteerde afbeelding in plaats van alleen op de lijstprijs.
Stel tot slot budgetwaarborgen in: een maximale batchgrootte, een herhaalpogingslimiet per taak, een dagelijkse bestedingswaarschuwing en een stopvoorwaarde wanneer het goedkeuringspercentage daalt. Het sneller opschalen van een slechte prompt is geen optimalisatie.
Veelgestelde vragen over het automatiseren van beeldgeneratie op schaal
Wat is de eenvoudigste manier om beeldgeneratie op schaal te automatiseren zonder meerdere API’s te beheren?
Gebruik één wachtrij en opslagworkflow en stuur vervolgens compatibele afbeeldingsverzoeken via één CometAPI-sleutel en https://api.cometapi.com/v1/images/generations. Verander het model-ID in je routeringslaag in plaats van aparte authenticatie en provider-SDK’s te onderhouden.
Kan ik één verzoek sturen en meerdere beeldmodellen tegelijk laten genereren?
Het voorbeeld gebruikt één model per taak. Fan-out is een applicatieworkflow: dupliceer een taak met verschillende ID’s en modelwaarden en vergelijk vervolgens de opgeslagen outputs. Dit houdt kosten en reviewstatus toewijsbaar aan elk model.
Welke paralleliteit moet ik gebruiken?
Er is geen universeel aantal voor elk account en model. Begin met een kleine begrensde pool zoals vier workers, monitor latentie en 429-responses en stel af op basis van evidence.
Moet ik de geretourneerde URL opslaan of de afbeelding zelf?
Sla de afbeelding op in je eigen objectopslag. Een geretourneerde URL kan tijdelijk zijn, terwijl GPT Image-modellen base64-inhoud kunnen retourneren in plaats van een URL.
Hoe kies ik het goedkoopste model?
Bereken kosten per geaccepteerde afbeelding, niet alleen prijs per aanroep. Neem token- of aanroepkosten, herhaalpogingen, mislukte downloads, afgekeurde assets, nabewerking en menselijke review mee. Controleer de live modelcatalogus op de dag dat je publiceert of uitrolt.
Waar moet ik de endpoint en het responsformaat verifiëren?
Gebruik de CometAPI Quick Start, documentatie van de modelcatalogus, referentie voor beeldgeneratie en de prijsgids.