
DeepSeek V4.1 Flash vervangt de kortstondige bètafase door een productierelease, gebouwd rond asymmetrische rekenlast, native multimodaliteit, sterkere agent-benchmarks en fors lagere API-prijzen.
TL;DR
DeepSeek V4.1 Flash is nu een officiële API en een model met open gewichten, geen aflopend bèta-endpoint meer. DeepSeek zegt dat het een Mixture-of-Experts-model met 552B parameters is dat een nieuwe Causal-Encoder-Decoder-architectuur gebruikt. Slechts 8B parameters worden geactiveerd tijdens inputverwerking, terwijl 16B actief zijn tijdens outputgeneratie. Dat asymmetrische ontwerp is bedoeld om minder compute te spenderen aan lange prompts zonder de autoregressieve generatiefase te verzwakken.
De productiemodelnaam voor de API is deepseek-flash. Het ondersteunt een contextvenster van 1M tokens, tot 384K outputtokens, denk- en niet-denkmodi, JSON-uitvoer, tool-aanroepen, de Responses API, de Anthropic-compatibele API en native visuele invoer. DeepSeek’s officiële benchmarktabel laat substantiële winst zien ten opzichte van zowel V4 Flash 0731 als V4 Pro 0813 op coding-, agent-, cybersecurity- en multimodale taken.
De prijswijziging is even belangrijk. Op piekmomenten kost V4.1 Flash $0.006 per miljoen invoertokens bij cache-hit, $0.30 per miljoen invoertokens bij cache-miss en $1.20 per miljoen outputtokens. Buiten piekuren zijn de tarieven de helft daarvan.
Belangrijkste punten
- DeepSeek V4.1 Flash is een uitgebracht model met open gewichten; de tijdelijke
deepseek-v4.1-flash-expires-on-0910-identifier is niet langer de juiste productiereferentie. - Het 552B MoE-ontwerp activeert 8B parameters voor input en 16B voor output, wat een ander efficiëntieprofiel oplevert dan de 284B-totaal/13B-actief-architectuur van V4 Flash.
- Native multimodaliteit is onderdeel van het hoofdmodel in plaats van een aparte Vision Exp-variant.
- De officiële vergelijking toont V4.1 Flash vóór V4 Pro 0813 op de meeste geselecteerde agent- en coding-benchmarks, al leidt het niet op elke kennis- of terminalbenchmark tegen alle frontier-concurrenten.
- De globale KV-cache daalt naar 890 bytes per token, ongeveer 3,9 keer kleiner dan V4 Flash en ruwweg een kwart van de eerdere voetafdruk.
- Piek-API-prijzen zijn $0.006 voor cache-hit-invoer, $0.30 voor cache-miss-invoer en $1.20 voor output per miljoen tokens; dalurentarieven zijn 50% lager.
Wat is DeepSeek V4.1 Flash?
DeepSeek V4.1 Flash is DeepSeek’s efficiency-gedreven foundation model van september 2026 voor redeneren, coderen, agents en multimodale interpretatie. De officiële aankondiging beschrijft het als een MoE-model met 552B parameters dat de capaciteiten verbetert terwijl het de hoeveelheid compute en geheugen voor inputverwerking reduceert.
De belangrijkste verandering is architectonisch. De eerdere V4 Flash gebruikte één actief-parameterbudget gedurende de hele inferentie. V4.1 Flash scheidt de input- en outputworkloads: 8B parameters zijn actief bij het encoderen van de prompt en 16B zijn actief tijdens het genereren van het antwoord. DeepSeek noemt dit ontwerp Causal-Encoder-Decoder.
| Datum | Status | Model-ID |
|---|---|---|
| Sep 8 | Beperkte bèta | deepseek-v4.1-flash-expires-on-0910 |
| Sep 10 | Productierelease | deepseek-flash |
DeepSeek V4.1 Flash-specificatie:
| Specificatie | DeepSeek V4.1 Flash |
|---|---|
| Release-status | Officiële API-release en model met open gewichten |
| Architectuur | Mixture-of-Experts met Causal-Encoder-Decoder-structuur |
| Totaal aantal parameters | 552B |
| Geactiveerde parameters | 8B voor input; 16B voor output |
| Contextvenster | 1M tokens |
| Maximale output | 384K tokens |
| Invoermodaliteiten | Tekst en afbeeldingen |
| Uitvoermodaliteit | Tekst |
| Productie-API-naam | deepseek-flash |
| Denkmodes | Denk- en niet-denkmodi |
| API-functies | JSON-uitvoer, tool-aanroepen, Responses API, Anthropic API, prefix completion, FIM completion |
| Open gewichten | Uitgebracht op Hugging Face |
Hoe werkt DeepSeek V4.1 Flash: Causal-Encoder-Decoder
Traditionele uitsluitend-decoder-taalmodellen gebruiken in wezen dezelfde grote stack voor promptverwerking en tokengeneratie. DeepSeek V4.1 Flash wijst verschillende actieve capaciteit toe aan die fasen.
Tijdens de inputfase verwerkt het model de prompt met een actieve footprint van 8B. Deze fase kan de aangeleverde tekst- of afbeeldingscontext efficiënt onderzoeken omdat het volledige antwoord nog niet is gegenereerd. Tijdens de outputfase activeert het model 16B parameters en gaat het door met causale generatie, token voor token. Het ontwerp bespaart dus compute bij het encoderen van de prompt, terwijl meer actieve capaciteit behouden blijft voor redenering en responsgeneratie.
DeepSeek heeft niet elk implementatiedetail gepubliceerd in de aankondiging, dus de veiligste omschrijving is functioneel: de architectuur is asymmetrisch, de input- en outputfasen gebruiken verschillende actieve-parameterbudgetten en het resulterende systeem vermindert geheugen- en kosten bij inferentie.
KV-cache-reductie
Het geheugeneffect is meetbaar. DeepSeek rapporteert 890 bytes globale KV-cache per token voor V4.1 Flash, vergeleken met 3.514 bytes voor V4 Flash, 48.068 bytes voor V3.2 en 389.120 bytes voor V1. De V4.1-waarde is ongeveer 3,9 keer kleiner dan V4 Flash.
Voor agents met lange context is dit belangrijker dan één benchmark. Een kleinere KV-cache vermindert de druk op hogebandbreedtegeheugen (HBM) terwijl een request actief is en verlaagt de hoeveelheid state die naar tragere opslag verplaatst moet worden. DeepSeek zegt dat V4.1 Flash grofweg een kwart van de HBM- en een achtste van de SSD-capaciteit nodig heeft van het voorgaande model voor vergelijkbare cacheworkloads.
Functies van DeepSeek V4.1 Flash
Native multimodale invoer
V4.1 Flash accepteert afbeeldingen als onderdeel van de hoofdmodel-API. Dit vervangt de eerdere splitsing tussen de tekst-only V4 Flash en het experimentele V4 Flash Vision-endpoint. Ontwikkelaars kunnen nu documentbegrip, grafiekanalyse, screenshotinterpretatie en visuele-agentworkflows bouwen tegen dezelfde productiemodelfamilie.
Redeneren met lange context
De officiële API-specificatie behoudt een contextvenster van 1M tokens en staat tot 384K outputtokens toe. Dat maakt het model geschikt voor repository-schaal coderen, analyse van meerdere documenten, langlopende agentsessies en workflows die een grote toolgeschiedenis moeten behouden.
Productie-API-functies
Het model ondersteunt denk- en niet-denkmodi, gestructureerde JSON-uitvoer, tool-aanroepen, de Responses API, een Anthropic-compatibele interface, chat-prefix completion en FIM completion in niet-denkmodus. Deze mogelijkheden maken V4.1 Flash een directe productievervanger voor veel V4 Flash-agent- en codingworkloads.
Open gewichten
DeepSeek heeft de V4.1 Flash-gewichten en een technisch rapport vrijgegeven. De release verbetert de reproduceerbaarheid, maar het model blijft extreem groot: de aankondiging van DeepSeek vraagt organisaties die geïnteresseerd zijn in grote implementaties om te plannen voor ongeveer 2.000 GPU’s plus een storagecluster.
Benchmarkprestaties van DeepSeek V4.1 Flash
De officiële resultaten veranderen de eerdere inschatting dat V4.1 geen benchmarkbewijs had. DeepSeek biedt nu een brede tabel die kennis, wiskunde, coderen, terminalagents, cybersecurity, automatisering en multimodale agenttaken omvat.
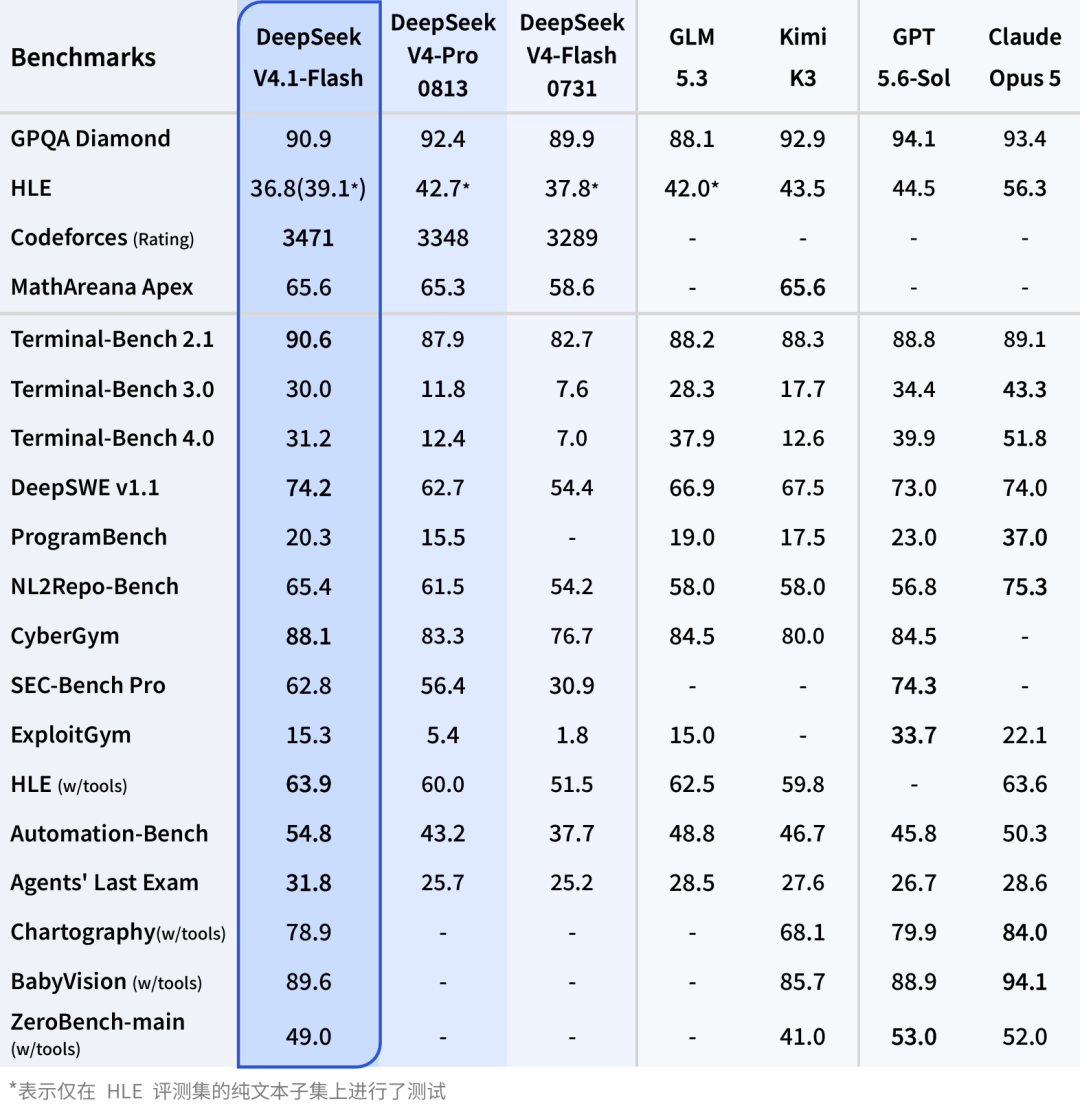
| Benchmark | DeepSeek V4.1 Flash | V4 Pro 0813 | V4 Flash 0731 |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Codeforces-rating | 3471 | 3348 | 3289 |
| MathArena Apex | 65.6 | 65.3 | 58.6 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| CyberGym | 88.1 | 83.3 | 76.7 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
Over deze geselecteerde acht benchmarks verslaat V4.1 Flash V4 Pro 0813 op zeven tests en V4 Flash 0731 op alle acht. De grootste winsten zitten in software-engineering en agents: DeepSWE stijgt met 11,5 punten ten opzichte van V4 Pro en 19,8 ten opzichte van V4 Flash, terwijl Automation-Bench met respectievelijk 11,6 en 17,1 punten verbetert.
De resultaten vragen nog om zorgvuldige interpretatie. V4.1 Flash scoort onder V4 Pro op GPQA Diamond, en de volledige officiële grafiek laat zien dat Claude Opus 5 en GPT-5.6 Sol voorlopen op Terminal-Bench 3.0. Een nuttige conclusie is dat V4.1 Flash de efficiëntie-capaciteitsbalans van DeepSeek materieel verbetert; de benchmarktabel bewijst geen universeel leiderschap over elke taak.
DeepSeek V4.1 Flash API-prijzen
DeepSeek gebruikt piek- en dalurenbilling. Piekuren zijn 01:00–04:00 en 06:00–10:00 UTC, maandag t/m vrijdag; alle andere perioden, inclusief weekenden, vallen onder het dalurent tarief. De huidige prijsdocumentatie stelt dat dalurentarieven de helft van de piektarieven zijn.
| Prijs per 1M tokens | V4.1 Flash daluren | V4.1 Flash piek | V4 Pro 0813 daluren | V4 Pro 0813 piek |
|---|---|---|---|---|
| Cache-hit-invoer | $0.003 | $0.006 | $0.022 | $0.044 |
| Cache-miss-invoer | $0.15 | $0.30 | $0.66 | $1.32 |
| Uitvoer | $0.60 | $1.20 | $1.98 | $3.96 |
De besparing is substantieel. Voor een workload met 100 miljoen cache-miss-invoertokens en 10 miljoen outputtokens kost V4.1 Flash ongeveer $21 buiten piekuren of $42 tijdens piekuren. Dezelfde tokenmix kost bij de gepubliceerde V4 Pro 0813-tarieven ongeveer $85.80 buiten piekuren of $171.60 tijdens piekuren. V4.1 Flash is in dit voorbeeld ongeveer 75.5% goedkoper.
Promptcaching vergroot het voordeel voor agents die systeeminstructies, repositorycontext of documenten herhaaldelijk hergebruiken. Het V4.1-tarief voor cache-hit is in beide billingperioden 50 keer lager dan het tarief voor cache-miss.
DeepSeek V4.1 Flash vs V4 Flash vs V4 Pro
| Dimensie | DeepSeek V4.1 Flash | DeepSeek V4 Flash | DeepSeek V4 Pro |
|---|---|---|---|
| Totaal aantal parameters | 552B | 284B | 1.6T |
| Geactiveerde parameters | 8B input / 16B output | 13B | 49B |
| Architectuurfocus | Asymmetrische input/output-efficiëntie | Lichtgewicht V4 MoE | Maximale V4-capaciteit |
| Native visuele ondersteuning | Ja | Afzonderlijke Vision Exp-variant | Nee |
| Contextvenster | 1M | 1M | 1M |
| Maximale output | 384K | 384K | 384K |
| API-status op DeepSeek | Huidig productiemodel | Uitgefaseerd; oude naam routeert naar V4.1 Flash | Gepland om naar V4.1 Flash te routeren vanaf 14 september 2026 |
| Beste toepassing | Algemene agents, coderen, vision, hoge throughput | Alleen voor migratiecompatibiliteit | Bestaande Pro-workloads tijdens transitie |
V4.1 Flash heeft meer totale parameters dan V4 Flash, maar kan goedkoper zijn in gebruik omdat de inputfase slechts 8B parameters activeert en een veel kleinere KV-cache gebruikt. Vergeleken met V4 Pro activeert het veel minder parameters, terwijl het Pro op de meeste van de hierboven geselecteerde agent- en coding-benchmarks overtreft.
API-toegang en migratie
DeepSeek’s productiemodelnaam is deepseek-flash. Bestaande toepassingen kunnen de OpenAI-compatibele basis-URL https://api.deepseek.com of de Anthropic-compatibele basis-URL https://api.deepseek.com/anthropic.
- Werk de modelnaam bij naar
deepseek-flash. - Behoud de bestaande DeepSeek-basis-URL en authenticatiemethode.
- Test denkmodus, tool-aanroepen, visuele invoer, latentie en tokengebruik opnieuw met productieprompts.
- Monitor legacy-aliassen:
deepseek-v4-flashendeepseek-v4-flash-vision-exprouteren nu naar V4.1 Flash, terwijldeepseek-v4-progepland staat om vanaf 14 september 2026 naar V4.1 Flash te routeren totdat een toekomstige V4.1 Pro-versie verschijnt.
Voor CometAPI-gebruikers is de DeepSeek V4.1 API in CometAPI nu live naast de bestaande DeepSeek V4 Flash API. Bevestig vóór het overschakelen van productieverkeer de definitieve modelnaam, prijzen en aliasmapping in het CometAPI-dashboard, omdat externe providers kunnen afwijken van DeepSeek’s officiële API-benamingen en tarieven.
Wie zou DeepSeek V4.1 Flash moeten gebruiken?
V4.1 Flash is zeer geschikt voor coding-agents, repositoryanalyse, terminalautomatisering, multimodale documentworkflows, assistants met lange context en systemen met hoog volume die tools gebruiken. De benchmarkwinst concentreert zich in dezelfde workloads die het meest profiteren van lagere cachegeheugen- en lagere tokenprijzen.
Teams die al V4 Flash gebruiken, moeten dit als een directe migratiekandidaat beschouwen. Teams die V4 Pro gebruiken, moeten zorgvuldig testen, maar DeepSeek’s eigen benchmark- en prijsgegevens maken V4.1 Flash nu de meer economische standaard voor veel Pro-class workloads.
Zelf hosten is een andere afweging. Open gewichten maken een 552B-model niet lichtgewicht. Organisaties moeten de kosten van een grote GPU- en opslagimplementatie vergelijken met gehoste API-gebruik voordat ze zich vastleggen op lokale inferentie.
Beperkingen en open vragen
- De benchmarkresultaten komen uit DeepSeek’s officiële evaluatie-setup; onafhankelijke replicaties zijn nodig om prestaties te meten in verschillende harnesses en toolomgevingen.
- Native multimodale ondersteuning is bevestigd, maar applicatieteams moeten ondersteunde bestandsformaten voor afbeeldingen, tokenverantwoording en vision-gedrag valideren tegen de live API.
- Legacy-modelaliassen veranderen nu het model achter een bestaande naam, wat outputs kan wijzigen zonder codewijziging in de applicatie.
- V4.1 Flash verlaagt de infrastructuurvereisten ten opzichte van eerdere DeepSeek-modellen, maar implementatie met open gewichten vereist nog steeds aanzienlijke reken- en opslagcapaciteit.
- Het speciale V4.1-eindpunt en de definitieve prijzen van CometAPI moeten in de liveconsole worden bevestigd vóór productgebruik.
Eindoordeel
DeepSeek V4.1 Flash is een belangrijke architectuur- en productupdate. Het 552B MoE-model combineert een inputfase met 8B actieve parameters, een outputfase met 16B actieve parameters, native vision, een contextvenster van 1M tokens en een sterk gecomprimeerde KV-cache. Die ontwerpkeuzes vertalen zich in sterkere officiële coding- en agentbenchmarks bij veel lagere API-prijzen dan V4 Pro 0813.
De meest praktische verandering is consolidatie. V4.1 Flash brengt tekst, vision, redeneren, toolgebruik en lange contextwerking onder in één productiemodelnaam. Voor de meeste nieuwe DeepSeek-integraties is deepseek-flash nu het logische startpunt; V4 Pro wordt eerder een migratievergelijking dan de automatische keuze voor moeilijk werk.
FAQ
Is DeepSeek V4.1 Flash officieel uitgebracht?
Ja. Het is beschikbaar via de API van DeepSeek onder de modelnaam deepseek-flash, en DeepSeek heeft open gewichten en een technisch rapport vrijgegeven.
Is de tijdelijke V4.1-bèta-model-ID nog nodig?
Nee. deepseek-v4.1-flash-expires-on-0910 was een kortstondige bèta-identifier. Productieapplicaties moeten deepseek-flash gebruiken.
Hoeveel parameters heeft DeepSeek V4.1 Flash?
Het model heeft in totaal 552B parameters. Het activeert 8B parameters tijdens inputverwerking en 16B tijdens outputgeneratie.
Ondersteunt DeepSeek V4.1 Flash afbeeldingen?
Ja. Visuele invoer is native in het productiemodel, dus een apart V4 Flash Vision Exp-endpoint is niet langer vereist.
Is V4.1 Flash beter dan V4 Pro?
Het ligt voor op V4 Pro 0813 op de meeste door DeepSeek gepubliceerde vergelijkingen voor coderen, agents, automatisering en cybersecurity, maar V4 Pro blijft voor op GPQA Diamond. Teams moeten beide evalueren met hun eigen prompts vóór migratie.
Wat kost de API?
Tijdens piekuren zijn de tarieven per miljoen tokens $0.006 voor cache-hit-invoer, $0.30 voor cache-miss-invoer en $1.20 voor output. Tijdens daluren zijn de tarieven de helft daarvan.
Wat gebeurt er met de oude V4-modelnamen?
De legacy-namen deepseek-v4-flash en deepseek-v4-flash-vision-exp routeren naar V4.1 Flash. DeepSeek zegt dat deepseek-v4-pro vanaf 14 september 2026 ook naar V4.1 Flash zal routeren totdat V4.1 Pro wordt uitgebracht.
Kan ik DeepSeek V4.1 Flash gebruiken via CometAPI?
Ja. CometAPI biedt nu een live DeepSeek V4.1 API-eindpunt. Bevestig vóór productietraffic de exacte modelnaam, prijzen en ondersteunde functies in de CometAPI-console, aangezien derde partijen andere naamgevingen of tarieven kunnen hanteren dan de officiële DeepSeek-API.