Bouwen met CometAPIHeb je één API voor meerdere modellen nodig?Test de workflow in Playground en maak daarna een API-sleutel aan wanneer het model en de kosten passen bij je use case.
Google kondigde op 30 september 2026 Gemini 4 Argon aan als een frontiermodel voor complexe, langlopende workflows. De gepubliceerde resultaten vertonen een duidelijk patroon: sterke prestaties in professioneel kenniswerk, taken met lange context en geselecteerde software-engineeringevaluaties, met zwakkere resultaten op sommige terminal- en computergebruiks-benchmarks. Google introduceert het model via een gefaseerde uitrol. Afzonderlijk meldt CometAPI catalogustoegang per 1 oktober; controleer voor implementatie de accountgeschiktheid en voer een geslaagde testrun uit. Het nuttigste verhaal over prestaties is waar de winst optreedt.
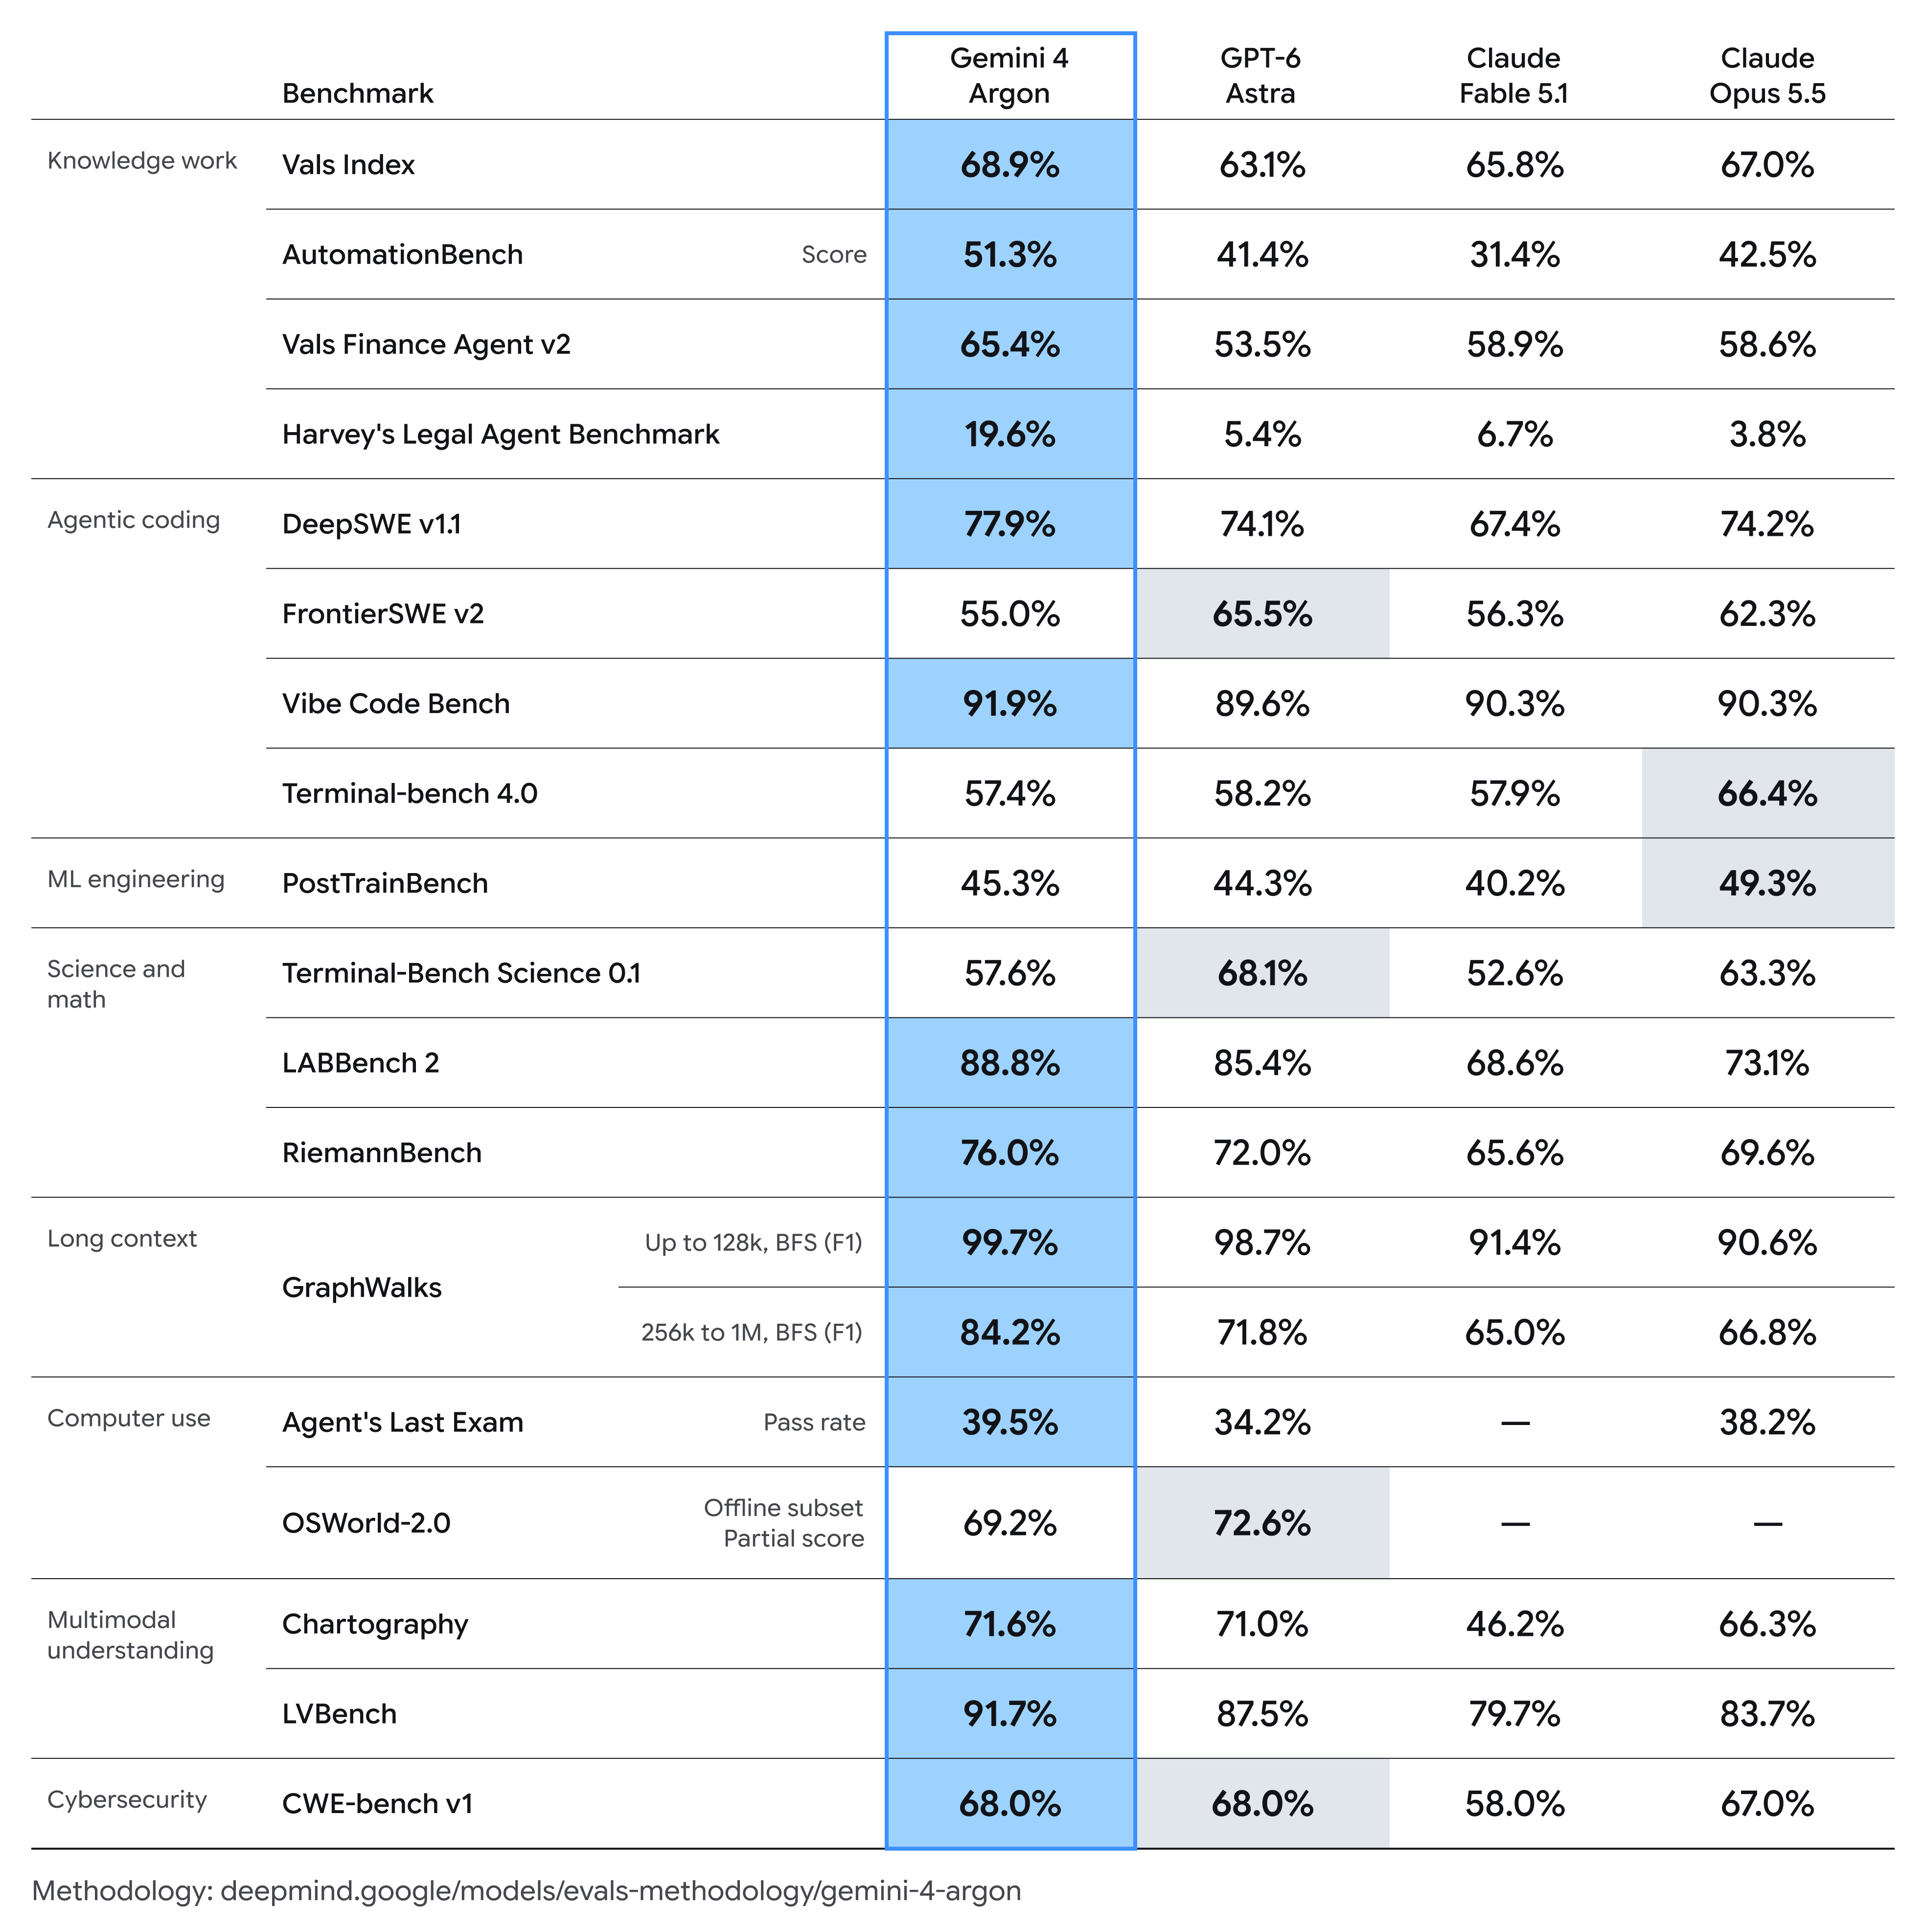
Argon behaalt 68,9% op de Vals Index, 65,4% op Vals Finance Agent v2, 77,9% op DeepSWE v1.1, 91,7% op LVBench en 84,2% op GraphWalks bij 256K–1M context. Tegelijkertijd blijft het achter op concurrerende frontiermodellen op FrontierSWE v2, Terminal-Bench 4.0, Terminal-Bench Science en OSWorld-2.0.
De resultaten pleiten voor een werkladingsspecifieke kijk op Argon. De sterkste scores clusteren rond professioneel kenniswerk, zeer lange-contexttaken en geselecteerde multimodale en software-engineeringevaluaties. Andere modellen behouden voordelen op verschillende terminal- en computergebruiks-tests.
Gecontroleerd op duidelijkheid, bronvermelding en actuele API-terminologie.
Key Takeaways
Gemini 4 Argon is het sterkst in enterprise-kenniswerk, lang-context redeneren, multimodaal begrip en diverse long-horizon coding-evaluaties.
De maximale outputlimiet van 1 miljoen tokens biedt meer ruimte voor lange redeneertrajecten; er is geen publieke specificatie voor inputcontext vastgelegd.
Argon leidt verschillende gepubliceerde kenniswerk- en lang-contextresultaten, maar GPT-6 Astra en Claude Opus 5.5 blijven voor op geselecteerde coding- en computergebruiks-evaluaties.
Benchmarkscores beschrijven specifieke configuraties van model en agent. Metrieken, inputcondities en evaluatie-instellingen zijn even belangrijk als de headline-percentages.
De uitrol van Google en CometAPI-toegang zijn afzonderlijke beschikbaarheidsclaims. Verifieer de actieve route, modelidentifier en accountgeschiktheid voordat je verkeer migreert.
What Is Gemini 4 Argon?
Gemini 4 Argon is het nieuwe frontier Gemini-model van Google DeepMind, gebouwd rond moeilijke workflows die redeneren over vele stappen vereisen in plaats van één kort promptantwoord.
Google’s officiële positionering benadrukt real-world software-engineering, enterprise-kenniswerk zoals juridisch en finance, defensieve cybersecurity, multimodaal begrip en langlopende agentische taken.
Dit is een belangrijk onderscheid ten opzichte van de recente Flash-releases. Gemini 3.8 Flash API in CometAPI is ontworpen als een goedkoper werkpaard voor agentische workloads op schaal. Argon vertegenwoordigt daarentegen het frontiersegment van Google’s stack en geeft prioriteit aan diepte en volgehouden uitvoering.
Model Specifications
Specification
Gemini 4 Argon
Developer
Google DeepMind
Announced
September 30, 2026
Model family
Gemini 4
Positioning
Frontier redeneren en long-horizon model
Maximum output
1,000,000 tokens
Long-context evaluation
Getest tot 256K–1M op GraphWalks
Public input context limit
Niet formeel gespecificeerd in een standaard publieke API-specificatietabel bij lancering
Multimodal understanding
Ja; omvat grafieken, documenten en evaluatie op lange video
Agentic coding
Ja
Computer use
Geëvalueerd
Cybersecurity
Gespecialiseerde defensieve capaciteiten
Google public API model ID
Niet aangekondigd in Google’s initiële publieke documentatie; CometAPI gebruikt gemini-4-argon als catalogus-id.
Output Budget and Trade-offs
Google kondigt voor Argon een maximale outputlimiet van 1 miljoen tokens aan, hoger dan de eerder aangehaalde 64K-limiet in de lanceringsaankondiging. Dit biedt ruimte voor langere redeneertrajecten. Het moet niet worden geïnterpreteerd als een gegarandeerd totaalbudget voor een hele agent-sessie met meerdere calls, of als bewijs dat elke taak verbetert.
Maximum output is niet hetzelfde als intelligentie. Een model meer outputtokens geven maakt het niet automatisch capabeler; het haalt slechts een potentiële bottleneck weg. Het model moet dat budget nog steeds productief gebruiken.
Er is ook een trade-off in kosten en latentie. Een model dat daadwerkelijk honderdduizenden tokens genereert, kan duur en traag zijn, zelfs als de nominale prijs per token aantrekkelijk lijkt.
Geselecteerde benchmarkresultaten gereproduceerd uit het artikel. Vergelijk modellen binnen elke rij; metriek en evaluatiecondities verschillen. Deze grafiek vervangt het decoratieve verloop en vertegenwoordigt geen onafhankelijk testen.
Een maximale outputlimiet en een inputcontextvenster beschrijven verschillende capaciteiten. Het GraphWalks-evaluatiebereik is bewijs over de geteste inputs, geen vervanging voor een publieke API-specificatie.
How Does Gemini 4 Argon Perform on Benchmarks?
De prestatietabel van Google DeepMind bestrijkt agent-workflows, professioneel kenniswerk en multimodale taken. De waarden hieronder reproduceren die gepubliceerde vergelijking. Ze meten taakprestatie, niet token-throughput of responstijd; “—” betekent dat er geen resultaat is gerapporteerd in deze vergelijking.
Benchmark
Gemini 4 Argon
GPT-6 Astra
Claude Fable 5.1
Claude Opus 5.5
Evaluation conditions
Vals Index
68.9%
63.1%
65.8%
67.0%
Vals AI
AutomationBench
51.3%
41.4%
31.4%
42.5%
Private set; Zapier leaderboard
Vals Finance Agent v2
65.4%
53.5%
58.9%
58.6%
Vals AI
Harvey's Legal Agent
19.6%
5.4%
6.7%
3.8%
Vals AI
DeepSWE v1.1
77.9%
74.1%
67.4%
74.2%
mini-swe harness; mixed sources
FrontierSWE v2
55.0%
65.5%
56.3%
62.3%
Proximal leaderboard
Vibe Code Bench
91.9%
89.6%
90.3%
90.3%
Vals AI leaderboard
Terminal-Bench 4.0
57.4%
58.2%
57.9%
Officiële benchmarkvergelijking van Google’s Gemini 4 Argon
Tenzij anders vermeld, gebruiken Argon-resultaten één poging en de hoogste thinking-instelling. Resultaten van andere modellen komen doorgaans van provider-rapporten, met benchmark-specifieke uitzonderingen. LVBench gebruikt 1 FPS voor Gemini, 800 frames voor GPT-6 Astra, 300 voor Fable 5.1 en 600 voor Opus 5.5. Deze inputs zijn niet identiek, dus vergelijk de gerapporteerde configuraties in plaats van elke rij als een gecontroleerde herhaling te behandelen.
Evaluation Conditions and Limitations
De tabel is nuttig, maar moet niet worden geïnterpreteerd als een onafhankelijke, universele leaderboard.
De officiële methodologie identificeert door providers gerapporteerde concurrerende resultaten als standaard, met benchmark-specifieke leaderboard- en zelfberekende uitzonderingen.
De hoogste benchmarkinstelling weerspiegelt mogelijk niet een standaard productie-inferentieconfiguratie.
Een headline-benchmarkscore onthult op zichzelf niet het tokenverbruik, toolcalls, retries, verstreken tijd of menselijke interventie.
Voor productiesystemen is een betere maat vaak de kosten per succesvol voltooide taak in plaats van prijs per token of één benchmarkpercentage.
Which Workload Is Gemini 4 Argon Best For?
Knowledge Work Performance
Het duidelijkste patroon in Argons resultaten verschijnt in professioneel, meerstaps kenniswerk.
Op de Vals Index bereikt Argon 68,9%, vergeleken met 67,0% voor Claude Opus 5.5. Het numerieke verschil is bescheiden, maar het patroon wordt duidelijker in gespecialiseerde workflows.
Vals Finance Agent v2: 65,4%, 6,5 punten boven de sterkste concurrent in Google’s tabel.
AutomationBench: 51,3%, 8,8 punten boven Claude Opus 5.5.
Harvey's Legal Agent Benchmark: 19,6%, vergeleken met 6,7% voor het op één na hoogste gerapporteerde model.
Het prestatieprofiel suggereert dat Argon het meest profiteert wanneer het model informatie moet verzamelen, state moet behouden, over meerdere fasen moet redeneren en een professioneel artefact moet produceren in plaats van alleen een gesloten vraag te beantwoorden.
De lage absolute legal-agent score is ook belangrijk. Een score van 19,6% op zichzelf onthult niet hoeveel criteria of volledige workflows faalden. De nuttige conclusie is dat Argon een grote relatieve verbetering toont op deze evaluatie, terwijl het resultaat geen betrouwbare automatisering van juridisch werk vaststelt.
Long-Context Reasoning
Argons meest in het oog springende voordeel kan de 256K–1M-versie van GraphWalks zijn.
Gemini 4 Argon: 84,2%
GPT-6 Astra: 71,8%
Claude Opus 5.5: 66,8%
Claude Fable 5.1: 65,0%
Dat is een voordeel van 12,4 punten ten opzichte van het dichtstbijzijnde model in de gepubliceerde vergelijking.
Het verschil is veel kleiner bij kortere contextlengten: op GraphWalks tot 128K scoort Argon 99,7% en GPT-6 Astra 98,7%. Dit suggereert dat Argon minder scherp degradeert dan de vergeleken modellen op deze specifieke zeer lange-contextevaluatie.
Wat Google niet heeft bekendgemaakt, is voldoende architectuurinformatie om dit verschil toe te schrijven aan een specifiek attentionmechanisme, retrievalsysteem, trainingsrecept of strategie tijdens inferentie. Claims zoals “Gemini 4 introduceert een nieuwe attention-architectuur” zouden daarom verder gaan dan het publieke bewijs.
Coding Performance
De officiële benchmarktabel ondersteunt geen simpel ja.
Argon presteert uiterst goed op sommige vormen van coderen en verliest duidelijk op andere. Op DeepSWE v1.1 haalt het 77,9%, versus 74,2% voor Claude Opus 5.5 en 74,1% voor GPT-6 Astra. De Vibe Code Bench-score is ook sterk met 91,9%.
FrontierSWE v2: 55,0% voor Argon vs. 65,5% voor GPT-6 Astra.
Terminal-Bench 4.0: 57,4% voor Argon vs. 66,4% voor Claude Opus 5.5.
Terminal-Bench Science 0.1: 57,6% voor Argon vs. 68,1% voor GPT-6 Astra.
Deze splitsing is belangrijk voor ontwikkelaars. Argon lijkt vooral sterk wanneer coderen een lange engineeringworkflow wordt met substantiële context en planning, terwijl terminalzware uitvoering meer competitief blijft. Een repository-migratiebenchmark en een interactieve terminalbenchmark moeten niet worden behandeld als uitwisselbare maatstaven voor “codeervaardigheid.”
Defensive Cybersecurity
Cybersecurity is een kerngebied voor implementatie. Google’s positionering inzake defensieve cyberbeveiliging omvat autonome kwetsbaarheidsdetectie, validatie en patching. Dit is een providercapaciteitsclaim; het hieronder genoemde CWE-bench-resultaat meet kwetsbaarheidsremediatie op zijn eigen evaluatie.
Op CWE-bench v1 scoort Argon 68%, gelijk met GPT-6 Astra en iets voor op Claude Opus 5.5 met 67%.
Google benadrukt ook sterkere waarborgen tegen misbruik, indirecte prompt-injectie, risicovol agentgedrag en compromittering van de uitvoeringsomgeving. Dit maakt Argon net zozeer een agent-beveiligingsrelease als een conventionele modelupgrade.
Multimodal Understanding
Argon scoort 71,6% op Chartography en 91,7% op LVBench voor begrip van lange video. Het LVBench-resultaat ligt 4,2 procentpunten boven GPT-6 Astra in Google’s tabel. Omdat de modellen verschillende framesampling-configuraties ontvangen, is dit een vergelijking van de gerapporteerde setups in plaats van een pure model-alleenvoorsprong.
Dit is relevant omdat veel professionele workflows niet alleen tekst zijn. Een financieel onderzoeksagent moet mogelijk een grafiek bekijken; een enterprise-assistent kan rapporten, PDF’s en screenshots combineren; een video-analysesysteem moet gebeurtenissen over een lange sequentie behouden in plaats van individuele frames onafhankelijk te verwerken.
Argons combinatie van multimodale perceptie en volgehouden redeneren is daarom relevanter dan multimodale ondersteuning alleen.
Science and Mathematics Performance
De resultaten zijn gemengd maar over het algemeen sterk. Argon bereikt 88,8% op LABBench 2 en 76,0% op RiemannBench, voor op de vergeleken modellen in Google’s tabel. Op Terminal-Bench Science 0.1 daarentegen haalt GPT-6 Astra 68,1% vergeleken met 57,6% voor Argon.
Dat verschil wijst op een breder patroon: Argon lijkt sterker in het redeneren over wetenschappelijke informatie dan in elke vorm van toolgedreven wetenschappelijke uitvoering.
Computer-Use Performance
Op Agent's Last Exam scoort Argon een binaire pass-rate van 39,5%, voor GPT-6 Astra met 34,2% en Claude Opus 5.5 met 38,2%. Op de offline subset van OSWorld-2.0 is de partiële score 69,2%, onder de 72,6% van GPT-6 Astra. De OSWorld-waarde is geen voltooide-taaksuccespercentage, en ontbrekende Claude-inzendingen impliceren geen nulcapaciteit.
De huidige data toont dus geen algeheel voordeel bij computergebruik. Voor productie-implementatie moeten benchmark-scores worden aangevuld met taakniveau-tests van navigatienauwkeurigheid, mislukte klikken, retryfrequentie, onbedoelde acties, tijd tot voltooiing en menselijke correctiegraad.
Gemini 4 Argon vs GPT-6 Astra and Claude
Dimension
Gemini 4 Argon
GPT-6 Astra
Claude Opus 5.5
Claude Fable 5.1
Knowledge work
Zeer sterk
Sterk
Zeer sterk
Sterk
Long-context benchmark
Sterkste gepubliceerde resultaat
Sterk
Gematigd–sterk
Gematigd
Long-horizon coding
Zeer sterk
Zeer sterk
Zeer sterk
Sterk
Terminal coding
Competitief
Sterk
Sterkst in geselecteerde test
Competitief
Scientific terminal agents
Competitief
Sterkst in geselecteerde test
Sterk
Competitief
Multimodal understanding
Zeer sterk
Zeer sterk
Sterk
Competitief
Computer use
Competitief
Sterk
Gemengd / beperkte vergelijking
Beperkte vergelijking
Cybersecurity
Gelijk aan top op CWE-bench v1
Gelijk aan top
Zeer dichtbij
Lager
Argon valt in deze vergelijking op door lang-context, documentzware en professionele agent-werklasten. Ontwikkelaars kunnen het vergelijken met GPT-6 Astra, Claude Opus 5.5 en Claude Fable 5.1 via CometAPI.
Performance-based selection
De kwalitatieve labels hierboven vatten de geselecteerde benchmarktabel samen, geen universele ranking. Geef Argon de voorkeur voor een pilot wanneer het werk lijkt op zijn leidende evaluaties; test Astra en Opus op terminalzware workloads voordat je een default selecteert.
Specifications and deployment constraints
Deze prestatievergelijking stelt geen architectuurvoordeel of algemene prijs-prestatiewinnaar vast. Argons aantal parameters en architectuur zijn niet gespecificeerd in de beoordeelde lanceringsmaterialen van Google. De publieke input-contextlimiet vereist officiële API-documentatie. CometAPI rapporteert een gemini-4-argon-route; bevestig de ondersteunde parameters en accounttoegang onafhankelijk van Google’s bredere uitrol. Vergelijk per route de limieten en de daadwerkelijke taakkosten vóór implementatie.
How Can Developers Access Gemini 4 Argon Through CometAPI?
CometAPI rapporteert het model als beschikbaar onder gemini-4-argon. Gebruik het accountdashboard om een API-sleutel aan te maken, selecteer die identifier in de playground en voer een testrun uit vóór integratie. Het OpenAI-compatibele voorbeeld gebruikt de basis-URL https://api.cometapi.com/v1. Bevestig de door het model ondersteunde endpoint en parameters in de accountdocumentatie; een catalogusbadge op zichzelf verifieert geen geslaagde call.
Maak een CometAPI-account en genereer een API-sleutel in het dashboard.
Kies gemini-4-argon en valideer een representatief verzoek in de playground.
Configureer de compatibele client met de CometAPI basis-URL, je sleutel en de modelidentifier; bevestig het ondersteunde requestschema en de billing vóór implementatie.
CometAPI and official pricing
Google kondigde introductieprijzen aan van $2 per miljoen inputtokens en $10 per miljoen outputtokens, met gecachte input geprijsd op 95% korting op het inputtarief. Na de introductieperiode zijn de aangekondigde tarieven $4 input en $20 output per miljoen tokens. Dit zijn Google’s aangekondigde tarieven, niet de prijzen van CometAPI of een bevestiging van directe algemene API-toegang.
Billing basis
Gemini 4 Argon API in CometAPI
Google official announcement
Comparison
Input / 1M tokens
$3.20
$4.00 na introductieperiode
20% onder aangekondigd na-introtarief
Output / 1M tokens
$16.00
$20.00 na introductieperiode
20% onder aangekondigd na-introtarief
Conclusion
Het benchmarkprofiel van Gemini 4 Argon is interessanter dan een simpele leaderboard-claim.
De sterkste resultaten in deze vergelijking clusteren rond professioneel kenniswerk, lange context en volgehouden agentuitvoering. Dit patroon is nuttig voor werklastselectie, maar identificeert niet de onderliggende architectuur of bewijst welk mechanisme de winst veroorzaakte.
De gerapporteerde finance-, legal-, long-video- en software-engineeringresultaten ondersteunen een gerichte pilot voor die werklasten. Of hetzelfde voordeel in productie aanhoudt, hangt af van de inputmix, het agentframework, de inferentie-instellingen en de verificatie-eisen.
Tegelijkertijd tonen de resultaten dat prestaties van frontiermodellen steeds meer gespecialiseerd worden. Argon kan DeepSWE aanvoeren terwijl het achterblijft op FrontierSWE; Agent's Last Exam aanvoeren terwijl het achterblijft op OSWorld; en LABBench aanvoeren terwijl het achterblijft op Terminal-Bench Science. Deze benchmarks benadrukken verschillende delen van een agentsysteem.
Voor ontwikkelaars is de belangrijkste les dat modelselectie in toenemende mate op het niveau van de werklast moet plaatsvinden in plaats van op merk of familie.
FAQ
How should developers validate Gemini 4 Argon on their own workloads?
Bouw een representatieve set taken met expliciete acceptatiecriteria. Houd tools, tijdslimieten, inputvoorbereiding en retry-beleid vergelijkbaar tussen modellen. Registreer voltooide taken, totale tokens, verstreken tijd en menselijke correctie. Begin met een kleine pilot en analyseer faalcases voordat je productie-verkeer routeert.
Can Gemini 4 Argon's benchmark percentages be averaged into one score?
Nee. De tabel combineert verschillende metriek, waaronder F1, pass rates en partiële scores. Gebruik taakspecifieke criteria in plaats van alle percentages te middelen.
Should a Gemini 4 Argon agent always use its full output budget?
Nee. Kies het kleinste geteste budget dat voldoet aan je kwaliteits- en betrouwbaarheidsvereisten. De maximale outputlimiet is een plafond, geen doel.
How should teams evaluate Gemini 4 Argon access through CometAPI?
Begin met een beschikbaarheidscontrole op accountniveau en een klein verzoek via de gedocumenteerde CometAPI-route. Meet responskwaliteit, latentie, limieten en gefactureerde tokens, en pas dezelfde acceptatietests toe als voor alternatieve modellen. Behandel CometAPI’s toegangclaim los van Google’s bredere uitrol, en houd routing configureerbaar totdat de route aan je vereisten voldoet.
66.4%
Self-test / leaderboard
PostTrainBench
45.3%
44.3%
40.2%
49.3%
v1.1; OpenCode; 10h; one H100
Terminal-Bench Science 0.1
57.6%
68.1%
52.6%
63.3%
Verifier timeout ×6
LABBench 2
88.8%
85.4%
68.6%
73.1%
Linux tools; internet
RiemannBench
76.0%
72.0%
65.6%
69.6%
Surge leaderboard
GraphWalks up to 128K
99.7%
98.7%
91.4%
90.6%
BFS F1; 650 items
GraphWalks 256K–1M
84.2%
71.8%
65.0%
66.8%
BFS F1; 200 items
Agent's Last Exam
39.5%
34.2%
—
38.2%
Binary pass; ALE-Claw; 5h
OSWorld-2.0
69.2%
72.6%
—
—
Offline partial score; best of 3 runs
Chartography
71.6%
71.0%
46.2%
66.3%
No tools; Surge leaderboard
LVBench
91.7%
87.5%
79.7%
83.7%
No tools; model-specific frame sampling
CWE-bench v1
68.0%
68.0%
58.0%
67.0%
pass@1; pass@4 breaks ties
Gemini 4 Argon-prestaties: benchmarks en limieten - CometAPI