Bouwen met CometAPIHeb je één API voor meerdere modellen nodig?Test de workflow in Playground en maak daarna een API-sleutel aan wanneer het model en de kosten passen bij je use case.
Gemini 4 Argon prijzen en toegang: API-kosten, tariefplannen en realistische workloads
Vergelijk de API-prijzen van Gemini 4 Argon, de toegang tot Pro en Ultra, benchmarks, CometAPI-integratie en de kosten per request vóór en na de promotie.
Deon GoodwinOnderzoeksteam voor AI-modellen en API
Gemini 4 Argon is niet inbegrepen in de Gemini API Free tier, en een Google AI Pro-abonnement alleen biedt geen Argon-API-toegang. Google AI Ultra kan toegang bieden via geselecteerde Gemini-producten, terwijl betaalde API-gebruikskosten apart worden gefactureerd. CometAPI biedt een onafhankelijke API-route zonder dat elke eindgebruiker een Google AI Pro- of Ultra-abonnement nodig heeft. De gepubliceerde ongecachete input- en outputtarieven zijn $1.60 en $8 per miljoen tokens, vergeleken met Google’s introductietarieven Standard van $2 en $10.
Toegang en headline-tarieven van aanbieders geverifieerd op 16 oktober 2026.
Key Takeaways
Introductieprijs: $2 / 1M inputtokens en $10 / 1M outputtokens; vanaf 1 december verdubbelen de tarieven.
Gecachte input: 95% implicit-cachekorting op in aanmerking komende hits; cacheminimum is 4.096 prompttokens.
Gecontroleerd op duidelijkheid, bronvermelding en actuele API-terminologie.
Gemini 4 Argon prijzen en toegang: API-kosten, tariefplannen en realistische workloads - CometAPI
Outputfacturatie omvat thinking-tokens; input, thinking en zichtbare output delen een budget van 1.048.576 tokens.
Scheid Gemini-appabonnementen van Antigravity-entitlements en betaalde API-toegang. Het ontbreken van een model in één product bewijst niet dat elke toegangsroutes onbeschikbaar is.
CometAPI biedt een onafhankelijke API-route met lagere gepubliceerde ongecachete input- en outputtarieven. Applicaties kunnen meerdere eindgebruikers bedienen via één CometAPI-account zonder dat elke gebruiker een Google AI Pro- of Ultra-abonnement hoeft te onderhouden; quotum-, saldo-, tarief- en gelijktijdigheidslimieten op accountniveau blijven van toepassing.
What Are Google’s Current Gemini 4 Argon Access Limits?
De eerste beslissing is waar je Argon nodig hebt: een interactieve app, een lokale coding-omgeving of een API-integratie. Google’s developer-access announcement onderscheidt betaalde Gemini API-toegang van Ultra-abonneetoegang in AI Studio en Antigravity. Interpreteer een Antigravity-abonnementsbeperking niet als een vereiste om Ultra voor elke betaalde API-werkstroom te kopen.
Voor een API-toepassing biedt CometAPI een alternatieve account- en facturatieroute. Dit kan nuttig zijn wanneer je Argon naast andere modellen wilt evalueren zonder daarvoor een Google-consumentenabonnement te kopen. Het verandert de toegangsrechten binnen Google’s eigen apps niet, en het moet niet als onbeperkt gebruik worden omschreven.
How Much Does Gemini 4 Argon API Cost?
Google’s Standard Gemini 4 Argon-tarieven gelden tot en met 30 november 2026, met hogere tarieven vanaf 1 december. Alle bedragen hieronder zijn USD per miljoen tokens tenzij anders vermeld. Batch, Flex en Priority hebben aparte tarieven.
Facturatiecategorie (USD / 1M tokens)
Google Standard: t/m 30 nov 2026
Google Standard: v.a. 1 dec 2026
Gemini 4 Argon API in CometAPI: t/m 30 nov 2026
Input
$2.00
$4.00
$1.60
Gecachte input
$0.10
$0.20
$0.08
Output, inclusief thinking
$10.00
$20.00
$8.00
CometAPI-tarieven zijn geverifieerd op 14 oktober 2026. De gepubliceerde input- en outputprijzen liggen 20% onder Google’s introductietarieven Standard. De gecachte-inputwaarde komt uit de kostencalculator van CometAPI; bevestig het actuele accounttarief en cachegeschiktheid voordat je hierop vertrouwt. Google’s prijswijziging in december zal de toekomstige CometAPI-tarieven bepalen; controleer de tarieven in je CometAPI-account bij het budgetteren.
Tegen deze tarieven kosten 200.000 ongecachete inputtokens plus 60.000 factureerbare outputtokens $0.80 via CometAPI, vergeleken met $1.00 via Google tijdens de introductieperiode. Dit rekenvoorbeeld sluit tools en retries uit.
What Does Gemini 4 Argon Cost Across Realistic Workloads?
De volgende scenario’s zijn rekenvoorbeelden, geen gemeten modelgebruik. Input is ongecached; output omvat zowel thinking als zichtbare tekst. Een coding-agentaanvraag met 200.000 inputtokens en 60.000 factureerbare outputtokens kost $1.00 tijdens de introductieperiode en $2.00 daarna. Dezelfde workload 1.000 keer herhaald kost $1.000 of $2.000, exclusief retries, tools en belastingen.
Voorbeeldaanvraag
Ongecachete inputtokens
Factureerbare outputtokens
Introprijs
Standard-prijs
Kort assistentantwoord
5K
1K
$0.02
$0.04
Documentanalyse
100K
10K
$0.30
$0.60
Complexe coding-agent
200K
60K
$1.00
$2.00
Research-werkstroom
500K
100K
$2.00
$4.00
Long-decode-aanvraag
100K
500K
$5.20
$10.40
Formule: Cost = (ongecachete inputtokens × inputtarief + gecachte inputtokens × gecachet tarief + factureerbare outputtokens × outputtarief) / 1.000.000. De bovenstaande voorbeelden zijn illustratief en gaan uit van geen caching.
How Can You Reduce Gemini 4 Argon API Costs?
Implicit Caching and Reused Prompt Prefixes
Caching verlaagt de bestedingen voor hergebruikte input, niet de volledige verzoekprijs. Voor het 200K-input / 60K-outputvoorbeeld verlaagt een volledige in aanmerking komende input-cachehit de introductie-invoerkosten van $0.40 naar $0.02. De totale tokenkosten worden $0.62 in plaats van $1.00: een reductie van 38%, ondanks de 95% inputkorting. Als 50% van de inputtokens uit cache wordt geleverd, kost hetzelfde verzoek $0.81: 100.000 gecachte inputtokens × $0.10 / 1M + 100.000 ongecachete inputtokens × $2 / 1M + 60.000 factureerbare outputtokens × $10 / 1M = $0.01 + $0.20 + $0.60. Hier verwijst 50% specifiek naar inputtokenvolume. Beschouw dit als scenario’s en gebruik geobserveerd gebruik van gecachte tokens voor forecasting.
Google schakelt impliciete caching in voor prompts van ten minste 4.096 tokens en ondersteunt geen expliciete cachecreatie voor Argon. Behoud herbruikbare promptprefixen, maar budgetteer voor ongecachete input totdat geobserveerde cachehits een lagere schatting rechtvaardigen.
Thinking Levels and Output Spending
Een kort zichtbaar antwoord kan nog steeds aanzienlijke outputkosten meedragen omdat thinking factureerbaar is. Begin met medium denkniveau, test vervolgens lagere en hogere niveaus op representatieve taken. Volg zowel kwaliteit als totale outputconsumptie; kies het laagste redeneerniveau dat aan je acceptatiecriteria voldoet.
Omdat thinking en zichtbare output de responslimiet delen, kan een lage max_output_tokens-waarde onvoldoende ruimte overlaten voor het eindantwoord. Vergelijk succesvolle taakvoltooiing op elk denkniveau voordat je de outputcap verlaagt.
Operational Controls for Gemini 4 Argon Costs
Gebruik realistische outputlimieten en vermijd onnodig lange generaties.
Hergebruik gedeelde promptprefixen wanneer in aanmerking voor impliciete caching.
Routeer eenvoudige taken naar goedkopere modellen en bewaar Argon voor moeilijke gevallen.
Log totale factureerbare tokens, fouten, retries en kosten per geslaagde taak.
Evalueer de economie tegen post-promotietarieven voordat je je vastlegt op een grootschalige uitrol.
How Can You Access Gemini 4 Argon?
Kies Gemini-apptoegang voor persoonlijk interactief werk en een betaalde API-route voor applicaties en geautomatiseerde agents. Argon is uitgesloten van de Gemini API Free tier; een Google AI Pro-abonnement alleen verleent geen Argon-API-toegang. Pro- en Ultra-app-entitlements staan los van API-tokenfacturatie, en Ultra is niet vereist voor de betaalde Gemini API.
Toegangsroute
Argon-toegang
Facturatie / entitlement
Gemini-app
In aanmerking komende Pro- en Ultra-abonnees
Abonnement en applimieten
Google AI Studio
In aanmerking komende Ultra-abonnees of betaalde API-gebruikers
Afhankelijk van toegangsroutes
Gemini API
In aanmerking komende betaalde projecten
Gebruik gebaseerde API-facturatie
Google Antigravity
In aanmerking komende Ultra-abonnees
Productspecifieke entitlement
CometAPI
Ondersteunde CometAPI-accounts
CometAPI-tarieven en voorwaarden
Direct Gemini 4 Argon API Integration
Ontwikkelaars kunnen Gemini 4 Argon rechtstreeks integreren via een in aanmerking komend betaald Gemini API-project. De model-ID is gemini-4-argon. Deze route is bedoeld voor applicaties, geautomatiseerde agents en productie-werkstromen die directe toegang tot Google’s API, gebruiksgebaseerde facturatie en officiële API-functionaliteit vereisen.
De Gemini API Free tier omvat Argon niet. Google AI Pro-apptoegang verschaft ook niet automatisch API-toegang of API-credits. Ontwikkelaars moeten facturatie en geschiktheid configureren voor het project dat aan hun API-referenties is gekoppeld.
Authenticatie-, facturatie- of geschiktheidsfouten moeten worden opgelost voor het project dat de sleutel bezit voordat je opnieuw probeert; het wijzigen van een consumentenabonnement alleen configureert API-facturatie niet.
CometAPI Access for Gemini 4 Argon
Ontwikkelaars kunnen toegang krijgen tot de Gemini 4 Argon API in CometAPI via een apart account en een aparte API-sleutel. De praktische voordelen zijn onafhankelijke API-facturatie, toegang tot meerdere modellen via één provider en de hierboven vergeleken gepubliceerde input/outputtarieven. Deze route vereist niet dat Google AI Pro of Ultra als consumentenabonnement wordt aangeschaft.
Toegang op accountbasis is geen belofte van onbeperkte capaciteit. Bevestig modelbeschikbaarheid, saldo, tarief- en gelijktijdigheidslimieten, ondersteunde regio’s, caching, denkinstellingen en gebruiksrapportage voor je CometAPI-account. API-toegang ontgrendelt Argon evenmin binnen de Gemini-app of Antigravity.
Begin met een kleine aanvraag via de gekozen provider, verifieer de geretourneerde model- en usage-velden, stel vervolgens een bestedingslimiet in voordat je het verkeer opvoert.
Is Gemini 4 Argon Worth the Cost?
Gemini 4 Argon is een kandidaat voor veeleisend redeneren, coderen, research en long-contextwerk. De waarde hangt ervan af of het de succesvolle taakvoltooiing verbetert of retries voldoende reduceert om de tokenuitgaven te rechtvaardigen. Gebruik de specificaties en gepubliceerde benchmarks hieronder om workloads te identificeren om te testen, evalueer vervolgens kwaliteit en kosten met je eigen prompts, tools en toegangsroutes.
Gemini 4 Argon Specifications
Specificatie
Gemini 4 Argon
Model-ID
gemini-4-argon
Ontwikkelaar
Google DeepMind
Modeltype
Op redeneren georiënteerd multimodaal model
Gecombineerd venster voor input + thinking + output
Tot 1.048.576 tokens gecombineerd
Denkniveaus
Low / medium / high
Standaard denkniveau
Medium
Ondersteuning voor lange output
Achtergronduitvoering; maximum onderhevig aan gedeeld budget
Contextcache
Impliciet; in aanmerking komende prompts ≥ 4.096 tokens
Expliciete cache
Niet ondersteund
De limiet van een miljoen tokens wordt gedeeld door input, thinking en gegenereerde output. Op de Interactions API vereist genereren van meer dan 65.536 tokens zowel background=True als generation_config.max_output_tokens boven 65.536. Alleen background=True instellen verhoogt de standaard outputlimiet niet. De GenerateContent API ondersteunt ook client-side continuering voor lange decodering
Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5: Published Benchmarks
De volgende waarden komen overeen met Google’s gepubliceerde evaluatieresultaten. Het zijn door leveranciers gepubliceerde resultaten, samengesteld uit meerdere evaluatiebronnen, en geen nieuwe gecontroleerde vergelijking voor dit artikel.
Gepubliceerde benchmark
Gemini 4 Argon
GPT-6 Astra
Claude Opus 5.5
Vals Index
68.9%
63.1%
67.0%
AutomationBench
51.3%
41.4%
42.5%
Vals Finance Agent v2
65.4%
53.5%
58.6%
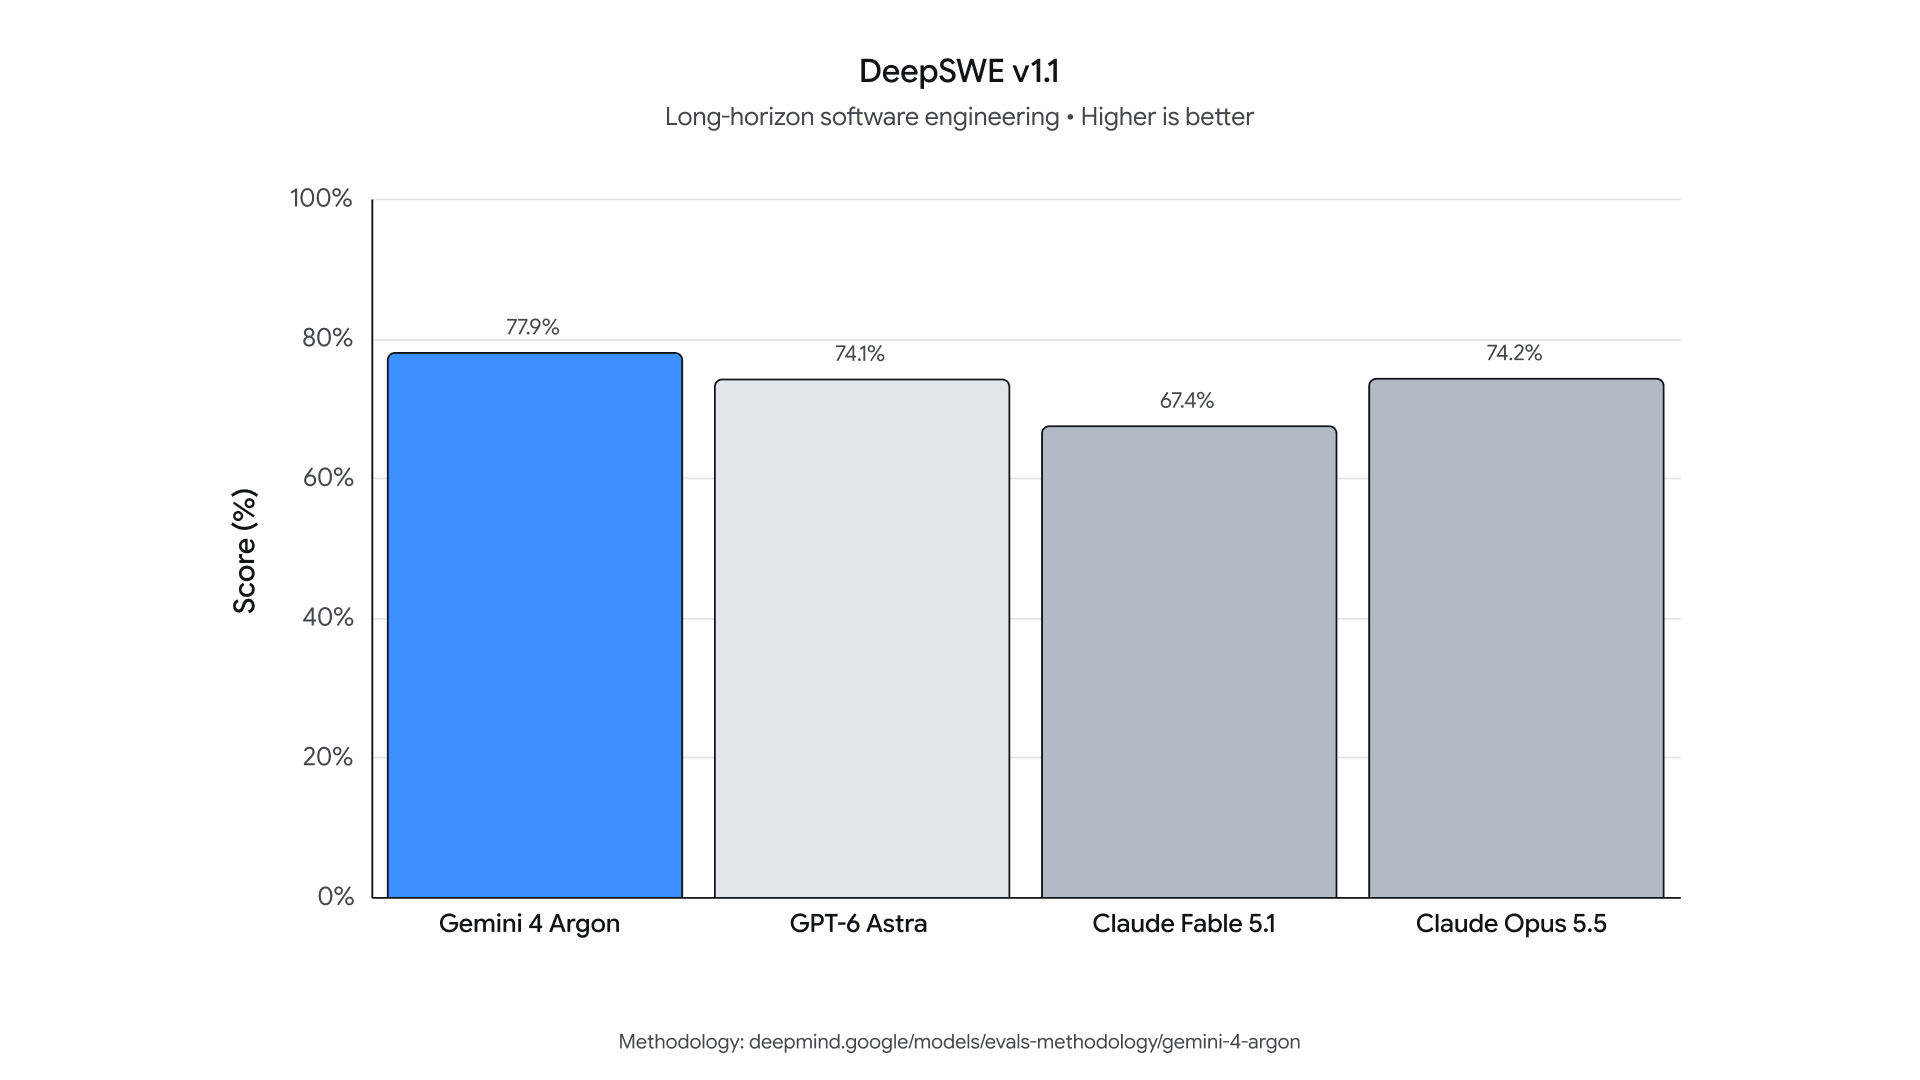
DeepSWE v1.1
77.9%
74.1%
74.2%
FrontierSWE v2
55.0%
65.5%
62.3%
Terminal-bench 4.0
57.4%
58.2%
66.4%
GraphWalks 256K–1M, BFS F1
84.2%
71.8%
66.8%
LVBench
91.7%
87.5%
83.7%
Evaluation Conditions and Comparability
Google’s evaluation methodology gebruikt de Gemini API op de hoogste thinking-instelling tenzij anders gespecificeerd, doorgaans met pass@1. DeepSWE gebruikt mini-swe voor Argon; concurrerende cijfers komen van leaderboards of system cards. GraphWalks 256K–1M gebruikt 200 problemen. LVBench draait zonder tools, met 1 FPS voor Gemini, 800 frames voor GPT-6 Astra en 600 voor Opus 5.5. Deze verschillen beperken de directe vergelijkbaarheid.
Google’s originele DeepSWE v1.1-grafiek toont Gemini 4 Argon (77.9%), GPT-6 Astra (74.1%), Claude Fable 5.1 (67.4%) en Claude Opus 5.5 (74.2%), van links naar rechts. De bovenstaande tabel selecteert drie van deze modellen; de officiële afbeelding bevat alle vier.
Performance Implications for Gemini 4 Argon Users
Interpretatie: Argon leidt in de geselecteerde Vals Index-, AutomationBench-, financieel-agent- en long-context-rijen; het leidt niet in FrontierSWE of Terminal-bench. Omdat evaluatieharnassen en prompts kunnen variëren, gebruik deze resultaten als directioneel bewijs en voer workloadspecifieke tests uit.
Voor inkoop, meet de kosten van een geslaagde taak naast nauwkeurigheid, latency, retries en tokenverbruik. Een hogere gepubliceerde score bewijst niet dat de productiekosten lager zijn onder jouw prompts, tools of toegangsroutes.
Choose Gemini 4 Argon or Cheaper Model
Test Argon op moeilijke redenerings-, coding- en long-contexttaken waar minder retries of een hogere voltooiingsgraad de hogere tokenuitgaven kunnen rechtvaardigen. Test voor routinematige classificatie, extractie en grootschalige samenvattingen eerst goedkopere modellen.
Vergelijk de totale kosten per geslaagde taak, inclusief denk-tokens, cachegebruik, toolcalls en retries. Kies het model en de toegangsroutes die aan je kwaliteitsvereisten voldoen tegen aanvaardbare kosten.
FAQ
Are Gemini 4 Argon Batch and Flex cheaper than Standard?
Google’s Argon Batch- en Flex-tarieven zijn $1 input en $5 output per miljoen tokens t/m 30 november 2026, oplopend naar $2 en $10 daarna. Gecachte input is $0.05, oplopend naar $0.10. Dit zijn afzonderlijke verwerkingsopties, dus valideer hun operationele beperkingen ten opzichte van je workload voordat je een Standard-integratie vervangt.
Schat Standard-, Batch- en Flex-gebruik afzonderlijk in met de toepasselijke tarieven per optie en tel vervolgens de subtotalen op voor een gemengd-workloadbudget.
Do Gemini 4 Argon token estimates include search charges?
Nee. Tokenrekenwerk alleen sluit apart gefactureerde services uit. Google’s Search grounding charge is $14 per 1.000 queries na de gedeelde maandelijkse toewijzing van 5.000 verzoeken voor Gemini 3 en nieuwere modellen. Een ingediend verzoek kan meer dan één zoekquery uitvoeren, dus volg daadwerkelijk grounding-gebruik afzonderlijk in plaats van aan te nemen dat één gebruikersprompt gelijk is aan één factureerbare query.
How should I budget Gemini 4 Argon across the price change?
Splits de voorspelde tokenconsumptie in de introductie- en standaardperiode en pas vervolgens de tarieven per periode toe. Bijvoorbeeld, 10 miljoen ongecachete inputtokens plus 1 miljoen outputtokens kosten $30 tegen introductietarieven Standard of $60 daarna. Als de helft van dat volume in elke periode valt, is de tokenraming $45. Tel tools en retrykosten apart op en gebruik post-promotietarieven voor een steady-state budget.
Why can a Gemini 4 Argon answer stop before it is complete?
De outputcap omvat thinking evenals zichtbare tekst. Een veeleisende prompt kan die ruimte uitputten voordat het eindantwoord voltooid is. Voor lange antwoorden gaat achtergronduitvoering door in stappen tot voltooiing of de geconfigureerde limiet; het vereist nog steeds een toereikende max_output_tokens-waarde. Controleer voltooiingsstatus en usage, pas vervolgens de redeneerdiepte of de cap aan in plaats van herhaaldelijk dezelfde ondergekapte aanvraag te sturen.
Conclusion
Kies Gemini 4 Argon-toegang per workflow en vergelijk vervolgens de kosten van het voltooien van een nuttige taak. Google’s app- en Antigravity-entitlements verschillen van betaalde API-toegang. CometAPI biedt een aparte API-route met gepubliceerde input/outputprijzen die 20% onder Google’s introductietarieven Standard liggen, waardoor het een praktische optie is voor een kleine, gebudgetteerde evaluatie. Valideer accountlimieten en vereiste functies, volg thinking-tokens en retries, en schaal pas op wanneer kwaliteit en totale kosten aan je behoeften voldoen.