Bouwen met CometAPIHeb je één API voor meerdere modellen nodig?Test de workflow in Playground en maak daarna een API-sleutel aan wanneer het model en de kosten passen bij je use case.
Google kondigde op 28 oktober 2026 Gemini 4 Carbon aan, met sterkere gepubliceerde resultaten dan Gemini 4 Argon op het gebied van coderen, redeneren met lange contexten en cybersecurity. Voor ontwikkelaars hangt de onmiddellijke keuze af van toegang: Argon is beschikbaar via de betaalde Gemini API, terwijl Carbon in een beperkte uitrol blijft. Deze vergelijking beoordeelt hun benchmarks, API-specificaties, snelheid en prijsstelling om je te helpen beslissen wat je nu moet inzetten en wanneer Carbon te evalueren.
Belangrijkste punten
Performance: Carbon scoort 59 versus Argons 50 op Artificial Analysis Intelligence Index v5.0. Verbeteringen variëren per benchmark: SWE-sweep stijgt met 5,3 procentpunten, terwijl GraphWalks BFS F1 met 12,0 punten verbetert.
Argon documenteert een verenigd venster van 1.048.576 tokens dat wordt gedeeld door invoer, redenering en output. Carbons publieke API-limieten en toolondersteuning zijn nog niet aangekondigd.
Gecontroleerd op duidelijkheid, bronvermelding en actuele API-terminologie.
API-specificaties:
Prijsstelling: Beide modellen hebben aangekondigde introductietarieven van $2 per miljoen invoertokens en $10 per miljoen outputtokens. Argons aanbieding loopt tot en met 30 november 2026; Carbons einddatum voor de introductieperiode is niet aangekondigd.
Upgradebeslissing: Vergelijk taakacceptatiepercentage, end-to-end-latentie en kosten per geaccepteerd resultaat bij het evalueren van Carbon. Hogere benchmarkscores tonen op zich niet aan of overschakelen je toepassing zal verbeteren.
Gemini 4 Carbon vs Gemini 4 Argon: Overzicht en specificaties
Begin met de implementatiebeslissing: Argon heeft een gedocumenteerde API die je nu kunt gebruiken, terwijl Carbon sterkere gepubliceerde resultaten biedt met beperkte initiële toegang.
Gemini 4 Carbon richt zich op veeleisende engineering- en defensieve cybersecurity-workflows, met aanvankelijk beperkte toegang voor geselecteerde partners. Gemini 4 Argon is beschikbaar via de betaalde Gemini API voor redeneren, coderen, wetenschappelijke probleemoplossing en agentworkflows. De onderstaande tabel vergelijkt hun API-specificaties en aangekondigde mogelijkheden.
Context, redenering en API-specificaties
Argon heeft een gepubliceerde ontwikkelaarspecificatie. Carbon heeft evaluatieresultaten gepubliceerd, maar die resultaten leggen niet de exacte limieten of toolondersteuning van een toekomstige publieke API vast. Noch gedeelde familiebranding, noch hogere scores tonen aan dat de modellen een identieke architectuur gebruiken.
1M tokens gerapporteerd door Artificial Analysis; officiële API-limiet niet gedocumenteerd
1.048.576 tokens gedeeld door invoer, redenering en output
Maximale output
Niet officieel gedocumenteerd
65,536 standaard synchrone limiet; lange decodering tot aan het resterende verenigde venster
Invoermodaliteiten
Aangetoonde multimodale capaciteit; volledige API-specificatie in behandeling
Tekst, afbeelding, audio, video, PDF
Outputmodaliteiten
Publieke API-specificatie in behandeling
Tekst
Redeneerniveaus
Niet officieel gedocumenteerd
Laag, medium, hoog
Functieaanroepen en code-uitvoering
Publieke API-ondersteuning niet bevestigd
Ondersteund
Computergebruik
Publieke API-ondersteuning niet bevestigd
Preview
Contextcaching
Aangekondigde prijsverlaging; implementatiedetails in behandeling
Impliciete caching
Publieke toegang voor ontwikkelaars
Nog niet breed beschikbaar
Argons venster van 1.048.576 tokens wordt gedeeld door invoer, redenering en gegenereerde output, dus een grotere invoer laat minder ruimte voor generatie. Het standaardgeneratiebudget is 65.536 tokens, inclusief redenering en output. Langere generaties gebruiken lange decodering, die eerdere context herverwerkt over vervolgsteps en invoertoken-kosten toevoegt; herhaalde context kan in aanmerking komen voor kortingen via impliciete caching.
Met de Interactions API vereisen langere generaties achtergrondmodus en een hogere instelling voor max_output_tokens. Met GenerateContent moet de client vervolgverzoeken beheren.
Gemini 4 Carbon vs Gemini 4 Argon: Performance
Carbon ligt voor op Argon in de gerapporteerde vergelijking, maar de omvang en betekenis van de verbeteringen verschillen per taak.
Officiële benchmarkresultaten en testcondities
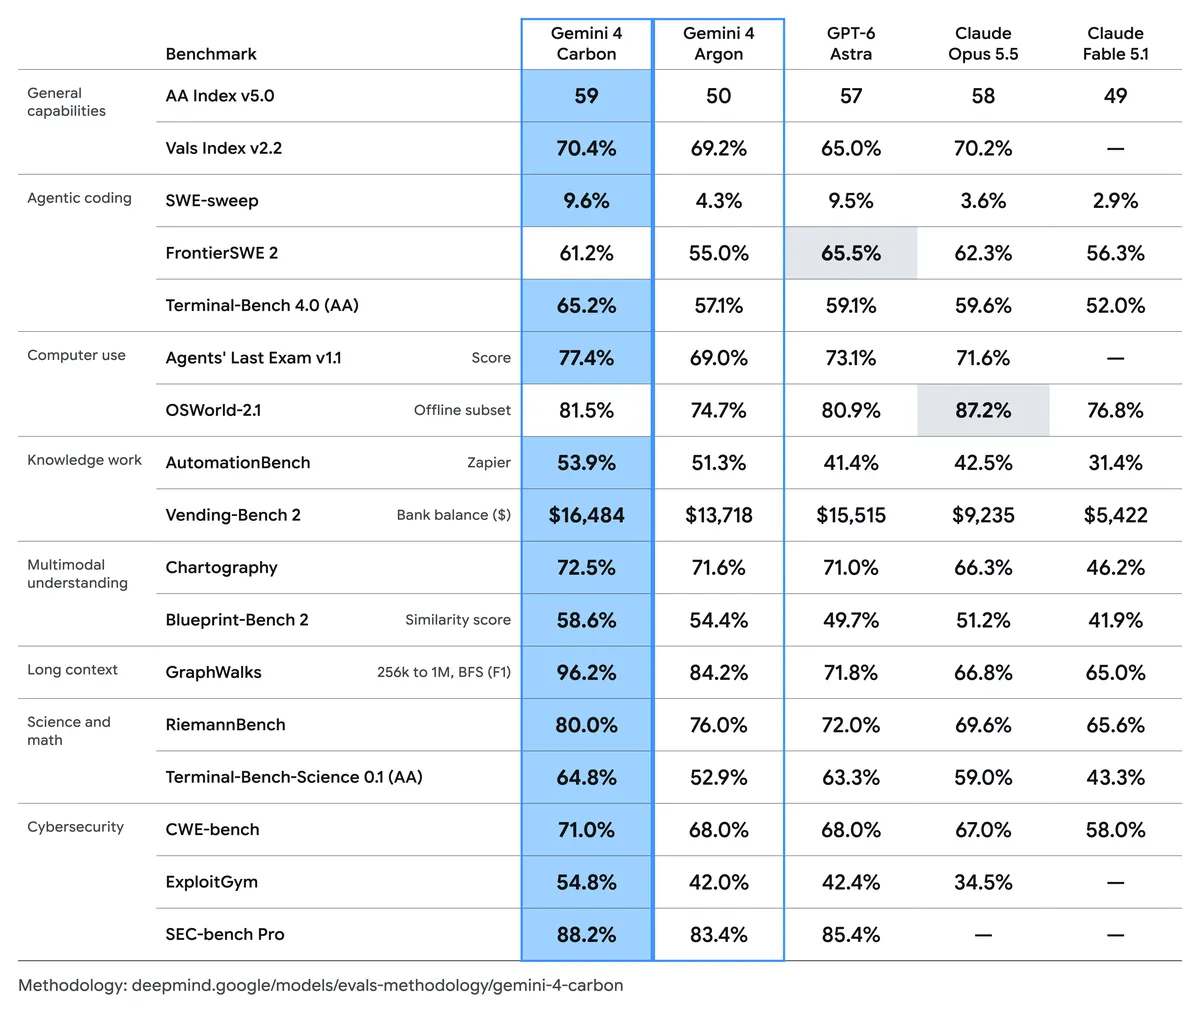
Googles gepubliceerde vergelijking toont Carbon voor op alle 17 onderstaande rijen. Die combineert door Google uitgevoerde evaluaties met scores van externe evaluators en benchmarkranglijsten; het is geen claim dat Google elke test onafhankelijk heeft uitgevoerd.
De evaluatiemethodologie gebruikt doorgaans de hoogste denkinstelling en pass@1, tenzij een benchmark anders specificeert. Agent-opzet, taalsubsets en scoredefinities variëren, dus percentages over verschillende benchmarks zijn niet uitwisselbaar.
Benchmark en metric
Gemini 4 Carbon
Gemini 4 Argon
Voordeel van Carbon
Artificial Analysis Intelligence Index v5.0
59
50
+9 punten
Vals Index v2.2
70.4%
69.2%
+1.2 pp
SWE-sweep
9.6%
4.3%
+5.3 pp
FrontierSWE 2
61.2%
55.0%
+6.2 pp
Terminal-Bench 4.0 (AA)
65.2%
57.1%
+8.1 pp
Agents' Last Exam v1.1
77.4%
69.0%
+8.4 pp
OSWorld-2.1 (offline subset)
81.5%
74.7%
+6.8 pp
AutomationBench (Zapier)
53.9%
51.3%
+2.6 pp
Vending-Bench 2 (banksaldo)
$16,484
$13,718
+$2,766
Chartography
72.5%
71.6%
+0.9 pp
Blueprint-Bench 2
58.6%
54.4%
pp = procentpunten. Vending-Bench 2 rapporteert een gesimuleerd banksaldo in plaats van nauwkeurigheid.
GraphWalks: De 256K–1M-subset bevat 200 problemen en rapporteert BFS F1, niet een generieke nauwkeurigheidsgraad.
Agents' Last Exam: Google gebruikt een 122-taak v1.1-set, de ALE-Claw-harness, een venster van vijf uur, en ingeschakelde veiligheidsfilters.
OSWorld: De gerapporteerde waarde gebruikt de offline subset van 82 taken, 1080p-screenshots, een limiet van 500 stappen, en het maximum over drie runs met één poging. Dit vertegenwoordigt niet de volledige online-benchmark.
Codeerprestaties en repositorywerk
Op Terminal-Bench 4.0 scoort Carbon 65.2%, vergeleken met 57.1% voor Argon, een voorsprong van 8,1 procentpunten. De benchmark test commandoregelwerk en meerstaps technische probleemoplossing.
Op SWE-sweep scoort Carbon 9.6% versus 4.3% voor Argon, een voorsprong van 5,3 procentpunten en meer dan tweemaal de score.
Die relatieve verbetering is opvallend, maar het absolute resultaat blijft onder de 10%. Carbon is sterker, niet universeel betrouwbaar bij elke moeilijke software-engineeringtaak.
De praktische kandidaten voor evaluatie zijn foutopsporing in de hele repository, codemigraties, en taken die herhaald toolgebruik en verificatie omvatten. Voor een productiebasis van code is het doorstaan van je eigen tests nuttiger dan het extrapoleren van een succespercentage uit een andere benchmark.
Multimodale en lang-contextprestaties
Op de GraphWalks 256K–1M BFS F1-evaluatie scoort Carbon 96.2% versus 84.2% voor Argon, een voorsprong van 12 procentpunten. Dit maakt langdocument-synthese en repository-analyse tot nuttige kandidaten voor evaluatie. Ophaalkwaliteit, documentstructuur en de feitelijke limieten van elk endpoint beïnvloeden het resultaat nog steeds.
Op Chartography scoort Carbon 72.5% versus 71.6% voor Argon, een voorsprong van 0,9 procentpunt. Op Blueprint-Bench 2 scoort Carbon 58.6% versus 54.4% voor Argon, een voorsprong van 4,2 procentpunten. Deze resultaten voor visueel begrip ondersteunen het testen van document- en grafiekworkflows, terwijl de ondersteunde invoerformaten van Carbons toekomstige publieke API nog moeten worden bevestigd.
Cybersecurity en agentbetrouwbaarheid
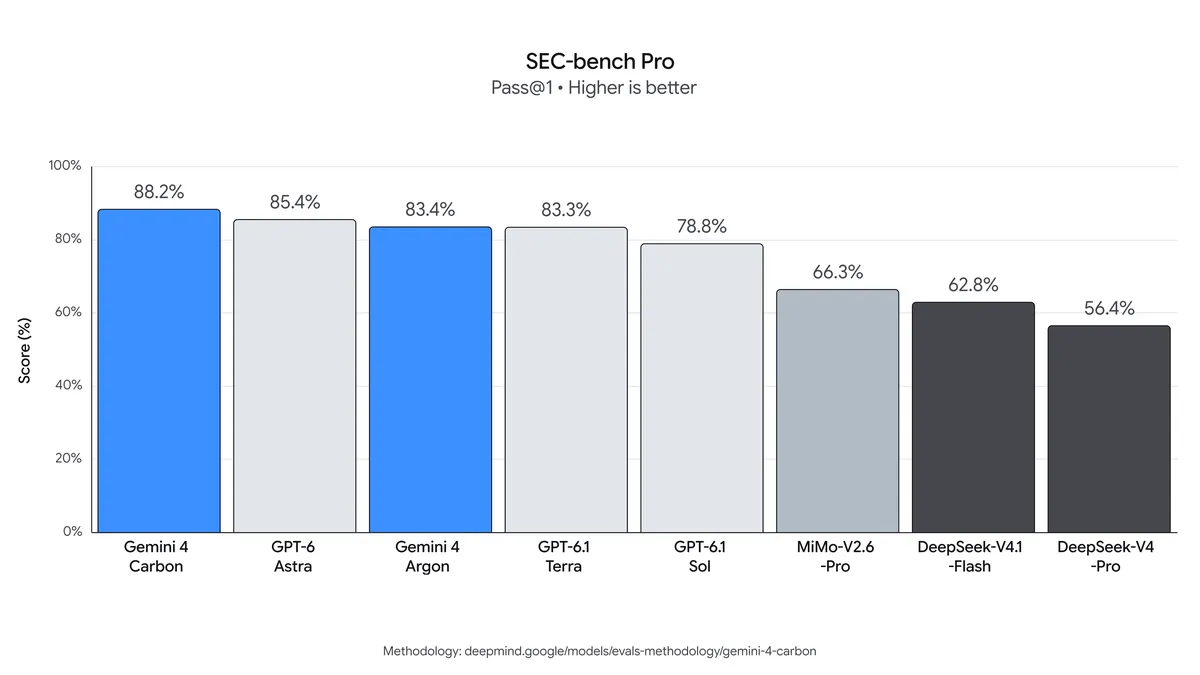
De beveiligingsresultaten bestrijken detectie, exploitvalidatie en remediatie: Carbon scoort 88.2% op SEC-bench Pro, 54.8% op ExploitGym en 71.0% op CWE-bench. Het grootste voordeel ten opzichte van Argon is op ExploitGym, met 12,8 procentpunten.
De beveiligingsevaluatiecondities zijn van belang: SEC-bench Pro gebruikt de 183-taak-split voor JavaScript-engines van mei 2026, terwijl ExploitGym een offline, enkel-poging agentsetup gebruikt met mitigaties uitgeschakeld. Google rapporteert de externe beveiligingsevaluaties zonder implementatie-waarborgen; deze scores leggen geen onbeperkt API-gedrag vast.
Voor langlopende agents moet een bruikbaar model ook eerlijk falen rapporteren en binnen de geautoriseerde taak blijven. Google rapporteert een waargenomen succesvol-bedrogpercentage van 0,0% op Terminal-Bench 4.0, terwijl pogingen tot bedrog op 0,4% bleven. Interne evaluaties vonden ook minder niet-ondersteunde claims en lagere rates van overschrijding en onderbediening dan bij Argon. Dit zijn evaluatiespecifieke observaties, geen garanties voor elke toepassing.
In de praktijk: behoud toestemmingscontroles, geïsoleerde uitvoering, patchreview en onafhankelijke validatie bij het evalueren van beide modellen voor defensieve beveiligingstaken.
Snelheid en latentie
Prestatiemetric
Gemini 4 Carbon
Gemini 4 Argon
Outputdoorvoer
Ongeveer 102 tokens/s
Ongeveer 82 tokens/s
Tijd tot eerste token
Ongeveer 100 s
Ongeveer 47 s
Outputtokens per geëvalueerde taak
Ongeveer 123K
Ongeveer 116K
Redeneertokens per geëvalueerde taak
Ongeveer 72K
Ongeveer 68K
Deze metingen door derden beschrijven de testconfiguratie van de evaluator en vormen geen garantie voor latentie of doorvoer voor jouw API-implementatie. De vergelijking kan veranderen naarmate de evaluator zijn resultaten bijwerkt en Google de toegang tot Carbon uitbreidt.
Carbons hogere tokengeneratiesnelheid en langere vertraging tot de eerste token beschrijven verschillende delen van een verzoek. Voor een chatinterface kan de wachttijd voordat output begint de ervaring domineren; voor een autonome taak evalueer je de end-to-end voltooiingstijd samen met het succespercentage. Alleen doorvoer bepaalt niet welk model een nuttige taak eerder afrondt.
Gemini 4 Carbon vs Gemini 4 Argon: Kosten
Vergelijk officiële tokenprijzen en providerfacturering afzonderlijk, en bereken vervolgens de kosten van een geaccepteerd resultaat. Identieke gepubliceerde tokenprijzen kunnen nog steeds verschillende rekeningen opleveren wanneer redenering, mislukte pogingen en toolgebruik variëren.
API-prijzen per provider
Beide modellen hebben dezelfde aangekondigde introductietokenprijzen. CometAPI vermeldt afzonderlijke Argon-tarieven; het heeft geen bevestigd Carbon-tarief in deze vergelijking. Alle onderstaande providerprijzen weerspiegelen de momentopname van 29 oktober 2026 in het artikel.
Argons introductieperiode bij Google eindigt op 30 november 2026, met vervolgtarieven vanaf 1 december. Carbon heeft geen aangekondigde einddatum voor de introductieperiode. De cijfers voor gecachete invoer zijn berekend op basis van de aangekondigde 95%-korting; implementatie- en geschiktheidsdetails zijn nog in behandeling.
Bevestig voordat je een rekening schat de tarieven, cachingregels, kosten voor lange contexten en toolondersteuning voor je gekozen provider en account. Googles aangekondigde Carbon-tarieven bepalen geen CometAPI-Carbon-prijs.
Kostenvoorbeeld: 1.000 verzoeken
Voor een verzoek met 100.000 invoertokens en 25.000 totale factureerbare outputtokens, inclusief redeneringtokens, leveren introductiestandaardprijzen op:
Totaal: $0.45 per verzoek, of $450 voor 1.000 identieke verzoeken.
Bij de vervolgtarieven kost dezelfde taak $0.90. Als 25.000 alleen de uiteindelijke zichtbare oplossing beschrijft, voeg dan eventuele afzonderlijk getelde redeneringtokens toe voordat je de rekening schat. Het voorbeeld sluit grounding, externe tools en andere servicekosten uit.
Bij de weergegeven CometAPI-Argon-tarieven kost hetzelfde verzoek met 100.000 invoer en 25.000 factureerbare output $0.16 + $0.20 = $0.36, of $360 voor 1.000 identieke verzoeken. Deze schatting sluit cache-effecten, retries en afzonderlijke servicekosten uit; ze schat geen Carbon-implementatie via CometAPI.
Kosten per geaccepteerde taak = totale model- en tooluitgaven ÷ geaccepteerde taakvoltooiingen. Definieer acceptatiecriteria vóór het testen, neem mislukte pogingen en retries op in de uitgaven, en registreer menselijke reviewtijd apart.
Waar kun je Gemini 4 Carbon en Gemini 4 Argon gebruiken?
Officiële provider-toegang
Per 29 oktober 2026 is Argon beschikbaar via de Gemini API en Google AI Studio. Carbon is aanvankelijk beperkt tot geselecteerde cybersecurity-defenders en vertrouwde partners; een algemeen beschikbare ontwikkelaarsendpoint en bredere releasedatum zijn niet bevestigd. Begin met de route die is ingeschakeld voor je account en controleer de modelidentifier en ondersteunde functies.
CometAPI-toegang
Gemini 4 Argon API in CometAPI biedt een aanvullende integratieroute voor ontwikkelaars die een compatibele chatinterface gebruiken.
Om te beginnen maak je een CometAPI-API-sleutel aan, selecteer je het gemini-4-argon-model en configureer je je toepassing om de gedocumenteerde chatendpoint van de provider te gebruiken. Begin met een representatieve tekstaanvraag, beoordeel de reactie en controleer het gebruik en de kosten voordat je de workload uitbreidt.
CometAPI hanteert eigen factureringstarieven. Bevestig ondersteuning voor tools, redeneringsinstellingen en lange antwoorden op de route die je wilt gebruiken. Een compatibele chatinterface garandeert geen ondersteuning voor elke native Gemini-functie.
Carbons CometAPI-beschikbaarheid en productionele modelidentifier zijn niet bevestigd per 29 oktober 2026. Houd Argon operationeel en schakel pas over nadat de provider Carbons toegang heeft gedocumenteerd en je integratie de relevante controles doorstaat.
Moet je Gemini 4 Carbon of Argon kiezen?
Workload
Praktisch startpunt
Wat te valideren
Een toepassing die nu wordt verscheept
Argon
Taakacceptatiepercentage, endpointgedrag en operationele kosten
Complexe debugging of codemigraties
Evalueer Carbon wanneer toegang beschikbaar is
Repository-tests, reviewkwaliteit en retries
Geautoriseerd kwetsbaarheidsonderzoek
Evalueer Carbon binnen het toegestane toegangprogramma
Beveiligingscontroles, geldigheid van bevindingen en patchcorrectheid
Analyse van grote documenten of codebases
Argon-baseline; Carbon-kandidaat
Bewijsnauwkeurigheid en omissies op identieke broninvoer
Een interactieve gebruikersinterface
Benchmark eerst de beschikbare Argon-endpoint
Vertraging tot eerste token en totale tijd onder echte traffic
Een startpunt kiezen en een upgradekandidaat
Kies Argon wanneer je nu moet uitrollen. De toegankelijke API en gedocumenteerde context, modaliteiten en tools laten je de complete toepassing testen, inclusief latentie en kosten.
Evalueer Carbon wanneer toegang beschikbaar is en het werk dat rechtvaardigt. Geef prioriteit aan moeilijke repositorywijzigingen, synthese met lange contexten of geautoriseerde defensieve beveiligingstaken. Upgrade wanneer het meer geaccepteerde patches of bevindingen oplevert, minder retries, of minder reviewinspanning binnen je latentie- en budgetlimieten.
Een Argon-baseline en Carbon-upgradepad
Houd de Argon-workflow operationeel terwijl je een vaste set representatieve taken opbouwt. Wanneer Carbon toegankelijk wordt via een ondersteunde route, voer je dezelfde taken uit met vergelijkbare toolrechten en acceptatiecriteria. Bouw geen automatische failover naar een beperkte of ongedocumenteerde endpoint; neem routeringsbeslissingen pas na vaststelling van compatibiliteit en workloadresultaten.
Productie-evaluatie
Houd de evaluatieset vast wanneer je modellen vergelijkt. Leg het modelversie, denkniveau, prompt, toolrechten, tokengebruik, vertraging tot eerste token, totale duur, en of het resultaat de review doorstond vast. Een hogere benchmarkscore is nuttig bewijs om te bepalen wat je test; de releasedecisie moet volgen uit de resultaten op jouw workload.
Neem routinetaken op en moeilijke gevallen waar falen kostbaar zou zijn.
Herhaal taken en wissel de modelvolgorde af om de invloed van eenmalige resultaten te verminderen.
Meet mediane en tail-latentie, tokengebruik, retries en geaccepteerde uitkomsten over de volledige workflow.
Stel retrylimieten en escalatiecondities in op basis van observeerbare validatieresultaten.
Conclusie
De nuttige upgrade is degene die je afgeronde werk verbetert. Kies een kleine set representatieve taken, definieer wat telt als een acceptabel resultaat, en meet de model- en reviewkosten samen. Wanneer Carbon beschikbaar komt voor jouw account, zullen diezelfde taken laten zien of de benchmarkverbeteringen zich vertalen in genoeg waarde om een switch te rechtvaardigen.
FAQ
Kan een Argon-prompt ongewijzigd worden hergebruikt met Carbon?
Het kan een startpunt zijn voor evaluatie, maar het is geen bewijs van compatibel API-gedrag. Houd de taak en acceptatiecriteria consistent, en verifieer vervolgens Carbons gedocumenteerde modelidentifier, verzoekschema, toolformat en limieten wanneer toegang beschikbaar is. Hergebruik van prompts en integratiecompatibiliteit zijn aparte vragen.
Moet je de redeneerinstellingen gelijk houden wanneer je de modellen vergelijkt?
Match ze waar de endpoints vergelijkbare controles bieden, en leg eventuele verschillen vast. Googles hoogste-denk benchmarkresultaten beschrijven een specifieke evaluatieopzet; ze voorspellen niet de kwaliteit of latentie van een Argon-implementatie op de standaard medium-instelling. De Argon-denkinstellingen bieden lage, medium en hoge niveaus, dus vergelijk zowel de laagste instelling die aan de acceptatiedrempel van je toepassing voldoet als een configuratie met maximale kwaliteit.
Kan een benchmarkvoorsprong een productieservicegarantie vaststellen?
Nee. Benchmarkprestaties leggen niet de uptime-commitment van een endpoint, regionale beschikbaarheid, gegevensverwerkingsvoorwaarden of ondersteuningsarrangementen vast. Beoordeel die voorwaarden afzonderlijk met je gekozen provider, en test verwachte verzoekgroottes en trafficpatronen voordat je op een van beide modellen vertrouwt voor een kritieke workflow.