
TL;DR
Claude Fable 5.1 heeft de sterkere benchmarkonderbouwing voor moeilijke autonome programmering en langetermijnwerk. GPT-5.6 Sol biedt lagere gewone tokenkosten, een brede native toolstack en een kortere tijd tot de eerste token in de onafhankelijke vergelijking bij maximale inspanning. De juiste standaardkeuze hangt af van de kosten van een mislukte taak, niet alleen van de hoogste benchmarkscore.
In de Intelligence Index-momentopname van 8 september 2026 scoort Fable 5.1 53, tegenover 47 voor GPT-5.6 Sol. De outputdoorvoer is praktisch gelijk met 69,9 versus 69,8 tokens/s. Deze resultaten ondersteunen een kwaliteit-versus-kostenbeslissing; ze wijzen geen universele snelheidswinnaar aan.
Belangrijkste punten
- Kies Fable 5.1 voor de moeilijkste autonome taken wanneer je eigen evaluaties de hogere prijs rechtvaardigen.
- Begin met GPT-5.6 Sol voor kostenbewuste frontier-inferentie en toepassingen die profiteren van de geïntegreerde tools.
- Vergelijk opstartvertraging apart van uitvoersnelheid: GPT-5.6 Sol heeft een lagere gemeten tijd tot de eerste token, terwijl de doorvoer vrijwel gelijk is.
- Modelleer cache-writes, -reads, retentie en long-context-tarieven afzonderlijk. Kopprijzen voor input/output beschrijven niet elke agent-workload.
Gegevens gecontroleerd op 8 september 2026. Onafhankelijke resultaten gebruiken GPT-5.6 Sol op maximale inspanning en Fable 5.1 met Adaptive Reasoning, Max Effort, Default Fallback. Vendorbenchmarks en onafhankelijke benchmarks gebruiken verschillende evaluatieopzetten. Prijzen zijn USD per miljoen tokens (MTok), tenzij anders vermeld.
GPT-5.6 Sol vs Fable 5.1: snel oordeel
| Dimensie | GPT-5.6 Sol | Claude Fable 5.1 | Betere keuze |
|---|---|---|---|
| Onafhankelijke Intelligence Index v4.3 (8 sep) | 47 | 53 | Fable 5.1 |
| Onafhankelijke Terminal-Bench 4.0 (7 sep) | 39.9% | 52.0% | Fable 5.1 |
| Door Anthropic uitgevoerde Terminal-Bench 4.0 | 37.3% | 55.8% | Fable 5.1 |
| Contextvenster | 1.05M | 1M | Praktisch gelijk |
| Maximale output | 128K | 128K | Gelijk |
| Tekst-/afbeeldingsinvoer | Ja | Ja | Gelijk |
| Officiële invoerprijs / MTok | $4 | $10 | Sol |
| Officiële uitvoerprijs / MTok | $20 | $50 | Sol |
| Officiële cache-read / MTok | $0.40 | $0.25 | Fable 5.1 |
| Onafhankelijke uitvoersnelheid (8 sep) | 69.8 tok/s | 69.9 tok/s | Praktisch gelijk |
| API-toolbreedte | Zeer breed | Sterk | Sol |
| Langlopende autonome taken | Uitstekend | Kernsterkte | Fable 5.1 |
| Kostenbewuste productie | Betere default | Premium-escalatie | Sol |
Een nuttig startbeleid is Sol voor routinematig frontierwerk, met Fable 5.1 als escalatieroute wanneer een taak je kwaliteits- of autonomiedrempel niet haalt. Valideer dat beleid tegen de kosten per geslaagde taak.
GPT-5.6 Sol biedt zes niveaus van redeneerinspanning, van none tot max, met medium als standaard. Fable 5.1 gebruikt altijd ingeschakelde adaptieve denkwijze; de inspanningsstand stuurt de diepte van het redeneren, en de standaard is hoog.
De extra 50.000 tokens in de context van GPT-5.6 Sol zullen waarschijnlijk niet de doorslag geven in de meeste architecturen. Facturering en cache-hergebruik worden belangrijker naarmate een verzoek de miljoen tokens nadert; de long-contextsectie hieronder laat zien waarom.
Wat is GPT-5.6 Sol?
GPT-5.6 Sol is een high-capability tier in OpenAI’s GPT-5.6-familie voor veeleisende workflows op het gebied van programmeren, onderzoek, planning en agents. De belangrijkste aantrekkingskracht in deze vergelijking is de combinatie van redeneerinstellingen en de omringende uitvoeringsomgeving.
Via de Responses API ondersteunt GPT-5.6 Sol een brede native toolportefeuille: web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP, skills en tool search. Dit kan het aantal afzonderlijke runtimecomponenten dat een applicatie moet integreren, verminderen.
OpenAI beschrijft ook programmatic tool calling en multi-agentuitvoering voor de familie. Deze platformfuncties zijn belangrijk wanneer een model werk over tools moet coördineren in plaats van één enkel antwoord te geven.
Wat is Claude Fable 5.1?
Claude Fable 5.1 richt zich op veeleisende programmering, professioneel kenniswerk, onderzoek en langlopende agents. De directe benchmarkresultaten maken het een sterke kandidaat voor taken waarbij herstel, volharding en succesvolle voltooiing belangrijker zijn dan een kort antwoord.
Anthropic benadrukt duurzame autonome uitvoering in toepassingen, waaronder plannen, herstellen van mislukte stappen en het communiceren van voortgang. Behandel die positionering als een reden om langere taken te testen, niet als een garantie dat elke workflow correct afrondt.
Fable 5.1 verschilt ook van GPT-5.6 Sol in API-gedrag: de beperkingen op verplichte toolkeuze doen ertoe voor workflows die vereisen dat het model een specifieke tool aanroept. Controleer ondersteunde tool_choice modes bij het migreren van een deterministische agentloop.
De integratievraag is daarom praktisch: kan je applicatie een autonomere redeneerlus tolereren, of is fijnmazigere controle over elke stap vereist? Test het exacte toolgedrag voordat je een route kiest.
Benchmarkvergelijking: Fable 5.1 heeft de sterkere directe onderbouwing
Benchmarkvergelijkingen tussen concurrerende aanbieders zijn gemakkelijk verkeerd te gebruiken. OpenAI’s oorspronkelijke GPT-5.6-lanceerevaluaties gaan vooraf aan Fable 5.1, terwijl Anthropic’s Fable 5.1-release nieuwere directe GPT-5.6 Sol-vergelijkingen bevat.
De schoonste manier om het bewijs te lezen is daarom in drie lagen: de directe vergelijking van Anthropic, de huidige onafhankelijke tests en het eigen capabilityprofiel van GPT-5.6 Sol van OpenAI.
Rechtstreekse resultaten van Anthropic: Fable 5.1 vs GPT-5.6 Sol
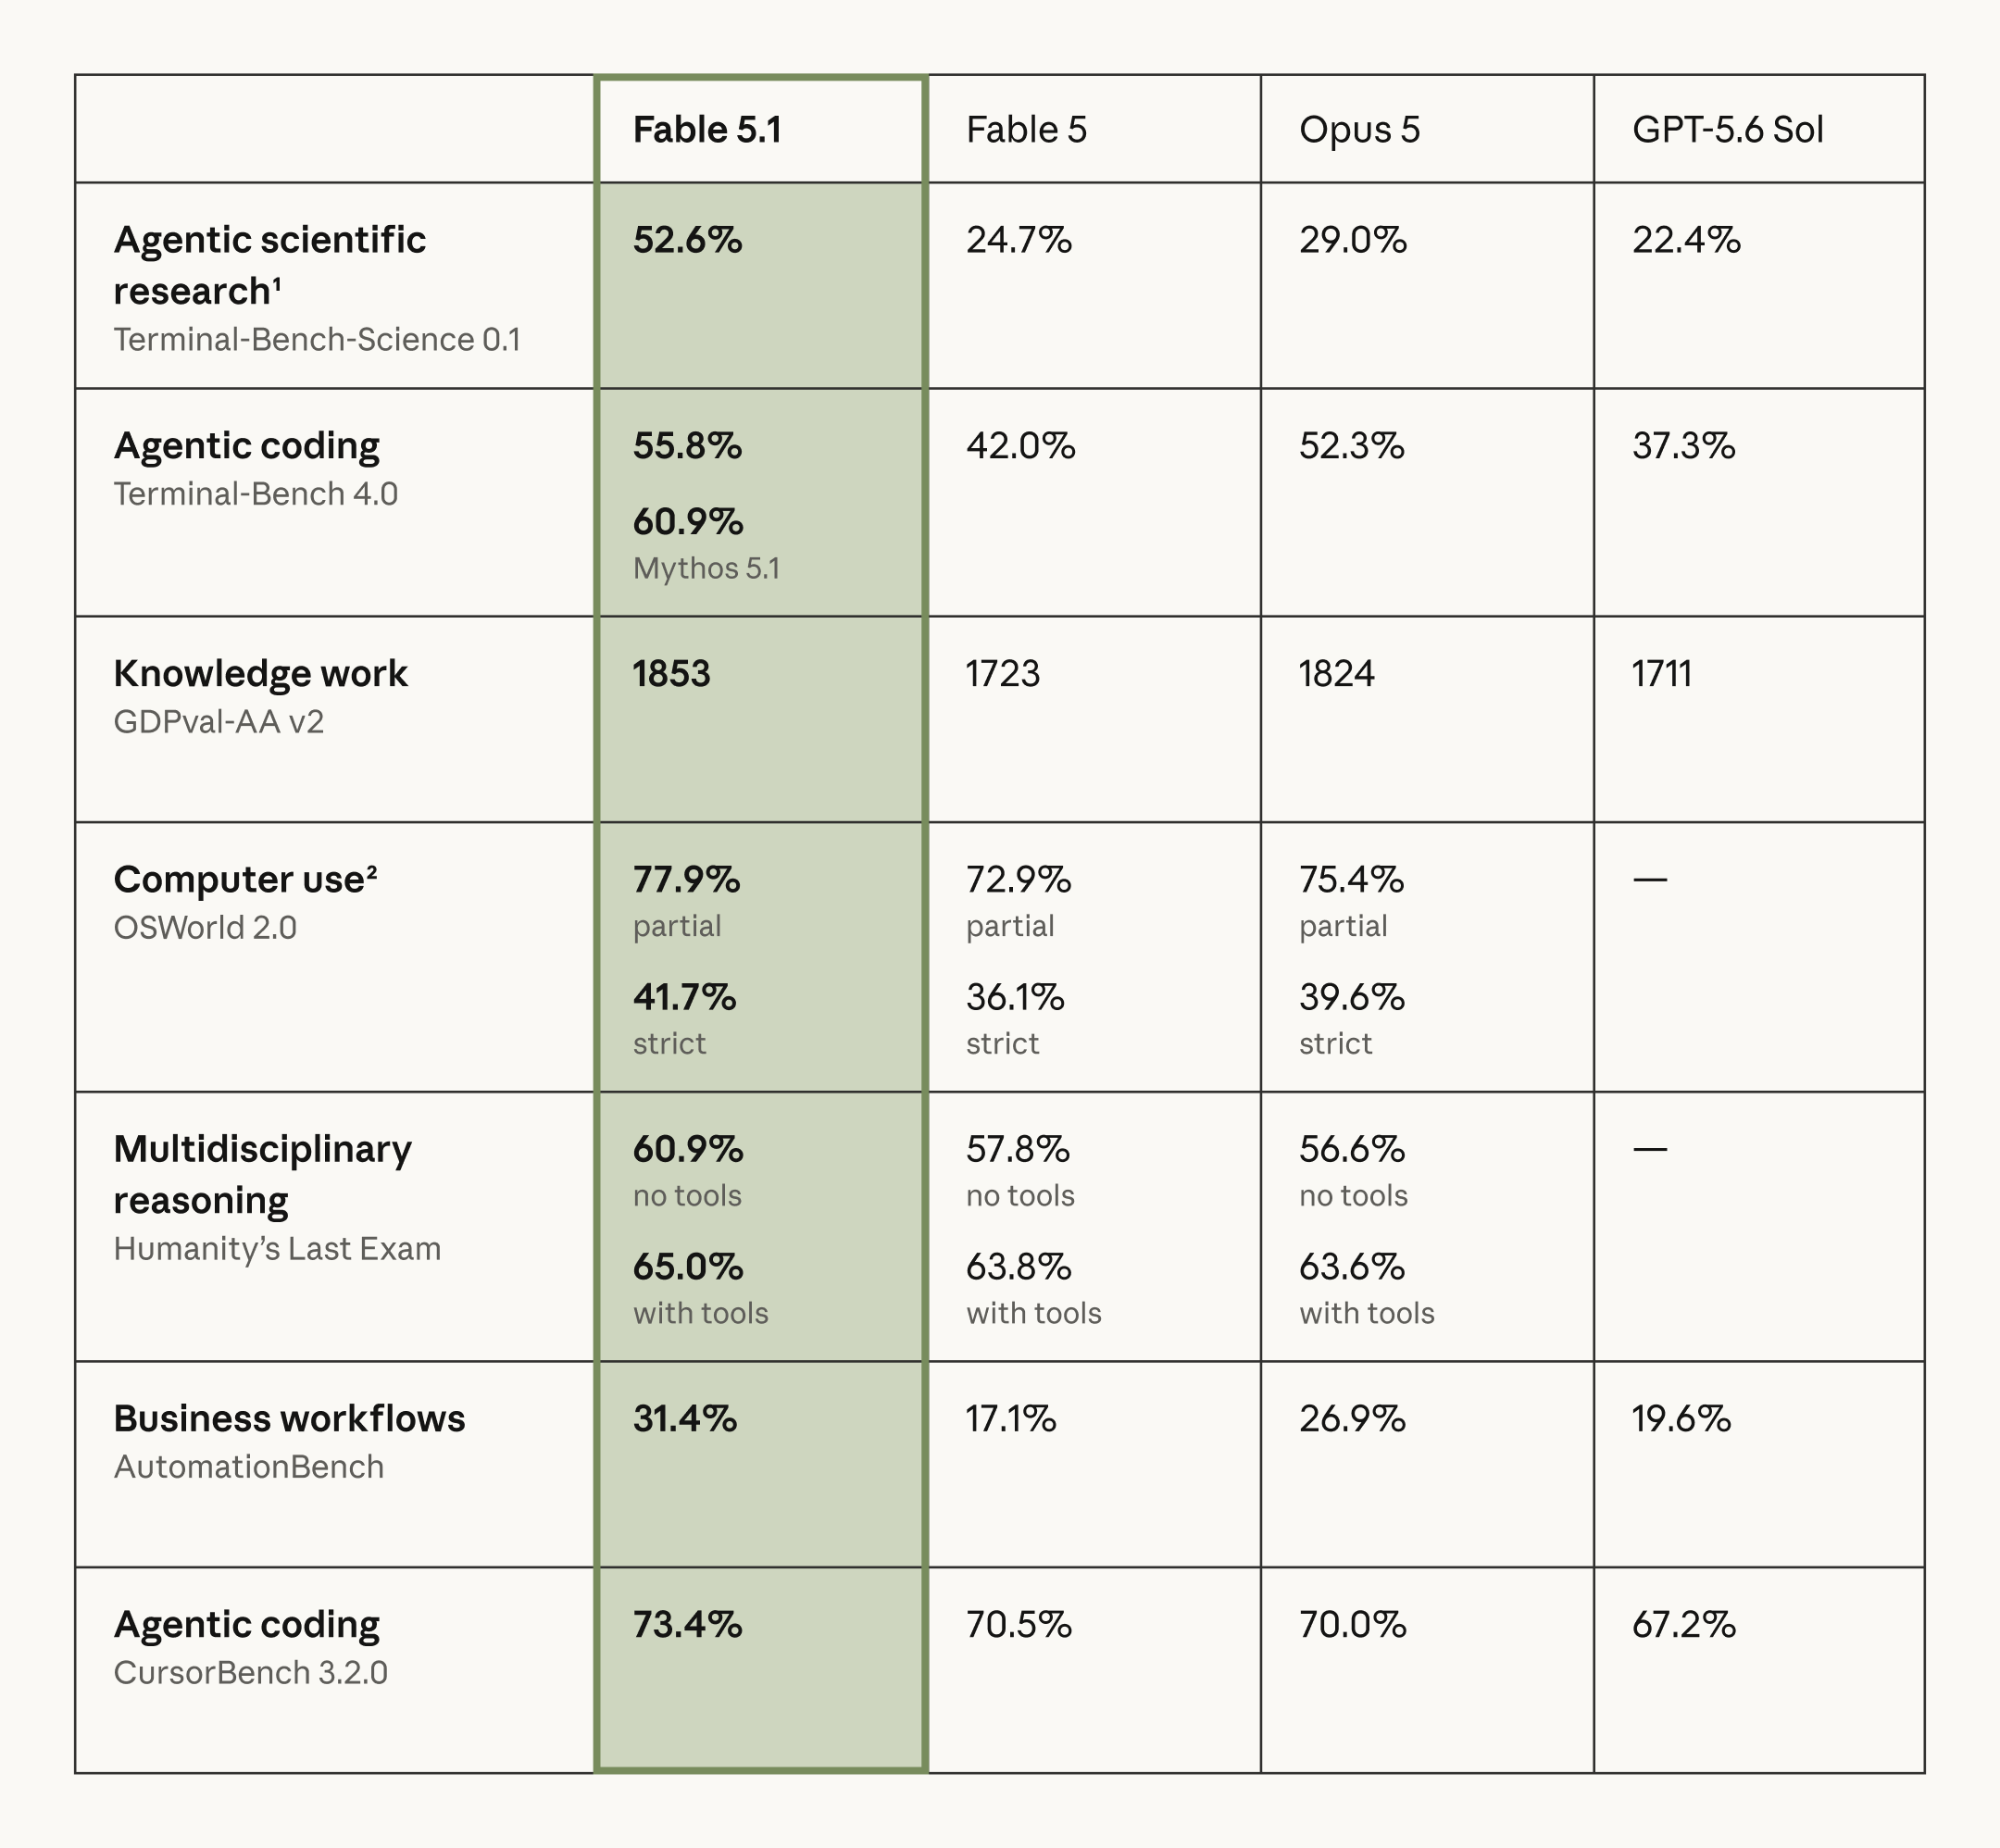
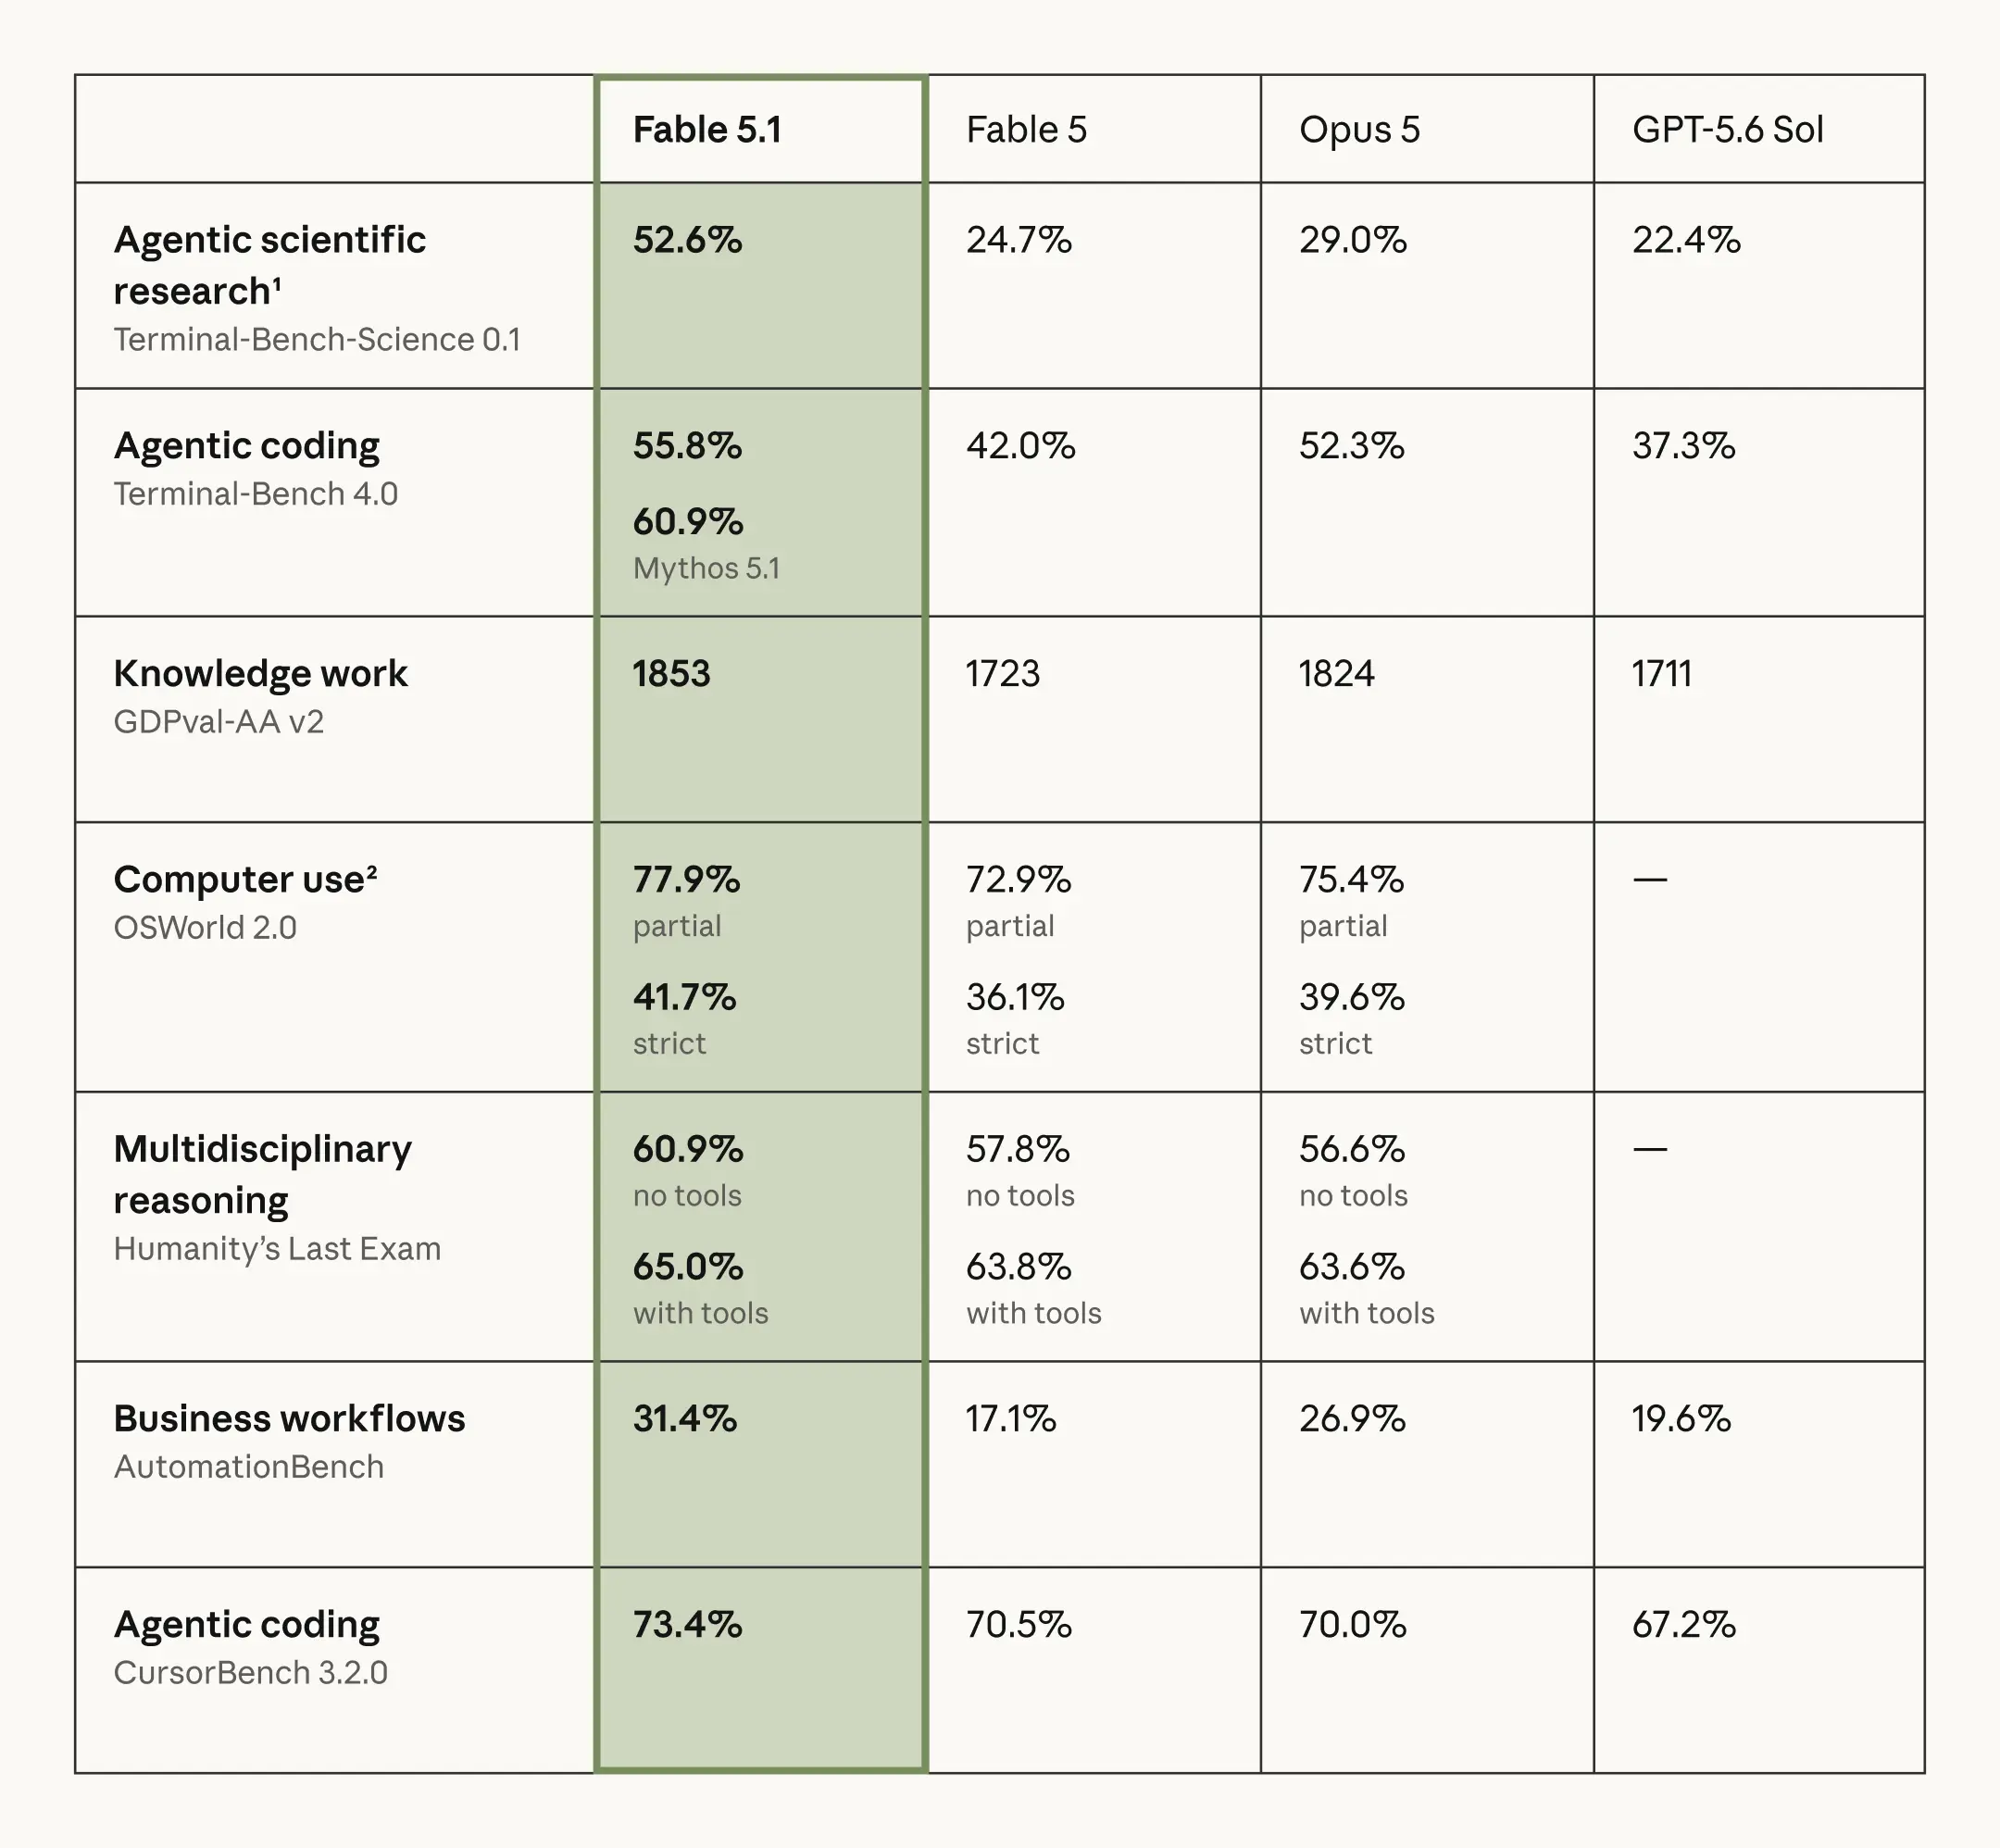
De officiële benchmarkresultaten bevatten vijf taken met gerapporteerde scores voor beide modellen. Hieronder zijn de verschillen in procentpunten en Elo berekend op basis van die gepubliceerde waarden.
| Benchmark | GPT-5.6 Sol | Claude Fable 5.1 | Voorsprong Fable 5.1 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 22.4% | 52.6% | +30.2 pts |
| Terminal-Bench 4.0 | 37.3% | 55.8% | +18.5 pts |
| GDPval-AA v2 | 1711 Elo | 1853 Elo | +142 Elo |
| AutomationBench | 19.6% | 31.4% | +11.8 pts |
| CursorBench 3.2.0 | 67.2% | 73.4% | +6.2 pts |
Het resultaat is ongewoon consistent: Fable 5.1 leidt GPT-5.6 Sol in elke directe rij die Anthropic publiceerde. De grootste verschillen verschijnen in agentisch wetenschappelijk onderzoek en terminalgebaseerde programmering in plaats van in gewone kortvormredenering.
Bron: Anthropic — originele benchmarkgrafiek.
Dit zijn door de aanbieder uitgevoerde evaluaties: Anthropic testte zowel het eigen model als het concurrerende model. Ze bieden direct vergelijkend bewijs, maar het zijn geen onafhankelijke tests. Anthropic meldt een standaardfout van ±3,5–4,5 procentpunt per model op Terminal-Bench-Science; de tabel hierboven toont puntschattingen, geen betrouwbaarheidsintervallen.
De aanbiederresultaten zijn in het voordeel van Fable 5.1, maar het onafhankelijke bewijs behoeft eigen data en configuraties.
Onafhankelijke benchmarks: scheid gedateerde resultaten van livemetingen
Artificial Analysis introduceerde Intelligence Index v4.3 op 7 september, verving Terminal-Bench 2.1 door Terminal-Bench 4.0 en voegde AutomationBench-AA toe. De release rapporteerde 53 voor Fable 5.1 en 47 voor GPT-5.6 Sol, overeenkomend met de afgeronde scores in de vergelijking van 8 september. De tabel onderscheidt de terminalresultaten van de release van de latere prestatiemomentopname.
| Vergelijking onafhankelijke metriek AA / v4.3-release | GPT-5.6 Sol (max) | Claude Fable 5.1 (max) | Resultaat |
|---|---|---|---|
| Intelligence Index v4.3 (8 sep) | 47 | 53 | Fable |
| Terminal-Bench 4.0 (7 sep release) | 39.9% | 52.0% | Fable |
| OSWorld 2.0 | 62.6% | 41.7% | |
| Uitvoersnelheid (8 sep) | 69.8 tok/s | 69.9 tok/s | Praktisch gelijk |
| Tijd tot eerste token (8 sep) | 132.10 s | 277.47 s | Sol |
| AA genormaliseerde tokenmix-prijs / MTok | $3.08 | $7.175 | Sol |
Momentopname: 8 september 2026, behalve de expliciet gedateerde Terminal-Bench-rij van 7 september. Fable 5.1 gebruikt Adaptive Reasoning, Max Effort, Default Fallback; Sol gebruikt max. Livemetingen kunnen veranderen. AA’s genormaliseerde tokenmix-prijs gebruikt een 7:2:1 cache-hit/input/outputverhouding; het is niet de prijs van elk API-verzoek.
OSWorld 2.0 is het grootste gerapporteerde voordeel voor Sol in deze vergelijking: 62,6% versus 41,7% voor Fable 5.1, een voorsprong van 20,9 punten. Dit compenseert de sterkere Fable-resultaten op de Intelligence Index en Terminal-Bench.
Het bewijs ondersteunt een specifieke afruil: Fable 5.1 heeft de hogere Intelligence Index, terwijl Sol een lagere tijd tot de eerste token en een lagere genormaliseerde prijs heeft. De outputdoorvoer is praktisch gelijk. Deze metingen ondersteunen verschillende keuzes voor kwaliteitssensitief batchwerk en interactieve toepassingen.
De gedateerde onafhankelijke Terminal-Bench-vergelijking wijst in dezelfde richting als Anthropic’s test: 52,0% versus 39,9%, vergeleken met de 55,8% versus 37,3% van de aanbieder. De twee gaten zijn niet uitwisselbaar omdat de evaluatieopzetten verschillen.
Wat OpenAI’s benchmarks ons nog vertellen over GPT-5.6 Sol
OpenAI’s lanceerevaluaties bieden extra context voor de mogelijkheden van GPT-5.6 Sol. Ze gaan vooraf aan de nieuwere head-to-headresultaten die hierboven worden besproken, dus ze mogen niet worden gebruikt als een directe vergelijking met Fable 5.1.
OpenAI meldt 88.8% op Terminal-Bench 2.1 voor GPT-5.6 Sol. Dat is bewijs van sterke agentische programmeercapaciteit onder de lanceeropzet; de oudere benchmarkversie moet niet numeriek worden vergeleken met Terminal-Bench 4.0-scores.
GPT-5.6 Sol vs Fable 5.1 voor programmeren
Voor rechttoe rechtaan codegeneratie is elk model overgekwalificeerd voor veel productie-workloads. De scheiding wordt duidelijker wanneer programmeren verandert in agentgebaseerde software-engineering: een grote repository inspecteren, meerdere files bewerken, commando’s uitvoeren, fouten diagnosticeren, tests schrijven en itereren tot de taak slaagt.
Hier heeft Claude Fable 5.1 de sterkere huidige benchmarkonderbouwing. Het leidt zowel de door de aanbieder uitgevoerde als de onafhankelijke Terminal-Bench 4.0-vergelijkingen, en Anthropic’s CursorBench-resultaat is ook in het voordeel: 73,4% tegen 67,2%.
Voor een praktische code-evaluatie moeten repository-brede veranderingen, tests, review en prestatiewerk worden meegenomen. Een geslaagd kort codefragment is een zwakke proxy voor het voltooien van een taak die meerdere files en mislukte pogingen omvat.
GPT-5.6 Sol blijft aantrekkelijk wanneer de omringende uitvoeringsomgeving net zo belangrijk is als de pure modelkwaliteit. Native ondersteuning voor shell-executie, apply-patch, code interpreter, file search, computer use en MCP kan de hoeveelheid orkestratie-infrastructuur die je zelf moet bouwen verminderen.
Code-oordeel: kies Fable 5.1 wanneer je evaluaties de moeilijkste autonome repositorytaken benadrukken. Kies GPT-5.6 Sol wanneer een iets lagere benchmarkcapaciteit acceptabel is in ruil voor lagere kosten en een brede geïntegreerde uitvoeringsstack.
Redeneerinstellingen en developerervaring
De twee API’s stellen intelligentie op verschillende manieren bloot.
Sol’s bereik van none tot max laat een team kwaliteit en vertraging op meerdere instellingen testen. Lagere inspanning kan het redeneerwerk verminderen, maar de juiste instelling hangt af van de faalkosten van de taak.
Fable’s altijd ingeschakelde adaptieve denkwijze maakt het afstemmen van inspanning een andere oefening. Vergelijk de instellingen die je applicatie zal inzetten in plaats van identieke inspanningslabels als identieke compute-budgetten te behandelen.
Er is bijgevolg geen universeel eerlijke vergelijking tussen “default Sol” en “default Fable”. Hun standaard redeneerconfiguraties verschillen. Productie-evaluaties moeten ofwel equivalente inspanningsbudgetten vergelijken, ofwel de exacte instellingen die je applicatie daadwerkelijk zal inzetten.
GPT-5.6 Sol vs Fable 5.1: welke is beter voor AI-agents?
De keuze hangt af van waar de bottleneck zit: moeilijke redenering of de runtime errond.
Fable’s voorsprong in de aangehaalde terminal-, automatiserings- en professionele-werkbenchmarks maakt het een logische kandidaat voor de moeilijkste taken. Meet voltooiingspercentage en herstel van mislukte stappen voordat je die voorsprong generaliseert naar je agent.
GPT-5.6 Sol’s gedocumenteerde Responses-toolportefeuille maakt het aantrekkelijk voor toepassingen die zijn gebouwd rond search, files, shell-executie en patches. Dat is een integratievoordeel om naast taaknauwkeurigheid te evalueren, geen vervanging ervoor.
| Agent-vereiste | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|
| Moeilijke langetermijnredenering | Uitstekend | Beste fit |
| Terminal-/repositoryautonomie | Uitstekend | Sterkere onderbouwing |
| Native geïntegreerde toolportefeuille | Sterker | Sterk |
| Verplichte toolselectie | Ondersteund; controleer API | Beperkt; controleer tool_choice modes |
| Multi-agent platformintegratie | Sterk voordeel | Beschikbaar via agentarchitectuur |
| Voortgangscommunicatie bij lange jobs | Goed | Kerngedrag |
| Kostenbewuste agents op grote schaal | Beter | Premium |
| Herhaald massaal gecachte context | Goed | Potentieel zeer aantrekkelijk |
Beide gebruiken kan economisch zijn wanneer slechts een klein deel van de taken escalatie vereist. Meet of de extra geslaagde afrondingen de hogere prijs en opstartvertraging van het tweede model compenseren.
Lange context: 1,05M vs 1M is niet het belangrijke verschil
De kopgetallen lijken bijna identiek: GPT-5.6 Sol biedt 1,05M tokens en Fable biedt 1M. Een capaciteitsverschil van 5% zal waarschijnlijk niet bepalen of je een grote repository, juridische corpus, onderzoeksarchief of meeruur-agentgeschiedenis kunt analyseren. Beide zitten al in de miljoen-tokenklasse.
Voor GPT-5.6 Sol triggert input boven 272K hogere long-context-tarieven voor het verzoek: $8/MTok input, $0.80/MTok gecachte input en $30/MTok output. Cache-writes stijgen ook van $5 naar $10/MTok.
Fable 5.1 houdt zijn standaardtarieven voor 1M-context: $10/MTok input, $50/MTok output en $0.25/MTok cache-reads. Er is geen apart premium boven 272K in deze gedocumenteerde configuratie.
Beschouw een beurt met 100K ongecachte inputtokens, 900K cache-read tokens en 20K totaal gefactureerde outputtokens. GPT-5.6 Sol kost 0.1 × $8 + 0.9 × $0.80 + 0.02 × $30 = $2.12. Fable 5.1 kost 0.1 × $10 + 0.9 × $0.25 + 0.02 × $50 = $2.225.
Deze cache-zware beurt sluit bijna het prijsverschil omdat Fable goedkopere cache-reads heeft. Het resultaat hangt af van de tokenmix van de workload; het betekent niet dat de twee modellen hetzelfde kosten voor een volledige agentsessie.
Kostenaannames: de prefix van 900K tokens is al gecached en de 100K nieuwe input wordt niet gefactureerd als een nieuwe cache-write. De schatting sluit de initiële cache-write en toolkosten uit. De 20K outputtoelage omvat alle gefactureerde output, inclusief eventuele gefactureerde redeneertokens.
Prijzen: Sol wint gewone workloads, Fable wint één belangrijke cachemetriek
Tegen de gecontroleerde tarieven kost Sol $4 input / $20 output per MTok, met $0.40 cache-reads. Fable 5.1 kost $10 input, $50 output en $0.25 cache-reads. De tabel scheidt aanbiedersprijzen van de GPT-5.6 Sol API in CometAPI en Claude Fable 5.1 API in CometAPI-tarieven.
| Prijsonderdeel | GPT-5.6 Sol Officiële prijzen | Claude Fable 5.1 Officiële prijzen |
|---|---|---|
| Officiële input / MTok | $4.00 | $10.00 |
| Officiële output / MTok | $20.00 | $50.00 |
| Officiële cache-read / MTok | $0.40 | $0.25 |
| Officiële cache-write / MTok | $5.00 (30 minuten) | $12.50 (5 minuten) |
| Boven 272K input: input / cache-read / cache-write / output | $8 / $0.80 / $10 / $30 | Zelfde gedocumenteerde basistarieven |
| CometAPI input / MTok | $3.20 | $8.00 |
| CometAPI output / MTok | $16.00 | $40.00 |
Cache-write-durations verschillen: Sol gebruikt een standaard retentieperiode van 30 minuten, terwijl het Fable 5.1-tarief dat hier wordt getoond overeenkomt met een write van 5 minuten. Controleer het gedrag voor cachecreatie, -verversing en -verloop voor de aanbieder en route die je daadwerkelijk gebruikt.
Tegen de gecontroleerde directe aanbiedertarieven kost Fable 5.1 2,5× zoveel als Sol voor zowel ongecachte input ($10 vs $4/MTok) als output ($50 vs $20/MTok). Behandel deze gecontroleerde tarieven als een gedateerde vergelijking, aangezien aanbiederpromoties en gatewayprijzen kunnen veranderen.
Een kort-contextverzoek met 100K input en 10K totaal gefactureerde output kost ongeveer $0.60 met Sol of $1.50 met Fable tegen directe aanbiedertarieven. Tegen de hierboven getoonde CometAPI-tarieven kost dezelfde mix $0.48 of $1.20. Deze voorbeelden sluiten cache-writes en toolkosten uit.
Fable’s cache-readtarief voor korte context is 37,5% lager: ($0.40 − $0.25) ÷ $0.40. Dat kan ertoe doen voor agents die een grote stabiele prefix hergebruiken, maar de totale besparing hangt nog steeds af van nieuwe input, schrijffrequentie en outputvolume.
Prijs-oordeel: Sol is het goedkopere startpunt voor verkeer met nieuwe context. Fable wordt concurrerender naarmate het aandeel cache-reads groeit; vergelijk de volledige sessiekosten, inclusief het creëren en verversen van de cache.
Snelheid en latentie
Tests op maximale inspanning kunnen aanzienlijke tijd besteden aan redeneren voordat de eerste zichtbare token verschijnt.
De doorvoer- en latentiemetingen van 8 september tonen 69,9 outputtokens/s voor Fable en 69,8 voor Sol. Tijd tot de eerste token is 277,47 seconden versus 132,10 seconden. De outputdoorvoer is praktisch gelijk; Sol begint in deze configuratie eerder zichtbare output te produceren.
Dit zijn metingen bij maximale inspanning, niet beloofde latentie voor elke API-aanroep. Promptlengte, redeneerconfiguratie, aanbiederbelasting, tools en cachestatus kunnen het resultaat veranderen. Tijd tot eerste token en totale responstijd zijn verschillende metrics.
Voor interactief werk kan de lagere waargenomen opstartvertraging Sol in het voordeel stellen. Voor asynchroon onderzoek of nachtelijk repositorywerk kan succesvolle afronding belangrijker zijn dan wachten op de eerste token. Benchmark beide modellen met de instellingen en gelijktijdigheid die je van plan bent te gebruiken.
Safeguards zijn een productieverschil
Beide modellen passen sterkere safeguards toe omdat hun capaciteiten reiken tot gevoelige cyberbeveiligings- en wetenschappelijke domeinen, maar ze implementeren die verschillend.
OpenAI beschrijft gelaagde beschermingen en monitoring voor de GPT-5.6-familie. Toepassingen in gevoelige domeinen moeten de relevante safeguards evalueren als onderdeel van hun deploymentgedrag.
Anthropic’s rerouting- en retentievoorwaarden beschrijven het routeren van sommige gevoelige cyberbeveiligings- of biologieverzoeken naar minder capabele modellen, zonder het Fable-tarief te berekenen voor die doorgestuurde verzoeken. De standaard gegevensretentieperiode is 30 dagen, met uitzonderingen voor in aanmerking komende enterprise-arrangementen.
Voor gewoon programmeren en kenniswerk verschijnen deze verschillen mogelijk nooit. Voor beveiligingsproducten, gereguleerde workloads of privacygevoelige deployments horen ze thuis op de evaluatielijst naast benchmarkkwaliteit en prijs.
Welk model moet je kiezen?
De algemene vergelijking kan worden teruggebracht tot de vorm van de workload.
| Werkbelasting | GPT-5.6 Sol | Claude Fable 5.1 | Aanbeveling |
|---|---|---|---|
| Moeilijke autonome programmering | Uitstekend | Sterkere huidige benchmarks | Fable 5.1 |
| Langetermijnonderzoek | Uitstekend | Kernsterkte | Fable 5.1 |
| Hoogvolume frontier-API | Veel goedkoper | Duur | Sol |
| Interactieve code-assistent | Lager gemeten max-effort TTFT | Hoger gemeten max-effort TTFT | Test ingezette instellingen |
| Tool-zware API-agent | Broadere native toolstack | Sterk | Sol |
| Miljoen-token gecachte agent | Concurrerend | Zeer lage cache-read prijs | Test beide |
| Maximale redeneerkwaliteit | Uitstekend | Onafhankelijke voorsprong | Fable 5.1 |
| Kosten per gewone aanvraag | Duidelijk voordeel | Premium | Sol |
| Beeld-/documentredenering | Sterk | Sterk | Test op workload |
| Single-provider OpenAI-stack | Natuurlijke fit | Vereist migratie/gateway | Sol |
| Modelonafhankelijke routing | Sterk | Sterk | Gebruik beide via CometAPI |
Een routingbeleid moet zijn complexiteit waard zijn. Vergelijk een single-model basislijn met een Sol-first beleid dat moeilijke taken escaleren naar Fable 5.1, en behoud de router alleen als deze de kosten per geslaagde taak verbetert bij de vereiste kwaliteit.
Hoe GPT-5.6 Sol en Fable 5.1 via CometAPI te vergelijken
CometAPI integreert GPT-5.6 Sol en Claude Fable 5.1 al. Benader beide modellen met hun native verzoekformaten, stuur dezelfde evaluatieset en vergelijk de geretourneerde resultaten onder overeenkomende instellingen.
Gebruik native-formatverzoeken voor elk model en houd prompts, datasets, inspanningsinstellingen, gelijktijdigheid en beoordelingsregels constant. Herhaal de runs; één enkele sequentiële aanvraag per model is niet genoeg om betrouwbare latentie of kwaliteit te schatten.
Voor een productie-evaluatie: gebruik een vaste promptset, herhaal runs in afwisselende volgorde, registreer de inspanningsinstelling en scoor juistheid, test-slaagpercentage, toolsucces, retries, tokengebruik, verstreken tijd en totale kosten per geslaagde taak. Stem elk model afzonderlijk af na de gemeenschappelijke basislijn.
Eindoordeel: GPT-5.6 Sol of Claude Fable 5.1?
Fable 5.1 heeft de sterkere directe onderbouwing voor de moeilijkste autonome programmering en langetermijnwerk. Het leidt de vijf gedeelde aanbiederbenchmarksrijen en de gedateerde onafhankelijke terminalvergelijking. Dat maakt het een sterke escalatiekandidaat, onder voorbehoud van validatie op je eigen taken.
Sol heeft de lagere gewone tokenprijzen, fijnere redeneerinstellingen en een brede native toolstack. In de gecontroleerde onafhankelijke configuratie op maximale inspanning heeft het ook een lagere tijd tot de eerste token; de outputdoorvoer is vrijwel gelijk.
Geef prioriteit aan Fable 5.1 wanneer de moeilijkste autonome taken je succescijfer bepalen. Begin met Sol voor kostenbewuste frontier-inferentie of tool-zware toepassingen. Test voor interactieve workloads de ingezette inspanningsinstellingen om te bevestigen of het waargenomen voordeel in opstartvertraging blijft bestaan.
Kies een enkel model wanneer het eenvoudig aan je vereisten voldoet. Voeg routing toe wanneer evaluatieresultaten aantonen dat schakelen tussen de twee de kwaliteit of de kosten per geslaagde taak verbetert.
FAQ
Is Claude Fable 5.1 beter dan GPT-5.6 Sol?
Het heeft de hogere onafhankelijke Intelligence Index in de momentopname van 8 september: 53, tegenover 47 voor Sol. Het leidt ook de gedateerde onafhankelijke terminaltest. Dat ondersteunt een kwaliteitsvoordeel op deze evaluaties, geen claim dat het beter is voor elke workload.
Is GPT-5.6 Sol goedkoper dan Claude Fable 5.1?
Voor gewone ongecachte API-trafiek, ja: de gecontroleerde directe aanbiedertarieven voor input/output zijn $4/$20 per MTok voor Sol en $10/$50 voor Fable 5.1. Cache-zware workloads kunnen die kloof verkleinen omdat Fable’s cache-readtarief lager is. Neem schrijf- en verloopgedrag mee in de schatting.
Welk model is beter voor programmeren?
Fable 5.1 heeft de sterkere benchmarkonderbouwing voor autonome programmering in deze vergelijking. Sol blijft aantrekkelijk voor lagere-kostenworkflows en zijn geïntegreerde uitvoeringstools. Gebruik repositorytaken met uitvoerbare tests om te beslissen of de gemeten capaciteitskloof belangrijk is voor je toepassing.
Welk model heeft het grotere contextvenster?
Sol leidt technisch met 1,05M tegenover 1M tokens voor Fable 5.1, terwijl beide tot 128K output toestaan. In de praktijk zijn Sol’s >272K-prijzendrempel en Fable’s goedkope cache-reads meestal belangrijker dan het capaciteitsverschil van 50K tokens.
Kan ik via CometAPI toegang krijgen tot beide modellen?
Ja. De GPT-5.6 Sol API in CometAPI en de Claude Fable 5.1 API in CometAPI ondersteunen een gemeenschappelijk startpunt voor tekstevaluaties. Controleer route-specifieke reasonering, caching en toolondersteuning voordat je de basislijn uitbreidt naar een productieagent.