
GPT-6 Astra en Claude Fable 5.1 verschenen met slechts twee dagen verschil: Astra werd gelanceerd op 3 september, terwijl Fable 5.1 op 1 september werd gelanceerd. Ondanks de nauwe timing komen de belangrijkste verschillen naar voren in het profiel van benchmarks, tooluitvoering en cache-economie.
De gelijkenis stopt zodra de workload begint. OpenAI’s lanceringsevaluaties plaatsen Astra voor op verschillende tests voor codering, wetenschap, computergebruik en professioneel werk, terwijl Anthropic’s gepubliceerde benchmarks laten zien dat Fable 5.1 leidt op Humanity’s Last Exam. Fable 5.1 heeft ook een lagere officiële cache-readprijs, wat de economie van langdurige agents aanzienlijk kan veranderen.
De nuttige vraag is daarom niet simpelweg welk model de hogere benchmarkscore heeft. De praktische vraag is welke model jouw workload betrouwbaarder en economischer voltooit.
Kort antwoord: Astra is de sterkere standaard voor execution-zware agents, codering, computergebruik en door tools gedreven wetenschappelijke workflows. Fable 5.1 is bijzonder overtuigend voor brede, moeilijke redenering, langdurig asynchroon werk en toepassingen die herhaaldelijk zeer grote gecachte contexten hergebruiken.
GPT-6 Astra vs Claude Fable 5.1 in één oogopslag
| Specificatie | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Ontwikkelaar | OpenAI | Anthropic |
| Releasedatum | 3 sep 2026 | 1 sep 2026 |
| API-model-ID | gpt-6-astra | claude-fable-5-1 |
| Contextvenster | 1,050,000 tokens | 1,000,000 tokens |
| Maximale output | 128,000 tokens | 128,000 tokens |
| Invoermodaliteiten | Tekst, afbeeldingen | Tekst, afbeeldingen |
| Uitvoermodaliteit | Tekst | Tekst |
| Kennisafkapdatum | 30 apr 2026 | jun 2026 |
| Redeneren | low / medium / high / xhigh / max | Adaptief, altijd ingeschakeld |
| Standaardinspanning | — | high |
| Officiële input/output | $10 / $50 per MTok | $10 / $50 per MTok |
| Officiële cache-read | $1 / MTok | $0.25 / MTok |
| Prijzen lange context | Hogere tarief boven 272K input | Standaardtarief over 1M context |
| Primaire positionering | End-to-end uitvoering, codering, computergebruik | Veeleisende redenering, lange-horizon agents |
Informatie en prijzen geverifieerd op 7 september 2026. Specificaties en prijzen van aanbieders kunnen na publicatie wijzigen.
Bron: OpenAI officiële benchmark
Wat is GPT-6 Astra?
OpenAI introduceerde GPT-6 Astra op 3 september 2026 als het capabelste model voor moeilijk, end-to-end professioneel werk. In plaats van te focussen op geïsoleerde vraag-en-antwoord, is Astra ontworpen om complexe workflows te voltooien die redeneren, coderen, onderzoek, computerinteractie en documentcreatie combineren. Het kan over meerdere stappen werken, aangeleverde tools en context gebruiken en zich aanpassen wanneer gebruikers vereisten herzien of van richting veranderen tijdens een taak. OpenAI’s releasenotes belichten toepassingen zoals het produceren van documenten, spreadsheets en presentaties die specifieke instructies en sjablonen volgen.
Het model biedt een contextvenster van 1,050,000 tokens en een maximale output van 128,000 tokens, waardoor het grote codebases, uitgebreide documentcollecties of langdurige agentgeschiedenissen in één workflow kan verwerken. De redeneersinspanning kan worden geconfigureerd op low, medium, high, xhigh of max, zodat ontwikkelaars de responssnelheid en rekendiepte kunnen balanceren op basis van de moeilijkheid van elke taak.
Wat is Claude Fable 5.1?
Anthropic bracht Claude Fable 5.1 uit op 1 september 2026 als zijn high-end model voor veeleisende redenering en agentisch werk met lange horizon. Het bouwt voort op Claude Fable 5 met verbeteringen in langdurige coderings taken, meerstaps onderzoek en het maken of analyseren van documenten, spreadsheets en presentaties. Anthropic beveelt het aan voor workloads waarin volgehouden redenering en betrouwbare uitvoering belangrijker zijn dan pure responssnelheid—vooral wanneer Claude Opus 5 op hogere inspanningsinstellingen niet voldoende prestaties levert.
Volgens de officiële specificatie van Claude Fable 5.1 biedt het model een contextvenster van 1 miljoen tokens en een maximale output van 128,000 tokens. Dit geeft voldoende capaciteit om grote repositories, lange zakelijke dossiers, onderzoekscollecties of uitgebreide agenttrajecten te onderzoeken zonder het materiaal agressief op te delen in afzonderlijke requests. Het accepteert tekst- en afbeeldinginput en produceert tekstoutput, met een kennisafkapdatum van juni 2026.
Benchmarkvergelijking: Astra wint meer rijen, maar niet elke belangrijke
Een benchmarkvergelijking tussen concurrerende aanbieders vereist meer voorzichtigheid dan een normale generatie-op-generatie vergelijking. OpenAI testte Fable 5.1 op verschillende Astra-lanceringsevaluaties, terwijl Anthropic zijn eigen harnassen gebruikte en in sommige gevallen een nieuwere taakrelease. Dat maakt de schoonste vergelijkingen de tests waarbij definities en gerapporteerde instellingen voldoende overeenkomen om een directe beslissing te ondersteunen.
GPT-6 Astra vs Claude Fable 5.1: welke is beter voor coderen en agentische software
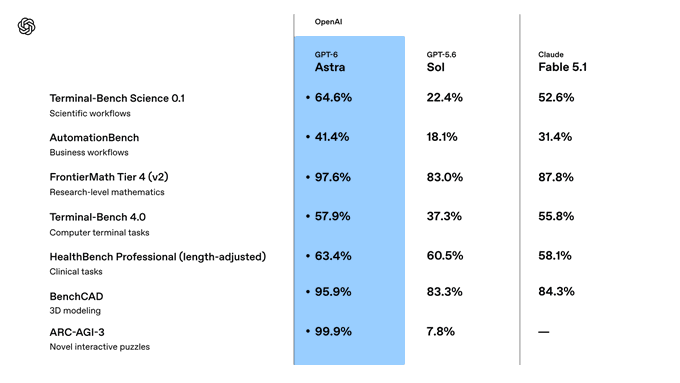
Coderen is een van Astra’s duidelijkste sterke punten. Op OpenAI’s gepubliceerde lanceringstabel scoort Astra 57.9% versus 55.8% op Terminal-Bench 4.0, 74.1% versus 67.4% op DeepSWE v1.1, en 63.9% versus 57.8% op een interne database-migratie-evaluatie.
| Coding-benchmark | GPT-6 Astra | Claude Fable 5.1 | Resultaat |
|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 55.8% | Astra +2.1 punten |
| DeepSWE v1.1 | 74.1% | 67.4% | Astra +6.7 punten |
| FrontierCode 1.1 Extended | 64.5% | 63.6% | Astra +0.9 punten |
| FrontierCode 1.1 Main | 53.3% | 50.9% | Astra +2.4 punten |
| Database migration, internal | 63.9% | 57.8% | Astra +6.1 punten |
Astra vertegenwoordigt een substantiële doorbraak voor op uitvoering gefocuste modellen: de gepubliceerde resultaten leiden Fable 5.1 op Terminal-Bench 4.0, DeepSWE v1.1 en de database-migratie-evaluatie, wat het voordeel versterkt wanneer code moet worden uitgevoerd, getest en geverifieerd over tools.
De conclusie is niet dat Fable 5.1 zwak is in codering. Anthropic beschrijft het als zijn capabelste model voor ambitieuze coderingsprojecten, en het eigen CursorBench 3.2.0-resultaat bereikt 73.4%. Het verschil zit in de vorm van de workload: Astra’s voordeel wordt overtuigender wanneer codering wordt gemengd met shell-uitvoering, repository-navigatie, verificatie en andere tools.
Winnaar voor uitvoering-intensieve software-engineering: Astra. Een langdurige repository-agent is een nauwere afweging omdat volgehouden samenhang, cachinggedrag en tokenefficiëntie even belangrijk kunnen zijn als één benchmarkscore.
GPT-6 Astra vs Fable 5.1: welke is beter voor redenering en wetenschap
De redeneervergelijking is interessanter omdat er geen sweeping win is. OpenAI’s gepubliceerde evaluaties rapporteren Astra op 97.6% op FrontierMath Tier 4, 96.0% op GPQA Diamond, en 64.6% op Terminal-Bench Science 0.1. Fable 5.1 noteert respectievelijk 87.8%, 93.7% en 52.6% in dezelfde vergelijking.
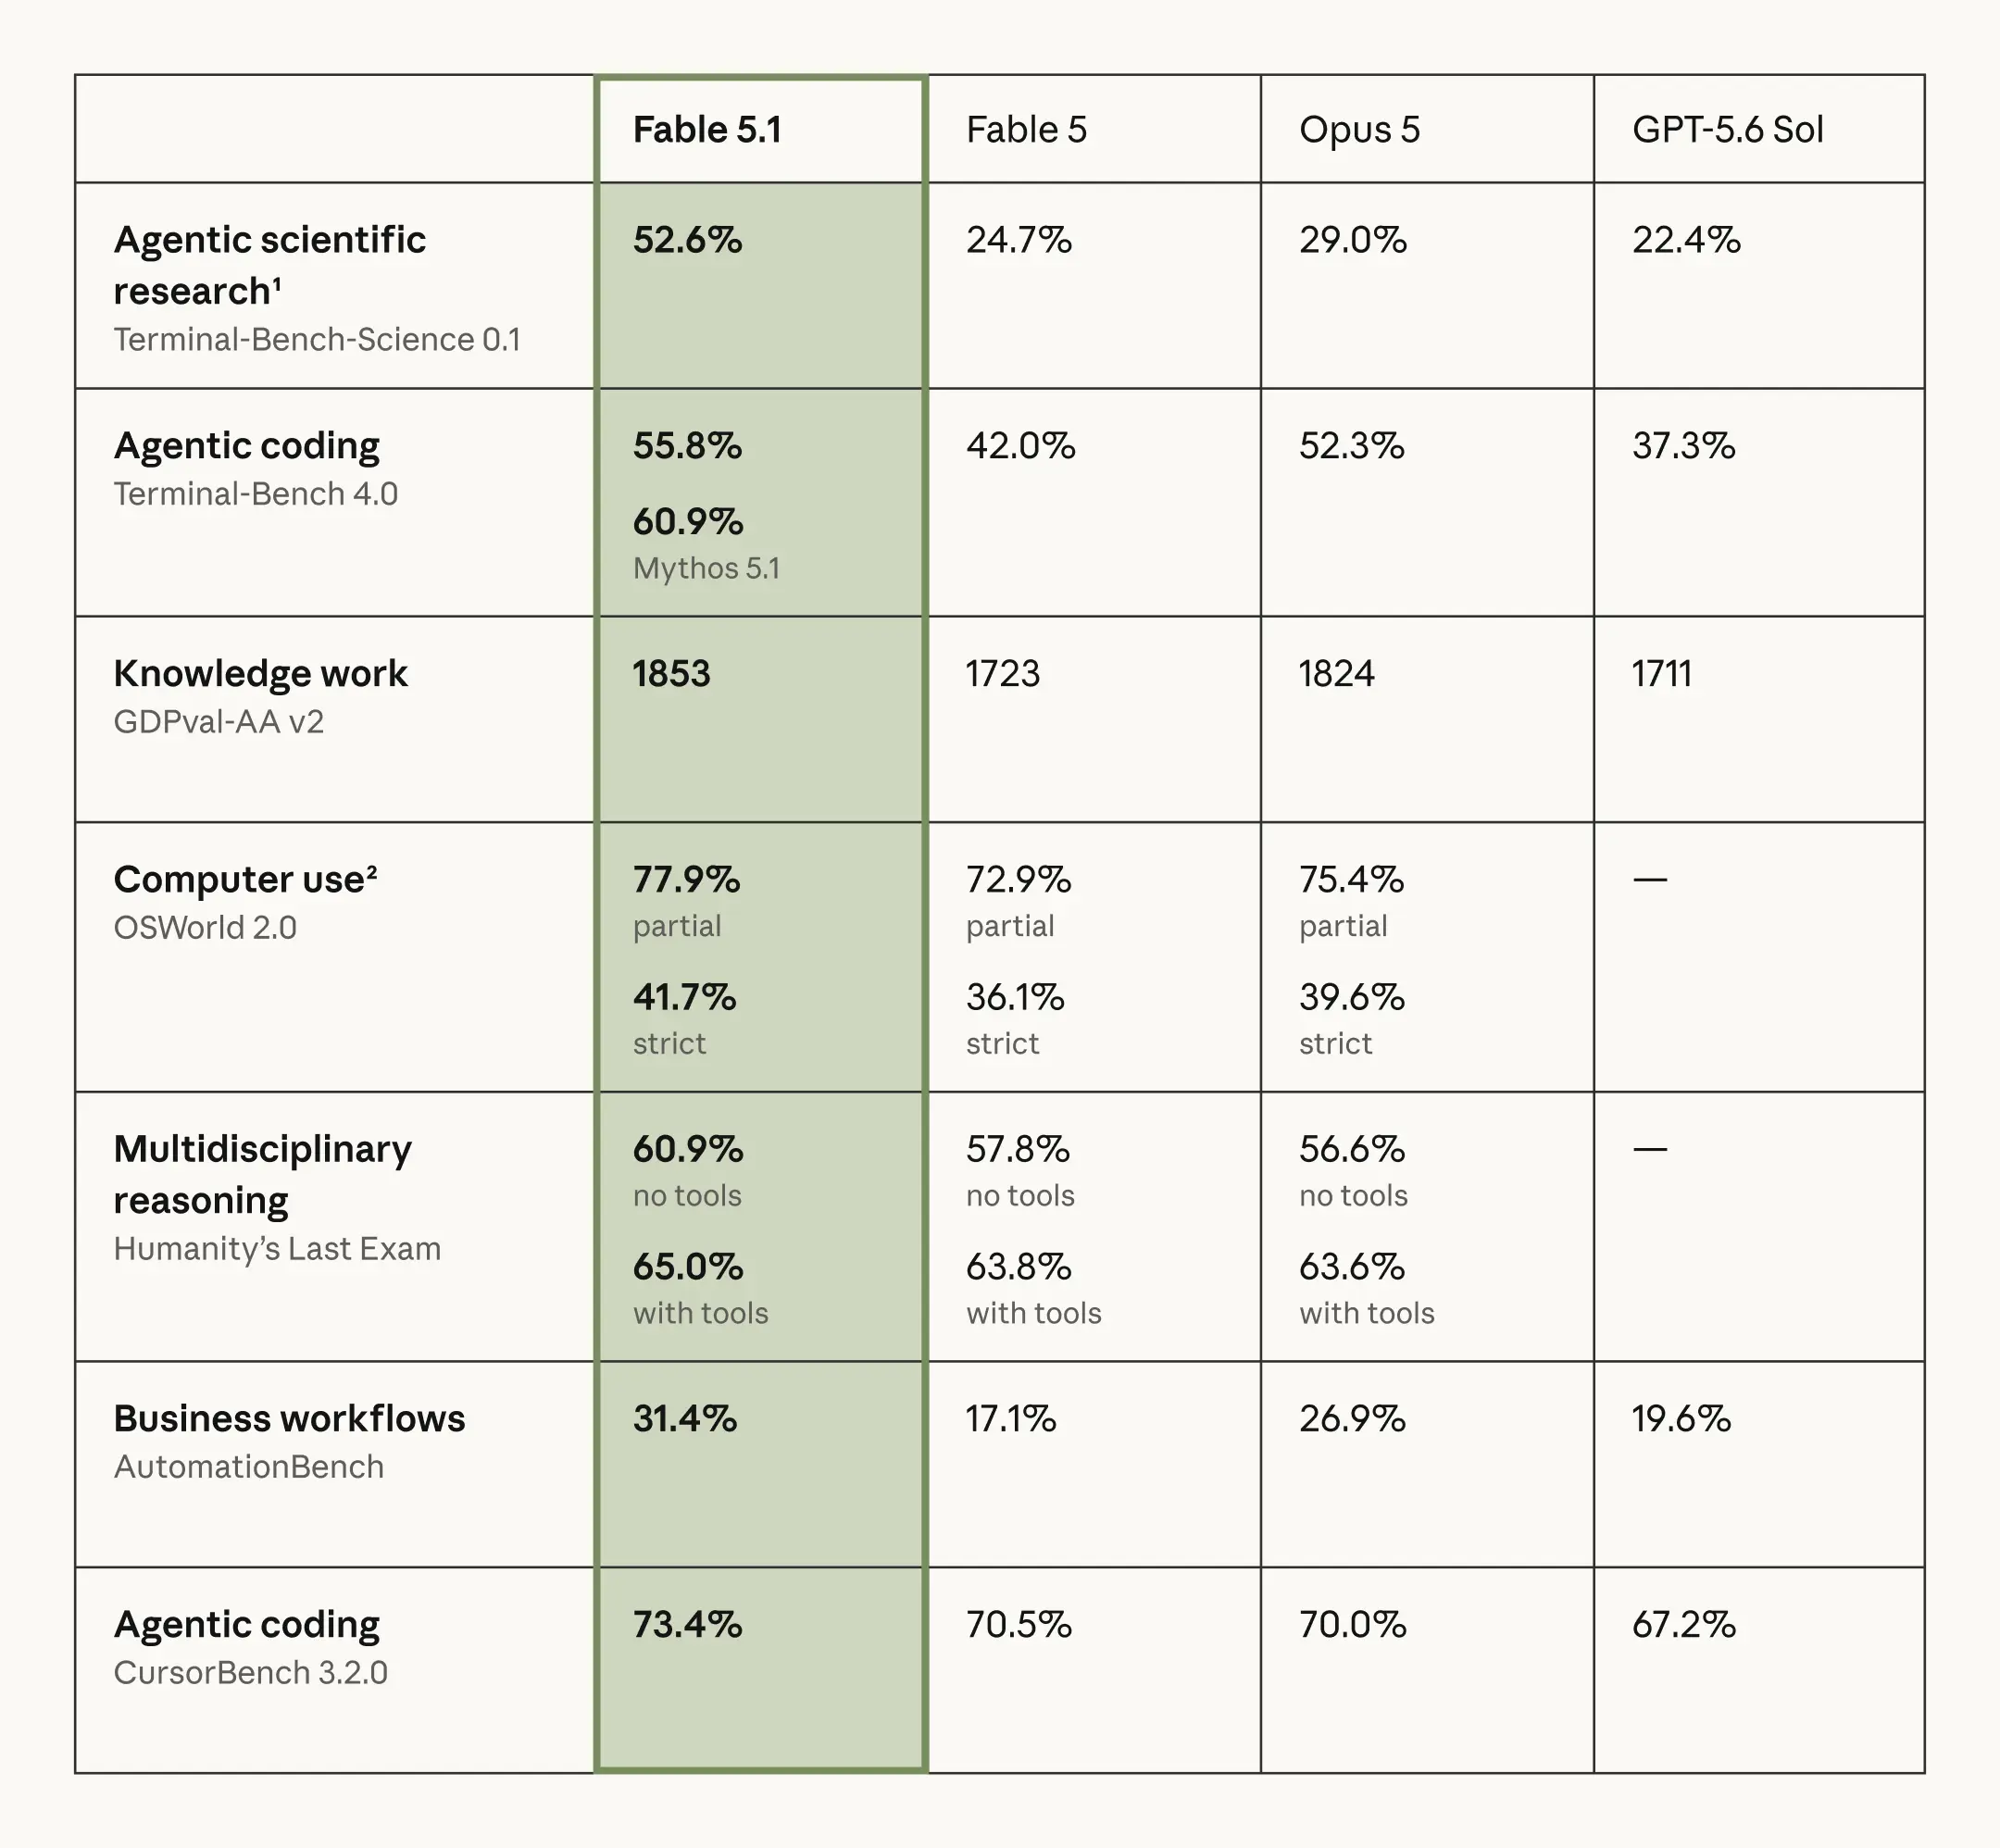
Fable 5.1 keert het resultaat om op Humanity’s Last Exam met tools, met 65.0% tegen Astra’s 57.2%. Anthropic’s officiële benchmarktabel rapporteert onafhankelijk hetzelfde 65.0%-resultaat voor Fable 5.1.
| Redenering-/wetenschapsbenchmark | GPT-6 Astra | Claude Fable 5.1 | Winnaar |
|---|---|---|---|
| FrontierMath Tier 4 v2 | 97.6% | 87.8% | Astra |
| GPQA Diamond | 96.0% | 93.7% | Astra |
| Terminal-Bench Science 0.1 | 64.6% | 52.6% | Astra |
| Humanity's Last Exam, met tools | 57.2% | 65.0% | Fable 5.1 |
| Artificial Analysis Intelligence Index | 61.2 | 65.7 | Fable 5.1 |
Dit onderscheid is belangrijk. FrontierMath en Terminal-Bench Science leggen de nadruk op gespecialiseerde wiskundige of wetenschappelijke probleemoplossing, vooral wanneer redeneren interacteert met tools en externe omgevingen. Humanity’s Last Exam is breder en multidisciplinair. Een praktische lezing is dat Astra sterker lijkt bij diep technische, tool-uitgevoerde redenering, terwijl Fable 5.1 een voorsprong behoudt op bredere frontier-redeneer-evaluaties.
Bron: Anthropic officiële benchmark
Computergebruik en professioneel werk geven de voorkeur aan GPT-6 Astra
Een directe Astra-versus-Fable 5.1 OSWorld-vergelijking zou misleidend zijn. De Anthropic benchmarknotitie zegt dat Fable 5.1 de taakrelease van augustus 2026 van de auteurs gebruikt. De grafiek rapporteert 77.9% gedeeltelijk en 41.7% strikt, maar die cijfers zijn niet equivalent aan het OpenAI-resultaat van 72.6%.
| Professionele benchmark | GPT-6 Astra | Claude Fable 5.1 | Resultaat |
|---|---|---|---|
| AutomationBench | 41.4% | 31.4% | Astra +10.0 punten |
| BenchCAD | 95.9% | 84.3% | Astra +11.6 punten |
| Terminal-Bench Science | 64.6% | 52.6% | Astra +12.0 punten |
OpenAI traint Astra ook specifiek rond het produceren van documenten, spreadsheets en presentaties en zegt dat het is ontworpen om meerstaps professionele workflows uit te voeren in plaats van enkel de tekstcomponent te genereren. Fable 5.1 is eveneens gebouwd voor langdurige agents, browseroperaties, onderzoek, codering en professionele documentworkflows, maar Astra heeft momenteel sterkere gepubliceerde aanwijzingen voor computer-gemedieerde uitvoering en artefactproductie.
Winnaar voor computergebruiksagents en professionele automatisering: Astra.
GPT-6 Astra vs Claude Fable 5.1 lange context: 1,05M vs 1M is de verkeerde vergelijking
Astra heeft technisch het grotere contextvenster: 1,05 miljoen tokens versus 1 miljoen voor Fable 5.1. Dat verschil van 5% zal waarschijnlijk geen productie-architectuur bepalen. Prijsstelling binnen het contextvenster kan dat wel.
De OpenAI-regel voor prijzen van lange context geldt wanneer een request meer dan 272K inputtokens bevat: input- en cachetarieven verdubbelen, terwijl het outputtarief met 1,5 keer stijgt voor de volledige request. Astra’s effectieve tarieven worden daarmee $20 input, $2 gecachte input en $75 output per MTok.
De specificatie van Fable 5.1 documenteert een 1M-contextvenster met $10 input, $50 output en $0.25 cache-reads per MTok. Voor toepassingen die routinematig 300K, 500K of 900K tokens in een request laden, vertelt de nominale contextvenstergrootte daarom maar de helft van het verhaal.
Voor zeer grote contexten heeft Fable 5.1 de schonere tariefkaart-economie, vooral wanneer een groot deel van de context kan worden gecachet.
GPT-6 Astra vs Claude Fable 5.1 prijsstelling: dezelfde kopprijs, zeer verschillende agent-economie
Bij officiële standaardtarieven beginnen de twee modellen exact gelijk op ongecachte tekstinput en -output.
| Prijsonderdeel | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Input / MTok | $10.00 | $10.00 |
| Output / MTok | $50.00 | $50.00 |
| Cache-schrijf 5 min / MTok | $12.50 | $12.50 |
| Cache-read / MTok | $1.00 | $0.25 |
| Batchkorting input/output | 50% | 50% |
| Toeslag lange context | Boven 272K input | Geen over standaard 1M context |
Het sleutelgetal is niet $10 of $50. Het is $0.25. Anthropic verlaagde Fable 5.1’s cache-readtarief naar $0.25 per miljoen tokens, een kwart van Astra’s standaardprijs van $1 voor gecachte input en een achtste van Astra’s $2 lang-context cachetarief.
Dit kan enorm veel uitmaken voor een agentloop. Een langdurige toepassing kan herhaaldelijk een grote system prompt, tooldefinities, repositorycontext en referentiedocumenten over tientallen beurten meenemen. Wanneer het stabiele prefix herhaaldelijk uit de cache wordt gelezen, stapelt cache-prijsstelling zich op een manier die een single-turn benchmark nooit vastlegt.
De Anthropic workloadschatting zegt dat de lagere cacheprijs de typische Fable 5.1-workloadkosten met ongeveer 25% kan verlagen en sterk agentische workloads tot ongeveer 45%. Dit zijn schattingen van de leverancier en geen universele garanties, maar ze laten zien waarom cache-economie een eigen vergelijkingsdimensie verdient.
Maakt dat Fable 5.1 goedkoper?
Niet automatisch. Een model met duurdere tokens kan nog steeds een lagere rekening opleveren als het de taak oplost met minder tokens, minder retries, minder mislukte toolcalls of minder wallclock-tijd. Daarom is kosten per succesvolle taak informatiever dan prijs per miljoen tokens.
Het praktische prijsverdict is gesplitst: Fable 5.1 wint de tariefkaart voor cache-zware en zeer-lange-context workloads. Astra kan nog steeds winnen op kosten per voltooide taak wanneer het uitvoeringsvoordeel retries, tokenverbruik of runtime materieel vermindert.
CometAPI-prijzen vernauwen de beslissing tot workloadkwaliteit
Beide modellen zijn beschikbaar via CometAPI. De GPT-6 Astra API in CometAPI begint bij $8 per miljoen inputtokens, terwijl de Claude Fable 5.1 API in CometAPI begint bij dezelfde $8 inputprijs. Dat is 20% onder de basisingangsprijs van de providers.
| API-prijsstelling | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Officiële input/output | $10 / $50 | $10 / $50 |
| CometAPI input/output | $8 / $40 | $8 / $40 |
| Verlaging t.o.v. basistarief | 20% | 20% |
Dit creëert een nuttige productiesetup: in plaats van uitsluitend te beslissen op basis van openbare benchmarktabellen, kunnen ontwikkelaars dezelfde workload tegen beide model-ID’s evalueren via één API-omgeving en de acceptatiegraad, tokenconsumptie, latentie, toolstoringen en totale uitgaven vergelijken. Prijzen en factureringsregels kunnen veranderen, dus productie-budgettering moet de live API-configuratie gebruiken in plaats van de waarden in dit artikel hard te coderen.
Toolgebruik en agentontwerp: vergelijkbaar doel, andere filosofie
Beide modellen zijn ontworpen voor agents, maar hun API’s onthullen verschillende filosofieën. GPT-6 Astra ondersteunt een toolrijke Responses API-omgeving. De door OpenAI ondersteunde toolset omvat web search, file search, image generation, code interpreter, hosted shell, Apply Patch, computer use, MCP en tool search. Configureerbare redeneersinspanning laat een toepassing beslissen hoeveel compute wordt besteed.
Fable 5.1’s redeneermodel is anders: adaptief denken is altijd ingeschakeld, met effort gebruikt om diepte te sturen. Anthropic voegde ook per-bericht-inspanning toe, beurtonafhankelijke system messages en leesbare voortgangsupdates tussen toolcalls, die vooral nuttig zijn in lange autonome sessies.
GPT-6 Astra voelt daardoor geoptimaliseerd rond toolbreedte en end-to-end omgevingscontrole, terwijl Fable 5.1 geoptimaliseerd voelt rond persistente lange-horizon redenering en agentcontinuïteit. Geen van beide architectuurstijlen is universeel superieur; jouw orkestratielaag is net zo belangrijk als het ruwe model.
Waarom veiligheids- en implementatiebeperkingen ertoe doen voor GPT-6 Astra en Claude Fable 5.1
OpenAI beschrijft Astra als het eerste model dat de Critical cybersecurity-drempel van het bedrijf haalt en zet extra waarborgen in rond hoog-capabele workflows. Dezelfde aankondiging beschrijft productiemonitoring en taakonderbreking wanneer een agent zijn geautoriseerde scope kan overschrijden.
Fable 5.1 gebruikt een andere waarborgarchitectuur. Anthropic stelt dat sommige cyberbeveiligings- en biologieaanvragen die door zijn safeguards worden geïdentificeerd, kunnen worden gerouteerd naar minder capabele modellen. Dat betekent dat een productiescore zowel het onderliggende model als de safeguards eromheen kan weerspiegelen.
Dit is nog een reden waarom cross-vendor benchmarktabellen niet als perfect gecontroleerde laboratoriumvergelijkingen moeten worden behandeld. Enterprise-evaluaties moeten weigeringen, fallback-gedrag, taakonderbreking, auditvereisten, gegevensretentie en privacycontroles omvatten in plaats van ze pas na modelselectie te overwegen.
GPT-6 Astra vs Claude Fable 5.1: welk model moet je kiezen?
| Workload | Aanbevolen model | Waarom |
|---|---|---|
| Autonome agent voor computergebruik | Astra | Sterkere gepubliceerde aanwijzingen voor computergebruik en professionele uitvoering |
| Agentische terminal-/software-engineering | Astra | Leidt Terminal-Bench, DeepSWE en database-migratieresultaten |
| Wetenschappelijke toolworkflows | Astra | Sterke FrontierMath-, GPQA- en Terminal-Bench Science-resultaten |
| Brede frontier-redenering | Fable 5.1 | Leidt HLE met tools en de Intelligence Index |
| Langdurige asynchrone agent | Fable 5.1 | Ontworpen rond agentisch werk met lange horizon en voortgangsupdates |
| 300K–1M-token-requests | Fable 5.1 | Vermijdt Astra’s toeslag voor lange context in standaardprijsstelling |
| Zwaar prompt-cachehergebruik | Fable 5.1 | $0.25/MTok officiële cache-reads |
| Automatisering van documenten/spreadsheets/presentaties | Astra | Sterke positionering voor professioneel werk en artefactgeneratie |
| Grote repository met herhaald gecachte context | Fable 5.1 | Cache-economie kan domineren in herhaalde agentloops |
| Gemengde productie-workloads | Test beide | Verschillende sterke punten maken workloadrouting nuttiger dan een universele winnaar |
Als jouw toepassing het model vraagt om te handelen, moet Astra meestal het eerste model zijn om te testen. Als de toepassing het model vraagt om lang na te denken over een zeer grote en herhaaldelijk hergebruikte context, verdient Fable 5.1 evenveel of meer aandacht.
GPT-6 Astra vs Claude Fable 5.1: welke is overall beter?
Er is geen nette 10–0-uitslag. Astra wint meer van de direct vergelijkbare, door leveranciers gepubliceerde rijen, met bijzonder consistente voordelen bij code-uitvoering, wetenschappelijke tooling, computergebruik en professionele automatisering. Voor ontwikkelaars die een agent bouwen die software moet bedienen in plaats van enkel te bespreken wat te doen, is dat een substantieel voordeel.
Fable 5.1’s overwinningen zijn smaller maar strategisch belangrijk. De 65.0% Humanity’s Last Exam-score en de sterkere Intelligence Index-score laten zien dat Astra niet simpelweg domineert in algemene redenering. Fable 5.1 heeft ook een structureel prijsvoordeel voor cache-zware agents en requests die een groot deel van het miljoen-token contextvenster gebruiken.
De diepere verschuiving is dat de selectie van frontier-modellen verschuift van “welke chatbot geeft het slimste antwoord?” naar “welk systeem voltooit deze taak correct tegen de laagste totale kosten?”
Hoe je ze voor je eigen toepassing vergelijkt
Een openbare ranglijst moet je shortlist verkleinen, niet je productiebeslissing maken. Bouw een vaste evaluatieset van echte taken. Voer identiek inputmateriaal uit tegen beide modellen, behoud equivalente toolrechten en meet niet alleen of het uiteindelijke antwoord er goed uitziet, maar of de taak daadwerkelijk slaagt.
Voor een agentische toepassing zijn nuttige metrics onder meer totale taaksucces, menselijke acceptatiegraad, mislukte tool-calls, retries, tijd tot voltooiing, ongecachte input, cache-reads, outputtokens en totale API-uitgaven.
Een eenvoudige productiemetric is totale API-uitgaven ÷ geaccepteerde voltooide taken.
Dat cijfer kan een benchmark-gebaseerde beslissing omkeren. Een model dat meer per token rekent, kan goedkoper zijn als het minder retries nodig heeft. Een model met goedkope caching kan dramatisch goedkoper worden over een agentloop van 50 beurten. Een model dat hoger scoort in isolatie kan verliezen zodra jouw tools, retrieval-laag en echte acceptatiecriteria worden geïntroduceerd.
Astra en Fable 5.1 zijn beschikbaar via CometAPI; de sterkste productiestrategie is niet noodzakelijk om permanent aan één provider vast te houden. Houd het model configureerbaar, evalueer beide tegen dezelfde acceptatiecriteria en routeer elke workload naar het model dat daadwerkelijk het beste presteert.
Veelgestelde vragen
Is GPT-6 Astra beter dan Claude Fable 5.1?
Astra is sterker op verschillende direct vergelijkbare benchmarks voor codering, wetenschap en professioneel werk, waaronder Terminal-Bench, DeepSWE, FrontierMath en AutomationBench. Fable 5.1 leidt op Humanity’s Last Exam met tools en de Artificial Analysis Intelligence Index. Geen van beide modellen wint op elke dimensie.
Welk model is beter voor codering?
GPT-6 Astra is het betere model voor codering, vooral voor agentische codering en uitvoering. OpenAI’s gepubliceerde vergelijking rapporteert 57.9% voor Astra versus 55.8% voor Fable 5.1 op Terminal-Bench 4.0, met grotere Astra-voorsprongen op DeepSWE en de database-migratie-evaluatie. Claude Fable 5.1 blijft zeer competitief voor langdurig repositorywerk, maar Astra heeft het sterkere totale bewijs voor codering.
Welk model is beter voor lange context?
Claude Fable 5.1 is de betere keuze voor lange-context workloads, vooral voor zeer grote requests en herhaald prompt-cachegebruik. Beide modellen bieden ongeveer een miljoen tokens context, maar GPT-6 Astra past hogere tarieven toe wanneer input 272K tokens overschrijdt, terwijl Fable 5.1 een eenvoudiger tariefstructuur behoudt en aanzienlijk goedkopere prompt-cache-reads biedt.
Welke is goedkoper?
Geen van beide modellen is goedkoper op het standaard basistarief—ze staan gelijk; Claude Fable 5.1 is goedkoper voor cache-zware en zeer-lange-context workloads. Officiële basisprijs is $10 per miljoen inputtokens en $50 per miljoen outputtokens voor beide modellen. Via CometAPI beginnen GPT-6 Astra en Fable 5.1 momenteel beide op $8 per miljoen inputtokens en $40 per miljoen outputtokens. Fable 5.1 krijgt het kostenvoordeel wanneer prompt-cache-reads of Astra’s toeslag voor lange context materieel worden.
Moeten ontwikkelaars slechts één van beide gebruiken?
Niet noodzakelijk. Hun sterke punten zijn voldoende complementair dat een evaluatie- of routingstrategie met meerdere modellen beter kan presteren dan één model voor elke request kiezen. Test echte productie-workloads en vergelijk kosten per geaccepteerde voltooide taak in plaats van te vertrouwen op één benchmarkscore.