
TLDR Op 28 juni 2026 kondigde Elon Musk aan dat Grok 4.5 — gebouwd op xAI’s nieuwe V9-fundamentmodel met 1,5 biljoen parameters, met aanvullende trainingsdata van het Cursor AI-codingplatform — de private bèta is ingegaan bij SpaceX en Tesla. Interne evaluaties claimen prestaties “dicht bij, mogelijk beter dan” Claude Opus van Anthropic, met doorlopende RLHF- en Grok Build-verbeteringen.
Voor ontwikkelaars en bedrijven die vandaag frontier-modellen integreren, biedt CometAPI onmiddellijke, kostenefficiënte toegang tot Grok 4.3 (en andere xAI-modellen) via één OpenAI-compatibel endpoint naast 500+ modellen van Anthropic, OpenAI, Google en meer — vaak met 20%+ besparing ten opzichte van directe prijzen, zonder promptlogging voor privacygerichte workflows.
Belangrijkste punten
- Een geciteerde regel die aan Elon Musk wordt toegeschreven, zegt dat Grok 4.5 in private bèta is bij SpaceX en Tesla, verspreid door AshutoshShrivastava.
- TestingCatalog meldt dat Grok 4.5 draait op een 1,5T V9-fundamentmodel met Cursor-data toegevoegd in aanvullende training.
- Het enige signaal met bewijslabel is Mark Kretschmanns screenshot van 28 juni waaruit blijkt dat het versienummer van het Grok / Cursor Composer 3-model uit xAI-menu’s is verwijderd.
- Er zijn geen benchmarkcijfers, prijzen, contextvenster of API-timing bekendgemaakt in deze set signalen.
- Het Cursor-trainingsdataverhaal bouwt sinds 16 juni op via minstens drie accounts, waarbij Mark Kretschmann Grok 5 koppelt aan een 6T- en 10T-parameterpaar in de Fable 5-gewichtsklasse.
Releasedatum van Grok 4.5
Grok 4.5 ging op 28 juni 2026 in private bèta en staat gepland voor publieke release op 9 juli 2026 (morgen, per 8 juli).
Het bouwt voort op eerdere versies zoals Grok 4 (uitgebracht rond juli 2025) en Grok 4.3. Het zou kort na de aankondiging toegankelijk moeten worden voor in aanmerking komende gebruikers (bijv. SuperGrok/Premium+-abonnees). Voor API wordt CometAPI onmiddellijk na de release geïntegreerd met de grok 4.5-API en zal het een lagere aanschafprijs bieden.
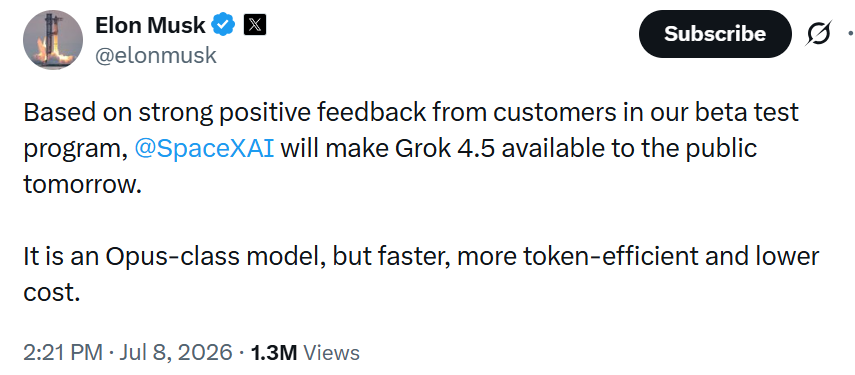
Public Release: Today (July 8, 2026),[ Musk posted that], op basis van positieve beta-feedback, SpaceXAI / xAI Grok 4.5 morgen beschikbaar stelt voor het publiek (9 juli). Het wordt omschreven als een "Opus-klasse"-model dat sneller, token-efficiënter en goedkoper is dan vergelijkbare modellen.
Signalen uit de architectuur van grok 4.5: wat we hebben gezien
De primaire bron is Elon Musks eigen X-bericht van 28 juni 2026:
“Grok 4.5, gebaseerd op ons 1,5T V9-fundamentmodel, met Cursor-data toegevoegd in aanvullende training, is nu in private bèta bij SpaceX & Tesla. Vroege evaluaties tonen prestaties die dicht bij, wellicht voorbij Opus liggen. RL blijft het model significant verbeteren, en het Grok Build-harnas wordt elke dag beter…”
Dit werd versterkt door accounts zoals @testingcatalog en @ai_for_success, met architectuurdetails over de 1,5T V9 en Cursor-integratie: "Grok 4.5 is gebaseerd op 1,5T V9-fundamentmodel, met Cursor-data toegevoegd in aanvullende training."
Cursor-signaal: xAI/SpaceX’ beweging richting overname of diep partnerschap met Cursor (Anysphere) voor ~$60B biedt een rijke bron van echte ontwikkelaars-IDE-traces, agentische workflows en multi-file-bewerkingsdata. Deze aanvullende training (na pretraining) differentieert Grok 4.5 voor codingtaken, al merken experts op dat integratie tijdens de pretraining nog sterker zou zijn.

Bron: @mark_k
Het menu-statussignaal is smaller maar meer bewijsachtig. Volgens Mark Kretschmanns post van 28 juni werd het versienummer voor het Grok 1.5T / Cursor Composer 3-model in de ochtend van 28 juni uit xAI-menu’s verwijderd. Hij beschrijft dat als een patroon dat vooraf kan gaan aan xAI-releases. Dit is geen formele lancering, maar het is concreter dan een gereposte prestatieclaim omdat het is gekoppeld aan een screenshot.
Het latere kanariesignaal duwde het verhaal verder. TestingCatalog spotted een Grok-web-UI-string met de tekst "Unlock the full power of Chat with Grok 4.5." Dat soort trace duikt vaak op vóór een productwijziging, maar kan ook worden laten vallen, uitgesteld of verborgen achter een beperkte uitrol.
Wat we redelijkerwijs van Grok 4.5 kunnen verwachten
- Verbeterde coding- en agentische prestaties: Aanvullende Cursor-data zou SWE-Bench-achtige taken, redeneren over meerdere bestanden en echte ontwikkelaarsworkflows moeten verbeteren. Verwacht sterke punten in technische redenering, debuggen en engineering op productieschaal — gebieden die aansluiten bij SpaceX/Tesla-gebruiksscenario’s.
- Schaal en efficiëntie: Met 1,5T parameters op geoptimaliseerde V9 (Blackwell-era GPU’s via Colossus) balanceert het brute kracht met inference-haalbaarheid. RL-verbeteringen na bèta kunnen gaten in redenering dichten.
- Snelle iteratie: Musk noemde maandelijks nieuwe modellen vanaf scratch. Grok 4.5 fungeert als tussenstap, met een grotere 2T+-run die Cursor-data al vanaf pretraining incorporeert.
- Multimodaal en toolgebruik: Voortbouwend op eerdere Grok-capabilities (vision, search, Grok Build) mag je uitgebreide agentische features verwachten.
- Publieke uitroltijdlijn: UI-traces suggereren dagen tot weken voor bredere toegang. Historische patronen duiden op 1–2 weken van teaser tot preview.
Voor productiegebruik vandaag: Integreer in de tussentijd via de Grok-endpoints van CometAPI. Hun OpenAI-compatibele API ondersteunt naadloos schakelen en biedt kostenbesparingen (bijv. Grok 4 tegen gereduceerde tarieven), ideaal om apps te bouwen die eenvoudig upgraden naar Grok 4.5. Bekijk CometAPI Grok-aanbod voor details.
De harde feiten komen uit officiële docs, en de officiële docs zijn stil over Grok 4.5. xAI’s modelpagina vermeldt grok-build-0.1 als een codingmodel dat specifiek is getraind voor agentische codingworkflows, met een contextvenster van 256k en $1.00 / $2.00 per 1M input-/outputtokens in de xAI-prijsdocs. Het vermeldt grok-4.3 voor algemeen gebruik, met een contextvenster van 1M tokens en $1.25 / $2.50 per 1M input-/outputtokens. De xAI-paginamet ratelimieten bevat Grok 4.3 en Grok Build 0.1, en de xAI function-calling-docs leggen het huidige toolgebruik uit, maar geen van die pagina’s vermeldt Grok 4.5.
Die afwezigheid doet ertoe. Een model kan intern echt zijn en toch niet beschikbaar via de publieke API. Teams moeten “xAI test dit mogelijk” scheiden van “ontwikkelaars kunnen dit inzetten”.
Publieke discussie is nog steeds nuttig voor een smallere doelstelling: het vertelt ons wat bouwers als eerste moeten testen.
De vervolgvragen zijn nuttiger dan de hype:
- Vermindert Cursor-stijl data mislukte patchpogingen?
- Navigeert Grok 4.5 repositories beter dan Grok 4.3 of Grok Build?
- Verslaat het Claude Opus 4.8 op echte multi-file-taken?
- Heeft het minder retries, minder toolcalls of minder menselijke review nodig?
- Blijft het concurrerend wanneer latentie en outputlengte worden gemeten?
- Generaliseert het buiten Cursor-achtige workflows?
Behandel X-threads als signalen, niet als specificaties. De specificaties beginnen wanneer xAI zijn modeldocs of releasenotes bijwerkt.
Grok 4.5 vs Claude Opus: verwachte prestaties
De echte routeringsvraag is niet “Is Grok 4.5 spannend?” Het is: Moet een coding- of agent-workflow Grok 4.5 gebruiken in plaats van Claude Opus 4.8 zodra Grok 4.5 beschikbaar komt?
Claude Opus 4.8 is de schone baseline omdat Anthropic publieke documentatie en benchmarkdata heeft. Anthropics modeloverzicht vermeldt Claude Opus 4.8 met een contextvenster van 1M tokens en 128k max output. Anthropics Opus 4.8-aankondiging positioneert het rond complexe agentische taken, coding en enterprise-usecases, terwijl de prijspagina de officiële API-prijsbasis geeft.
De system card van Opus 4.8 geeft echte cijfers. In de evaluatiesamenvatting rapporteert Opus 4.8 88,6 op SWE-bench Verified, 69,2 op SWE-bench Pro, 74,6 op Terminal-Bench 2.1, 83,4 op OSWorld-Verified en 1890 op GDPval-AA.
Verwachte sterke punten van Grok 4.5:
- Codingspecialisatie: Cursor-data biedt een uniek voordeel in echte ontwikkelaarstraces die door synthetische benchmarks worden ondergewaardeerd. Eerdere Grok-modellen waren al competitief op coding; dit kan het op agentische taken verder vooruit helpen.
- Schaal & Snelheid: 1,5T parameters + Colossus-infrastructuur kan sterke throughput en long-context-verwerking opleveren.
- Kosten/toegankelijkheid: xAI-modellen zijn vaak scherp geprijsd; CometAPI verlaagt de kosten verder (bijv. Grok 4-serie met aanzienlijke besparingen).
Sterke punten van Claude Opus (huidige vlaggenschip):
- Bewezen benchmarks: Hoge SWE-Bench (~80%+ in recente versies), sterke redenering (GPQA, ARC-AGI), uitstekende instructievolging en safety.
- Volwassen ecosysteem: Robuust toolgebruik, artifacts en enterprise-features.
Vergelijkingstabel (geprojecteerd/beredeneerd op basis van beschikbare data)
| Aspect | Grok 4.5 (Verwacht) | Claude Opus (Huidig) |
|---|---|---|
| Parameters | 1,5T (V9) | Niet bekendgemaakt (dense/expert-mix) |
| Coderen (SWE-Bench, geschat) | Competitief/leidend (Cursor-boost) | ~80%+ Verified |
| Algemene redenering (GPQA/MMLU) | Dicht bij/boven Opus | Leidend |
| Contextvenster | Groot (geprojecteerd 200k+) | 200k+ |
| Prijs (via API) | Competitief (goedkoper via CometAPI) | Premium |
| Dataspecialisatie | Cursor-IDE-traces | Breed + gecureerd |
| Beschikbaarheid | Private bèta → binnenkort? | Publieke API |
| Trainingscadans | Maandelijks vanaf scratch | Iteratief |
Behandel de Opus-vergelijking als benchmarkdoel, niet als conclusie. Als Grok 4.5 werkelijk dicht bij of voorbij Opus ligt, zou dat zichtbaar moeten zijn in het aantal opgeloste taken, minder retries, minder reviewer-edits en betere herstelcapaciteit in tool-loops. Als het alleen demo’s wint, is dat niet genoeg voor productieroutering.
Drie technische schaduwzones
Het migratierisico is niet alleen de modelkwaliteit. Drie minder zichtbare details kunnen een Grok 4.5-uitrol duur of fragiel maken.
1. Verbeteringen afgestemd op Cursor vertalen mogelijk niet naar jouw coding-stack
Als het trainingssignaal afkomstig is van Cursor-workflows, is het model mogelijk het sterkst in Cursor-achtige bewerkpatronen. Jouw productiesysteem kan anders zijn: server-side agents, CI-repairbots, GitHub-issue-triage, interne repo-migratie of lokale developer-assistants.
Evaluatiechecklist:
- Neem echte repositories op, geen speelgoedprompts.
- Neem taken op die lezen vóór bewerken vereisen.
- Neem herstel van mislukte tests op.
- Scoor uiteindelijke patch-correctheid, niet alleen antwoordkwaliteit.
- Vergelijk plain chat-modus met agentmodus.
- Meet of Grok 4.5 retries verlaagt vergeleken met Opus 4.8 en Grok 4.3.
2. Prestaties in private bèta kunnen afhangen van interne frameworks
Een model dat binnen SpaceX of Tesla wordt getest kan voordeel hebben van interne tools, gecureerde prompts, private evaluatietaken of gespecialiseerde retrieval. Een publieke API-versie kan zich anders gedragen.
Evaluatiechecklist:
- Leg de exacte model-ID en releasedatum vast.
- Noteer toolbeschikbaarheid voor elke run.
- Scheid modelkwaliteit van frameworkkwaliteit.
- Volg p50- en p95-latentie.
- Volg toolfouten en ongeldige toolaanroepen.
- Vergelijk geen interne-agent-demo met een ruwe API-call.
3. Prijzen en contextlimieten kunnen benchmarkwinsten tenietdoen
Zelfs als Grok 4.5 sterker is, is het mogelijk niet goedkoper. Tokentarieven, contextvenster, outputlimiet, prompt-caching, ratelimieten en kosten van tool-calls doen er allemaal toe.
Gebruik deze routeringsmetriek:
Effectieve kosten per opgeloste taak = (primaire modelkosten + retry-kosten + fallback-kosten + kosten voor menselijke review) / succesvolle taken
Als Grok 4.5 meer taken oplost met minder retries, kan een hogere tokenprijs het waard zijn. Als het meer tokens gebruikt, langer loopt of meer review vereist, vertaalt de launch-hype zich niet naar lagere werkbelastingkosten.
Grok 4.5 zelf evalueren
Gebruik de lekperiode om de evaluatie voor te bereiden voordat het model verschijnt.
1. Stel een set van 20 taken voor code-agents samen
Neem echte taken op:
- bugfix in je eigen repo
- refactor over meerdere bestanden
- dependency-migratie
- herstel van falende test
- codereview met subtiele regressie
- documentatie-update gekoppeld aan code
- UI-bug op basis van screenshot plus broncode
- SQL- of datapijplijnprobleem
- tool-calling-workflow
- long-context vraag over een repository
2. Voer dezelfde taken uit op beschikbare baselines
Wacht niet op Grok 4.5 om te beginnen met meten. Voer dezelfde taken uit op:
- Grok 4.3 voor huidige xAI algemene redenering
- Grok Build 0.1 voor de officiële xAI-codingmodel-baseline waar beschikbaar
- Claude Opus 4.8 voor hoogwaardige coding en agentisch werk
- Claude Sonnet 5 voor lagere-kosten productieroutering
- je huidige productiemodel
3. Meet de kosten per opgeloste taak
Houd bij:
- invoertokens
- uitvoertokens
- toolcalls
- retries
- mislukte patches
- test-passrate
- latentie
- reviewer-edits
- uiteindelijke pass/fail-score
- kosten per geaccepteerde patch
Vergelijk geen eenmalige outputs. Vergelijk dezelfde taken, dezelfde instructies, dezelfde tools en dezelfde beoordelingsrubriek.
4. Voeg Grok 4.5 pas toe na publieke beschikbaarheid
Wanneer xAI of CometAPI een stabiele Grok 4.5-model-ID beschikbaar stelt, voeg die dan toe aan dezelfde evaluatie. Herschrijf de evaluatie niet rond het nieuwe model. Het punt is juist een benchmark stabiel genoeg te houden dat de vergelijking betekenisvol is.
5. Beslis per werkbelastingklasse
Gebruik het winnende model per taaktype, niet per merk:
- Gebruik het goedkopere model wanneer het taalsucces vergelijkbaar is.
- Gebruik Opus 4.8 wanneer fouten duur zijn en Grok 4.5 geen pariteit heeft bewezen.
- Gebruik Grok 4.5 alleen waar het je huidige baselines op je eigen taken verslaat.
- Houd een fallback-route aan totdat foutpercentages, latentie en kosten stabiel zijn.
Wat we weten vs. wat we nog niet kunnen verifiëren
Bevestigd / sterk gesignaleerd:
- 1,5T V9-fundament + Cursor-aanvullende training.
- Private bèta bij SpaceX/Tesla (28 juni 2026).
- Musk-toegeschreven claim “dicht bij/beter dan Opus”.
- Maandelijkse nieuwe model-roadmap.
- UI-kanarie-traces.
Ongeverifieerd / open vragen:
- Exacte benchmarks (geen system card).
- Publieke releasedatum en API-prijzen.
- Volledig contextvenster, multimodale capaciteiten.
- Precieze Cursor-datavolume, licentie en mixratio.
- Prestaties vs. specifieke Opus-versie of andere frontiers (bijv. GPT-5.5, Gemini 3.x).
- Grok 4.5 vs. geruchte grotere Grok 5-varianten.
Behandel claims als vendor-richtinggevend. De geschiedenis laat zien dat interne evaluaties kunnen verschillen van publieke; onafhankelijke verificatie is essentieel.
Waar op te letten de komende tijd
Let de komende weken op vijf zaken:
- xAI-modeldocs die een Grok 4.5-model-ID toevoegen.
- xAI-releasenotes die publieke of preview-beschikbaarheid bevestigen.
- Onafhankelijke coding-agent-benchmarks, vooral SWE-bench, Terminal-Bench en Cursor-stijl coding-agent-taken.
- Echte ontwikkelaarsrapporten over Cursor-achtige codingworkflows.
- CometAPI-catalogus of dashboardupdates voor Grok 4.5-beschikbaarheid.
Het eerste betrouwbare koopsignaal is geen virale X-post. Het is een model-ID plus herhaalbare evaluatieresultaten.
Toekomstperspectief: maandelijkse modellen en verder
Het tempo van xAI — maandelijks nieuwe fundamentmodellen — kan iteratiesnelheid herdefiniëren. Grok 4.5 is een incrementele sprong; Grok 5-varianten beloven meer. Verwacht aanhoudende nadruk op waarheidsvinding, humor en praktische bruikbaarheid in lijn met Musks visie.
Call to Action: Meld je vandaag nog aan bij CometAPI om krachtige Grok-modellen betaalbaar te gebruiken en voorop te blijven. Volg x.ai en X voor officiële Grok 4.5-updates. De AI-codingrevolutie versnelt — positioneer je workflows nu.