Bouwen met CometAPIHeb je één API voor meerdere modellen nodig?Test de workflow in Playground en maak daarna een API-sleutel aan wanneer het model en de kosten passen bij je use case.
Wat is promptcaching? OpenAI vs Claude vs Gemini in 2026
Leer hoe promptcaching in 2026 werkt. Vergelijk OpenAI, Claude en Gemini qua cachemethoden, TTL's, prijzen, prestaties, Python-voorbeelden en CometAPI-toegang.
Deon GoodwinOnderzoeksteam voor AI-modellen en API
Promptcaching stelt taalmodellen in staat eerder verwerkte promptprefixen te hergebruiken in plaats van dezelfde invoerberekening te herhalen. Het kan de kosten voor invoertokens verlagen en de latentie verbeteren, vooral voor agent-workflows, klantenondersteuning, RAG en analyse van grote documenten. In 2026 biedt OpenAI automatische caching en nieuwere expliciete cachebesturing, Claude ondersteunt automatische en cachebreekpunten op blokniveau, en Gemini legt de nadruk op impliciete caching voor zijn nieuwste modellen. Providers rekenen verschillend af voor cache-schrijfbewerkingen, -leesbewerkingen en, waar van toepassing, opslag. Verloop kan een nieuwe write of een volledige invoerkostenpost triggeren, dus de werkelijke besparingen hangen af van hergebruikfrequentie en gemeten cachehits.
Deze gids vergelijkt promptcaching in GPT-6.1 Sol, Claude Opus 5.5 en Gemini 4 Argon voor ontwikkelaars die toepassingen bouwen met herhaalde invoer. De focus ligt op cachebesturing, prijsstelling en hoe hergebruik te verifiëren.
Key Takeaways
Promptcaching hergebruikt verwerkte invoer—niet het vorige antwoord van het model.
Gecontroleerd op duidelijkheid, bronvermelding en actuele API-terminologie.
OpenAI-promptcaching hangt af van een stabiele prefix, ondersteunde modelfuncties en modelspecifieke minimumvereisten en retentie-instellingen.
Claude-promptcaching biedt TTL's van 5 minuten en optioneel 1 uur met automatische en expliciete cachecontrole.
Gemini-contextcaching is impliciet op moderne modellen; expliciete cacheresources blijven modelafhankelijk.
Besparingen door promptcaching hangen af van cache-schrijfbewerkingen, -leesbewerkingen, opslag en daadwerkelijke hits; verifieer endpointsupport en facturatie van gecachete tokens bij gebruik van CometAPI.
What Is Prompt Caching in LLMs?
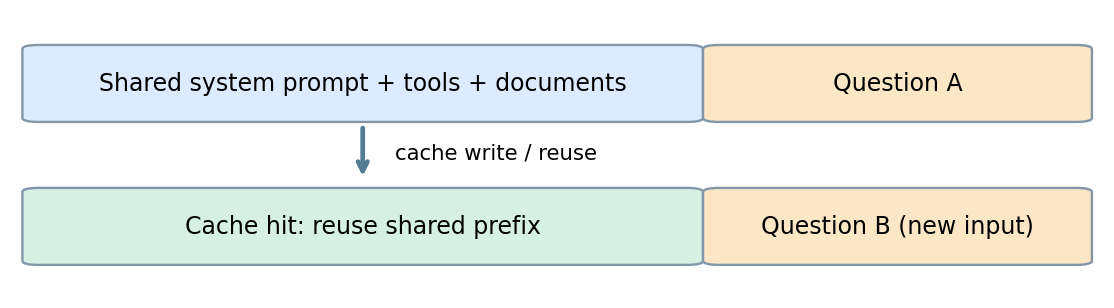
Promptcaching is een inferentie-optimalisatie die hergebruik mogelijk maakt van de computationele staat die is afgeleid van een eerder verwerkte prefix. Een prompt bevat vaak stabiele instructies, tooldefinities of documenten, gevolgd door een veranderende gebruikersvraag. Als een latere aanvraag dezelfde in aanmerking komende prefix herhaalt, kan de provider gecachete key-value (KV)-toestanden hergebruiken en alleen het niet-gecachete restant verwerken. In tegenstelling tot caching van antwoorden wordt er geen vorig antwoord afgespeeld: het model genereert een nieuw antwoord voor de huidige aanvraag.
Promptcaching-workflow:
Eerste aanvraag: stuur een grote, herhaalbare prefix en een specifieke vraag.
Cachecreatie: de provider slaat in aanmerking komende tussenliggende computationele toestanden op.
Volgende aanvraag: hergebruik dezelfde prefix en vervang de vraag.
Cache-read: eerder verwerkte tokens worden hergebruikt terwijl nieuwe tokens normaal worden verwerkt.
Conceptuele illustratie aangeleverd bij het oorspronkelijke concept: herhaald promptmateriaal gaat vooraf aan een veranderende vraag. Dit is geen officieel architectuurdiagram van een provider.
Het gemeenschappelijke ontwerpprincipe is prefixstabiliteit. De API-contracten, in aanmerking komende modelfamilies, cachelevensduur en tarieven zijn niet onderling uitwisselbaar.
OpenAI, Claude, and Gemini Caching at a Glance
Hetzelfde principe van een stabiele prefix geldt voor alle providers, maar de onderstaande besturingselementen zijn specifiek voor de modellen die in deze gids worden gebruikt. Controleer model en endpoint samen voordat je een instelling kopieert.
Opt-in via cache_control op aanvraagniveau of per contentblok
Impliciete caching standaard ingeschakeld
Minimum prefix
1,024 zichtbare invoertokens
512 tokens vóór de cachegrens
4,096 invoertokens
Lifetime controls
Responses API: prompt_cache_options.ttl; 30m standaard of 12h
5 minuten standaard; optionele TTL van 1 uur
Door provider beheerde impliciete levensduur
Where to place stable content
Voorste instructies, tools en referentiemateriaal
Stabiele tooldefinities, systeemcontent of berichtblokken vóór het breekpunt
Grote gedeelde content aan het begin van de prompt
Usage to inspect
input_tokens_details.cached_tokens en gerapporteerde cache-write-usage
cache_creation_input_tokens en cache_read_input_tokens
cached_content_token_count in usage_metadata, indien aanwezig
Important distinction
prompt_cache_key kan de boekhouding scheiden; is niet vereist voor Sol's automatische routing
Het breekpunt moet eindigen op content die ongewijzigd blijft
Geen expliciete cacheresource voor Argon; oudere ondersteunde modellen bieden een aparte interface
Prompt Caching Controls and Python Examples
Elk voorbeeld verstuurt hetzelfde referentiemateriaal met twee verschillende vragen. Houd de gedeelde content ongewijzigd, voer de aanvragen sequentieel uit en inspecteer de gebruiksgegevens om te zien of het tweede verzoek daadwerkelijk gecachete invoer heeft hergebruikt.
OpenAI: Cache Controls and Python Example
OpenAI matcht automatisch cache-in aanmerking komende promptprefixen en staat, op ondersteunde nieuwere modellen, expliciete breekpunten en retentieconfiguratie toe. Cachehergebruik is vooral nuttig wanneer lange systeeminstructies, toolschema's of repositorycontext terugkeren over meerdere aanvragen. De vereiste prefixlengte en tokenprijsmultipliers zijn afhankelijk van de modelgeneratie en de geselecteerde retentielaag.
Het voorbeeld gebruikt de Responses API met prompt_cache_options ingesteld op de modus implicit en een levensduur van 30 minuten. Eerdere modelgeneraties gebruiken andere retentieparameters; volg de instellingen voor jouw exacte model.
Installeer de openai-SDK en stel OPENAI_API_KEY in. Gebruik minimaal 1,024 zichtbare tokens in de stabiele prefix. Voer beide aanvragen sequentieel uit en controleer input_tokens_details.cached_tokens en cache_write_tokens in de usage. Een positief aantal gecachete tokens bevestigt een in rekening gebrachte cache-read; het garandeert niet in elk geval een lagere latentie.
Om de voorbeelden uit te voeren, installeer de relevante Python-SDK, stel de API-sleutel van de provider in en maak een UTF-8 reference.txt-bestand met voldoende stabiele content om aan het cachingminimum van dat model te voldoen.
from pathlib import Path
from openai import OpenAI

client = OpenAI()  # Reads OPENAI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
questions = ["Summarize the architecture.", "Identify the main technical risks."]
for question in questions:
    response = client.responses.create(
        model="gpt-6.1-sol",
        instructions="Use the following reference material.\n" + shared,
        input=question,
        prompt_cache_key="docs-assistant-v1",
        prompt_cache_options={"mode": "implicit", "ttl": "30m"},
    )
    print(response.output_text)
    print(response.usage)
Claude: Cache Controls and Python Example
In de Claude Messages API is promptcaching opt-in. Voeg cache_control toe op aanroepniveau voor automatische plaatsing van een breekpunt, of koppel het aan een contentblok om een expliciet breekpunt te markeren. Ontwikkelaars kunnen stabiele instructies, documenten en geselecteerde promptblokken markeren, terwijl de latere gebruikersinvoer verandert. De standaardcache met korte duur is vijf minuten, met een optie van één uur voor geschikte workloads.
Installeer de anthropic-SDK en stel ANTHROPIC_API_KEY in. Voor Claude Opus 5.5 moet je minimaal 512 tokens vóór de cachegrens aanleveren. Houd het systeemblok identiek over de aanvragen heen. Een cache-item wordt beschikbaar zodra de eerste respons start; dit voorbeeld wacht op de volledige respons voor eenvoud. Inspecteer de aantallen voor cachecreatie en -lezen; een korte prefix kan voor beide nul teruggeven zonder een fout op te werpen.
from pathlib import Path
import anthropic

client = anthropic.Anthropic()  # Reads ANTHROPIC_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=1024,
        system=[{
            "type": "text",
            "text": shared,
            "cache_control": {"type": "ephemeral"},
        }],
        messages=[{"role": "user", "content": question}],
    )
    print(response.content)
    print(response.usage.cache_creation_input_tokens)
    print(response.usage.cache_read_input_tokens)
Gemini: Implicit Caching and Python Example
Google noemt zijn implementatie contextcaching. Gemini 4 Argon gebruikt impliciete caching en ondersteunt geen expliciete cacheresources. Sommige eerdere modelfamilies ondersteunen expliciete caches met een configureerbare TTL. Kies de cachinginterface op basis van het contract van het individuele model in plaats van aan te nemen dat alle Gemini-modellen dezelfde besturingselementen bieden.
Installeer google-genai en stel GEMINI_API_KEY in. Gebruik minimaal 4,096 tokens aan gedeelde leidende content voor Gemini 4 Argon, en verstuur het tweede verzoek kort na het eerste. Controleer cached_content_token_count in usage_metadata indien aanwezig. Impliciete caching kan missen, zelfs wanneer de prefix in aanmerking komt.
from pathlib import Path
from google import genai

client = genai.Client()  # Reads GEMINI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.models.generate_content(
        model="gemini-4-argon",
        contents=shared + "\nQuestion: " + question,
    )
    print(response.text)
    print(response.usage_metadata)
How Much Does Prompt Caching Cost Across OpenAI, Claude, and Gemini?
Cachekosten moeten worden beoordeeld als de combinatie van schrijfbewerkingen, leesbewerkingen en—op sommige systemen met expliciete caches—retentie of opslag. De volgende multipliers illustreren gangbare ontwerpen en zijn geen universele prijsbeloften over modelversies heen.
Cost category
OpenAI
Claude
Gemini
Uncached input
Normaal tarief voor invoertokens
Normaal tarief voor invoertokens
Normaal tarief voor invoertokens
Cache write
Schrijfpremies mogelijk bij nieuwere modellen
Premies voor 5m/1h
Impliciet of expliciet modelspecifiek
Cache read
Verlaagd modelspecifiek tarief
Verlaagd modelspecifiek tarief
Verlaagd modelspecifiek tarief
Cache lifetime
Modelspecifiek
5m / 1h
Impliciet beheerd / expliciet configureerbaar
Additional storage
Afhankelijk van model
Meestal verdisconteerd in de schrijftaak
Expliciete opslagkosten kunnen van toepassing zijn
Illustratief voorbeeld: een prefix van 10,000 tokens wordt hergebruikt over N aanvragen, de initiële cache-write kost 1,25 keer de gewone invoerkosten en daaropvolgende cache-reads kosten 0,1 keer de gewone invoerkosten. Ga uit van een basistarief van $2 per miljoen tokens en perfecte cachehits na de eerste aanvraag.
Number of requests
Without caching
With caching
Savings on reused prefix
10
$0.200
$0.043
78.50%
100
$2.000
$0.223
88.85%
Formula: Cached prefix cost = 1.25P + (N − 1) × 0.1P, where P is the ordinary cost of processing the shared prefix once. This example excludes dynamic input, output, expirations, misses, storage and other services.
Het bovenstaande voorbeeld gebruikt een illustratief read-tarief van 10%, niet het huidige tarief van GPT-6.1 Sol. Sol's standaardprijzen voor short context zijn $2 per miljoen niet-gecachte invoertokens, $0.10 per miljoen gecachte invoertokens en $2.50 per miljoen tokens die worden geschreven met de standaardlevensduur. Bereken het voorbeeld opnieuw met jouw daadwerkelijke model, laag en endpointfacturering.
Een langere levensduur is alleen de moeite waard als deze voldoende herhaalde writes of niet-gecachte aanvragen voorkomt om de prijs te compenseren. Claude's writes van 5 minuten en 1 uur worden respectievelijk belast met 1,25× en 2× van de basisinvoer. Expliciete Gemini-caches op ondersteunde oudere modellen kunnen ook opslagkosten met zich meebrengen. Meet hergebruik over echte idle-gaten, niet alleen een burst van back-to-back calls.
Reken misses, verloop en outputgeneratie mee in de rekening. Als een prefix verloopt voordat deze opnieuw wordt gebruikt, kan de volgende aanvraag een nieuwe write of volledige invoerverwerking vereisen. Korte prompts komen mogelijk helemaal niet in aanmerking, terwijl lange antwoorden ervoor kunnen zorgen dat outputtokens de grootste kostenpost blijven, zelfs bij sterk cachehergebruik. Vergelijk de totale kosten per afgeronde taak voordat je meer cachingcomplexiteit toevoegt.
Which Prompt Caching API Is Best for Different Workloads?
Voor code-agents en klantenondersteuning plaats stabiele tooldefinities, repositorycontext, beleidsregels en kennis vóór de veranderende taak. OpenAI en Claude bieden breekpuntbesturing die helpt herbruikbare grenzen te definiëren; evalueer de daadwerkelijke cache-reads van het endpoint in plaats van aan te nemen dat herhaalde tekst is gecachet.
Voor documentanalyse en multimodale taken houd het brondocument of ondersteunde media vóór de vraag. Gemini’s impliciete aanpak vermindert het cachebeheerwerk, terwijl Claude je het stabiele blok direct laat markeren. Controleer ondersteuning voor het specifieke mediatype en model voordat je op hergebruik vertrouwt.
Voor lange gesprekken voeg nieuwe beurten toe in plaats van het begin steeds opnieuw te herschrijven, en kies een beschikbare levensduur die past bij de gaten tussen beurten. Als je toepassing een benoemde cacheresource nodig heeft die expliciet kan worden gemaakt en gerefereerd, evalueer dan een Gemini-model dat die interface ondersteunt; Argon doet dat niet.
Er is geen universele winnaar: vergelijk cachehit-rate, kosten per afgeronde taak en latentie onder je werkelijke verkeerspatroon.
How Does Prompt Caching Affect Latency and Performance?
Een cachehit vermindert herhaalde invoerverwerking en kan de tijd tot de eerste token verkorten. Het verbetert niet inherent de antwoordkwaliteit en versnelt de outputgeneratie niet, en gecachete invoer neemt nog steeds ruimte in in het contextvenster. Meet zowel de latentie tot de eerste token als de totale responstijd op vergelijkbare aanvragen; een cachehit op zichzelf is geen bewijs dat de gebruiker het definitieve antwoord sneller ontving.
How to Optimize Prompt Caching and Troubleshoot Misses
Start with a Stable, Useful Prefix
Plaats herbruikbare instructies, tooldefinities, beleidsregels en documenten vooraan; zet tijdstempels, aanvraag-ID’s, veranderende context en de vraag van de gebruiker daarna. Houd de volgorde en schema’s van tools stabiel. Eindig bij expliciete caching het breekpunt op het laatste ongewijzigde blok. Voeg nuttig referentiemateriaal toe wanneer het de taak helpt; blaas niet elke aanvraag kunstmatig op enkel om een cachemetric te halen.
If Cached Tokens Stay at Zero
Controleer de geschiktheid voordat je de prompt wijzigt: bevestig het exacte model, endpoint, de minimale tokenlengte en de vereiste cachecontrole-instellingen. Verstuur vervolgens twee sequentiële aanvragen met identieke gedeelde content. Inspecteer cachecreatie en cache-reads afzonderlijk; de eerste aanvraag kan het item maken dat een latere aanvraag kan hergebruiken. Een impliciete cache komt in aanmerking om te hitten, maar is niet gegarandeerd.
Voor Claude kan een aanvraag onder het minimum voor zowel cachecreatie als -read nul teruggeven zonder fout. Het cache-item wordt beschikbaar zodra de eerste respons start. De Claude-cachinggids legt ook uit hoe de plaatsing van breekpunten en veranderende aanroepinstellingen het hergebruik beïnvloeden.
If Hits Disappear Between Requests
Vergelijk de daadwerkelijke payloads, niet alleen de prompttemplate. Zoek naar gewijzigde documenttekst, herschikte tools, aangepaste schema’s, herschreven vroege conversatierondes of dynamische velden die vóór de herbruikbare grens zijn ingevoegd. Controleer de verstreken tijd sinds de eerdere aanvraag en of de gekozen levensduur deze dekt. Verander één variabele tegelijk en noteer de resulterende usage.
If Hits Do Not Produce Savings
Splits gecachete invoer, writes, niet-gecachete invoer, output en eventuele opslagkosten. Herhaalde writes na idle-gaten, weinig hergebruik of lange gegenereerde antwoorden kunnen invoerkortingen tenietdoen. Gebruik de bovenstaande kostenberekening met gemeten usage en de daadwerkelijke tarieven van het endpoint. Houd een optimalisatie alleen aan als deze de totale taakkosten of de voor de gebruiker zichtbare latentie verbetert.
Check Endpoint Support and Data Boundaries
Een compatibiliteitsendpoint kan een aanvraag accepteren zonder dezelfde cachebesturing of usagevelden bloot te leggen als de native API. Bevestig parametersupport en vergelijk geretourneerde usage met accountfacturatie voordat je hergebruik als besparing beschouwt. Houd tenantisolatie en toegangscontroles in stand en volg de retentie- en gegevensverwerkingsbeleid van de provider. Caching vervangt die controles niet.
How Can You Use Prompt Caching with CometAPI?
CometAPI biedt één integratiepunt voor het testen van aanvragen over modelfamilies heen. Voor caching verifieer je welke providerspecifieke besturingselementen het gekozen endpoint accepteert en hoe gecachete invoer verschijnt in usage en facturatie. Ontwikkelaars kunnen modeltesten centraliseren terwijl ze aparte validatie behouden voor cachinggedrag en boekhouding, aangezien native provideropties niet gegarandeerd identiek zijn over proxy- of compatibiliteitsendpoints.
Voor modelspecifieke setup, zie de CometAPI-pagina’s voor GPT-6.1 Sol, Claude Opus 5.5 en Gemini 4 Argon. Bevestig dat je gekozen endpoint het cachinggedrag ondersteunt dat je nodig hebt.
Installeer de openai-SDK en stel COMETAPI_KEY in. Dit voorbeeld verstuurt aanvragen met herhaalde prefix via de OpenAI-compatibele Chat Completions-interface van CometAPI. Bevestig modelbeschikbaarheid en inspecteer vervolgens de geretourneerde usage en accountfacturatie voor bewijs van cachehergebruik. Kopieer geen Responses API-cacheparameters naar dit endpoint zonder ondersteuning te controleren.
import os
from pathlib import Path
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.chat.completions.create(
        model="gpt-6.1-sol",
        messages=[
            {"role": "system", "content": shared},
            {"role": "user", "content": question},
        ],
    )
    print(response.choices[0].message.content)
    print(response.usage)
Conclusion
Voor AI-toepassingen met veel herhaling kan promptcaching een materieel verschil maken in de inferentiekosten. OpenAI geeft ontwikkelaars steeds gedetailleerdere prompt- en retentiecontrole; Claude biedt handige automatische en blokniveaucontroles; Gemini maakt impliciet hergebruik eenvoudig in moderne modellen. De juiste implementatie hangt af van volume aan stabiele prompts, hit-rate, verloop en totale kosten. Begin met een duidelijke gedeelde prefix, verifieer gebruikstelemetrie en optimaliseer vervolgens retentie en providerkeuze op basis van metingen die op productie lijken.
FAQ
How can I compare caching providers fairly?
Speel dezelfde nuttige brondocumenten en equivalente vragen af, maar gebruik de eigen tokenaantallen en daadwerkelijke tarieven van elke provider. Houd de outputvereisten vergelijkbaar en rapporteer mislukte aanvragen net zo goed als geslaagde. Een vast aantal tekens impliceert niet hetzelfde aantal tokens, dus vergelijk kosten per afgeronde taak naast metingen van cachehits.
Should I cache every document in a changing knowledge base?
Groepeer documenten op hoe vaak ze veranderen en hoe vaak ze worden hergebruikt. Een document dat vaak wordt bijgewerkt kan herhaaldelijk een grote gedeelde prefix ongeldig maken; door stabiel beleid eerst en veranderlijk materiaal later te plaatsen, kun je die blootstelling verminderen. Versieer het bronmateriaal doelbewust en ververs het wanneer correctheid dat vereist, ook als dat het cachehergebruik vermindert.