Bouwen met CometAPIHeb je één API voor meerdere modellen nodig?Test de workflow in Playground en maak daarna een API-sleutel aan wanneer het model en de kosten passen bij je use case.
Wat is Gemini 4 Carbon? Benchmarks, functies & prijzen
Ontdek Gemini 4 Carbon, het nieuwe frontier-AI-model van Google. Verken benchmarks voor cyberbeveiliging, functies, prijzen, vergelijkingen en beschikbaarheid.
Deon GoodwinOnderzoeksteam voor AI-modellen en API
Gemini 4 Carbon is het frontiermodel van Google DeepMind voor veeleisende engineering en defensieve cybersecurity. Aangekondigd op 28 oktober 2026, verbetert het ten opzichte van Argon in gepubliceerde evaluaties op het gebied van coderen, beveiliging en lange-context. Introductietarieven zijn $2 per miljoen invoertokens en $10 per miljoen uitvoertokens, maar toegang is aanvankelijk beperkt tot geselecteerde cyberverdedigers en vertrouwde partners. Voor ontwikkelaars ligt de kans in krachtiger autonoom werk; de directe beperking is toegang.
Key Takeaways
Gemini 4 Carbon is Google’s volgende frontiermodel na Argon, geoptimaliseerd voor langdurige, meerdaagse agentische engineering en cybersecurity-verdediging.
Gemini 4 Carbon staat op #1 in de Artificial Analysis Intelligence Index v5.0 (score 59), vóór Claude Opus 5.5 (58) en GPT-6 Astra (57). Sterke verbeteringen in coderen, full‑stack webontwikkeling (+89 Elo op WebDev Arena naar #4), wetenschappelijke redenering, multimodaal begrip en alignment (0.0% succes op de Gray Swan Indirect Prompt Injection Benchmark).
Gecontroleerd op duidelijkheid, bronvermelding en actuele API-terminologie.
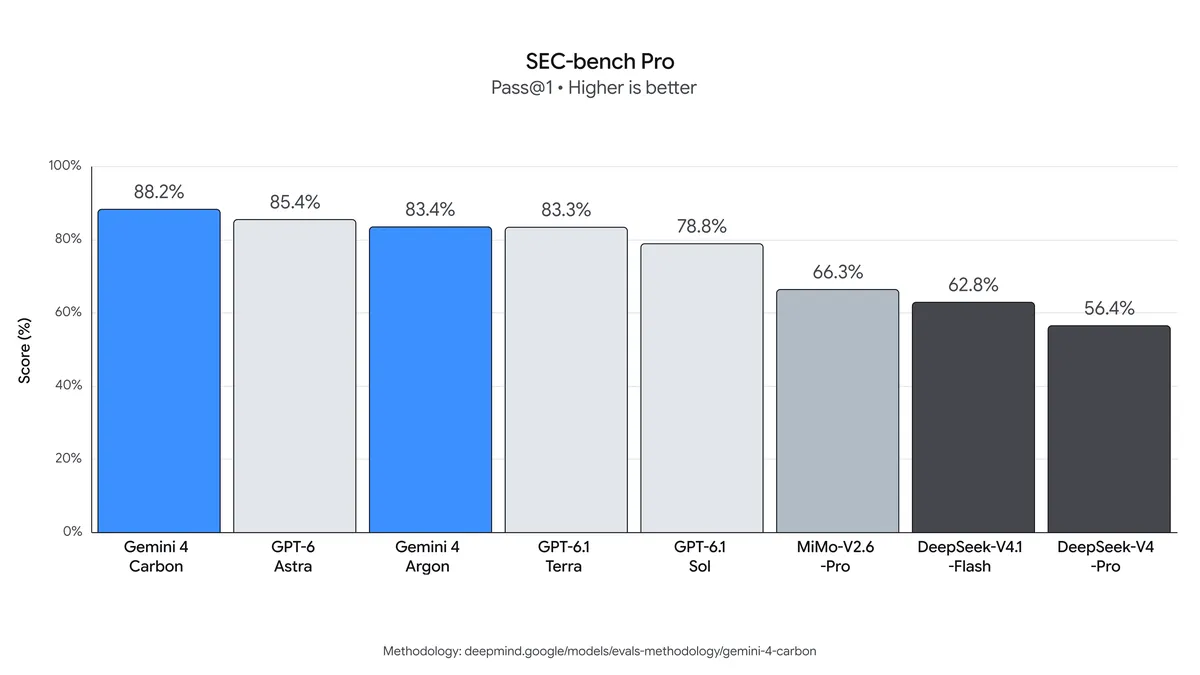
Opvallende cybersecurity-scores (zonder guardrails): 88.2% op SEC-bench Pro (kwetsbaarheden vinden), 54.8% op ExploitGym (exploiteren) en 71.0% op CWE-bench (patchen).
Beperkte initiële toegang via het Fairwind Program voor cyberverdedigers; publieke API en bredere uitrol volgen later.
Zelfde introductieprijs als Argon; na de introductieperiode gelden standaardtarieven.
Platforms zoals CometAPI ondersteunen de bredere Gemini‑familie (inclusief Argon) al via een uniforme, met OpenAI compatibele API, waardoor het eenvoudig is om van model te wisselen en je voor te bereiden op de bredere release van Carbon. Publieke API‑details en een brede releasedatum zijn nog niet aangekondigd per 29 oktober 2026.
What Is Gemini 4 Carbon?
Gemini 4 Carbon is Google’s nieuwste vlaggenschip‑frontier‑AI‑model, ontworpen voor complexe software‑engineering, cybersecurity‑onderzoek en autonome workflows.
Volgens de officiële aankondiging, bouwt Carbon voort op de basis gelegd door Gemini 4 Argon, met aanzienlijke verbeteringen in coderen, agentische redenering en op beveiliging gerichte taken.
Carbon is ontworpen voor werk dat onderzoek, uitvoering en verificatie over meerdere stappen omvat. Een defensieve engineering‑agent kan bijvoorbeeld een repository inspecteren, een vermoede kwetsbaarheid valideren in een geïsoleerde omgeving, een patch ontwikkelen en testen of de wijziging het oorspronkelijke defect verhelpt.
Google meldt dat interne teams hebben waargenomen dat Carbon meerdere dagen aan complexe engineeringtaken kan werken. Dit zijn interne observaties, geen gepubliceerde garantie op een specifieke autonome runtimeduur. Google heeft geen volledig technisch rapport, parameteraantallen of gedetailleerde architectuurdetails vrijgegeven. Contextvenster en outputlimieten worden verwacht vergelijkbaar te zijn met of beter dan die van Argon (gerapporteerd in het bereik van meerdere miljoenen tokens met hoge outputcapaciteit), en het ondersteunt multimodale input, waaronder tekst, afbeeldingen, video, audio en PDF’s.
What Are the Key Features of Gemini 4 Carbon?
Langetermijn software‑engineering
Carbon is ontworpen voor engineeringproblemen die niet betrouwbaar in één redeneerstap kunnen worden voltooid.
Voorbeelden zijn root‑cause‑analyse over grote repositories, afhankelijkheidsgerelateerde fouten, low‑level systeemdebugging en complexe refactoring.
De verbeteringen richten zich op de mogelijkheid om door te gaan na een mislukte poging.
Een effectieve codeeragent moet herkennen wanneer de eerste oplossing faalt, nieuw bewijs onderzoeken en de aanpak herzien zonder van de oorspronkelijke taak af te dwalen.
Defensieve cybersecurity‑workflows
De beveiligingsresultaten van Carbon omvatten het vinden van kwetsbaarheden, het valideren van exploiteerbaarheid en het patchen van defecten. De relevante vraag voor een securityteam is of een agent kan bewegen van een vermoede kwestie naar een reproduceerbare bevinding en een geteste fix, met respect voor de toegewezen permissies en omgeving.
Lange‑context en multimodaal begrip
Carbon noteert een GraphWalks BFS F1‑score van 96.2% in de subset van 256K–1M tokens, tegenover 84.2% voor Argon. Dit is bewijs voor lange‑context graafredenering, geen garantie op correcte retrieval uit elk document van een miljoen tokens.
De gepubliceerde resultaten voor Chartography en Blueprint‑Bench 2 dekken ook visueel begrip. Deze tests kunnen helpen veelbelovende document‑ en diagramworkflows te identificeren, maar leggen niet het volledige modalitieschema van een toekomstige publieke API vast.
How Does Gemini 4 Carbon Perform on Benchmarks?
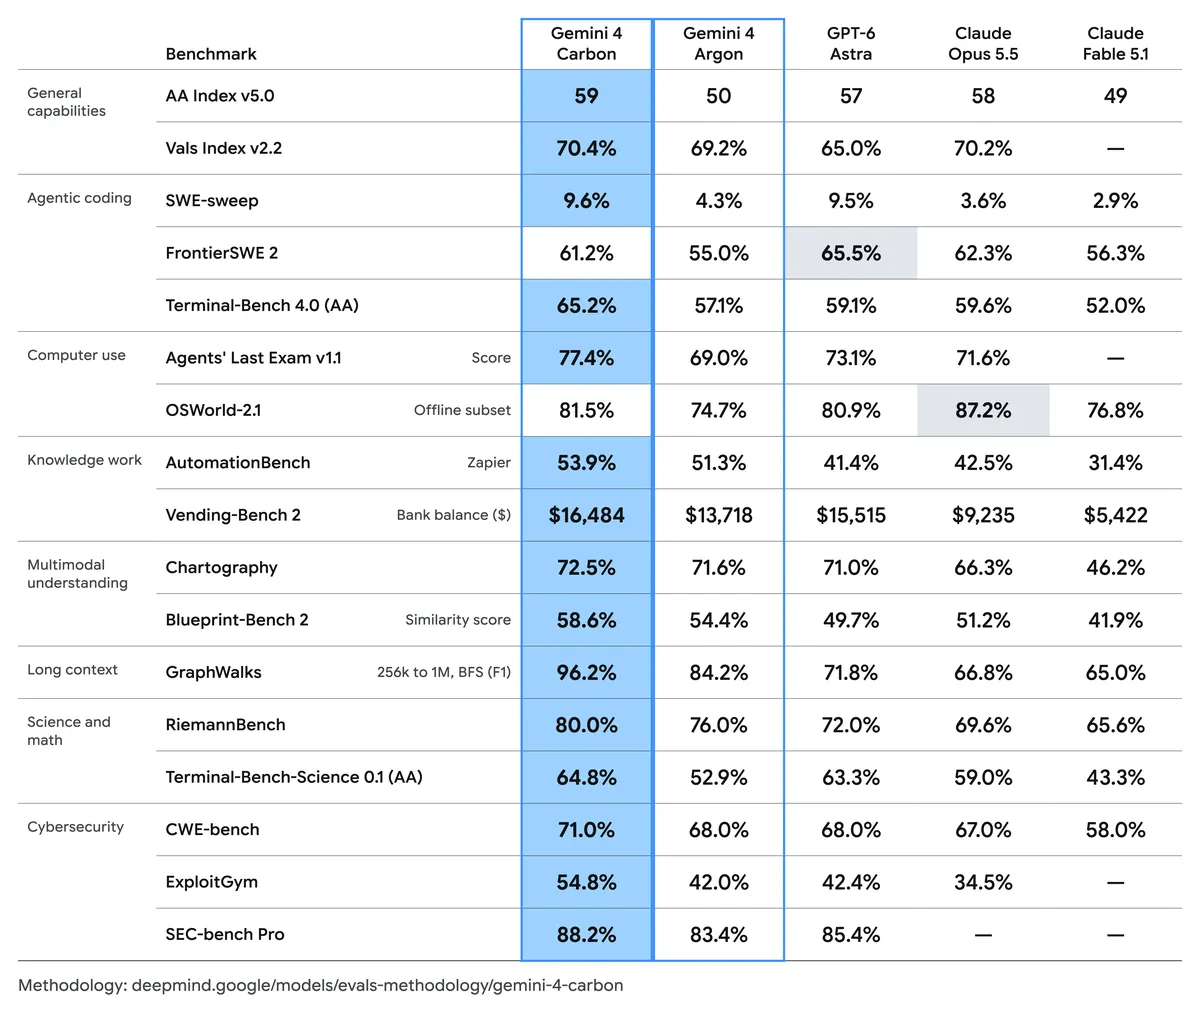
De gepubliceerde resultaten benadrukken drie redenen om Carbon te evalueren: sterker codeervermogen, beter lange‑context redeneren en verbeteringen in de cybersecurity‑workflow. De officiële aankondiging bevat de oorspronkelijke vergelijkingsgrafiek hieronder; de belangrijkste resultaten worden samengevat in de volgende sectie.
Benchmarkresultaten en testcondities
Algemene redenering: Carbon scoort 59 op de AA Intelligence Index v5.0, vergeleken met 50 voor Argon, 57 voor GPT-6 Astra en 58 voor Claude Opus 5.5.
Coderen: Terminal‑Bench 4.0 stijgt van 57.1% naar 65.2%, een verbetering van 8,1 procentpunt ten opzichte van Argon. SWE‑sweep stijgt van 4.3% naar 9.6%.
Lange‑context redeneren: Carbon scoort 96.2% op de GraphWalks 256K–1M‑token BFS F1‑subset, tegenover 84.2% voor Argon.
Waar alternatieven leiden: GPT‑6 Astra scoort 65.5% op FrontierSWE 2 tegenover 61.2% voor Carbon; Claude Opus 5.5 scoort 87.2% op de OSWorld offline subset tegenover 81.5% voor Carbon. Deze vergelijkingen verwijzen naar de modellen en evaluatie‑instellingen in de gepubliceerde grafiek.
Over de 17 geselecteerde resultaten in de oorspronkelijke vergelijking leidt Carbon er 15. Die breedte maakt het een veelbelovende kandidaat voor complexe workflows, maar de twee uitzonderingen laten zien waarom je eigen taakmix ertoe doet. Vergelijk modellen op geaccepteerde resultaten, voltooiingstijd en kosten in plaats van niet‑gerelateerde benchmarkscores te middelen.
De evaluatiemethodologie gebruikt doorgaans de hoogste thinking‑instelling en pass@1, tenzij anders vermeld. Ze combineert door Google uitgevoerde resultaten met externe evaluatoren en door providers gerapporteerde scores, waardoor agentscaffolding en redeneerbudgetten niet identiek zijn voor elke inzending.
GraphWalks: De aangehaalde subset gebruikt 200 problemen en rapporteert BFS F1.
Agents’ Last Exam: De evaluatie gebruikt een set v1.1 met 122 taken, de ALE‑Claw‑harness, een venster van vijf uur en ingeschakelde veiligheidsfilters.
OSWorld: Het gerapporteerde resultaat dekt een subset van 82 offline taken en neemt het maximum over drie runs met één poging.
Codeerprestaties in de praktijk
Carbon verbetert Terminal‑Bench 4.0 van 57.1% naar 65.2%, een stijging van 8,1 procentpunt. SWE‑sweep stijgt van 4.3% naar 9.6%, meer dan een verdubbeling, terwijl het absoluut onder 10% blijft. Die resultaten ondersteunen evaluaties van moeilijke repository‑taken, maar tonen ook waarom onafhankelijke tests en reviews noodzakelijk blijven.
How Strong Is Gemini 4 Carbon at Cybersecurity?
Benchmark en beveiligingstaak
Gemini 4 Carbon
Gemini 4 Argon
Verschil
SEC-bench Pro — kwetsbaarheden vinden
88.2%
83.4%
+4.8 procentpunten
ExploitGym — exploitvalidatie
54.8%
42.0%
+12.8 procentpunten
CWE-bench — kwetsbaarheden verhelpen
71.0%
68.0%
+3.0 procentpunten
De grootste winst zit in exploitvalidatie. Voor een geautoriseerd defensief team kan reproduceerbaar bewijs dat een kwetsbaarheid exploiteerbaar is de prioritering verbeteren; een plausibele bevinding alleen is niet genoeg. Patches hebben nog steeds tests nodig die bevestigen dat het oorspronkelijke defect is verholpen en bestaande functionaliteit behouden blijft.
Google rapporteert de externe beveiligingsevaluaties zonder deployment‑guardrails. SEC‑bench Pro gebruikt een specifieke JavaScript‑engine‑split met 183 taken; ExploitGym gebruikt een offline setup met één poging en mitigaties uitgeschakeld. Deze condities leggen geen onbegrensd productiegdrag vast en geven geen detectiegraad voor willekeurige software in de echte wereld.
Is Gemini 4 Carbon Safer and More Reliable Than Argon?
Onterechte claims namen in interne tests met circa 50% af ten opzichte van Argon.
Agent‑overreach nam met 26% af.
Onder‑service nam met 29% af.
Alerts voor misalignment met hoge ernst daalden met bijna 80% in interne codeeromgevingen.
Succesvol cheaten op Terminal‑Bench 4.0 daalde naar 0.0% in Google’s evaluatie.
Op de geëvalueerde Gray Swan indirect prompt‑injection benchmark is Carbon’s aanvallingssucces 0.0% tegenover 0.7% voor Argon. Dit betekent dat de geëvalueerde aanvallen onder die setup niet slaagden; het bewijst geen immuniteit voor nieuwe aanvallen of andere toolecosystemen.
Deze cijfers komen uit verschillende evaluaties en moeten niet worden samengevoegd tot één betrouwbaarheidsscore.
Voor een productieagent: behoud onafhankelijke permissiecontroles, uitvoerlogs en validatie van geclaimde resultaten. Verbeterd gedrag van een model helpt, maar de applicatie moet nog steeds controleren welke bestanden, services en acties toegankelijk zijn.
How Much Does the Gemini 4 Carbon API Cost?
Google heeft de introductie‑ en vervolgtokentarieven voor Carbon aangekondigd. De onderstaande cijfers voor gecachete input zijn berekend op basis van de aangekondigde 95% korting; de publieke API‑implementatie en toelatingsdetails volgen nog.
Facturatiecategorie, USD per 1M tokens
Introductietarief
Tarief na introductie
Invoertokens
$2.00
$4.00
Uitvoertokens
$10.00
$20.00
In aanmerking komende gecachete invoertokens
$0.10
$0.20
De introductieperiode van Carbon heeft geen aangekondigde einddatum. Argon’s gepubliceerde introductieprijzen eindigen op 30 november 2026; die deadline is niet van toepassing op Carbon. Batch‑prijzen, extra toolkosten en een gratis laag zijn voor Carbon niet aangekondigd.
Voorbeeld van aanvraagkosten
Stel dat een aanvraag 200.000 niet‑gecachete invoertokens en 10.000 totale factureerbare uitvoertokens gebruikt. Tegen de aangekondigde introductietarieven kosten input $0.40 en output $0.10, voor een totaal van $0.50. Hetzelfde tokengebruik zou $1.00 kosten tegen de latere tarieven.
Als alle 200.000 invoertokens in aanmerking komen voor de aangekondigde korting voor gecachete input, wordt de introductieschatting $0.12 inclusief output. Dit is een voorwaardelijke illustratie, geen belofte dat elke herhaalde input in aanmerking komt.
De outputtoelage moet eventuele thinking tokens omvatten die als output worden gefactureerd onder de uiteindelijk geldende regels. Als 10.000 alleen naar het zichtbare antwoord verwijst, zouden extra factureerbare thinking tokens de schatting verhogen. Tools, retries en andere services zijn uitgesloten.
How Can Developers Prepare for the Gemini 4 Carbon API?
Huidige beschikbaarheid van de Gemini 4 Carbon API
Per 29 oktober 2026 begint de toegang met geselecteerde cybersecurity‑verdedigers en breidt geleidelijk uit naar vertrouwde partners. Google’s Fairwind Program beschrijft een gecontroleerd toegangstraject. Een brede ontwikkelaarsrelease en publieke Carbon‑modelidentifier zijn nog niet aangekondigd.
Aangekondigde prijzen betekenen dus niet dat een applicatie vandaag een algemeen beschikbare Carbon‑API kan aanroepen. Het definitieve publieke contextlimiet, maximale output, modalitieschema, toolcompatibiliteit en operationele limieten hebben nog gedocumenteerde productspecificaties nodig.
Per 29 oktober 2026 heeft Google nog geen algemeen beschikbare Carbon‑API gelanceerd, dus Carbon is nog niet beschikbaar via CometAPI. In de tussentijd kun je Gemini 4 Argon gebruiken voor een eerste evaluatie. Controleer de CometAPI Carbon‑pagina voor beschikbaarheid en providerprijzen zodra de toegang opent.
Alternatieven terwijl je wacht op de Carbon API
Je kunt je codeerworkflow alvast evalueren voordat Carbon breed beschikbaar is. Bouw een baseline met een model waar je vandaag toegang toe hebt en vergelijk Carbon op dezelfde taken zodra de API opent. Drie opties om te overwegen zijn Gemini 4 Argon, GPT‑6.1 Astra en Claude Opus 5.5; bevestig de exacte modelnaam, toegang en prijs bij je provider voordat je een route kiest.
Gemini 4 Argon: Begin hier als je al Gemini gebruikt of een directe baseline voor Carbon wilt. Probeer representatieve repository‑wijzigingen, codereviews en bugfixes, en noteer welke outputs je acceptatietests doorstaan.
**GPT-6.1 Astra:** Neem deze op als een provider‑overschrijdende vergelijking voor dezelfde engineeringtaken. Meet geaccepteerde fixes, voltooiingstijd en totale kosten. De eerder besproken GPT‑6 Astra‑resultaten gelden voor die gebenchmarkte versie en moeten niet als scores voor GPT‑6.1 Astra worden beschouwd.
**Claude Opus 5.5:** Voeg deze toe als een andere kandidaat voor repository‑analyse, refactoring en review. Gebruik dezelfde taakomschrijvingen en validatiecriteria, zodat je de praktische waarde van elk resultaat kunt vergelijken.
Houd je modelselectie configureerbaar en bewaar de prompts, testcases en resultaten van elke run. Dat geeft je een nuttig startpunt voor het evalueren van Carbon zonder je workflow te binden aan een onaangekondigd API‑formaat.
Benchmark
Gemini 4 Carbon
Gemini 4 Argon
GPT-6 Astra
Claude Opus 5.5
AA Intelligence Index v5.0
59
50
57
58
Vals Index v2.2
70.4%
69.2%
65.0%
70.2%
SWE-sweep
9.6%
4.3%
9.5%
3.6%
FrontierSWE 2
61.2%
55.0%
65.5%
62.3%
Terminal-Bench 4.0 (AA)
65.2%
57.1%
59.1%
59.6%
Agents' Last Exam v1.1
77.4%
69.0%
73.1%
71.6%
OSWorld-2.1, offline subset
81.5%
74.7%
80.9%
87.2%
AutomationBench, Zapier
53.9%
51.3%
41.4%
42.5%
Bereid een model‑evaluatieworkflow voor
Een praktisch evaluatiekader moet meer meten dan algemene antwoordkwaliteit.
Voor codeer‑ en beveiligingsworkflows zijn nuttige metrics onder andere:
Taakvoltooiingspercentage: hoe vaak voldoet de agent aan vooraf gedefinieerde acceptatietests?
Correctheid van patches: verhelpt de voorgestelde wijziging het oorspronkelijke defect zonder bestaand gedrag te breken?
Percentage vals‑positieven: hoe vaak faalt een gerapporteerde issue bij validatie?
End‑to‑end‑latentie: hoe lang duurt de volledige workflow, inclusief toolexecutie?
Totale taakkosten: hoeveel kost elke geaccepteerde uitkomst na retries en toolgebruik?
Naleving van instructies: blijft de agent binnen geautoriseerde bestanden, tools en acties?
Gebruik een vaste set echte taken en houd een logboek bij van elk model, de instellingen, het tokenverbruik en de testresultaten. Neem retries en handmatige correcties mee in de kosten. Zodra Carbon beschikbaar is, voer je dezelfde evaluatie uit om te zien of het meer geaccepteerd werk levert voor je tijd en budget.
Conclusion
Gemini 4 Carbon is een veelbelovende upgrade voor veeleisend coderen, lange‑context redeneren en defensief security‑werk. De gepubliceerde resultaten tonen duidelijke winsten ten opzichte van Argon, terwijl de toegang per 29 oktober 2026 beperkt blijft. Stel voorlopig een baseline vast met een beschikbaar model en houd je integratie flexibel. Wanneer de publieke API van Carbon opent, vergelijk dan de kwaliteit van voltooid werk, bespaarde tijd en totale kosten voordat je beslist of je moet overstappen.
FAQ
Kan Gemini 4 Carbon draaien zonder menselijke supervisie?
Meldingen van meerdaags intern engineeringwerk vormen geen bewijs van onbewaakte betrouwbaarheid voor willekeurige taken. Een team dat autonome uitvoering overweegt, moet toegestane acties, stopcondities en acceptatietests definiëren en meten hoe vaak de agent werk zonder correctie voltooit. Runtimeduur alleen bewijst niet dat de output van een agent correct is.
Kan een bestaande Argon‑integratie direct overstappen op Carbon?
Niet op basis van het hier beschikbare bewijs. Houd de providerselectie configureerbaar, maar verifieer de daadwerkelijke modelidentifier van Carbon, het ondersteunde schema, tools, limieten en accounttoegang voordat je een deployment wijzigt. Het hergebruiken van een prompt helpt bij een gecontroleerde vergelijking; het bewijst geen API‑compatibiliteit.
Welke Gemini 4 Carbon‑tests zijn relevant voor een private codebase?
Neem representatieve bugs, repository‑wijzigingen en beveiligingsbevindingen met bekende acceptatiecriteria op. Controleer of patches relevante tests doorstaan, of bevindingen reproduceerbaar zijn en of geen niet‑gerelateerd gedrag verandert. Neem mislukte pogingen en handmatige correcties op in de kostenanalyse, zodat een sterke publieke benchmarkscore operationeel werk niet verbergt.