
TL;DR Het Qwen-team van Alibaba lanceerde op 3 augustus 2026 officieel Qwen3.8-Max — een sparse Mixture-of-Experts-model met in totaal 2,4 biljoen parameters (95 miljard actief), een contextvenster van 1 miljoen tokens en native multimodale ondersteuning (tekst + beeld + video).
Het is het eerste Max-klasse Qwen-model waarvan de open gewichten zijn gepland (verwacht in de week erna). Agressief geprijsd op $2 per miljoen inputtokens en $6 per miljoen outputtokens levert het sterke resultaten op langetermijn agentische taken, autonome softwareontwikkeling (inclusief een gedocumenteerd, 16 dagen durend zelf-evoluerend codeproject), reproductie van onderzoek en multimodale benchmarks. Het concurreert nauw met modellen zoals Kimi K3 en positioneert zich boven lichtere opties zoals DeepSeek V4 Flash qua capaciteit, terwijl het bij output-intensieve workloads veel kostenefficiënter blijft dan toonaangevende Westerse frontier-modellen. Ontwikkelaars hebben er vandaag toegang toe via QwenCloud / Alibaba Cloud Model Studio en via geïntegreerde platforms zoals CometAPI.
Belangrijkste punten
- Schaal en efficiëntie: 2,4T totaal / 95B actief MoE-architectuur gebouwd op de fundamenten van Qwen 3.5 biedt frontier-niveau prestaties tegen praktische inferentiekosten.
- Sterk op langetermijn: Aangetoond bij meerdaagse autonome coding (265 commits, 127 PR’s over ~16 dagen zonder menselijke interventie), reproductie + verbetering van onderzoeksartikelen en een jaar aan gesimuleerde e-commerce-activiteiten.
- Benchmark-hoogtepunten: PaperBench 93.0 (leidend), Terminal Bench 2.1 86.6, sterke multimodale en document-scores; competitief maar niet dominant op elke pure coding-agent-ranglijst versus Claude Fable 5 of GPT-5.6 Sol.
- Prijsvoordeel: Vlak $2 / $6 per 1M tokens over de volledige 1M-context (gecachede input ~$0.25), goedkoper dan Kimi K3 op output en veel Westerse modellen.
- Beschikbaarheid: Live op QwenCloud en Alibaba Cloud Model Studio (OpenAI- en Anthropic-compatibele API’s); open gewichten gepland; reeds vermeld op CometAPI als
qwen3.8-maxvoor uniforme toegang naast 500+ andere modellen. Open gewichten komen op korte termijn; kleinere Qwen3.8-27B-variant ook gepland voor praktische lokale/edge-deployments. - Praktisch voordeel: Excelleert in end-to-end productie van deliverables in plaats van enkelvoudige antwoorden — ideaal voor coding-agents, onderzoeks-pijplijnen, kantoorworkflows en langdurige agent-lussen.
Wat is Qwen3.8-Max?
Qwen3.8-Max is Alibaba’s nieuwste en meest capabele vlaggenschipmodel in de Qwen-serie, officieel uitgebracht op 3 augustus 2026 (na een preview medio juli op de World AI Conference in Shanghai). Het vertegenwoordigt een bewuste verschuiving naar modellen die complexe, meerdaagse taken end-to-end met minimale supervisie kunnen afronden en productierijpe deliverables kunnen opleveren.
Architectonisch is het een sparse Mixture-of-Experts (MoE)-model opgeschaald naar 2,4 biljoen totale parameters, waarvan per token slechts ongeveer 95 miljard worden geactiveerd. Dit ontwerp, gebouwd op de Qwen 3.5-basis, balanceert enorme capaciteit met inferentie-efficiëntie. Het model ondersteunt een contextvenster van 1 miljoen tokens (gedocumenteerde maximale input rond 991K tokens en maximale output rond 131K tokens), native multimodale input (tekst, afbeeldingen en video) en tekstoutput. Het bevat instellingen voor redeneerinspanning (xhigh / medium / low) en ondersteunt zowel OpenAI Chat Completions als Anthropic-compatibele protocollen, waardoor het direct compatibel is met populaire agent-frameworks zoals Claude Code, Codex, Qoder CLI, Qwen Code en OpenClaw.
In tegenstelling tot eerdere Max-klasse modellen die gesloten bleven, heeft Alibaba zich gecommitteerd om de gewichten van Qwen3.8-Max (en een kleinere Qwen3.8-27B-variant) in de week na de lancering vrij te geven via Hugging Face en ModelScope — de eerste keer dat een Max-tier Qwen-model openlijk beschikbaar komt.
Het model is gepositioneerd voor coding-agents, professioneel werk in de echte wereld (“cowork”), onderzoek, langetermijnplanning en multimodale agent-lussen. Officiële demo’s benadrukken zelf-evoluerend gedrag: het model maakt issues aan, wijst ze aan zichzelf toe, schrijft en test code, iterereert op feedback en verbetert zijn eigen tooling over langere periodes.
Bronnen: Officiële Qwen-blog en Alibaba Cloud-aankondigingen (augustus 2026); Artificial Analysis modelkaart; onafhankelijke reviews die de GA-release samenvatten.
Wat is er nieuw in Qwen3.8-Max?
Vergeleken met zijn voorganger Qwen3.7-Max levert de 3.8-generatie substantiële verbeteringen in agentisch coderen, langetermijnbetrouwbaarheid, multimodale redenering en document-/kantoorprestaties. Belangrijke vernieuwingen omvatten:
Echte langetermijnautonomie:
Het model kan closed-loop adaptief leren volhouden over honderden beurten of meerdere dagen. Gedocumenteerde voorbeelden omvatten een 16 dagen durend autonoom software-ontwikkelingsproject dat een zelf-evolverende CLI-tool (oh-my-cli) opleverde met 265 commits, 127 pull requests en 151 issues geheel zonder menselijke interventie; reproductie en verbetering van de methodologie van een onderzoeksartikel (inclusief GPU-trainingsloops en meetbare benchmarkwinsten); en een volledig gesimuleerd jaar aan e-commerce-activiteiten dat de baselines significant overtrof.
Multimodaal als een continue feedbacklus:
Visuele input is niet slechts een invoermodaliteit. Het model gebruikt visueel begrip voor planning, uitvoeringsmonitoring en zelfcorrectie — waardoor taken mogelijk worden zoals screenshot-naar-code-reconstructie, interactieve game-/animatiegeneratie en 2D-naar-3D-visualisatie.
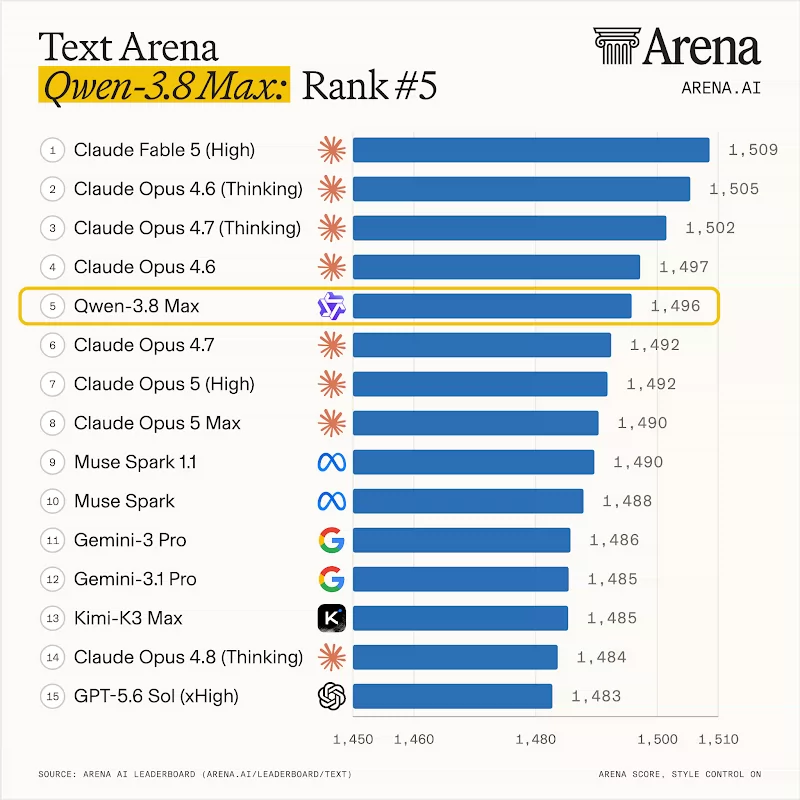
Het model scoort hoog op Text Arena (vijfde gerapporteerd) en Vision Arena (tweede gerapporteerd) in vroege gegevens na release.

Focus op end-to-end deliverables:
Nadruk op het leveren van productie-outputs over honderden beroepen in plaats van geïsoleerde antwoorden.
Denk- en snelle-inferentiemodi
Twee modi: thinking-modus en snelle-inferentiemodus. Thinking-modus is voor diepere redenering en complexe planning. Snelle modus is voor reacties met lagere latentie wanneer de taak eenvoudig is. Alibaba Cloud's OpenCode-documentatie laat thinking ingeschakeld zien voor de Qwen3.8-routes en vermeldt redeneerinstellingen voor de preview-route, waaronder xhigh, medium en low.
Deze splitsing is waardevol voor productontwerp. Teams moeten niet bij elk verzoek de zwaarste redeneermodus gebruiken. Een supportbot kan een simpel ticket goedkoop classificeren, met een sneller model samenvatten en alleen opschalen naar Qwen3.8-Max thinking-modus wanneer de gebruiker om een ingewikkelde beleidsbeslissing, root-causeanalyse, contractbeoordeling of code-migratieplan vraagt.
Deze capaciteiten zijn gevalideerd via interne langdurige experimenten en een uitgebreide benchmarksuite die coding-agents, algemene agents, multimodale redenering, documentbegrip en perceptie/grounding-taken omvat.
Benchmarking: prestaties bij gegevenskwantisatie
Alibaba publiceerde bij GA een uitgebreide interne benchmarksuite. Onafhankelijke verificatie (Artificial Analysis Intelligence Index, LMArena, enz.) liep in de dagen direct na release nog achter; vroege Artificial Analysis-gegevens plaatsten Qwen3.8-Max op een Intelligence Index van 53 (rang ~16/186 in de gevolgde set), met opmerkelijk hoge breedsprakigheid en relatief lagere snelheid.
Geselecteerde officiële/gerapporteerde scores (Qwen3.8-Max vs geselecteerde peers):
| Benchmark | Qwen3.8-Max | Claude Fable 5 / Opus 4.8 | GPT-5.6 Sol (max) | Qwen3.7-Max |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 86.6 | 84.6 | 88.8 | 74.5 |
| PaperBench | 93.0 | 88.8 / 80.3 | 90.5 | 64.8 |
| SWE-bench Pro | 67.7 | 80.0 / 69.2 | 64.6 | 60.6 |
| FrontierSWE | 73.5 | 88.8 | — | 40.7 |
| DeepSWE 1.1 | 56.6 | 70.0 | 73.0 | 21.6 |
| IFBench | 82.8 | ~63.5 | — | 79.1 |
| GPQA Diamond | 92.6 | 92.6 | 94.1 | 92.4 |
| OmniDocBench 1.5 | 92.1 | — | — | — |
| OSWorld-Verified | 86.1 | — | — | — |
Qwen3.8-Max leidt vaak of eindigt in de buurt van de top op multimodale redenering, document-/kantoortaken en bepaalde agentische coding-/onderzoeksstatistieken, terwijl het achterblijft bij de sterkste gesloten modellen op enkele pure software-engineering-agent-suites. De generatie-sprong op FrontierSWE en DeepSWE is vooral opmerkelijk. Beschouw leverancierscijfers als richtinggevend; onafhankelijke runs en werklastspecifieke evaluatie blijven essentieel.
API-prijzen van Qwen3.8-Max
Officiële Alibaba Cloud Model Studio / QwenCloud-prijzen voor Qwen3.8-Max (GA-tarieven begin augustus 2026):
- Input: $2.00 per 1 miljoen tokens
- Output: $6.00 per 1 miljoen tokens (inclusief thinking-/reasoning-tokens)
- Gecachede input: ongeveer $0.25 per 1 miljoen tokens (aanzienlijke besparing voor herhaalde lange contexten)
Prijzen zijn vlak over het gehele contextvenster van 1M tokens — een opvallend voordeel ten opzichte van veel concurrenten die toeslagen toepassen voor lange contexten. Batch- en andere kortingen kunnen van toepassing zijn, afhankelijk van regio en abonnement.
Context voor vergelijking (ruwe lijstprijzen in dezelfde periode):
- Kimi K3: ~$3 / $15
- Hogere-end Claude- / GPT-frontier-modellen: vaak $5+ / $15–25+
- DeepSeek V4 Flash-varianten: substantieel lager (vaak onder $0.50 gecombineerd voor veel use-cases)
Voor teams die al meerdere providers gebruiken, bieden geaggregeerde gateways zoals CometAPI doorgaans ~20% korting ten opzichte van officiële tarieven, één OpenAI-compatibel endpoint, uniforme facturatie en eenvoudig modelswitchen of failover. Dit maakt experimenteren met Qwen3.8-Max (en gelijktijdige vergelijking met DeepSeek V4 Flash, Kimi-modellen of andere) operationeel eenvoudiger en vaak goedkoper. Controleer de huidige CometAPI-prijspagina’s en free-credit-aanbiedingen voor de meest actuele effectieve tarieven.
Hoe Qwen3.8-Max zich verhoudt tot Kimi K3 en DeepSeek V4 Flash
| Dimensie | Qwen3.8-Max | Kimi K3 | DeepSeek V4 Flash |
|---|---|---|---|
| Totale / Actieve parameters | 2.4T / ~95B | ~2.8T / ~104B | 284B / 13B |
| Context | 1M | 1M | 1M |
| Multimodaal | Tekst + Afbeelding + Video | Tekst + Afbeelding + Video | Alleen tekst |
| Prijzen (in/uit) | $2 / $6 | $3 / $15 | ~$0.14 / $0.28 (veel goedkoper) |
| Open gewichten | Gepland (volgende week) | Reeds vrijgegeven | MIT, beschikbaar |
| Sterke punten | Langetermijnautonomie, multimodaal, PaperBench, output-prijzen | Sterke onafhankelijke scores, frontend coding Arena-leiderschap | Uiterst kostenefficiënt, solide agentisch coderen voor formaat |
| Relatieve positie | Competitief / leidend op diverse agent- & multimodale benches | Licht voordeel op sommige geauditeerde intelligentie-indices | Uitstekende waarde; lagere absolute capaciteit |
Qwen3.8-Max evenaart of overtreft Kimi K3 doorgaans in kostenefficiëntie voor output-intensief werk en multimodale taken, terwijl DeepSeek V4 Flash de budgetkoning blijft voor grootschalige tekstworkloads waarbij piekcapaciteit secundair is. Veel teams zullen alle drie gebruiken via een uniforme gateway, waarbij eenvoudig verkeer naar Flash-klasse modellen wordt gerouteerd en complexe agent-sessies naar Qwen3.8-Max of Kimi K3.
Evenaart Qwen3.8-Max Kimi K3?
In zekere zin, ja. Het evenaart de 1M-contextklasse, heeft een sterke multimodale positionering en is goedkoper op standaard officiële input-/outputprijzen. Het evenaart niet Kimi K3’s 2,8T totale parametercount, en Kimi’s publieke documentatie biedt momenteel bijzonder gedetailleerde richtlijnen voor tools, contextcaching, gestructureerde output en vision.
Evenaart Qwen3.8-Max DeepSeek V4 Flash?
Het concurreert in 1M-context en MoE-architectuur, maar de producten zijn gericht op verschillende taken. DeepSeek V4 Flash is de economische snelle route. Qwen3.8-Max is de grotere route met hoge capaciteit voor werk waar multimodaal begrip, geavanceerde redenering en enterprise-productiviteit belangrijker zijn dan de laagst mogelijke tokenprijs.
Wat kan Qwen3.8-Max doen?
Coderen en software-engineering
Qwen3.8-Max is een sterke kandidaat voor fullstack-ontwikkeling, code review, repository-begrip, migratieplanning, API-ontwerp, debugging, testredenering en software-architectuur. Zijn lange context helpt wanneer het model veel bestanden, logs en requirements tegelijk moet overzien. Gebruik het voor moeilijke codeklussen, niet voor elke autoaanvulling of simpele lint-uitleg.
Kantoor- en kenniswerk
De “Cowork”-positionering van het model is belangrijk. Enterprise-medewerkers stellen niet alleen chatvragen. Ze vergelijken PDF’s, vatten vergaderingen samen, beoordelen slides, interpreteren spreadsheets, controleren contracten, schrijven rapporten en bereiden beslissingen voor op basis van rommelige bewijslast. Het multimodale en lang-contextuele ontwerp van Qwen3.8-Max maakt het geschikt voor kantoorworkflows waarin tekst, documenten, screenshots en gestructureerde gegevens samen moeten worden beredeneerd.
Agentische workflows
Qwen3.8-Max is nuttig voor agentplanning: een doel opdelen in stappen, beslissen welk hulpmiddel aan te roepen, resultaten evalueren en het plan bijstellen. In CometAPI wordt dit praktischer omdat dezelfde applicatie eenvoudige stappen naar goedkopere modellen kan routeren en Qwen3.8-Max reserveren voor planning of verificatie.
Aan de slag en tips voor CometAPI-integratie
- Directe toegang: Gebruik QwenCloud of Alibaba Cloud Model Studio met het model-ID
qwen3.8-max. Zowel OpenAI-compatibele als Anthropic-compatibele endpoints worden ondersteund. - Uniforme toegang via CometAPI: Meld je aan op CometAPI.com, verkrijg een API-sleutel, stel
base_urlin ophttps://api.cometapi.com/v1en roep aan metmodel="qwen3.8-max". Dezelfde sleutel werkt voor DeepSeek V4 Flash, Kimi K3, Claude, GPT en honderden andere modellen — ideaal voor experimentatie, kostenbeheersing en productierouting. CometAPI benadrukt concurrerende prijzen, lage latentie en snelle toevoeging van nieuwe modellen (Qwen3.8-Max werd kort na lancering opgenomen). - Agent-frameworks: Plug direct in op Claude Code, OpenClaw of maatwerk-harnassen. Schakel hogere redeneerinspanning in voor complexe langetermijnjobs.
- Open gewichten: Houd Hugging Face / ModelScope in de gaten voor de aanstaande release als je on-premise of fijn-afgestemde deployments nodig hebt.