

Kort oppsummert
Gratisnivået for Gemini API er tilgjengelig i oktober 2026 for utvalgte modeller, inkludert Gemini 3.8 Flash, Gemini 3.6 Flash, Gemini 3.5 Flash-Lite og Gemini 3.1 Flash-Lite. Du kan starte uten å sette opp fakturering, men kvoten som er tilgjengelig for prosjektet ditt avgjør hvor mye du faktisk kan kjøre.
Start med Gemini 3.8 Flash for krevende koding og resonneringseksperimenter, eller en Flash-Lite‑modell for rutinemessig ekstraksjon og klassifisering. Før du bruker reelle kundedata, sjekk gjeldende datavilkår. Hvis du trenger betalt kapasitet, sammenlign Googles egne priser med CometAPIs separat fakturerte tilgang.
Hovedpunkter
- Gemini 3.8 Flash er det nyeste Flash-alternativet som dekkes her, med multimodal input og justerbar resonnementinnsats.
- Gemini 3.6 Flash er fortsatt et støttet alternativ for eksisterende integrasjoner; Gemini 3.5 Flash-Lite og Gemini 3.1 Flash-Lite er rettet mot lettere arbeidslaster.
- Gemini 4 Argon krever betalt API-tilgang. Gratis tilgjengelighet i et annet Google-produkt etablerer ikke gratis API-berettigelse.
- Sjekk kvoter i AI Studio. En modells kontekstvindu er noe annet enn prosjektets forespørsels- og token‑kvoter.
- Sammenlign tilgangsrutene. Googles gratis kvote og CometAPIs priser, kreditter og kontogrenser er separate.
Er Gemini API gratis i 2026?
Google tilbyr gratis inndata- og utdata‑tokens for utvalgte Gemini API‑modeller, underlagt kvoter på prosjektnivå. Du kan starte uten å aktivere fakturering. Dette er et kvotebasert gratisnivå, ikke en engangspromokreditt.
Det viktige skillet er at Google AI Studio, Gemini API og forbrukerabonnementer på Gemini er separate tilganger. En modell som er tilgjengelig i ett grensesnitt, er ikke nødvendigvis gratis i et annet.
Hvilke Gemini API‑modeller er gratis i oktober 2026?
De fire modellene nedenfor er nyttige startpunkter for tekst- og multimodale applikasjoner. De er ikke en uttømmende liste over alle gratisberettigede endepunkter. Følg modelllenkene for å utforske CometAPI‑tilgang; Google‑spesifikasjoner er lenket under tabellen.
Alle fire tar imot tekst, bilde, video, lyd og PDF som input og produserer tekst. Den publiserte inputgrensen er 1,048,576 tokens, med opptil 65,536 output‑tokens. Disse modellgrensene garanterer ikke at det gratis prosjektet ditt kan sende en forespørsel av den størrelsen.
Lyd, Embeddings og bildegenerering: tilgang og begrensninger
Google lister også gratis tilgang for utvalgte spesialistmodeller, som Gemini 3.8 Live, Gemini 3.8 Flash TTS og Gemini Embedding 2. Sjekk prisoppføringen for den eksakte modellen og endepunktet før du integrerer: å forstå et bilde eller et lydklipp er en annen kapasitet enn å generere et bilde eller et stemmesvar.
API‑metoder, forespørselsformater og grenser varierer etter kapasitet. Sjekk dokumentasjonen for den spesifikke modellen og operasjonen du planlegger å bruke.
Gratis tilgang omfatter ikke hver Gemini‑modell eller generasjonsendepunkt. Gemini 4 Argon krever betalt Gemini API‑tilgang, mens premium endepunkter for bilde- og videogenerering har egne berettigelsesregler. Før du integrerer en funksjon, sjekk nøyaktig modell og operasjon i stedet for å anta at de deler samme gratis kvote.
Hvordan yter Gemini 3.8 Flash?
Googles publiserte evaluering sammenligner Gemini 3.8 Flash med Gemini 3.7 Flash og andre modeller. Den rapporterer 73.7% på DeepSWE v1.1, sammenlignet med 65.3% for 3.7 Flash—en økning på 8.4 prosentpoeng. På HLE-Verified stiger den rapporterte scoren fra 53.6% til 54.9%.
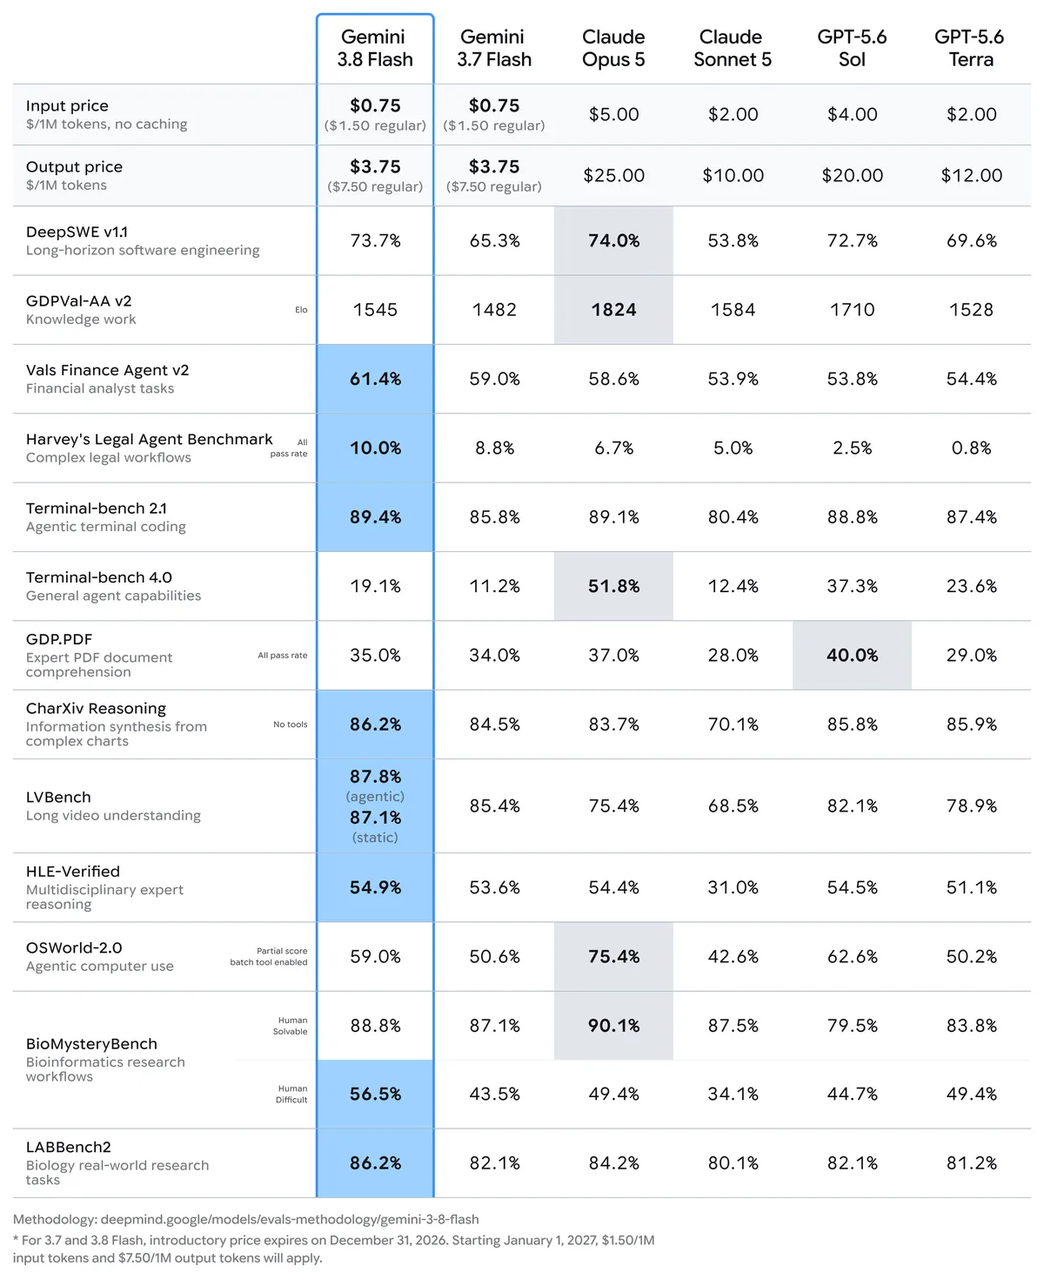
Bruk disse resultatene for å velge en modell å teste, og evaluer den deretter på eksempler fra din egen applikasjon. For en dokument‑ekstraktor kan korrekte felt og stabil outputformatering være viktigere enn en kodebenchmark. For en kodeassistent, mål om den foreslåtte endringen fungerer, hvor lang tid det tar, og hvor mange tokens den bruker.
Hva er ratebegrensningene i gratisnivået for Gemini API i 2026?
Den største misforståelsen om gratisnivået til Gemini er at hver konto mottar det samme faste antallet forespørsler.
Åpne Google AI Studio, velg prosjektet bak API‑nøkkelen din, og gjennomgå aktive grenser for den valgte modellen. Googles veiledning for rate limits forklarer kvotedimensjonene; dashbordet viser kvoten som gjelder for kontoen din.
- RPM (forespørsler per minutt): Begrenser hvor mange forespørsler du kan sende hvert minutt. Se opp for korte topper og parallelle arbeidere som sender for mange forespørsler samtidig.
- TPM (inndata‑tokens per minutt): Begrenser volumet av inndata‑tokens du kan sende per minutt. Store prompt, samtalehistorikk og dokumenter kan bruke denne kvoten selv når antall forespørsler er lavt.
- RPD (forespørsler per dag): Begrenser det totale daglige forespørselsantallet. Planlegg arbeidslasten rundt den daglige kvoten og tidspunktet for reset.
En million‑token inputgrense beskriver modellens maksimalt støttede inputstørrelse. Det garanterer ikke at et prosjekt på gratisnivå har nok TPM‑kapasitet til å sende en million tokens i én forespørsel. Kontekstkapasitet og rate‑limit‑kapasitet må vurderes separat.
Daglige forespørselskvoter resettes ved midnatt Pacific Time. Flere nøkler i ett prosjekt deler bruksgrensene, så det å opprette en ny nøkkel gir ikke mer kapasitet. Andre grenser kan gjelde for spesialistmodeller eller operasjoner.
Håndter 429‑feil fra Gemini API
Les feilkroppen før du prøver på nytt. I dagens Interactions API kan en 429 skille mellom en kortsiktig forespørsels- eller token‑grense og en oppbrukt daglig kvote. For en kortsiktig grense, senk køen og bruk eksponentiell backoff med jitter. For daglig oppbruk, vent på reset eller endre applikasjonens kapasitetsplan. En 503 signaliserer midlertidig tjenesteutilgjengelighet i stedet. Se Googles API‑feilreferanse.
Hvordan sammenlignes prisene mellom Google og CometAPI?
Når begynner fakturering for Gemini API
Det å bruke opp gratiskvoten bytter ikke automatisk prosjektet ditt til betalt bruk. Uten en aktiv faktureringskonto vil forespørsler som overskrider tilgjengelig gratis kvote møte tilgangs- eller kapasitetsbegrensninger i stedet for Standard betalte tokenkostnader.
For å bruke betalt kapasitet må du knytte til fakturering. Hvis kontoen din er tilordnet en forhåndsbetalt plan, må du også fylle på kreditter, fra $5 eller lokal ekvivalent. Sjekk din tildelte plan og forbruksstyring i AI Studio før du oppgraderer. Saldoer og forbruksregnskap kan oppdateres med forsinkelse, så en vist forhåndsbetalt saldo er ikke en øyeblikkelig forbruksstopp.
Googles $300 Cloud‑velkomstkreditt er separat fra gratisnivået for Gemini API. Kontoer åpnet etter 2. mars 2026 kan ikke bruke den kreditten til Gemini API‑ eller AI Studio‑kostnader. Se faktureringsveiledningen for reglene som gjelder for kontoen din.
Google‑ og CometAPI‑tokenpriser
Tabellen sammenligner Googles Standard token‑priser med CometAPIs publiserte modellrater sjekket 26. oktober 2026. Alle beløp er USD per én million tokens; utdata inkluderer fakturerbar resonnement der det er aktuelt. Googles gratis input og output gjelder kun for kvalifiserte forespørsler innenfor prosjektets kvote.
Googles introduksjonspriser for Flash over slutter 31. desember 2026; 3.8 Flash og 3.6 Flash går deretter til $1.50 inndata og $7.50 utdata. Argons introduksjonspris slutter 30. november 2026, etter det blir prisen $4 inndata og $20 utdata. CometAPI‑rater bør sjekkes uavhengig når disse kampanjene endres. Verktøy, caching, lagring, skatter og andre tjenester kan gi tilleggskostnader.
Et lite eksempel på arbeidsbelastning
Anta at du sender 1,000 tekstforespørsler, hver med 2,000 inndata‑tokens og 500 utdata‑tokens. Det er to millioner inndata‑tokens og en halv million utdata‑tokens. Med prisene over koster Gemini 3.8 Flash $3.375 gjennom Google, eller omtrent $3.38, og $2.70 gjennom CometAPI. En kvalifisert arbeidslast på Googles gratisnivå koster $0 bare hvis den passer innenfor tilgjengelige kvoter. Dette er tokenkostnadsestimater, ikke målte fakturaer.
Hvordan kan du begynne å bruke gratisnivået for Gemini API?
Du trenger en kvalifisert Google‑konto og region, en API‑nøkkel, og Python med pip tilgjengelig. Eksemplet nedenfor følger Googles gjeldende kom‑i‑gang‑guide og bruker Interactions API.
Opprett en nøkkel og installer SDK‑en
I Google AI Studio kopierer eller oppretter du en API‑nøkkel for et prosjekt som ikke har aktivert betalt fakturering. Installer SDK‑en, og sett deretter nøkkelen i terminalmiljøet ditt. Oppbevar nøkkelen på serveren din i stedet for å bygge den inn i kode som kjøres i nettleseren.
pip install -U google-genai
På macOS eller Linux:
export GEMINI_API_KEY="your_api_key"
I Windows PowerShell:
$env:GEMINI_API_KEY="your_api_key"
Send en forespørsel og sjekk resultatet
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-3.8-flash",
    input="Explain vector databases in 100 words."
)
print(interaction.output_text)
Lagre dette som en Python‑fil og kjør den fra samme miljø. En vellykket forespørsel skriver ut en kort forklaring. Sjekk deretter AI Studios bruksdashbord for å bekrefte prosjektet og modellen som mottar trafikken. Hvis den feiler, inspiser feilkoden og verifiser nøkkelen, modelltilgang, kvote og faktureringsstatus før du endrer koden.
Hvordan kan utviklere få tilgang til Gemini API‑modeller via CometAPI?
CometAPI gir en separat tilgangsrute for støttede Gemini‑modeller og andre AI‑leverandører.
Velg denne ruten når et delt grensesnitt på tvers av leverandører forenkler applikasjonen din. Bruk en CometAPI‑nøkkel med endepunktet deres, og verifiser deretter støttet model ID og kontogrenser. Googles gratis kvote overføres ikke til denne tjenesten. Følgende eksempel bruker det OpenAI‑kompatible grensesnittet dokumentert av CometAPI.
pip install -U openai
Sett COMETAPI_KEY i miljøet ditt med samme skallspesifikke metode som vist over, og kjør deretter:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)
response = client.chat.completions.create(
    model="gemini-3.8-flash",
    messages=[{
        "role": "user",
        "content": "Summarize the benefits of RAG."
    }]
)
print(response.choices[0].message.content)
Før produksjonssetting, bekreft at den tiltenkte model ID er støttet av CometAPI‑kontoen din. Google‑native identifikatorer og leverandørspesifikke aliaser er ikke garantert å samsvare for hver modell.
Hvilke personvernbegrensninger gjelder for gratisnivået til Gemini API?
Under Googles Gemini API Additional Terms of Service kan prompt og utdata for ubetalte tjenester brukes til å forbedre Googles produkter, og menneskelige gjennomlesere kan undersøke dem. Ikke send sensitiv, konfidensiell eller personlig informasjon til ubetalte tjenester. Betalte API‑tjenester har andre bestemmelser for databruk.
Regionale regler spiller en rolle: bestemmelser for databruk i betalte tjenester gjelder for visse ubetalte bruksområder i EØS, Sveits og Storbritannia, men det å gjøre en API‑klient tilgjengelig for brukere i disse regionene krever Paid Services. Det er separate vilkår. Sjekk gjeldende vilkår for dine brukere og din utrulling før lansering.
Hvordan kan du optimalisere bruken av gratisnivået for Gemini API?
Bygg rundt kvoten du har målt. Hold et lite sett representative oppgaver og registrer oppgavesuksess, latens, inndata- og utdata‑tokens og retries. Endre deretter én del av arbeidslasten om gangen:
- Rute etter vanskelighetsgrad. Test Flash‑Lite for rutinemessig ekstraksjon og bruk en større modell bare der den forbedrer resultatet.
- Trim inputen. Send den relevante dokumentdelen og nødvendig samtalehistorikk i stedet for å sende alt på nytt hver gang.
- Kontroller genereringen. Be om en nyttig utgangslengde og juster resonnementinnsatsen bare der modellen og API‑et støtter det.
- Gjenbruk arbeid. Lagre gjentatte applikasjonsresultater og sjekk modellspesifikk bufringsberettigelse før du antar at API‑bufring er gratis.
- Budsjetter samtidighet. Hold arbeidere bak en delt kø slik at uavhengige oppgaver ikke skaper unødige topper.
Overvåk til kvalitet så vel som forbruk. En billigere modell som ofte feiler eller krever flere forsøk kan skape mer arbeid enn en litt dyrere modell som lykkes på første forsøk.
En nyttig intern evalueringsmetrik er:
Effektiv kostnad per vellykket oppgave = Total inferenskostnad / Antall vellykkede oppgaver
For eksperimentering på gratisnivå er en ekstra operativ metrik vellykkede oppgaver per tilgjengelig kvotevindu.
Vanlige spørsmål
Hvordan kan jeg se om et kvoteproblem skyldes forespørsels‑topper eller store dokumenter?
Sammenlign tidsstemplene for feil med forespørselsantall og volum av inndata‑tokens. En topp av korte prompt peker mot forespørselsfrekvens; noen få lange dokumenter kan tømme token‑kapasiteten selv ved lav RPM. I Interactions API, inspiser maskinlesbar feilkode og skill daglig kvoteoppbruk fra en kortsiktig grense. Loggfør tokenbruk og arbeider‑samtidighet sammen slik at du kan endre riktig del av køen.
Hva bør jeg gjøre hvis en forespørsel tidsavbrytes etter at jeg har sendt den?
En timeout forteller ikke alltid om en ekstern operasjon ble fullført. For en interaksjon du har en ID for, sjekk tilstanden før du starter en annen kostbar oppgave. Sett en applikasjonsnivå oppgave‑ID rundt arbeidsflyten og dedupliser nedstrøms handlinger, spesielt e‑poster, database‑skriv og verktøykall. Et retry av tekstgenerering bør ikke stille gjenta en forretningshandling. Googles Interactions‑dokumentasjon beskriver henting av interaksjoner og kjøretilstander.
Hvordan bør jeg sammenligne Flash og Flash‑Lite for dokumentekstraksjon?
Bruk de samme dokumentene, påkrevde felt og akseptregler for begge modeller. Inkluder støyete skanninger, manglende felt og tvetydige verdier. Skår faktamessig felt‑nøyaktighet og output‑validitet, og tell retries og manuelle rettelser. En modell som produserer færre tokens kan likevel bruke mer innsats hvis feilene krever en ny forespørsel. Hold av et holdout‑sett med dokumenter slik at promptendringer ikke bare vurderes på eksempler du allerede har tunet.
Hva bør jeg sjekke før jeg bytter en applikasjon fra Google til CometAPI?
Test eksakt endepunkt, model ID, meldingsformat og funksjoner applikasjonen din bruker. En kompatibel chat‑completions‑forespørsel etablerer ikke identisk støtte for filer, verktøy, bufring eller resonnementsinnstillinger. Sammenlign returnerte bruksfelt og feilbehandling så vel som tekstsvaret, og gjennomgå mellomleddets og oppstrømsleverandørens datapolicyer. Start med en liten, ikke‑sensitiv arbeidslast før du flytter resten av trafikken.
Hvordan kan jeg holde en integrasjon stabil når modeller og priser endres?
Hold model ID‑er, endepunktsinnstillinger og prisforutsetninger i konfigurasjon. Registrer modell og dato med evalueringsresultater, overvåk avviklingsvarsler, og kjør representative oppgaver på nytt før du bytter modell. Sett budsjettvarsler og vurder kampanjepriser før sluttdatoene deres. Ha en testet fallback for essensielle arbeidslaster i stedet for å anta at en gratis kvote eller et bestemt modellalias vil være tilgjengelig på ubestemt tid.
Konklusjon
Gratisnivået for Gemini API er en nyttig måte å validere en applikasjon på før du betaler for kapasitet. Velg en modell for oppgaven, mål kvoten som er tilgjengelig for prosjektet ditt, og sjekk datavilkårene før du bruker produksjonsinnhold.
For et første eksperiment, gjør én liten forespørsel og bekreft den i AI Studio. Mål deretter en representativ arbeidslast. Hvis gratis kapasitet blir flaskehalsen, sammenlign Googles betalte API med CometAPI ved å bruke samme prompt, kvalitetskrav og komplette tokenkostnader.