Bygg med CometAPITrenger du ett API for flere modeller?Test arbeidsflyten i Playground, og opprett deretter en API-nøkkel når modellen og kostnaden passer bruksområdet ditt.
GPT-6.1 Terra vs GPT-6.1 Sol: Ytelsestester, priser og hva du bør velge
Sammenlign GPT-6.1 Terra og GPT-6.1 Sol på offisielle benchmarker, resonnement, API-priser og praktiske arbeidslaster, med et CometAPI Python-eksempel.
Start med GPT-6.1 Terra for høyt volum, verifiserbare og kostnadssensitive oppgaver. Evaluer GPT-6.1 Sol for kompleks koding, flertrinns verktøybruk og arbeidsflyter der feil er kostbare. En praktisk standard er å bruke Terra først og eskalere til Sol når forhåndsdefinerte tester eller valideringssjekker feiler.
Viktige punkter
Standard token-priser: På OpenAI Standard koster Terra $1 per million input-tokener og $5 per million output-tokener; Sol koster henholdsvis $2 og $10.
Oppgavespesifikk ytelse: Ved maksimal resonneringsinnsats leder Terra så vidt på Agents’ Last Exam v1 og Terminal-Bench-Science 0.1, mens Sol leder på Terminal-Bench 4.0 og OSWorld 2.1.
Delt kontekstkapasitet: Begge modellene tilbyr et 1.05-million-token kontekstvindu og aksepterer tekst- og bildeinndata.
Ulike styringer for resonnering: Terra støtter å slå av resonnering med ; Sol krever minst resonneringsinnsats.
Gjennomgått for klarhet, kildeangivelse og gjeldende API-terminologi.
none
low
Operasjonelle kostnader betyr noe: Sammenlign forbruk per vellykket fullført oppgave, inkludert nye forsøk og verktøykall, og følg opp kostnader for menneskelig gjennomgang separat.
GPT-6.1 Terra vs GPT-6.1 Sol: Oversikt og spesifikasjoner
Oversikten nedenfor oppsummerer avveiingene. De detaljerte avsnittene forklarer bevis, faktureringsforutsetninger og begrensninger bak hvert valg.
Beslutningsfaktor
GPT-6.1 Terra
GPT-6.1 Sol
Startarbeidslast
Rutinepreget visuelt arbeid og repeterbare agenter
Kompleks koding og vedvarende profesjonell resonnering
Kontekst og modaliteter
Samme totale kontekstkapasitet; tekst- og bildeinput
Samme totale kontekstkapasitet; tekst- og bildeinput
Styring av resonnering
Inkluderer et alternativ for å slå av resonnering
Krever minst lav resonneringsinnsats
Publisert ytelsesmønster
Lavkost-ytelse på repeterbare agentoppgaver
Sterkere på flere krevende kode- og desktop-tester
API-tilgang
OpenAI og CometAPI
OpenAI og CometAPI
GPT-6.1 Terra: Effektive visuelle og agent-arbeidsflyter
OpenAI introduserte GPT-6.1 Terra 26. oktober 2026. Den kombinerer visuell resonnering, datamaskinbruk og generell tekstgenerering for rutinepregede profesjonelle arbeidsflyter. De lavere token-satsene gjør den nyttig som utgangspunkt når oppgaver er hyppige og resultater kan kontrolleres.
GPT-6.1 Sol: Kompleks koding og profesjonell resonnering
GPT-6.1 Sol ble lansert 29. september 2026. Den er rettet mot krevende koding og profesjonelt arbeid. Evaluer den når et ukjent repo, en lang kjede av avhengige handlinger eller dyre korreksjoner gjør økt resonneringsevne verdifull.
Kontekst, resonnering og API-spesifikasjoner
Spesifikasjon
GPT-6.1 Terra
GPT-6.1 Sol
Offisiell lanseringsdato
October 26, 2026
September 29, 2026
API-modell-ID
gpt-6.1-terra
gpt-6.1-sol
Kontekstvindu
1,050,000 tokens
1,050,000 tokens
Kunnskapsavgrensning
June 1, 2026
April 30, 2026
Input / output
Text and images / text
Text and images / text
Resonneringsinnsats
none, low, medium, high, xhigh, max
low, medium, high, xhigh, max
Standard innsatsnivå
medium
medium
API-funksjoner: Begge modellene støtter Structured Outputs, strømming og Batch API. Verktøykall bruker Responses API, og fininnstilling støttes ikke. Sjekk at valgt leverandør og endepunkt tilbyr funksjonene applikasjonen din trenger.
Begge modellene tillater opptil 128,000 output-tokener innenfor et 1,050,000-token kontekstvindu. Å reservere hele output-kvoten gir 922,000 tokener til resten av utvekslingen, inkludert input, systeminstruksjoner og verktøyhistorikk. Dette er en planleggingsberegning, ikke en egen fast input-grense.
Arkitekturavsløring: De lenkede offentlige modellspecene gir ikke nok intern arkitekturdetalj for en pålitelig sammenligning. Kontekstkapasitet og resonneringsinnstillinger bør ikke behandles som bevis på parameterantall eller arkitektur.
Styring av resonnering: Terras none-innstilling er nyttig for enkle transformasjoner og ekstraksjon. Til første sammenligning bør du bruke samme støttede resonneringsinnstilling på begge modellene, og deretter finjustere hver modell mot kvaliteten og latensen arbeidsflyten din krever.
Begge modellene har samme publiserte kontekstkapasitet, men det innebærer ikke identisk gjenfinningstreffsikkerhet eller langkontekst-resonnering. Modellvalg bør derfor ta hensyn til resonneringskvalitet, arbeidsflyteffektivitet, kostnad og oppgavespesifikk gjenfinningsytelse.
GPT-6.1 Terra vs GPT-6.1 Sol: Ytelse
De rapporterte resultatene viser et blandet bilde: Terra leder så vidt på enkelte agent- og vitenskapelige kodeevalueringer, mens Sol scorer høyere på generell terminalkoding, skrivebordsautomatisering og visjon. Sammenligningene nedenfor skiller OpenAIs lanseringsresultater fra uavhengige evalueringer og forklarer hva hvert kan — og ikke kan — fortelle om ytelse i produksjon.
Offisielle benchmark-resultater og testforhold
Følgende resultater stammer fra OpenAIs Terra-lanseringsevalueringer. Terra vises ved medium og maksimal resonneringsinnsats; Sol vises ved maksimal innsats. Siste kolonne sammenligner kun konfigurasjoner ved maksimal innsats.
OSWorld bruker den offline 2.1-evalueringen. Factuality-testen bruker OpenAIs interne prompter utformet for å fremkalle feil. Dette er leverandørrapporterte resultater fra spesifikke evalueringsoppsett, ikke målinger av produksjonsarbeidslasten din.
Benchmark
GPT-6.1 Terra (medium)
GPT-6.1 Terra (max)
GPT-6.1 Sol (max)
Sammenligning ved maks innsats
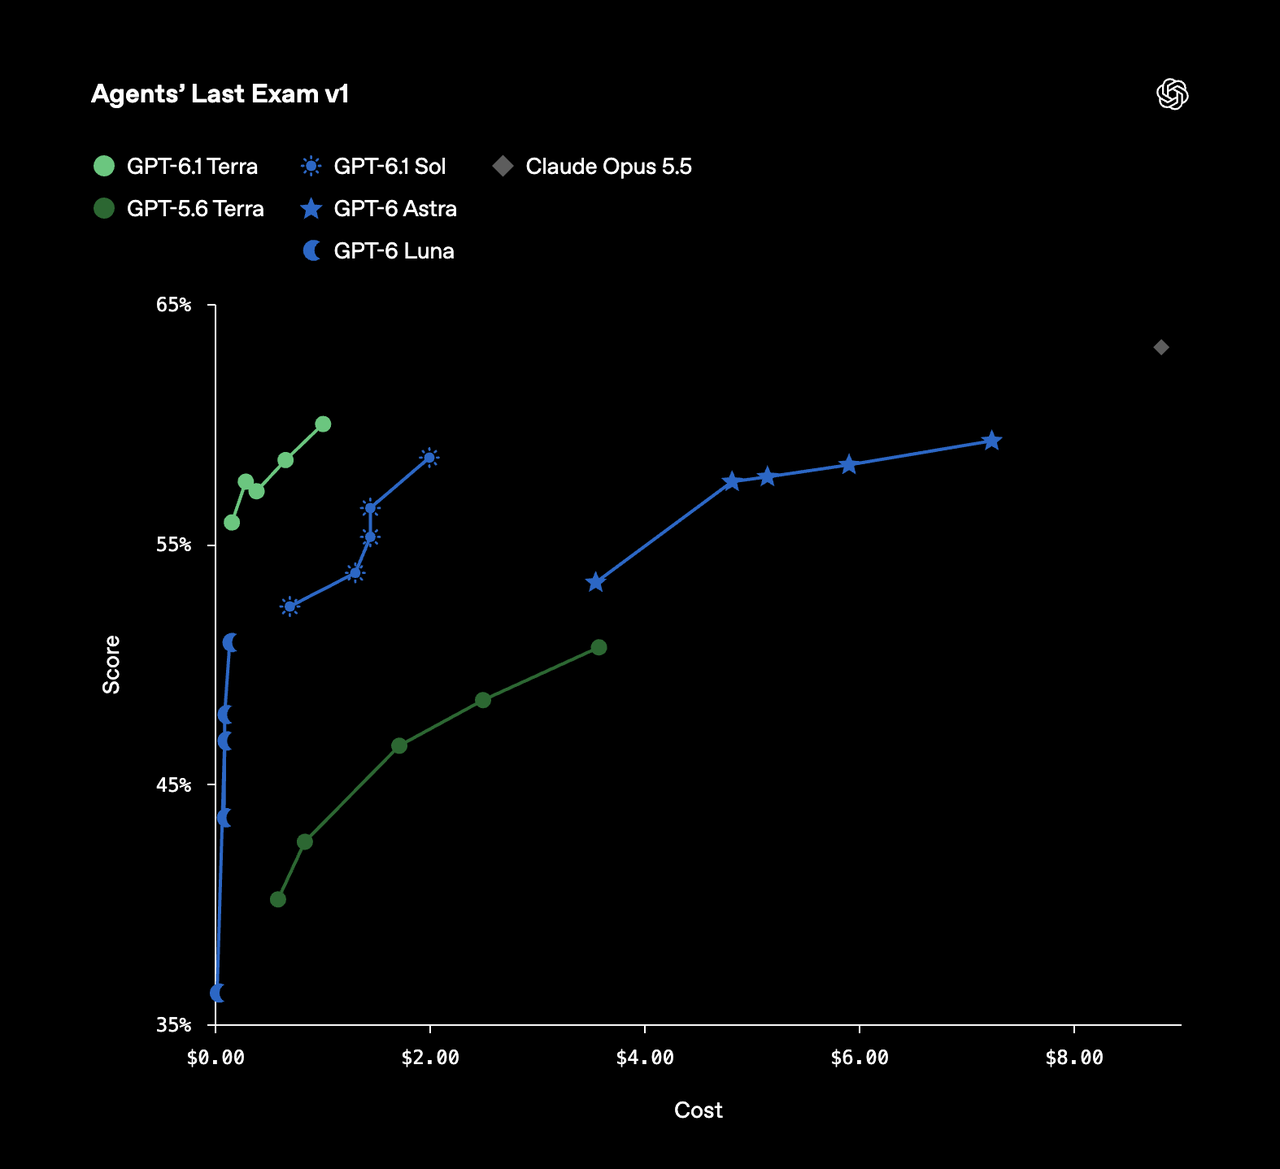
Agents’ Last Exam v1
57.60%
60.00%
58.60%
Terra +1.4 pp
MMMU-Pro (Vision)
84.60%
85.50%
86.30%
Sol +0.8 pp
OSWorld 2.1, offline
66.70%
74.20%
78.00%
Sol +3.8 pp
Terminal-Bench 4.0
35.80%
50.30%
55.90%
Sol +5.6 pp
Terminal-Bench-Science 0.1
34.30%
58.30%
57.00%
Terra +1.3 pp
Factual error rate on difficult prompts
10.10%
4.30%
4.40%
Terra 0.1 pp lavere
Alle scorer er prosenter; forskjeller uttrykkes i prosentpoeng (pp). Lavere er bedre kun for feilrate for faktafeil. Den 0.1-poengs forskjellen i feilrate alene etablerer ikke en meningsfull pålitelighetsfordel.
For programvareteknikk antyder Sols Terminal-Bench-ledelse og Terras knappe Terminal-Bench-Science-ledelse at utfallet avhenger av typen kodeoppgave. For applikasjonsarbeidsflyter underbygger Sols høyere OSWorld-score evaluering for skrivebordsautomatisering, mens Terras Agents’ Last Exam-resultat gjør den til en kandidat for profesjonelle agentoppgaver. Ingen av mønstrene etablerer en universell vinner.
Agentstillas, verktøysadgang og miljøkonfigurasjon kan påvirke disse resultatene. Bruk tallene til å identifisere kandidater for testing, og valider dem mot repo-endringene og applikasjonsarbeidsflytene du faktisk må fullføre.
OpenAIs Agents’ Last Exam v1-diagram plotter scorer mot estimerte oppgavekostnader på tvers av modellkonfigurasjoner. Det gir et kostnadseffektivitetsperspektiv til tabellen over; de plottede kostnadene er spesifikke for evalueringsoppsettet.
Uavhengige intelligens- og kodeevalueringer
Artificial Analysis’ evaluering 26. oktober plasserer Terra fire poeng under Sol på deres Intelligence Index ved maksimal resonneringsinnsats. Deres Coding Agent Index v2.0 gir Terra 48 og Sol 54. Dette er separate evalueringer med egne metoder og skalaer; de bør ikke kombineres numerisk med OpenAIs benchmark-resultater.
Den samme analysen identifiserer Terras lave og medium resonneringsinnstillinger som særlig kostnadseffektive på intelligensevalueringen. Dette støtter testing av praktiske konfigurasjoner ved siden av maksimumsinnstillinger. Evalueringskostnader er fortsatt spesifikke for testoppsettet og bør ikke behandles som anslag for applikasjonens forbruk.
Hastighet og latens: Oppgavefullføring vs. generering av tokener
OpenAI rapporterer at Terra fullfører de evaluerte Agents’ Last Exam-oppgavene mer enn tre ganger raskere enn Sol. Dette er en ende-til-ende-oppgavemåling som inkluderer resonnering og programvaresamhandlinger. Det innebærer ikke tredoblet gjennomstrømning av output-tokener eller samme hastighetsøkning for hver API-forespørsel.
For interaktive applikasjoner, skill mellom tid til første token, som måler ventetiden før output begynner, og output-tokener per sekund, som måler hvor raskt svaret fortsetter. For agenter, prioriter ende-til-ende fullføringstid, inkludert verktøykall, nye forsøk og gjenoppretting.
Sammenlign begge modellene med samme prompter, verktøy, støttet resonneringsinnstilling og akseptkriterier. Registrer latens sammen med oppgavesuksess: Et raskere svar har begrenset verdi hvis det krever mer korreksjon eller ikke fullfører arbeidsflyten.
Visjon og langkontekst-ytelse: Hva resultatene fastslår
Sols ledelse på 0.8 prosentpoeng på MMMU-Pro ved maksimal innsats er ett rapportert visjonsresultat, ikke en garanti for bedre ytelse på alle visuelle arbeidsflyter. Test små etiketter, dårlige skanninger, tette diagrammer og ukjente oppsett med representative input.
Evalueringene ovenfor fastslår ikke hvilken modell som er bedre på langkontekst-gjenfinning eller resonnering. Selv om begge har samme publiserte kontekstkapasitet, demonstrerer kapasitet alene verken gjenfinningstreffsikkerhet eller hukommelse på tvers av økter. Test om hver modell kan finne og bruke relevant bevis i dokumentene dine, og oppretthold applikasjonsstatus eksplisitt på tvers av forespørsler.
GPT-6.1 Terra vs GPT-6.1 Sol: Kostnad
Token-priser er utgangspunktet for kostnadssammenligning. Nye forsøk, resonneringstokener, verktøykall og menneskelig gjennomgang påvirker også hvor mye du bruker for å fullføre en oppgave vellykket.
Følgende satser er i USD per million tokener og prising.
Leverandør og token-kategori
GPT-6.1 Terra
GPT-6.1 Sol
OpenAI Standard — input
$1.00
$2.00
OpenAI Standard — cached input
$0.05
$0.10
OpenAI Standard — output
$5.00
$10.00
OpenAI Standard — 30-minute cache write
$1.25
$2.50
OpenAI Standard — 12-hour cache write
$2.50
$5.00
CometAPI ordinær inndata
$0.80
$1.60
CometAPI ordinær utdata
$4.00
$8.00
OpenAI API-priser
Terras oppgitte Standard-satser er halvparten av Sols på tvers av disse kategoriene. Faktiske kostnader avhenger av forespørselens konfigurasjon: forespørsler med lang kontekst, behandlingsnivåer, regional behandling og verktøybruk kan ha ulike vilkår. Sjekk gjeldende OpenAI-prisdokumentasjon før du estimerer produksjonskostnader.
CometAPI-priser
CometAPI er en tredjeparts tilgangsvei med egen prising og funksjonstilgjengelighet. Deres oppgitte ordinære inn- og utdata-satser vises separat nedenfor.
Med disse satsene er CometAPIs ordinære inn- og utdata-priser 20% under OpenAI Standard-satsene over. Bekreft gjeldende priser, kostnader for lang kontekst, cache-støtte og verktøytilgjengelighet for kontoen din før utrulling.
Eksempel på kostnad for 1,000 forespørsler
Anta at en applikasjon gjør 1,000 forespørsler, hver med 2,000 ikke-cachede input-tokener og 500 fakturerbare output-tokener. Dette gir totalt 2 millioner input-tokener og 500,000 output-tokener.
For 1,000 forespørsler, hver med 2,000 ikke-cachede input-tokener og 500 fakturerbare output-tokener, er de estimerte kostnadene:
Terra via OpenAI: $2.00 for input og $2.50 for output, totalt $4.50.
Sol via OpenAI: $4.00 for input og $5.00 for output, totalt $9.00.
Terra via CometAPI: $1.60 for input og $2.00 for output, totalt $3.60.
Sol via CometAPI: $3.20 for input og $4.00 for output, totalt $7.20.
Disse beregningene bruker de ordinære satsene listet over, uten Batch API-rabatt. De ekskluderer cache-skrivinger, separate verktøykostnader og nye forsøk. Eventuelle resonneringstokener som faktureres som output må inkluderes i output-totalen.
Effektiv kostnad per vellykket oppgave
I denne artikkelen er en vellykket oppgave en som består forhåndsdefinert kvalitet, skjema der relevant, og fullføringssjekker uten ytterligere manuell korreksjon.
Lavere token-priser gir ikke alltid lavere operasjonelle kostnader. Terras besparelser kan krympe hvis den trenger flere forsøk, resonneringstokener eller menneskelig inngripen. Sols høyere satser kan være verdt det hvis den fullfører flere oppgaver på første forsøk.
Effektiv modell-og-verktøy-kostnad per vellykket oppgave = total modell- og verktøybruk på tvers av alle forsøk ÷ antall vellykkede oppgaver.
Før separate kostnader for menneskelig gjennomgang og korreksjon. Velg modellen som oppfyller kvalitetsmålet ditt til lavest mulig samlet kostnad, i stedet for å sammenligne token-priser alene.
Hvilken modell bør du velge: GPT-6.1 Terra eller GPT-6.1 Sol?
Velg basert på oppgavekompleksitet, verifiserbar utgangskvalitet og total fullføringskostnad. Terra er et nyttig utgangspunkt for rutinepregede arbeidsflyter; Sol er verdt å evaluere når vanskelig resonnering eller kostbare feil rettferdiggjør økt forbruk.
Når du bør velge GPT-6.1 Terra
Start med Terra for høyt volum av ekstraksjon, dokumentutkast, katalogmatching og forutsigbare applikasjonsarbeidsflyter. Disse oppgavene er gode kandidater når resultater kan kontrolleres mot kildedokumenter, påkrevde felt eller automatiske valideringsregler.
Velg Terra når den møter nøyaktighets- og fullføringsmålene innenfor tillatt budsjett for nye forsøk og menneskelig gjennomgang. Lavere token-satser gir liten fordel hvis gjentatte feil spiser opp besparelsene.
Når du bør velge GPT-6.1 Sol
Evaluer Sol for vanskelig feilsøking, repo-endringer med mange avhengigheter og skrivebordsarbeidsflyter med lange kjeder av avhengige handlinger.
Velg Sol når testing viser at den produserer flere aksepterte patches, består flere tester eller krever mindre manuell korreksjon. De høyere token-kostnadene er berettiget når disse forbedringene reduserer totalkostnaden for å fullføre arbeidet.
Når du bør bruke Terra først og eskalere til Sol
En hybrid arbeidsflyt kan bruke Terra til første forsøk og eskalere til Sol når forhåndsdefinerte sjekker feiler. Basér eskalering på observerbare resultater fremfor modellens egen selvsikkerhet.
For eksempel kan en kodegenereringsarbeidsflyt:
Be Terra produsere den forespurte endringen.
Kjør relevante tester og valideringssjekker.
Eskalér til Sol hvis endringen feiler disse sjekkene eller faller utenfor Terras verifiserte kapasitet.
Send uløste saker til menneskelig gjennomgang når budsjettet for nye forsøk er brukt opp.
Når du eskalerer, bevar den opprinnelige forespørselen, relevant kontekst, mislykket output og valideringsresultater. Registrer begge modellenes forbruk slik at kostnadssammenligningen inkluderer hele arbeidsflyten.
Sjekkliste for produksjonsevaluering
Før du velger en standardmodell eller tar i bruk en eskaleringsarbeidsflyt:
Bruk representative oppgaver: Inkluder rutineforespørsler og tilfeller der feil er kostbare.
Hold sammenligninger kontrollerte: Bruk sammenlignbare instruksjoner, bevis, verktøy og akseptkriterier. Registrer modell-ID-er, endepunkter, resonneringsinnstillinger og testdatoer.
Mål aksepterte utfall: Sjekk nøyaktighet, skjemavaliditet der relevant, testresultater og fullføring uten manuell korreksjon.
Mål tid og forbruk: Følg median og hale-latens, fakturerte tokener, verktøykall, nye forsøk og innsats for menneskelig gjennomgang.
Gjenta sammenligningen: Kjør oppgaver flere ganger og alterner modellrekkefølgen for å redusere påvirkning av engangsresultater.
Definer operasjonelle grenser: Sett budsjetter for nye forsøk, eskaleringstriggere og krav til menneskelig godkjenning før utrulling.
Sammenlign hele arbeidsflyten: Inkluder mislykkede forsøk og eskaleringskostnader når du beregner kostnad per vellykket oppgave.
Hvor kan du få tilgang til GPT-6.1 Terra og GPT-6.1 Sol?
Offisiell leverandørtilgang
Begge modellene er tilgjengelige via OpenAI API. For tekstforespørsler støttes Chat Completions; verktøykall krever Responses API. Bekreft modellens støttede parametere, kontogrenser og verktøyene som er tilgjengelige på ruten du har tenkt å bruke.
CometAPI-tilgang
For å bruke begge modellene via CometAPI, følg deres hurtigstartguide for å sette opp OpenAI-kompatibel SDK. Oppgi CometAPI-nøkkelen sikkert via miljøvariabelen COMETAPI_KEY og sett base URL til https://api.cometapi.com/v1. Velg gpt-6.1-terra eller gpt-6.1-sol som modellidentifikator, og bekreft at ruten er aktivert for kontoen din.
Til en første sammenligning, gi begge modellene de samme representative oppgavene og bruk medium resonneringsinnsats. Hold instruksjoner og akseptkriterier konsistente, gjenta hver oppgave og alterner modellrekkefølge. Sammenlign vellykkede resultater, brukt tid, fakturerte tokener og nye forsøk i stedet for å dømme noen av modellene basert på ett enkelt svar.
Konklusjon
Start med GPT-6.1 Terra for hyppige, verifiserbare arbeidsflyter der lavere token-priser og raskere oppgavefullføring betyr mye. Evaluer GPT-6.1 Sol når vanskelig koding, flertrinns verktøybruk eller kostbare feil gjør høyere resonneringsevne verdifull. Det endelige valget bør baseres på kostnad per akseptert oppgave under et representativt evalueringssett, ikke på pris eller en enkelt benchmark alene.
For mange applikasjoner er neste nyttige steg en liten, representativ pilot med klare bestått-betingelser og en avgrenset eskaleringsvei. La det målte resultatet avgjøre modellvalget, fremfor å stole på pris eller én enkelt benchmark.