Bygg med CometAPITrenger du ett API for flere modeller?Test arbeidsflyten i Playground, og opprett deretter en API-nøkkel når modellen og kostnaden passer bruksområdet ditt.
Slik kjører du MiniMax M3.1 Flash lokalt: veiledning for GPU, vLLM og SGLang
Lær hvordan du kjører MiniMax M3.1 Flash lokalt. Utforsk dens 428B/23B MoE-arkitektur, GPU-krav, oppsett av vLLM og SGLang, benchmark-resultater og API-alternativer.
MiniMax M3.1 Flash bringer AI med åpne vekter til krevende kode- og agentarbeidsflyter, men lokal kjøring krever kraftig maskinvare. MoE-arkitekturen med 428B parametere aktiverer kun 23B parametere per token, noe som reduserer beregning uten å fjerne behovet for å lagre hele modellen. Utviklere med støttede multi-GPU-systemer kan ta den i bruk med vLLM eller SGLang. For dem som vil slippe infrastrukturstyring, tilbyr MiniMax M3.1 Flash API i CometAPI en enklere måte å komme i gang på.
Key Takeaways
Maskinvaren er den største hindringen. De publiserte vLLM-konfigurasjonene bruker fire støttede Blackwell- eller AMD MI355X-GPU-er, eller åtte H100/H200-GPU-er.
Gjennomgått for klarhet, kildeangivelse og gjeldende API-terminologi.
Lang kontekst har minnekostnader. Modellen støtter opptil én million tokens, men praktiske servergrenser avhenger av tilgjengelig GPU-minne og samtidighet.
Distribusjon er maskinvarespesifikk. Bruk en kompatibel inferensmotor, kvantiseringsformat og akseleratorkonfigurasjon fremfor en generisk installasjonskommando.
Benchmark-tall er bare et utgangspunkt. Evaluer kodepresisjon, agentoppgavefullføring, ventetid og gjennomstrømning under egne arbeidslaster.
Lokal og hostet inferens dekker ulike behov. Selvhosting gir større kontroll over infrastrukturen, mens API-tilgang reduserer oppsettkompleksitet og vedlikehold.
What Is MiniMax M3.1 Flash?
MiniMax M3.1 Flash tar imot tekst, bilder og video og genererer tekst. Den er laget for kode-, automasjons-, datamaskininteraksjons- og sikkerhetsarbeidsflyter. Vektene distribueres under MiniMax Community License. Før du tilbyr en kommersiell tjeneste, les lisensen som følger med sjekkpunktet og sjekk vilkårene som gjelder for din bruk.
MiniMax M3.1 Flash specifications
Spesifikasjon
MiniMax M3.1 Flash
Utvikler
MiniMax
Modellfamilie
Nativ multimodal MoE
Totalt antall parametere
Omtrent 428B
Aktive parametere
Omtrent 23B per token
Maksimal kontekst
1,048,576 tokens (modellkapasitet)
Inndatatyper
Tekst, bilder og video (ruteavhengig)
Utdata
Tekst
Oppmerksomhet
MiniMax Sparse Attention i hvert lag
Kvantisering
MXFP8 tette lag / NVFP4 eksperter
Utkast-dekoding
DSpark integrert draft head
Resonneringsinnsats
Low, medium, high, xhigh, max
Rapportert utgangshastighet
200+ tokens/s under gunstige forhold; P50 170+ tokens/s
Lisens
MiniMax Community License
Dokumentert inferens
vLLM, SGLang
Typisk topologi
4 støttede Blackwell- eller MI355X-GPU-er; 8 H100/H200-GPU-er
How does MiniMax M3.1 Flash use its 428B/23B architecture?
En Mixture-of-Experts (MoE)-modell ruter hver token gjennom utvalgte eksperter. I MiniMax M3.1 Flash er omtrent 23B parametere aktive for en token, mens den komplette parameterpoolen er omtrent 428B. Sparsom aktivering reduserer beregning; det gjør ikke sjekkpunktet til en tett 23B-modell.
What Changed in MiniMax M3.1 Flash?
Sparse attention: Brukes gjennom hele modellen for å redusere oppmerksomhetsarbeid på lange inndata; effekten avhenger av serveringskjerner og prompt.
Mixed-precision weights: MXFP8 for tette komponenter og NVFP4 for eksperter reduserer lagrings- og beregningskrav, men krever fortsatt kompatibel maskinvare og kjerner.
DSpark decoding: Et integrert draft head kan øke genereringshastigheten i støttede oppskrifter; resultatene avhenger av token-aksept og arbeidslast.
Power-aware serving: Planlegging på infrastrukturnivå kan forbedre utnyttelse, men er ikke en funksjon du automatisk får ved å laste ned vektene.
What Hardware Is Needed for MiniMax M3.1 Flash?
Budsjetter GPU-minne i fire deler: sjekkpunktvekter, key-value (KV)-cache for tidligere tokens, kjøretidsbuffere og arbeidslastmargin. Estimatene nedenfor dekker kun rå parameterlagring. Mikspresisjon, kvantiseringsskalaer, multimodale komponenter og serveringsoverhead endrer det reelle behovet.
Validated GPU topologies
Akseleratorer
Publisert topologi
Merknader
NVIDIA GB200/GB300/B200/B300
4 GPU-er, tensorparallellisme
Blackwell NVFP4-native sti
NVIDIA H100/H200
8 GPU-er, tensorparallellisme
FP8-cacher og Marlin MoE-sti
AMD MI355X
4 GPU-er, tensorparallellisme
Krever støttet ROCm og AITER-innstillinger
24–32 GB forbruker-GPU
Ingen referanseoppskrift for fullt sjekkpunkt
Ikke tilstrekkelig for enkel enkelt-GPU-lasting
Kun CPU-arbeidsstasjon
Ingen validert praktisk distribusjon
Avlastingsforsøk er ikke produksjonsveiledning
Memory estimate: Rå lagring for 428B parametere er omtrent 856 GB med BF16, 428 GB med 8-bit, eller 214 GB med idealisert 4-bit. Det offisielle sjekkpunktet blander formater, så disse tallene er ikke VRAM-krav under kjøring. Ta høyde for kvantiseringsskalaer, KV-cache, kjøretidsbuffere og samtidighet; bruk de faktiske sjekkpunktfilene og oppskriften for din GPU for å dimensjonere systemet.
Reserver NVMe-plass til sjekkpunktet, midlertidige nedlastinger og en rollback-kopi.
Which Deployment Method Should You Choose?
For en støttet lokal klynge er vLLM et praktisk utgangspunkt med referansekonfigurasjoner og kjent API-integrasjon; SGLang passer team som vil utforske serveringstilpasning etter å ha sjekket kompatibilitet, mens CometAPI tilbyr en hostet rute for prototyping og modellswitching.
Krav
Lokal vLLM
Lokal SGLang
CometAPI
Vekter og GPU-er
Last ned vekter; operer støttede GPU-er
Last ned vekter; operer støttede GPU-er
Leverandørstyrt inferens; ingen lokale vekter
Blackwell / AMD MI355X
Maskinvarespesifikke oppskrifter
Maskinvarespesifikke oppskrifter
Maskinvare styrt av leverandør
H100/H200
Dokumentert åtte-GPU-oppskrift
Sjekk gjeldende støttematrise
Maskinvare styrt av leverandør
Dekoding og parallellisme
DSpark på støttede stier; tensor- og distribuert servering
Maskinvarespesifikk dekoding; tensor- og ekspertparallellisme
Begrenset til alternativer eksponert av ruten
Kontroll og databehandling
Ditt miljø; du styrer skalering
Ditt miljø; du styrer skalering
Ekstern leverandør; leverandøren styrer skalering
Velg rammeverket med en validert oppskrift for din maskinvare, og sammenlign deretter latens og gjennomstrømning med samme prompt, presisjon og samtidighet.
How to Run MiniMax M3.1 Flash Locally With vLLM?
Følgende trinn forutsetter en Linux-vert med fire kompatible NVIDIA Blackwell-GPU-er, en støttet driver/CUDA-miljø, og tilgang til det offisielle sjekkpunktet. Bruk en validert vLLM-build; en ordinær installasjon på ikke-støttet GPU-maskinvare kan feile selv om pakkeinstallasjonen lykkes.
Sørg for at det installerte hjulet og CUDA-kjøretiden matcher din GPU-familie. Hvis det kreves en prosjekttilpasset utviklingsbuild, følg referanseinstallasjonsnotatene før du bruker oppstartsargumentene.
Bruk en passende Hugging Face-tilgangstoken om nødvendig, behold katalogstrukturen, og verifiser komplett nedlasting av alle shard før du starter serveren.
Vent til serveren er ferdig lastet og rapporterer at den er klar før du sender en forespørsel. Kommandoen over begrenser kontekst til 32 768 tokens og samtidige sekvenser til fire for en innledende røyktest. Disse reduserte grensene er ikke benchmarkede innstillinger; juster dem etter å ha målt minnebruk og forespørselsatferd på din maskinvare.
Hvis den eksponerte identifikatoren avviker fra katalognavnet, kall /v1/models og bruk den nøyaktige returnerte ID-en. Et vellykket tekstsvar validerer kun grunnleggende inferens; test visjon, verktøy-kalling, samtidighet og lang kontekst separat.
Step 5: Integrate with an OpenAI-compatible Python client
Eksemplet lytter på 127.0.0.1 for lokal testing. Før du kobler til eksterne klienter, legg tilgangskontroller foran endepunktet og konfigurer klient-timeouts, avgrensede retries og overvåking.
H100/H200 variant: use the eight-GPU Hopper recipe
På åtte H100/H200-GPU-er, bruk Hopper-spesifikk FP8-cache og Marlin MoE-sti i stedet for Blackwell NVFP4-konfigurasjonen. Kommandoen nedenfor følger den offisielle vLLM Hopper-oppskriften med kontekst og samtidighet redusert til 32K og fire sekvenser for en første test. Den deaktiverer videoinndata i tråd med den oppskriften. Hold dette endepunktet bak dine eksisterende tilgangskontroller.
SGLang tilbyr maskinvarespesifikke M3.1-distribusjonsoppskrifter og OpenAI-kompatibel servering. Ved snapshot 23. oktober inkluderer dokumentasjonen dedikerte utviklingscontainer-images, så en generisk SGLang-installasjon bør ikke antas å inneholde all modellspecifikk støtte.
Pull the dedicated container image
# NVIDIA development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash

# AMD MI350X/MI355X development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash-mi35x
Følg deretter SGLang MiniMax M3.1-kokeboken for din akselerator. Å trekke et image laster kun kjøretiden; du må fortsatt starte en container med GPU-tilgang og lansere den matchende serveringskonfigurasjonen inni. Bruk kokebokas komplette maskinvarespesifikke kommando, vent på readiness, og spør endepunktets modelliste før du sender en testforespørsel. De dokumenterte NVIDIA- og AMD-stiene bruker ulike avhengigheter og bør konfigureres separat.
How Does MiniMax M3.1 Flash Compare on Benchmarks?
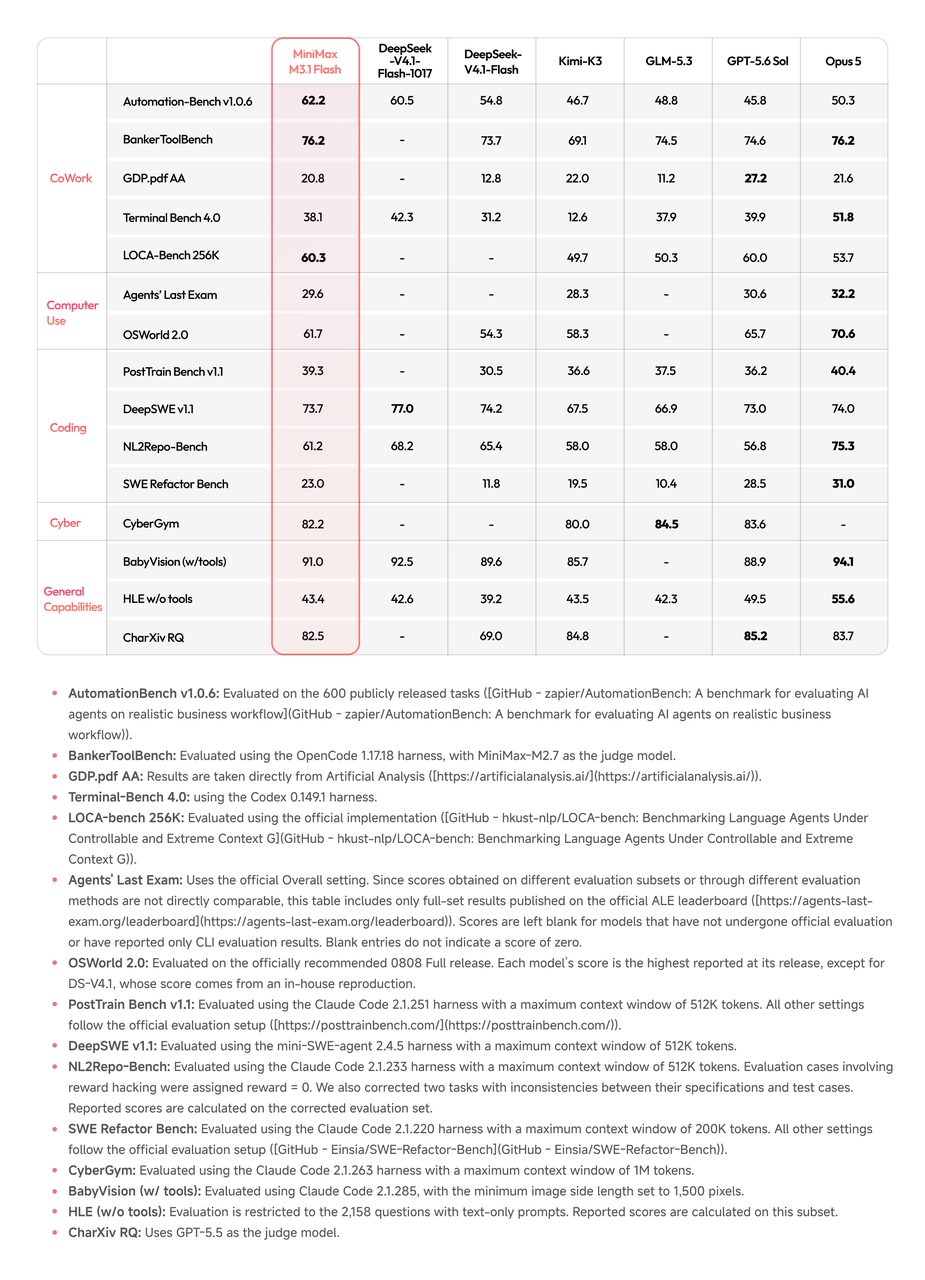
Når endepunktet ditt passerer sine grunnleggende kontroller, bruk publiserte benchmarks for å avgjøre hvilke arbeidslaster du vil teste videre. Tallene nedenfor er leverandørpubliserte evalueringer, ikke målinger av din lokale distribusjon.
Benchmark
M3.1 Flash
DeepSeek V4.1 Flash 1017
Kimi K3
Automation-Bench v1.0.6
62.8
60.5
46.7
DeepSWE v1.1
73.7
77.0
67.5
Terminal Bench 4.0
38.1
42.3
12.6
OSWorld 2.0
61.7
N/A
58.3
NL2Repo-Bench
61.2
68.2
58.0
BabyVision with tools
91.0
92.5
85.7
I denne sammenligningen leder MiniMax de oppførte modellene på Automation-Bench, mens DeepSeek leder flere kodebenchmarks. Les modelkortet og evalueringsinnstillingene før du trekker konklusjoner, og test promptene og verktøyene applikasjonen din faktisk bruker. Poeng fra ulike benchmarkversjoner eller oppsett er ikke direkte sammenlignbare.
How Can You Optimize MiniMax M3.1 Flash Performance?
Control context and concurrency
Etter den første vellykkede forespørselen, øk én lastvariabel om gangen: inndatalengde, utgangslengde eller samtidige forespørsler. Registrer toppminne og responstid for hver kjøring. Behold de sist stabile innstillingene som din rollback, slik at et mislykket eksperiment ikke blir ditt nye grunnlag.
Choose reasoning effort deliberately
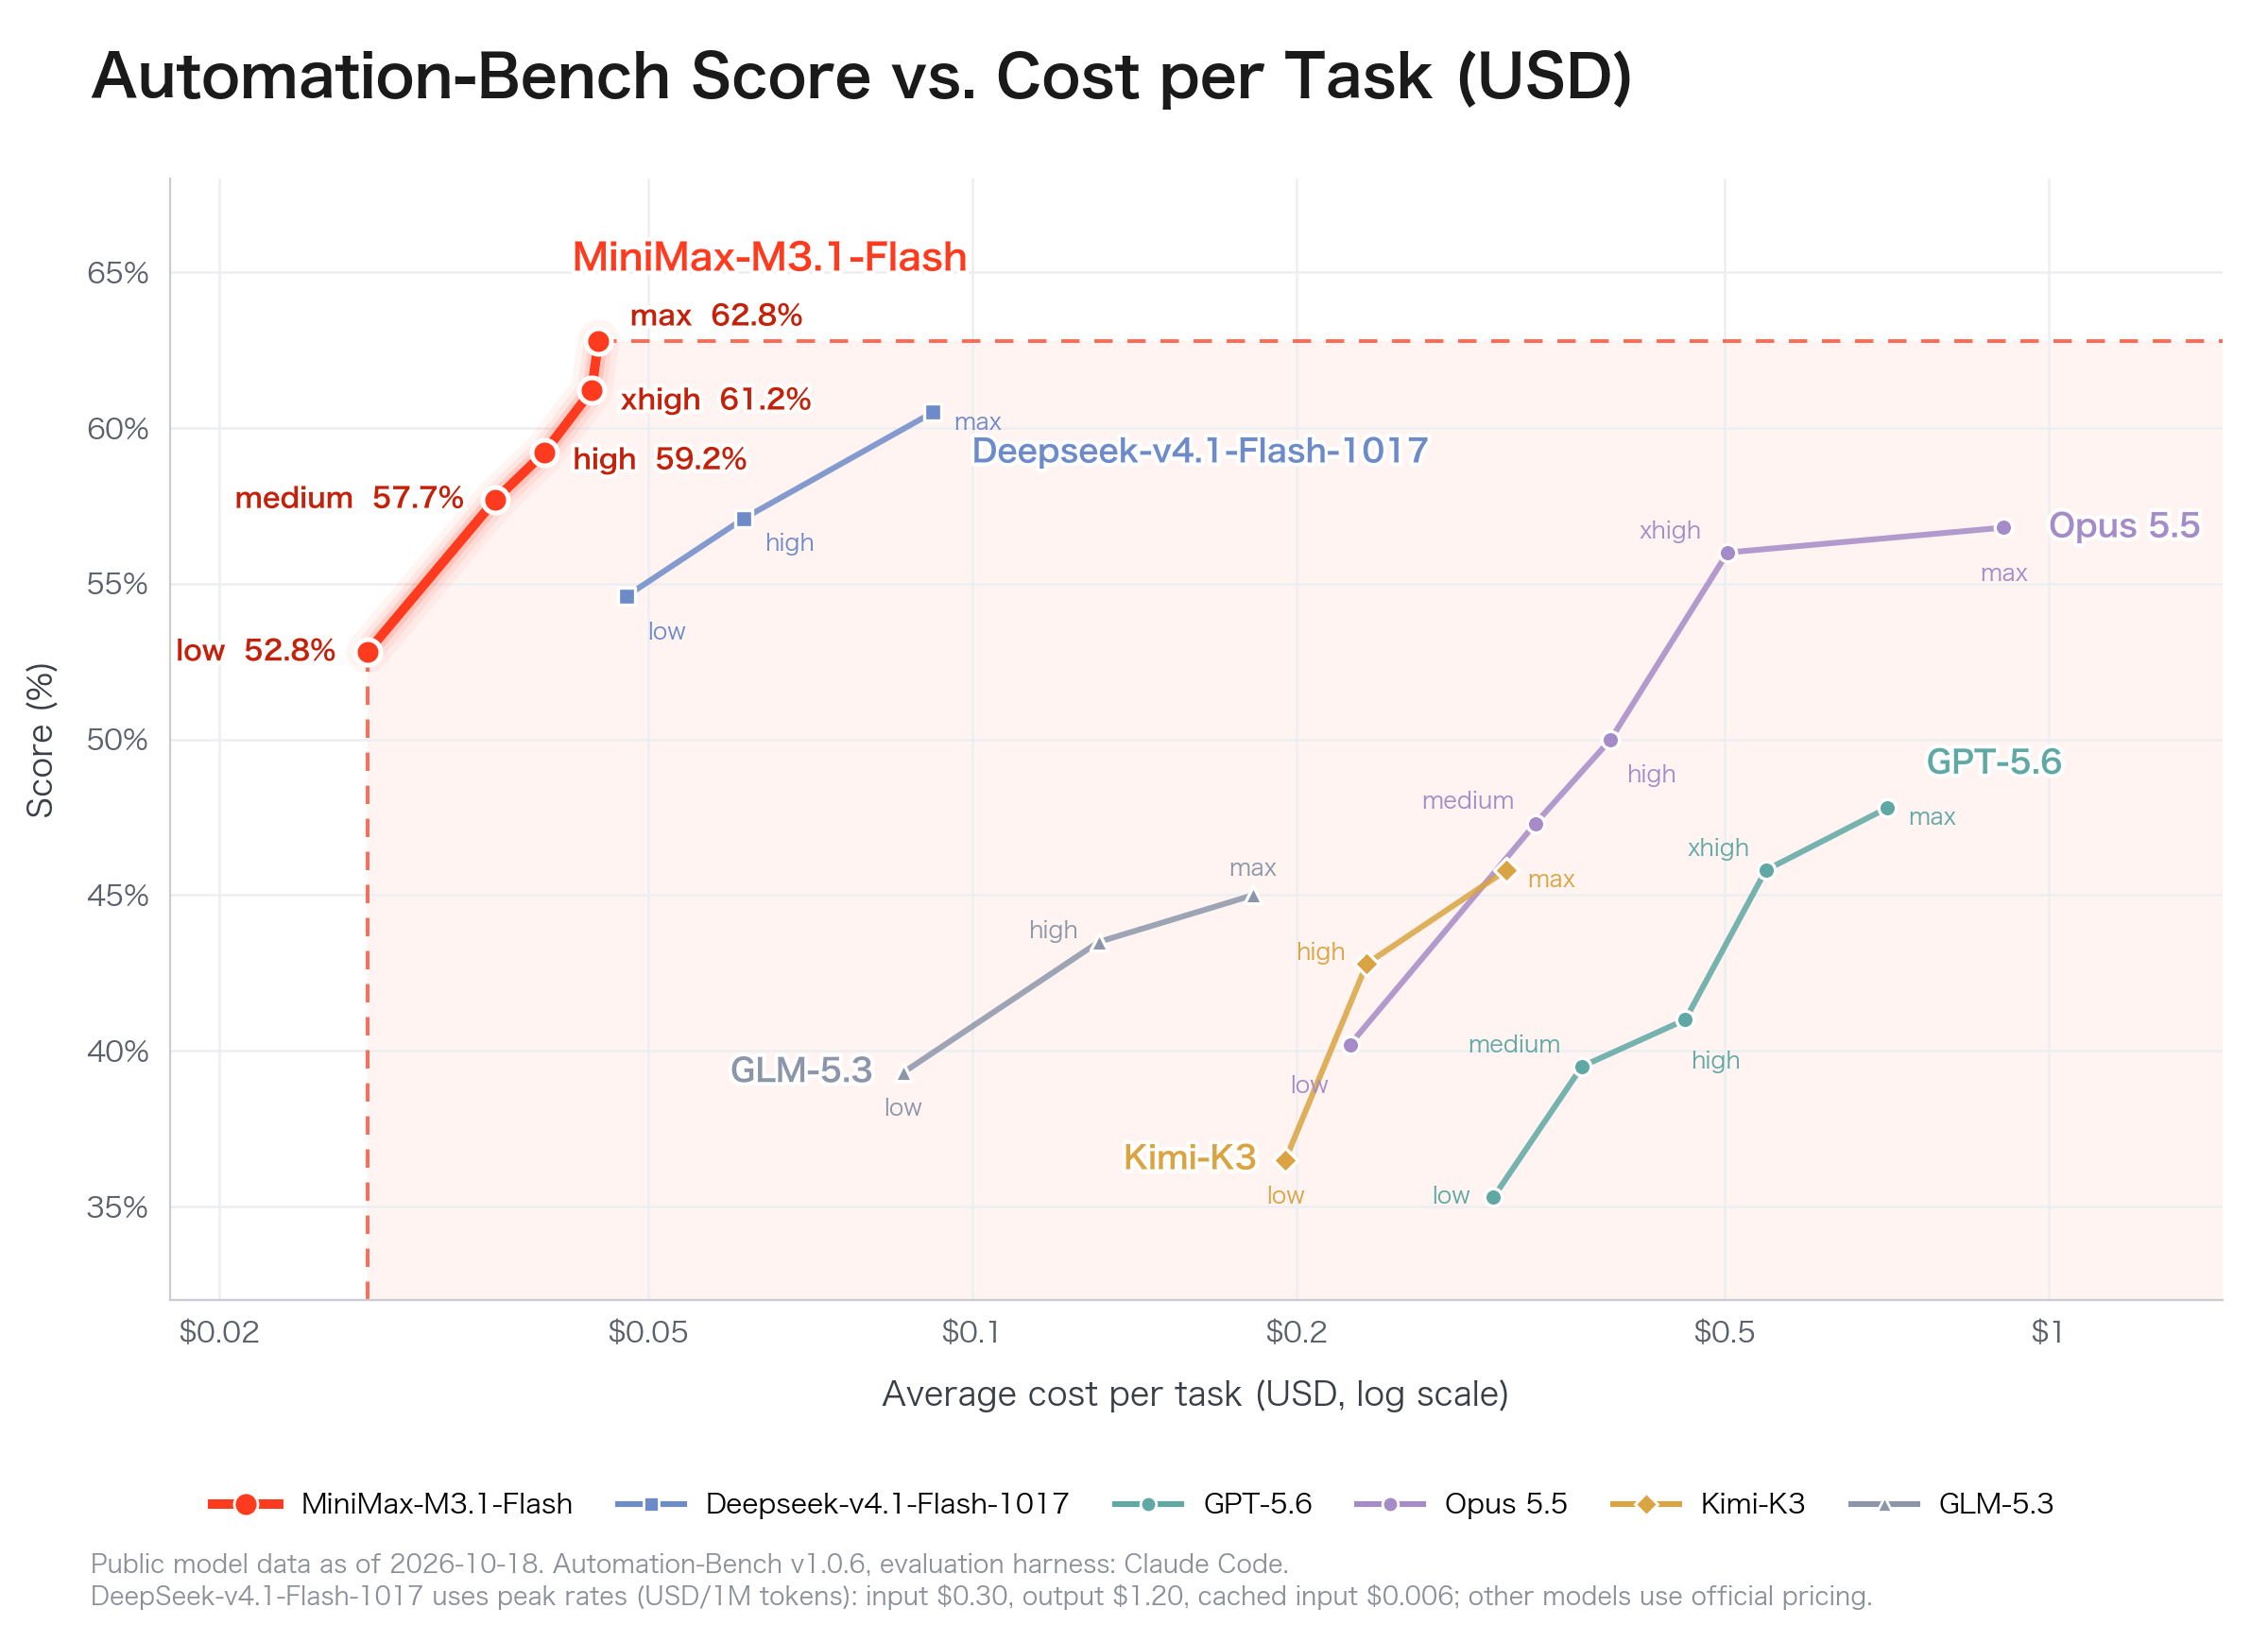
M3.1 Flash støtter low, medium, high, xhigh og max innsats. Høyere innstillinger kan forbedre poengsummene for krevende oppgaver, men krever ofte flere resonneringstokens og lengre latens. Bruk oppgavekvalitet og medgått beregningskostnad sammen.
For lokale vLLM-forespørsler viser oppskriften reasoning-effort-innstillinger under chat_template_kwargs. Sjekk både det endelige svaret og eventuelt separat returnert resonneringsfelt når du validerer klienten, siden hostede og lokale endepunkter kan eksponere disse feltene forskjellig.
Track cost per completed task
For agenter er tokens per sekund ikke nok. Registrer tid til første token, utgangshastighet, akseptrate for spekulativ dekoding, samtidig gjennomstrømning, feil ved verktøy-kall, minneutnyttelse og kostnad per fullført oppgave. Et tregere svar med færre mislykkede verktøy kan gi bedre totaløkonomi.
How Can You Use MiniMax M3.1 Flash API in CometAPI?
Team som ikke trenger dedikert akseleratorinfrastruktur kan bruke et OpenAI-kompatibelt hostet endepunkt. Dette eliminerer sjekkpunktnedlasting og GPU-operasjoner, men flytter forespørselsbehandling utenfor det selvhostede miljøet.
export COMETAPI_KEY="YOUR_COMETAPI_KEY"

curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-m3.1-flash",
    "messages": [{"role":"user","content":"Review this Python function for edge cases."}],
    "max_tokens": 2048
  }'
Bekreft modellidentifikator i din CometAPI-konsoll før du kjører dette eksemplet. Bruk gatewayen når et felles API på tvers av leverandører er nyttig for applikasjonen din; sammenlign gjeldende pris med direkte tilgang for forventet bruk.
MiniMax M3.1 Flash API pricing
Pris per million tokens
MiniMax offisielt API
CometAPI
Inndata
$0.15
$0.80
Utdata
$0.60
$3.20
Cached inndata
$0.015
Bekreft gjeldende rutepris
MiniMax direkte API-satser i lanseringsinnlegget 19. oktober 2026 (link) er $0.15 inndata, $0.60 utdata, og $0.015 cachet inndata per million tokens. For CometAPI, sjekk aktiv modellrute, inndata-/utdatasatser, caching-regler og eventuelle kontorabatter før du estimerer forbruk. Sammenlign totalkostnad for din forventede token-miks og retries.
What Problems Might Occur When Running MiniMax M3.1 Flash?
Out of memory during loading or requests
Hvis vekter ikke lastes: Sjekk feilsteg i oppstartlogg, bekreft at sjekkpunktet er komplett, og verifiser at GPU-topologi og kvantiseringsbackend matcher oppskriften. Hvis vektene overstiger tilgjengelig minne, bruk en konfigurasjon med tilstrekkelig kapasitet; å forkorte en forespørsel kan ikke rette en vektlastingsfeil.
Hvis vekter lastes men cache-allokering feiler ved oppstart: Sjekk cache-innstillinger og tilgjengelig minne, reduser deretter konfigurert kontekst eller samtidighet i tråd med oppskriften.
Hvis serveren starter men en forespørsel går tom for minne: Prøv en kort prompt med én forespørsel om gangen, øk deretter inndatalengde, utgangslengde og samtidighet separat mens du overvåker minne.
Incompatible quantization or attention kernels
NVFP4-kjøring skiller seg mellom Blackwell, Hopper og AMD-maskinvare. Match inferensmotorversjoner, kvantiseringsbackends, CUDA/ROCm-versjoner og akseleratorfamilier i stedet for å gjenbruke flagg ukritisk.
Sparse-attention cache configuration
Hvis oppstart rapporterer en ikke-støttet cache-layout, sammenlign komplett cache-konfigurasjon med den maskinvarespesifikke oppskriften. Den gjeldende vLLM-oppskriften krever --block-size 128 for MSA sparse/index-cache. Hvis oppstart rapporterer en cache-layout- eller block-size-feil, sammenlign komplett konfigurasjon med oppskriften for din maskinvare.
Unexpected model identifiers
En lokal sti og et eksternt gateway-modellnavn er ikke nødvendigvis identiske. Spørr det lokale /v1/models-svaret og unngå hardkoding av antakelser fra et annet endepunkt.
Poor observed throughput
Skille mellom treg promptbehandling og treg tokengenerering. Sammenlign kjøringer med samme inndatalengde og utgangsgrense, sjekk deretter GPU-utnyttelse og interconnect-atferd før du øker batchstørrelse. En hastighetsfigur fra leverandørhostet miljø er ikke en baseline for din lokale klynge.
Conclusion
Velg din første distribusjonsvei ut fra maskinvaren du kan operere i dag. Bruk vLLM-veiledningen for en støttet lokal klynge, den maskinvarespesifikke SGLang-kokeboken for et alternativt serveringsstakk, eller et hostet API når du vil fokusere på applikasjonsintegrasjon. Behold konfigurasjonen som møter målene for oppgavekvalitet og latens til en bærekraftig driftskostnad.
Den mest pålitelige måten å velge en serveringsmetode på er å optimalisere for korrekt fullført arbeid per dollar og minutt, ikke bare topp tokens per sekund.
FAQ
How do I make a deployment reproducible after upgrading the runtime?
Pin sjekkpunktrevisjon, runtime-image eller pakkeversjoner, driverstabel og oppstartsinnstillinger. Kjør samme lille akseptsett før hver oppgradering, og ha forrige fungerende konfigurasjon tilgjengelig for rollback.
How should I handle retries when an agent calls tools?
Skill mellom å retrye modellen og å gjenta en verktøyhandling. Bruk idempotensnøkler for handlinger som endrer data, sjekk om første forsøk lyktes, og valider komplette verktøyargumenter før kjøring.
Can I switch between a local endpoint and CometAPI without changing application behavior?
Hold endepunkt, legitimasjon og modell-ID konfigurerbart. Test streaming, verktøy-kall, resonneringsfelt og multimodale inndata på begge ruter, og bekreft dine krav til dataruting før du aktiverer fallback.
What should I test before accepting multimodal inputs?
Test representative bilder og videoer, inkludert lav kvalitet og ikke-støttede filer. Sjekk forhåndsprosessering, størrelsesgrenser, svarkvalitet og timeouts separat; en vellykket tekstforespørsel validerer ikke den multimodale stien.
How do I know whether a deployment is ready for real users?
Sett mål for oppgavesuksess, gyldige verktøy-kall, latens, feil og kostnad. Test realistisk trafikk, verifiser overvåking og fallback-atferd, og utvid fra en liten utrulling kun mens disse målene holder.