Hva er GPT-Image-1.5-API-et?
GPT-Image-1.5 er det nyeste medlemmet av OpenAIs GPT Image-familie og modellen bak ChatGPTs fornyede Images-opplevelse. Den er utviklet for å flytte bildegenerering fra nyhets-/eksperimentstadiet til produksjonsklare kreative verktøy: høyere fotorealisme, finere kontroll for iterative redigeringer og raskere inferens for å støtte interaktive og virksomhetsarbeidsflyter.
gpt-image-1.5 API er et multimodalt bildeendepunkt som aksepterer ett eller flere bildeinput (filidentifikatorer eller byte) pluss en tekstprompt og returnerer genererte bilder eller redigerte bilder. Det støtter:
- Tekst-til-bilde-generering (lag fra prompt),
- Bilderedigering / inpainting / komposisjon (bruk instruksjoner på eksisterende bilder, flere bildeinndata tillatt), og
- Iterative, fleromgangs redigeringsarbeidsflyter gjennom Responses API (muliggjør “tweak & iterate”-grensesnitt).
API-et behandler bildeprompter annerledes enn de gamle DALL·E-begrensningene: GPT-bildemodeller aksepterer betydelig lengre tekstprompter (retningslinje på 32 000 tegn), noe som gjør komplekse, kravtunge instruksjoner gjennomførbare.
Hovedfunksjoner (praktisk)
- Forbedret redigerbarhet / fleromgangskonsistens: bevarer figurkarakteristikk, lyssetting og viktige visuelle attributter på tvers av iterative redigeringer. Dette gjør “samme modell, gjentatte redigeringer” mer pålitelig for arbeidsflyter som produktkataloger eller merkevareaktiva.
- Raskere gjennomstrømning — 4× hastighetsforbedring over GPT Image 1, med mål om lavere latens for iterative kreative arbeidsflyter.
- Kostnadsoptimalisering — kostnader for bildeinn/-ut redusert med omtrent 20 % vs. GPT Image 1, som senker kostnad per bildeiterasjon for brukere med høyt volum.
- Flerbildekomposisjon og stilreferanser — godtar flere referansebilder for å komposittere scener eller overføre stil/lyssetting.
- Kvalitets-/fidelitetsbrytere — API-parametere som balanserer hastighet mot fidelitet (bruk lavere kvalitet for massegenerering; høyere kvalitet for produksjonsaktiva).
- Fleromgangsredigering / Responses API-integrasjon — muliggjør trinnvise arbeidsflyter (be om endringer, deretter “gjør småjusteringer” med tilstandsbevaring).
Tekniske kapabiliteter
- Begrensning for tekstprompt (bildemodeller): opptil 32 000 tegn (merk: OpenAI dokumenterer dette som tekstlengdekvoten for GPT-bildemodeller). Bruk dette for lange, kravtunge prompter.
- Bildeinndata: godtar File IDs (foretrukket for fleromgangsforløp) eller rå byte; flere bilder kan oppgis for komposisjon og referanse.
- Utdata: PNG/JPEG eller plattformens standard bildeartefakter returnert av API-et (eller som vedlegg i ChatGPT). Utdata kan inkludere flere kandidatbilder og støtter iterative forespørsler for å finjustere et resultat.
- Genereringsmoduser: tekst-til-bilde, bilderedigering (inpaint/utvid med instruksjoner), og varianter. Fleromgangsredigering støtter “legg til/trekk fra/kombiner”-instruksjoner.
- Instruksjonsbevisst redigering: modellene er optimalisert for instruksjonsfidelitet (bevarer spesifiserte invarianter som “ikke endre logoen”, “behold positur og lyssetting”). Prompt-engineering-mønstre (eksplisitte invarianter gjentatt for hver iterasjon) reduserer semantisk drift.
Ytelse i benchmarker
- Plassering på resultattavler: En samlet rapport oppga GPT Image 1.5 i ledelsen for tekst-til-bilde-rangeringer med ~1264 poeng på en Artificial Analysis-resultattavle, foran neste modell med en målbar margin.
- Oppgavemetrikker (redigering og bevaring): en Microsoft Foundry-oppsummering av evalueringsmetrikk viser at GPT-Image-1.5 oppnår tilnærmet perfekt binær endringssuksess (100 % på en enkeltomgangs BinaryEval) og sterke ansiktsbevaringsscore (omtrent 90 % på AuraFace-målinger) i deres sammenligningstabell mot konkurrenter og tidligere OpenAI-modeller. Disse sammenligningsmetrikkene plasserer GPT-Image-1.5 foran noen rivaler når det gjelder bevaring og redigeringsfidelitet.
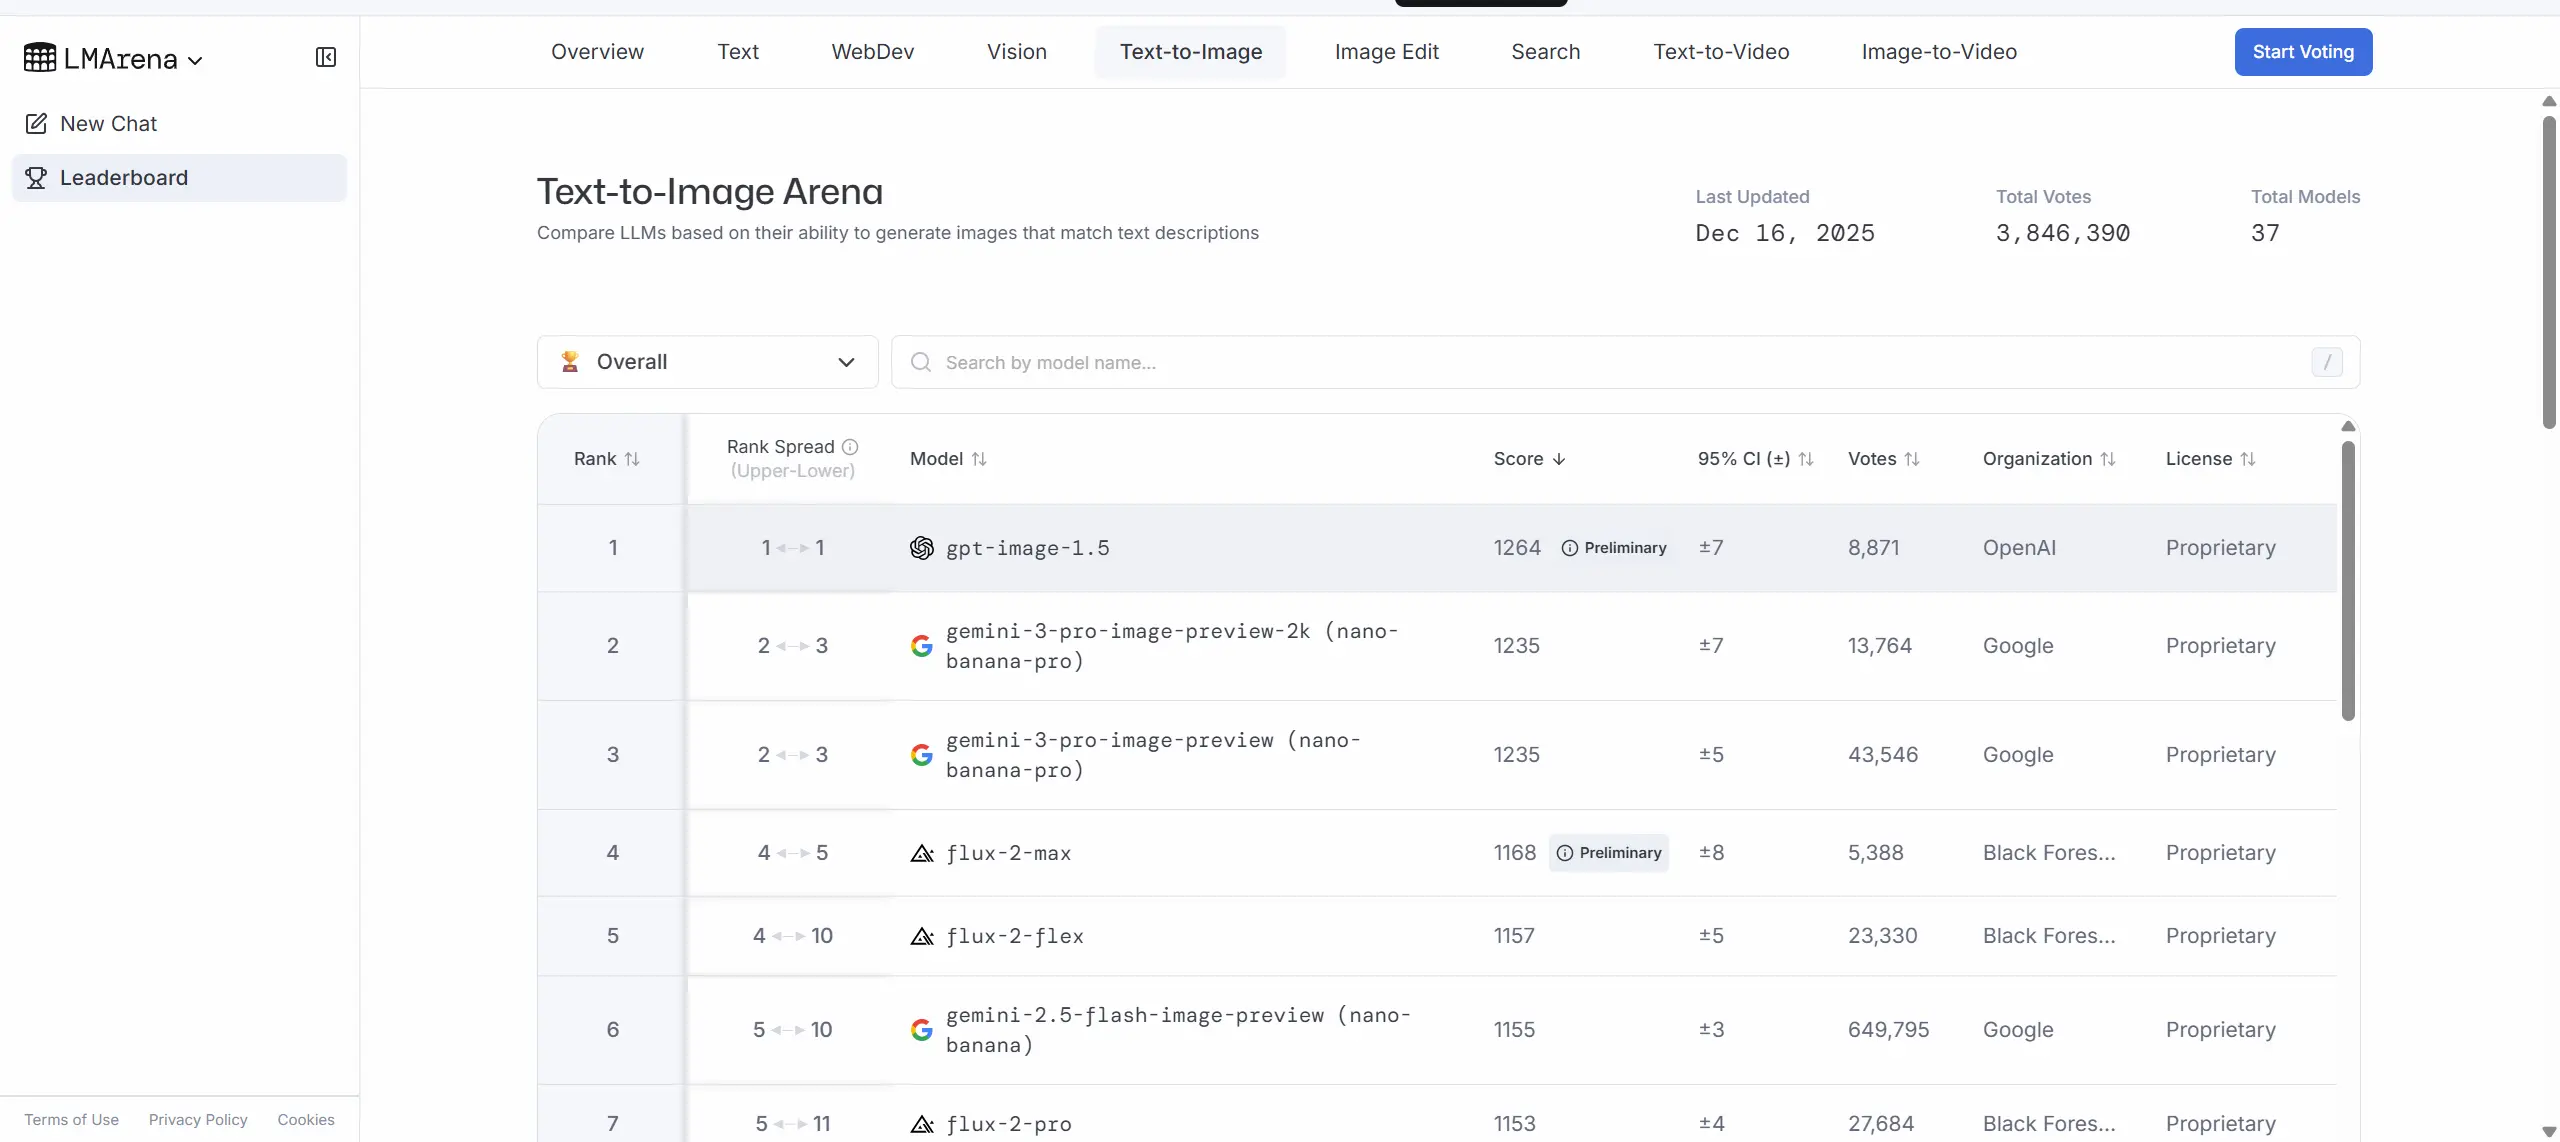
Hvordan GPT-Image-1.5 sammenlignes med andre
- Vs. GPT Image 1 (forrige OpenAI-generasjon): raskere (opptil 4×), billigere (~20 % lavere bilde-IO-kostnad), og sterkere redigeringsfidelitet — rettet mot å gå fra “prototype/demo” til “produksjonsvennlige” bildearbeidsflyter.
- Vs. Googles Nano Banana Pro / Gemini-bildemodeller: GPT-Image-1.5 og Googles Nano Banana Pro / Gemini 3-familie er nære rivaler — hver har styrker i ulike promptklasser. OpenAIs budskap vektlegger redigeringsfidelitet og iterasjonshastighet; Googles tilbud har blitt rost for realisme på studionivå i noen eksempler.
- Vs. Qwen Image og andre åpne/lukkede modeller: GPT-Image-1.5 overgår Qwen Image på flere redigerings- og bevaringsmetrikk i enkeltomgangsevalueringer, men forskjellene snevres inn i fleromgangs- eller andre domenespesifikke tester.
Hvor GPT-Image-1.5 er sterk
- Netthandelens produktbilder: massevarianter, bakgrunnsbytter, konsistente produktkataloger fra ett enkelt foto (bevaring av merke/logo).
- Produksjon av kreative og markedsføringsaktiva: raske konseptiterasjoner, fotorealistiske mockups, kontrollert stiloverføring.
- Foto-retusjering og redaksjonelle arbeidsflyter: realistiske påklednings-/frisyreprøver, selektiv retusjering som bevarer identitet og lyssetting.
- Integrasjon i designverktøy: koble til designplattformer eller CMS for bildevarianter på forespørsel (fidelitetsbrytere hjelper med kostnadskontroll).
- Flertrinns kompositeringspipeliner: flere bildeinndata muliggjør kompositering og referansebasert generering for komplekse scener.
Slik får du tilgang til GPT Image 1.5 API
Trinn 1: Registrer deg for API-nøkkel
Logg inn på cometapi.com. Hvis du ikke er bruker ennå, registrer deg først. Logg inn på din CometAPI console. Hent tilgangslegitimasjonens API-nøkkel for grensesnittet. Klikk “Add Token” ved API token i det personlige senteret, hent token-nøkkelen: sk-xxxxx og send inn.
Trinn 2: Send forespørsler til GPT Image 1.5 API
Velg endepunktet “gpt-image-1.5” for å sende API-forespørselen og sett forespørselens body. Forespørselsmetode og request body finnes i API-dokumentasjonen på nettstedet vårt. Nettstedet vårt tilbyr også Apifox-test for enkelhets skyld. Erstatt <YOUR_API_KEY> med din faktiske CometAPI-nøkkel fra kontoen din. basis-URL er Images (https://api.cometapi.com/v1/images/generations) og [Image Editing]
Sett inn spørsmålet eller forespørselen din i content-feltet—det er dette modellen vil svare på. Behandle API-responsen for å hente det genererte svaret.
Trinn 3: Hent og verifiser resultater
Behandle API-responsen for å hente det genererte svaret. Etter behandling svarer API-et med oppgavestatus og utdata.
Se også Gemini 3 Pro Preview API