
Anthropic lanserte Fable 5.1 1. september 2026 som deres mest kapable allment tilgjengelige modell for koding og kunnskapsarbeid. Modellen retter seg mot oppgaver med lang horisont: fler-timers koding, flertrinns forskning, dokumenttungt profesjonelt arbeid og agenter som gjentatte ganger bruker verktøy samtidig som de bevarer store mengder kontekst.
Claude Fable 5.1 kombinerer et 1M-token kontekstvindu, opptil 128K utdata-tokens, tekst- og bildeinndata og alltid påslått adaptiv tenkning. Basisprisene forblir $10 inndata og $50 utdata per MTok; den viktige kostnadsendringen er $0.25 per MTok for cache-lesinger.
Spesifikasjoner for Claude Fable 5.1 på et øyeblikk
Spesifikasjonene nedenfor kommer fra Anthropics modelldokumentasjon. Prisene er Anthropics listepriser og bør holdes atskilt fra eventuelle CometAPI-priser.
| Offisiell spesifikasjon | Claude Fable 5.1 |
|---|---|
| Utgivelse og modell-ID | 1. september 2026 — claude-fable-5-1 |
| Primærrolle | Krevende resonnering og agentisk arbeid med lang horisont |
| Kontekst og maksimal utdata | 1M-token kontekst — opptil 128K utdata |
| Inndata → utdata | Tekst og bilder → tekst |
| Tenkning og standard API-innsatsnivå | Adaptiv tenkning, alltid på — High effort |
| Pålitelig kunnskapsavgrensning | juni 2026 |
| Listepris | $10 inndata — $50 utdata — $0.25 cache-lesing per MTok |
To detaljer betyr mer enn råtallene. 1M kontekstvindu er tilgjengelig som standard i stedet for som et eget langkontekst-nivå. Adaptiv tenkning er alltid på, mens innsats styrer hvor mye arbeid modellen utfører; Anthropic sier at standarden er High i Claude Code og Medium i Claude Cowork og Claude.ai.
Hva er Claude Fable 5.1
Claude Fable 5.1 er Anthropics frontermodell for jobber der et system må fortsette å resonnere, bruke verktøy og bevare kontekst over mange steg. I stedet for å sikte mot korte spørsmål-og-svar-utvekslinger, er den designet for vedvarende gjennomføring: utforsking av en kodebase, kjøring av terminalarbeidsflyter, syntese av store dokumentsett og fullføring av profesjonelle oppgaver som kan ta timer.
Den definerende pakken er et 1M-token kontekstvindu med opptil 128K utdata, tekst- og bildeinndata, og adaptiv tenkning som forblir aktiv gjennom hele forespørselen. Dette lar en agent holde lange instruksjoner, kildemateriale, verktøyresultater og mellomliggende beslutninger i én arbeidskontekst, samtidig som resonnementinnsatsen justeres etter vanskelighetsgraden i hvert steg.
Best egnet er en høyverdiarbeidsflyt der feil, omarbeiding eller tapt kontekst koster mer enn premium tokenpris. Eksempler inkluderer utvikling i repository-skala, flertrinns forskning, datamaskinbruk-agenter, dokumentanalyse med mye compliance og forretningsautomatisering med gjentatte verktøykall. For rutinemessig klassifisering, utvinning i høyt volum eller latenssensitiv chat kan et rimeligere Claude-nivå fortsatt være et bedre utgangspunkt.
Standard bruk av Fable krever 30 dagers lagring for sikkerhetsovervåking. Kvalifiserte bedriftskunder kan bruke null datalagring mens Enterprise Frontier Safeguards rulles ut; Anthropic sier at den planlagte arkitekturen lagrer overvåkede data i kundekontrollert skytinfrastruktur. Regulerte team bør verifisere kontospesifikke vilkår før produksjonssetting.
Claude Fable 5.1 vs. Fable 5: Hva er endret?
5.1-versjonen er ikke et jevnt kapabilitetshopp. De tydeligste endringene er lavere kostnad for gjentatt kontekst og mye sterkere gjennomføring på agentisk forskning, terminalkoding og forretningsarbeidsflyter, mens generelt verktøyassistert resonnement bare beveger seg litt.
| Dimensjon | Claude Fable 5 | Claude Fable 5.1 | Endring |
|---|---|---|---|
| Grunnpris inndata/utdata | $10 / $50 per MTok | $10 / $50 per MTok | Uendret |
| Cache-lesing | $1.00 per MTok | $0.25 per MTok | 75% lavere |
| Terminal-Bench-Science 0.1 | 24.7% | 52.6% | +27.9 poeng |
| Terminal-Bench 4.0 | 42.0% | 55.8% | +13.8 poeng |
| AutomationBench | 17.1% | 31.4% | +14.3 poeng |
| HLE with tools | 63.8% | 65.0% | +1.2 poeng |
Cache-lesinger er 75% billigere mens basisprisene forblir uendret
Inndata forblir $10 per MTok og utdata forblir $50 per MTok, så overskriftsraten falt ikke. Den materielle endringen er cache-leseprisen som faller fra $1.00 til $0.25 per MTok. Dette betyr mest for agenter som gjentatte ganger laster inn et langt prefiks som inneholder repositories, policyer, dokumenter, verktøydefinisjoner og tidligere tilstand. Deres kostnad per fullført arbeidsflyt kan falle selv når ferske inndata- og utdata-priser ikke gjør det.
Agentisk vitenskapelig forskning viser den største forbedringen
Terminal-Bench-Science 0.1 stiger fra 24.7% til 52.6%, en økning på 27.9 prosentpoeng og mer enn en dobling av forrige score. Dette er det sterkeste beviset på at Fable 5.1 forbedrer gjennomføring med lang horisont: planlegging av en undersøkelse, bruk av verktøy, tolkning av resultater og gjenopphenting fra mellomliggende feil.
Terminalkoding og forretningsautomatisering forbedres vesentlig
Terminal-Bench 4.0 øker fra 42.0% til 55.8%, mens AutomationBench stiger fra 17.1% til 31.4%. Disse resultatene peker på bedre ende-til-ende oppgavefullføring, ikke bare bedre kodegenerering. Team bør forvente størst fordel i arbeidsflyter som krever at modellen inspiserer et miljø, velger handlinger, bruker verktøy og verifiserer resultater på tvers av flere steg.
Generell resonnering forbedres mindre enn gjennomføring
Humanity's Last Exam med verktøy går fra 63.8% til 65.0%, bare 1.2 poeng, og CursorBench øker med 2.9 poeng. Sammenligningen støtter derfor ikke et generelt krav om at hver kapabilitet forbedret seg likt. Fable 5.1 forstås best som en gjennomføringsfokusert oppgradering der de sterkeste gevinstene oppstår når resonnement må opprettholdes gjennom verktøy og lange oppgavekjeder.
Sammenligningsresultat: Eksisterende Fable 5-brukere som kjører lange, verktøytunge agenter har den klareste grunnen til å oppgradere: vesentlig billigere cache-lesinger og færre feil på gjennomføringsorienterte benchmarks. Team som bruker korte prompt eller generelle kunnskapsoppgaver bør validere de mindre gevinstene opp mot latens og totalkostnad før migrering.
Benchmark-ytelse for Claude Fable 5.1
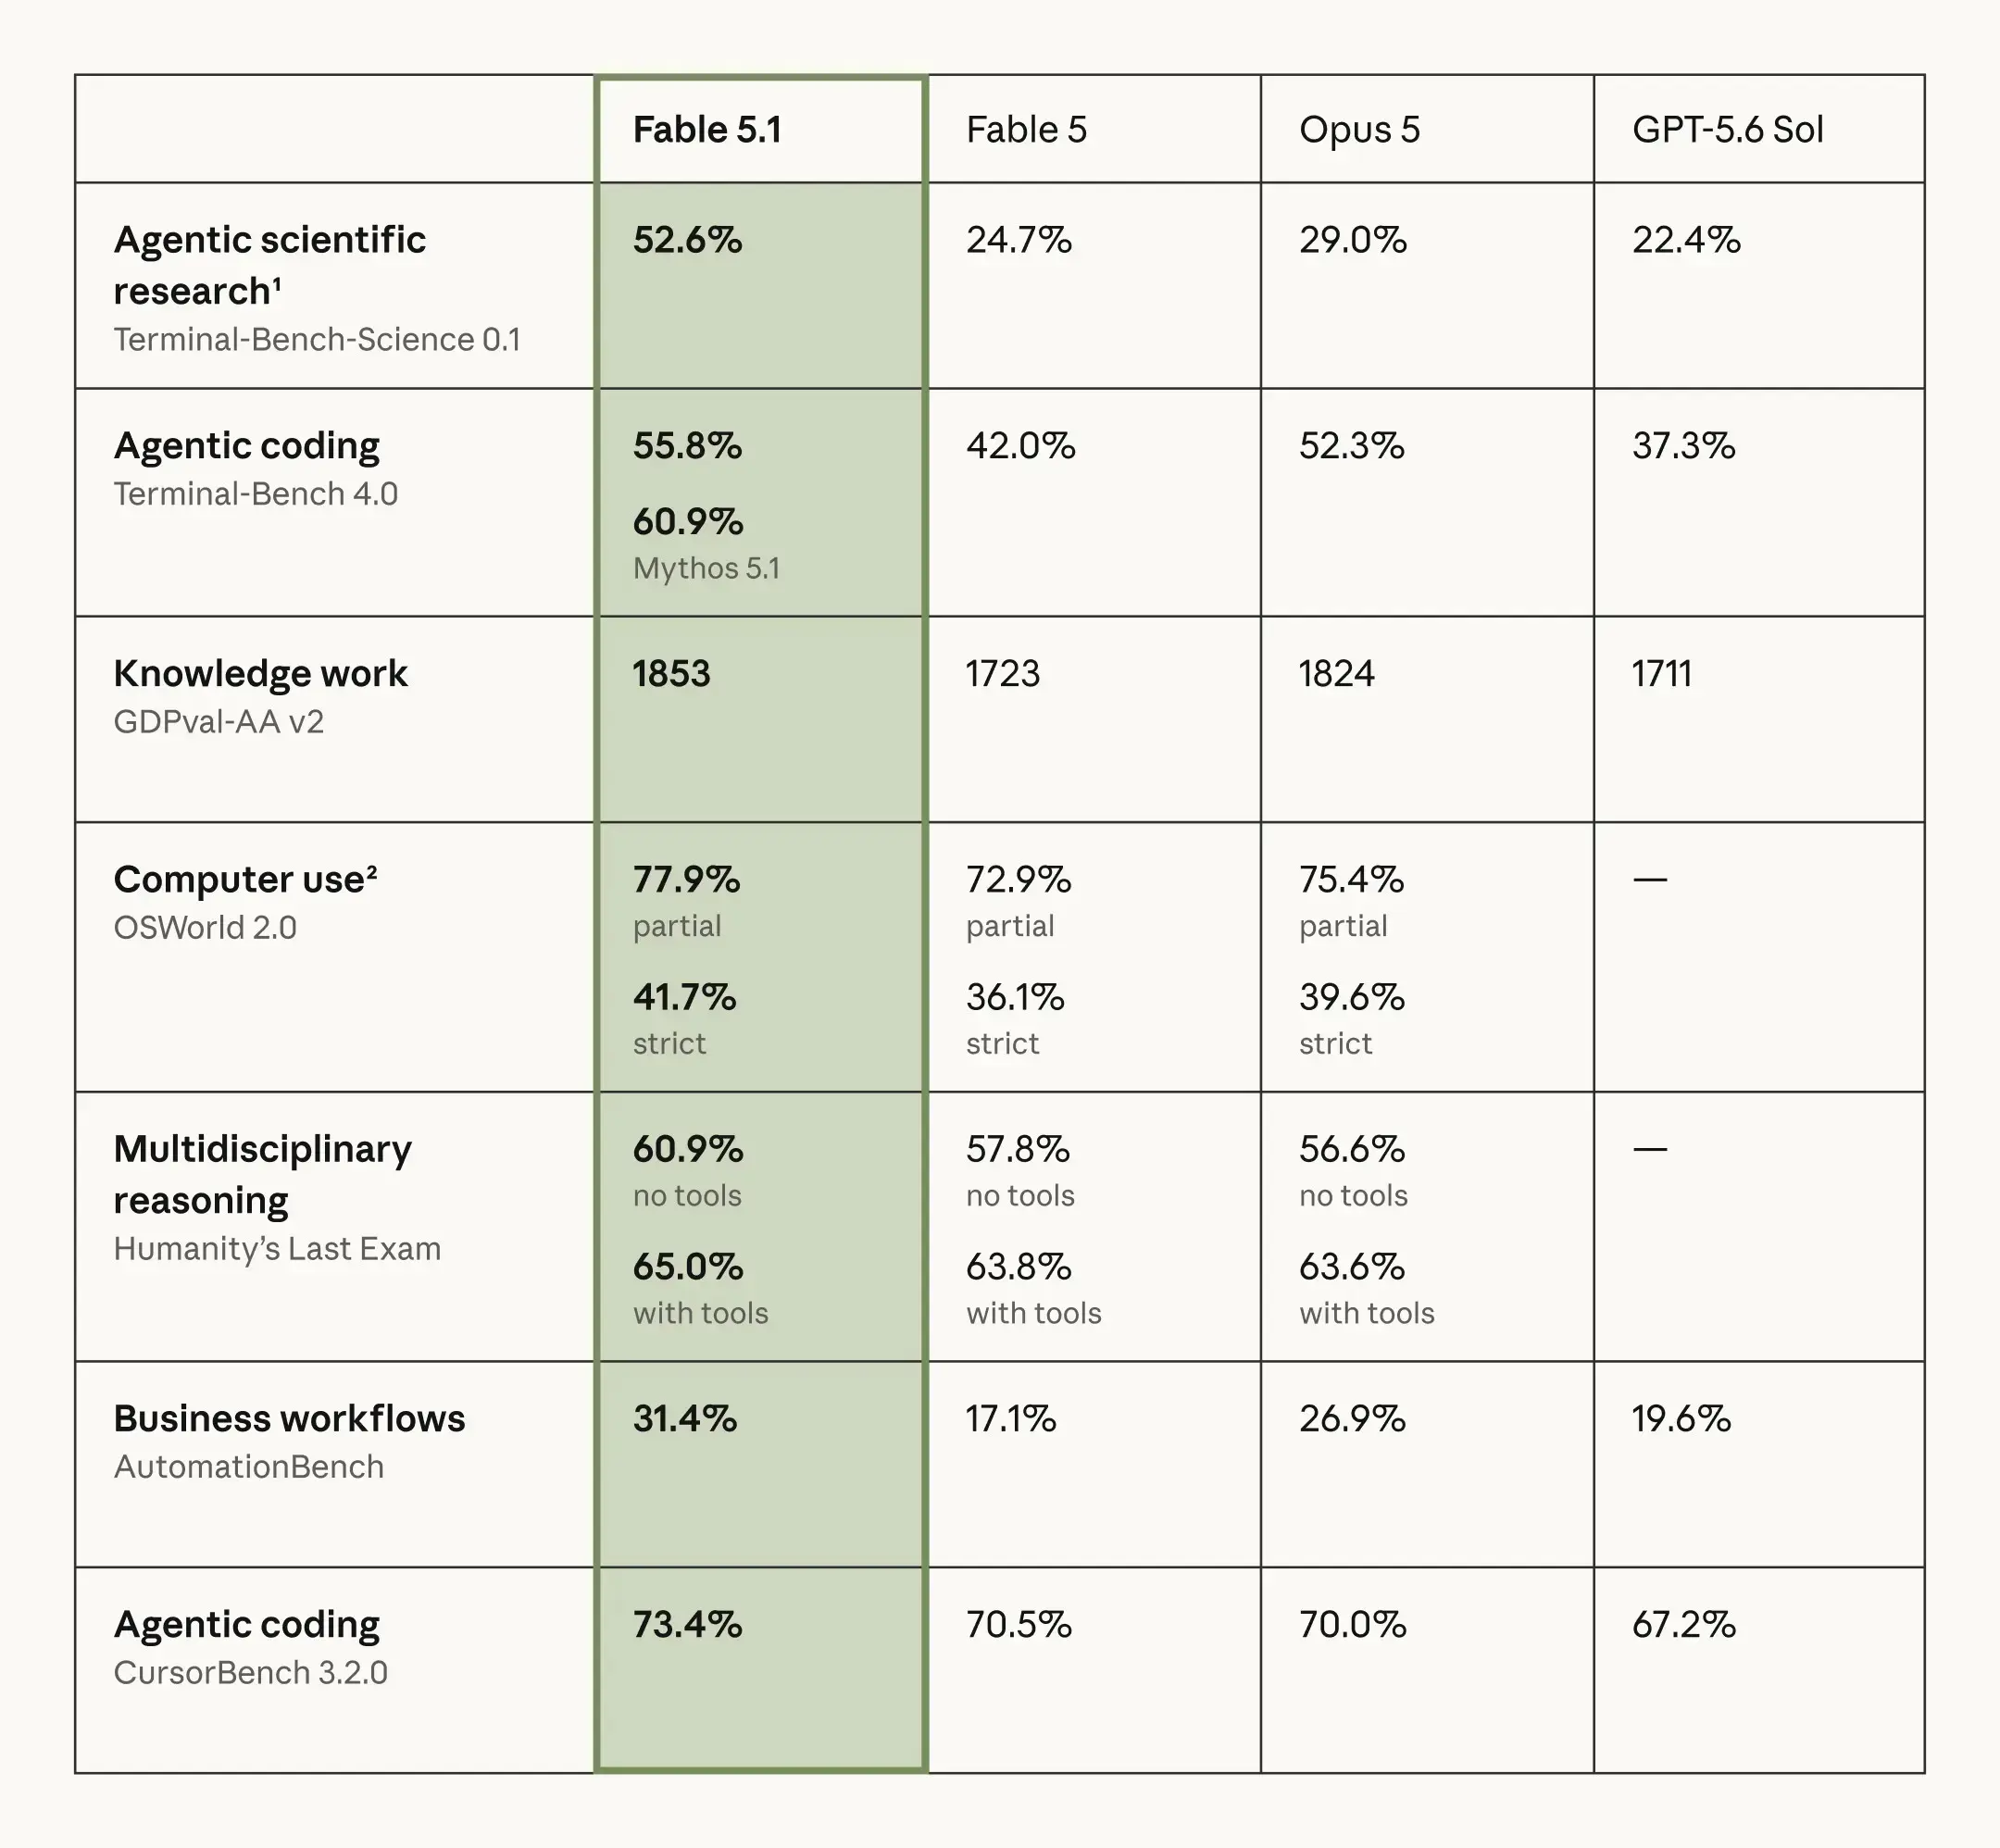
Anthropics offisielle benchmark-tabell sammenligner den nye modellen med forgjengeren, Claude Opus 5, og GPT-5.6 Sol. De utvalgte radene nedenfor dekker forskning, koding, kunnskapsarbeid, datamaskinbruk og automatisering.
| Offisiell benchmark | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 52.3% | 37.3% |
| GDPval-AA v2 | 1853 | 1723 | 1824 | 1711 |
| OSWorld 2.0 partial | 77.9% | 72.9% | 75.4% | — |
| OSWorld 2.0 strict | 41.7% | 36.1% | 39.6% | — |
| AutomationBench | 31.4% | 17.1% | 26.9% | 19.6% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 70.0% | 67.2% |
Grafikken over er den offisielle Anthropic benchmark-bildekopien fra kildedokumentet, ikke et lokalt omtegnet diagram. Anthropic bemerker en ±3.5–4.5 poeng standardfeil for Terminal-Bench-Science og sier at produksjonssikkerhetstiltak var aktivert under evalueringen. Små forskjeller bør derfor behandles med forsiktighet.
Kilde:Offisiell Anthropic Fable 5.1 benchmark-grafikk
Slik leser du benchmark-resultatene
Disse scoreene bør ikke tolkes som universelle mål på modellkvalitet. Anthropic evaluerte Claude Fable 5.1 med produksjonssikkerhetstiltak aktivert, og noen benchmark-oppgaver kan påvirkes av slike inngrep. Terminal-Bench-Science rapporterer også en standardfeil på omtrent ±3.5–4.5 prosentpoeng per modell.
OSWorld 2.0-resultatene bruker benchmark-forfatternes oppgaveutgivelse fra august 2026, så de bør ikke sammenlignes direkte med score fra tidligere oppgaveutgivelser.
Prising for Claude Fable 5.1
Inndata- og utdata-priser
Anthropic lister Claude Fable 5.1 til $10 per MTok inndata og $50 per MTok utdata. Claude Fable 5.1 API i CometAPI er $8 per MTok inndata og $40 per MTok utdata, en reduksjon på 20% fra de offisielle listeratene. Dette er forbruksbaserte satser; sjekk den levende modellsiden før produksjon fordi plattformpriser og faktureringsregler kan endres.
Prising for prompt-cache
Anthropic priser en 5-minutters cache-skriving til $12.50 per MTok, en 1-times cache-skriving til $20 per MTok, og en cache-lesing til $0.25 per MTok. Lesesatsen er 75% under Fable 5s $1 per MTok, så langtidskjørende agenter som gjenbruker repositories, policyer, verktøydefinisjoner eller tidligere tilstand, drar mer nytte enn korte engangs-prompt.
Eksempel på kostnad for agentarbeidsflyt
En agent som leser 150K cachede tokens på hver av 1,000 steg, forbruker 150 MTok med cache-lesinger. Med Fable 5.1s $0.25-sats koster den komponenten $37.50; med Fable 5s $1-sats ville den kostet $150 — en besparelse på $112.50. Ferske inndata, utdata, cache-skrivinger og plattformkostnader kommer i tillegg, så team bør sammenligne totalkostnad per vellykket arbeidsflyt snarere enn cache-kostnad alene.
Hvorfor cache-prising endrer økonomien for agenter
En konvensjonell forespørsel kan bruke mesteparten av regningen på ferske inndata og utdata. En agent er annerledes: hvert verktøysteg kan lese på nytt et stort cachet prefiks som inneholder policy, kode, dokumenter, verktøydefinisjoner og tidligere tilstand. Anthropics 75% reduksjon i cache-lesing gagner uforholdsmessig mye lange løkker.
For eksempel: en agent som leser 150K cachede tokens på nytt over 1,000 steg forbruker 150 millioner cache-lesetokens. Til $1 per MTok koster den komponenten $150; til $0.25 per MTok koster den $37.50. Dette eksemplet ekskluderer ferske inndata, utdata, cache-skrivinger og plattformkostnader, men det viser hvorfor uendrede basispriser likevel kan gi lavere kostnad per fullført oppgave.
Anthropic anslår omtrent 25% lavere kostnad for typiske token-fakturerte arbeidslaster og opptil omtrent 45% for sterkt agentiske arbeidslaster. Dette er anslag basert på arbeidslastmiks, ikke en universell rabatt på hver token.
Claude Fable 5.1 vs Opus 5 vs Sonnet 5
Frontermodellen er kapabilitetstaket, men Anthropic anbefaler Opus-nivået som utgangspunkt for de fleste arbeidslaster. Sonnet-nivået er fortsatt det raskere, rimeligere valget når gjennomstrømning og latens betyr mer enn maksimal pålitelighet over lang horisont. For en dypere tomodellanalyse, se CometAPIs Fable vs Sonnet-sammenligning.
| Dimensjon | Claude Fable 5.1 | Claude Opus 5 | Claude Sonnet 5 |
|---|---|---|---|
| Kontekstvindu | 1M | 1M | 1M |
| Maksimal utdata | 128K | 128K | 128K |
| Inndata-/utdata-listepris | $10 / $50 | $5 / $25 | $2 / $10 |
| Sammenlignende latens | Tregere | Moderat | Rask |
| Best egnet | De tøffeste agentene og resonnering med lang horisont | Standard premium utgangspunkt | Høyvolumsarbeid som prioriterer hastighet og kostnad |
Valgresultat: Start med det rimeligere nivået som møter oppgaven. Eskaler først når produksjonsevalueringer viser at frontermodellen øker akseptert-resultat-rate, reduserer omkjøringer eller senker totalkostnad per vellykket arbeidsflyt.
Migreringsendringer utviklere må teste
Den nye modellen er stort sett en drop-in-etterfølger, men Anthropic dokumenterer tre breaking changes som påvirker agentrammeverk og lange samtaler.
| Migreringsendring | Hva skjer | Påkrevd utviklerhandling |
|---|---|---|
| Tvunget verktøyvalg | tool_choice = any eller et navngitt verktøy returnerer HTTP 400 | Bruk auto, instruer modellen, og håndhev strenge skjemaer ved behov |
| Tenkeblokker ved modellbytter | Eldre modeller kan ikke lese de nye tenkeblokkene | Test rutere og forvent at resonnementblokker droppes ved tilbakeruting |
| Redigering av tidligere meldinger | Endret historikk kan gjøre tenkeblokker ugyldige | Hold historikken append-only eller bruk støttede komprimeringsmønstre |
Test også innsats per melding, tur-avgrensede systemmeldinger, fremdriftsoppdateringer mellom verktøykall, cache-oppførsel og innholdsopphav før du flytter produksjonstrafikk. Den eksisterende Fable API-veiledningen er fortsatt det beste stedet for generisk SDK-oppsett og forespørseleksempler.
Hvem bør bruke Claude Fable 5.1?
Claude Fable 5.1 er best for arbeidslaster der vedvarende resonnement og vellykket fullføring betyr mer enn minimalt med latens eller tokenpris. Velg den når oppgaven spenner over mange steg, bruker verktøy gjentatte ganger, eller har høy nok forretningsverdi til at færre feilkjøringer og mindre omarbeid kan oppveie premium modellkostnader.
- Repository-skala engineering: feilsøking, migreringer, refaktorisering på flere filer, testkjøring og ubemannede kodeagenter.
- Flertrinns forskning: søk, evaluering av bevis, kjøring av analyser og produksjon av en forankret sluttrapport.
- Store dokumenter og profesjonelt arbeid: kontrakter, teknisk dokumentasjon, finansmateriale, regneark og presentasjonsarbeidsflyter.
- Datamaskinbruk og automatisering: oppgaver som krever gjentatte verktøykall, grensesnittnavigasjon, verifisering og gjenoppretting fra mellomliggende feil.
For rutinemessig klassifisering, utvinning i høyt volum eller latenssensitiv chat, start med Claude Opus 5 eller Claude Sonnet 5
Tilgjengelighet via CometAPI
Per 4. september 2026 viser CometAPI-modellsiden Claude Fable 5.1 som live og operativ. Modell-ID-en er claude-fable-5-1.
- Opprett eller logg inn på en CometAPI-konto og generer en API-nøkkel i dashbordet.
- Velg Claude Fable 5.1 og oppgi
claude-fable-5-1som modell-ID. - Send forespørsler via den Anthropic-kompatible
/v1/messages-endepunktet eller det OpenAI-kompatible/v1/chat/completions-endepunktet. - Kjør en produksjonsnær evaluering for å bekrefte latens, konteksthåndtering, verktøyoppførsel og fakturering før du migrerer trafikk.
Utviklere kan også få tilgang til modellen direkte via Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry og Claude Platform on AWS.
Konklusjon
Claude Fable 5.1 forstås best som en gjennomføringsoppgradering. Det mest overbevisende beviset er ikke det uendrede 1M-kontekstvinduet eller premium $10/$50-basisprisen; det er den store forbedringen på agentisk forskning, terminalkoding og automatisering, kombinert med vesentlig billigere cache-lesinger.
Bruk den når en oppgave er vanskelig, langvarig og verdifull nok til at færre mislykkede kjøringer kan rettferdiggjøre premium prising. For rutinemessig, høyt volum eller latenssensitivt arbeid, begynn med et rimeligere nivå og eskaler først når din egen evaluering viser en målbar forbedring i fullførte resultater.
Vanlige spørsmål
Er Claude Fable 5.1 tilgjengelig via et API?
Ja. Anthropic lister Claude Fable 5.1 som aktiv siden 1. september 2026. Den er tilgjengelig via Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry og Claude Platform on AWS.
Hvor mye koster Claude Fable 5.1 API?
Anthropics offisielle listepris er $10 per MTok inndata og $50 per MTok utdata. CometAPI lister for øyeblikket $8 inndata og $40 utdata per MTok. Sjekk gjeldende rutepris før utrulling.
Hvor stort er kontekstvinduet til Claude Fable 5.1?
Modellen støtter et 1M-token kontekstvindu og opptil 128K utdata-tokens. Stor kapasitet fjerner ikke behovet for å teste gjenfinning, latens og kostnad med produksjonsdokumenter.
Hva er endret fra Claude Fable 5 til 5.1?
De største praktiske endringene er sterkere agentisk forskning og terminalgjennomføring, en reduksjon i cache-lesepris fra $1 til $0.25 per MTok, innsatskontroll per melding, fremdriftsoppdateringer og innholdsopphav. Migrering krever også testing av tvunget verktøyvalg, tenkeblokker ved modellbytter og redigerte samtalehistorikker.
Er Claude Fable 5.1 bedre enn Claude Opus 5?
Ikke for hver arbeidslast. Fable 5.1 er alternativet med høyere kapabilitet for krevende arbeid med lang horisont, men den er tregere og dyrere. Anthropic anbefaler å starte de fleste arbeidslaster med Claude Opus 5 og gå opp når evalueringer med høyere innsats fortsatt ikke strekker til.
Kan jeg bruke Claude Fable 5.1 via CometAPI?
Ja. CometAPI lister for øyeblikket Claude Fable 5.1 som live under modell-ID claude-fable-5-1, med Anthropic-kompatible og OpenAI-kompatible endepunkter.
Støtter Claude Fable 5.1 tvungen verktøybruk?
Nei. Anthropic dokumenterer at tool_choice satt til any eller et navngitt verktøy returnerer HTTP 400. Bruk auto eller none, og styr verktøyvalg med instruksjoner og strenge inndataskjemaer når nødvendig.