AI Comparisons
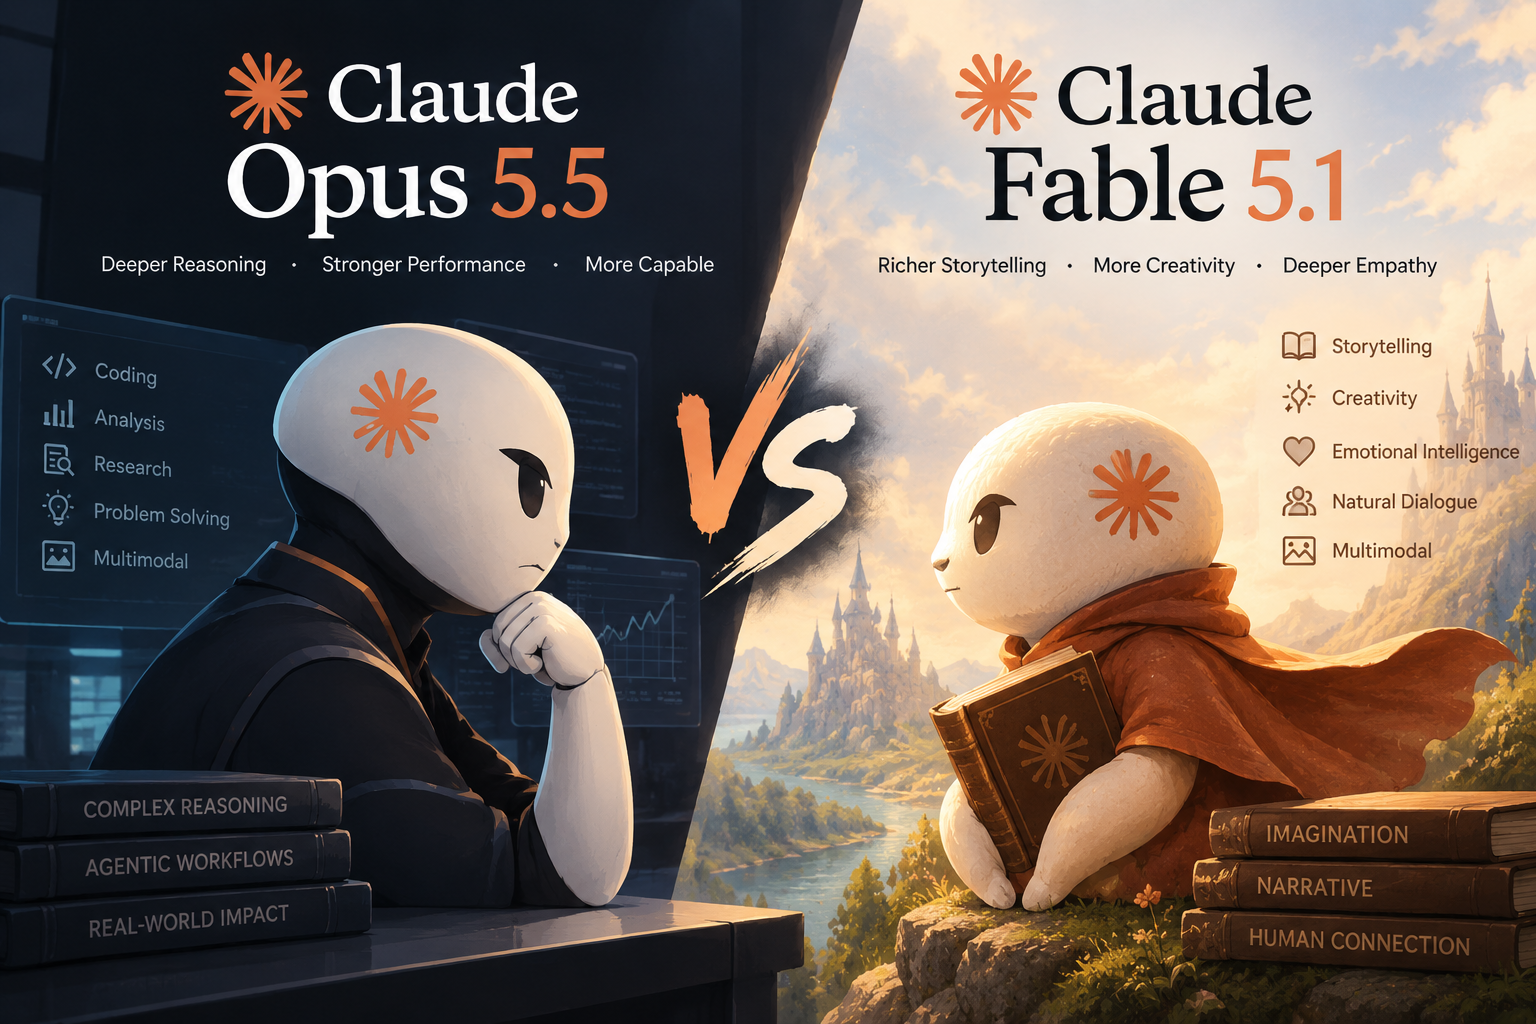
Claude Opus 5.5 vs Claude Fable 5.1: Benchmarki, koszt i przewodnik wyboru
Nie mam publicznie potwierdzonych danych o modelach o nazwach Claude Opus 5.5 i Claude Fable 5.1. Jeśli to warianty wewnętrzne lub robocze, poniższe porównanie podaje metodykę i kryteria oceny oraz typowe różnice między modelem klasy premium a lżejszym modelem ekonomicznym. Wstaw swoje rzeczywiste liczby z pomiarów i cenników.
Zakres porównania i zalecana metodyka
- Benchmarki kodowania
- Co mierzyć: HumanEval, MBPP, Codeforces Gym (syntetyczne), SWE-bench lite/verified, Repo-level (np. zmiany wieloplikowe), pass@k i stopę kompilacji/egzekucji.
- Procedura: 3–5 powtórzeń per zadanie; temperatury 0.0 i 0.2; top_p 0.9; ten sam kontekst, te same narzędzia (jeśli tool-use).
- Wynik oczekiwany w układzie premium vs lekki: model premium zwykle ma wyższe pass@1/ pass@k i mniej retry; model lekki więcej prób i większą wariantywność.
- Cennik API
- Ujednolicenie: porównuj koszt za 1M tokenów wejścia (prompt) i wyjścia (completion); uwzględnij ewentualne dopłaty za tryb “reasoning/effort”.
- Wzór: koszt = (tok_wejścia_efektywne × stawka_in) + (tok_wyjścia × stawka_out).
- Uwaga: jeżeli jest caching, tok_wejścia_efektywne to tok_wejścia minus trafienia cache (patrz sekcja caching).
- Szybkość
- Mierz: czas do pierwszego tokena, szybkość generacji (tok/s), latency p95, stabilność pod obciążeniem.
- Oczekiwany wzorzec: model lekki zwykle niższa latencja i wyższe tok/s; model premium wolniejszy, zwłaszcza w trybach zwiększonego rozumowania.
- Caching
- Sprawdź: czy dostępny jest prompt caching i na jakich zasadach (np. cache_control dla system/prompt), jaki jest próg minimalnego rozmiaru, TTL oraz kiedy hash zmiany kasuje cache.
- Praktyka: wydziel stałą część system/prompt (policy, styleguide, API spec) do segmentu cache’owalnego; porównuj trafienia cache i oszczędność kosztu/latencji dla obu modeli.
- Ustawienia “effort” (jeśli dostępne)
- Znaczenie: poziom wysiłku/rozumowania (np. low/medium/high) zwykle skaluje głębokość planowania, koszt i czas.
- Zalecenia:
- low do zadań prostych, odpowiedzi faktograficznych, krótkich transformacji.
- medium do zadań kodowych średniej złożoności, refaktoryzacji, testów jednostkowych.
- high tylko dla trudnych zadań wieloetapowych (algorytmika, planowanie, repo-level).
- Mierz wpływ effort na pass@1, liczbę retry i koszt/latencję.
- Koszt ukończenia zadania (E2E)
- Definicja: koszt na “done” = średni koszt per próbę × średnia liczba prób do zaliczenia × (1 − współczynnik reuse cache).
- Zbieraj:
- średnie tok_wejścia/wyjścia per próba,
- odsetek reuse cache,
- retry rate (ile iteracji/łaccznie z testami i poprawkami),
- czas do “green CI”.
- Porównuj modele na identycznym pipeline (w tym testy i automatyczne walidatory).
- Dopasowanie do obciążeń (workload fit)
- Scenariusze sprzyjające modelowi premium:
- złożone zadania repo-level, integracje wieloplikowe, generowanie/naprawa testów, ścisłe ograniczenia jakości (compliance, bezpieczeństwo),
- mniejsza tolerancja na retry, droższe błędy.
- Scenariusze sprzyjające modelowi lekkiego kosztu:
- wysoka przepustowość, niska latencja, prostsze transformacje kodu, templating, generowanie boilerplate,
- interaktywne IDE-owe “autocomplete”-like, gdzie liczy się responsywność i koszt per tok.
- Mix: routing dwumodelowy (lekki default, premium na eskalacje wg heurystyk: długa trasa tokenów, niska pewność, porażka testów).
Porównanie punkt po punkcie (ramka decyzyjna)
- Benchmarki kodowania
- Opus 5.5: oczekuj wyższych pass@1/MBPP/SWE-bench; mniej retry; lepsza spójność na repo-level.
- Fable 5.1: dobre w prostych/średnich zadaniach; częściej wymaga retry lub prowadzenia krokowego.
- Cennik API
- Opus 5.5: wyższe stawki in/out; potencjalne dopłaty za tryb rozumowania/effort.
- Fable 5.1: niższe stawki; mniejszy koszt na tok; brak lub niższy narzut reasoning.
- Wniosek: porównuj koszt “per-pass” i “per-done”, nie tylko stawki nominalne.
- Szybkość
- Opus 5.5: większa latencja, zwłaszcza przy wysokim effort; stabilny tok/s.
- Fable 5.1: krótszy czas do pierwszego tokena i wyższe tok/s; lepsze dla interakcji w czasie rzeczywistym.
- Caching
- Opus 5.5: największe zyski z cache przy dużych, stałych promptach (specyfikacje, konteksty długie).
- Fable 5.1: caching nadal opłacalny, ale względny zysk mniejszy przy krótszych promptach.
- Praktyka: standaryzuj system prompt i fragmenty reuse, aby maksymalizować trafienia.
- Effort
- Opus 5.5: skaluje jakość z effort; ustaw default na medium, high tylko dla trudnych przypadków.
- Fable 5.1: efekt effort może być mniejszy; utrzymuj low/medium dla kosztu i szybkości.
- Koszt ukończenia
- Opus 5.5: wyższy koszt na próbę, ale niższa liczba prób; bywa tańszy “per-done” przy trudnych zadaniach.
- Fable 5.1: niższy koszt na próbę, ale więcej iteracji; tańszy “per-done” przy prostych zadaniach.
- Dopasowanie do obciążeń
- Opus 5.5: backend batchy jakościowych, automatyczne naprawy z testami, krytyczne ścieżki.
- Fable 5.1: wysokoprzepustowe asysty kodowe, generacja szablonów, szybkie prototypy, czat deweloperski.
Jak przeprowadzić pilota i podjąć decyzję
- Zbuduj zestaw 30–50 zadań kodowych podzielonych na proste/średnie/złożone; przypisz metryki sukcesu (pass@1, retry, czas do zielonego CI, koszt).
- Uruchom A/B z wymuszonymi parametrami: temperature, top_p, effort; 3–5 nasion; identyczny kontekst i narzędzia.
- Włącz caching dla stałych promptów; raportuj trafienia cache i oszczędności.
- Policz koszt per-pass i per-done; zrób analizę wrażliwości na effort i retry.
- Zastosuj routing: domyślnie Fable 5.1, eskalacja do Opus 5.5 wg reguł (np. porażka testów, niski confidence, długi plan).
- Po tygodniu wybierz:
- single-model: jeśli 80% zadań to prostsze przypadki i Fable 5.1 ma niższy koszt per-done,
- dual-model: jeśli rozkład trudności jest mieszany i eskalacje znacząco obniżają retry i czas,
- premium-only: jeśli wymagana jest najwyższa jakość na pierwsze podejście lub ryzyko błędów jest kosztowne.
Checklist wdrożeniowy
- Standaryzuj system prompt i kontekst pod caching.
- Ogranicz długość promptu; używaj retrievala tylko dla niezbędnych fragmentów.
- Ustal domyślne effort per workload; loguj i monitoruj koszty/latencje p95.
- Dodaj walidację syntaktyczną i testy przed oceną modelu; minimalizuj retry manualne.
- Mierz i raportuj per-model: pass@1, retry rate, koszt per-done, latencje, odsetek cache hits.
Podmień w powyższym szkielecie rzeczywiste ceny, wskaźniki i wyniki z Twojego środowiska, aby uzyskać precyzyjne porównanie Opus 5.5 vs Fable 5.1.