
TL;DR
DeepSeek V4.1 Flash zastępuje wcześniejszą generację V4 Flash modelem MoE typu kauzalny enkoder–dekoder o 552 mld parametrów, z natywnym rozumieniem obrazów, oknem kontekstu 1M tokenów oraz znacząco niższym kosztem serwowania. W oficjalnym porównaniu DeepSeek poprawia większość benchmarków dotyczących kodowania, terminala, bezpieczeństwa i agentów względem V4 Pro 0813, podczas gdy V4 Pro pozostaje z przodu w GPQA Diamond i HLE bez narzędzi.
Bieżąca strona cennika API DeepSeek ponownie wymienia deepseek-flash i deepseek-v4-pro jako oddzielne trasy, serwujące odpowiednio V4.1 Flash i V4-Pro-0813. Różnią się cenami, limitami współbieżności i obsługą wizji. Nowe integracje powinny więc wybierać identyfikator modelu zgodny z zamierzonym obciążeniem, zamiast polegać na historycznym zachowaniu aliasów.
Najważniejsze wnioski
- V4.1 Flash i V4 Pro to obecnie odrębne oficjalne opcje API: używaj deepseek-flash dla V4.1 Flash oraz deepseek-v4-pro dla V4-Pro-0813.
- Największe porównywalne zyski widać w zadaniach terminalowych, agentach do kodowania, automatyzacji i wykonaniu zorientowanym na bezpieczeństwo — nie we wszystkich benchmarkach rozumowania typu closed-book.
- V4.1 Flash jest materialnie tańszy niż aktualnie wymieniona trasa V4 Pro w zakresie wejść z trafieniem w cache, wejść bez trafienia w cache oraz tokenów wyjściowych.
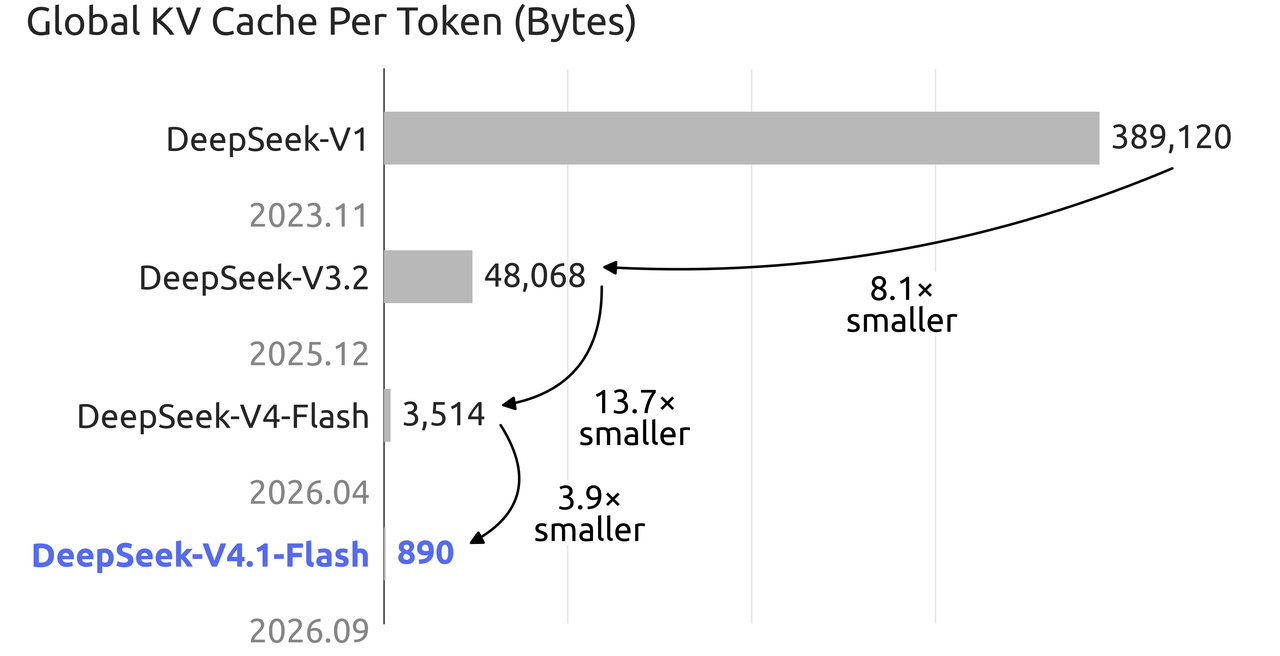
- V4.1 Flash dodaje natywną wizję, podnosi udokumentowaną współbieżność z 500 do 2 500 oraz redukuje globalną pamięć podręczną KV do 890 bajtów na token.
- Migracja powinna być jawna, nawet jeśli aliasy działają: zaktualizuj identyfikatory modeli, zweryfikuj zachowanie trybu thinking i non-thinking, przetestuj ponownie wywołania narzędzi i obrazy jako wejście oraz monitoruj zużycie tokenów i latencję.
Uwaga dotycząca routingu: oficjalna strona cennika identyfikuje deepseek-v4-pro jako V4-Pro-0813, odrębny od V4.1 Flash.
Jak porównują się specyfikacje DeepSeek V4.1 Flash i V4 Pro?
Architektura zmieniła się z bardzo dużego rzadkiego MoE w V4 Pro na asymetryczny kauzalny enkoder–dekoder w V4.1 Flash. Nowszy model aktywuje mniej parametrów podczas przetwarzania wejścia niż przy generowaniu wyjścia, co pomaga obniżyć koszt prefill przy zachowaniu silniejszej zdolności generacyjnej.
| Specyfikacja | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 |
|---|---|---|
| Architektura | Kauzalny enkoder–dekoder MoE | Rzadki MoE |
| Łączna liczba parametrów Parametry backbone / liczba wag w repozytorium | 552B parametrów backbone; Hugging Face podaje rozmiar modelu 763B | 1,6T parametrów backbone; Hugging Face podaje rozmiar modelu ok. 1,7T |
| Aktywne parametry | 8B dla wejścia; 16B dla wyjścia | 49B na token |
| Okno kontekstu | 1M tokenów | 1M tokenów |
| Maksymalny output | 384K tokenów | 384K tokenów |
| Tryby thinking i non-thinking | Obsługiwane | Obsługiwane |
| Natywne rozumienie obrazów | Obsługiwane | Nieobsługiwane |
| Udokumentowany limit współbieżności | 2 500 | 500 w bieżącej konfiguracji |
| Obecny oficjalny status w API | Aktywny jako deepseek-flash | Aktywny jako deepseek-v4-pro (V4-Pro-0813) |
Wyjaśnienie dotyczące liczby parametrów: karta modelu DeepSeek V4.1 Flash opisuje 552B parametrów „backbone”, podczas gdy repozytorium na Hugging Face raportuje rozmiar modelu 763B. Te wartości opisują różne zakresy rozliczania i nie powinny być przedstawiane jako zamienne sumy.
Wyjaśnienie dotyczące długości wyjścia: karta modelu V4.1 Flash zaleca max_tokens ≥ 256K dla inferencji lokalnej, podczas gdy bieżąca strona cennika API DeepSeek wyraźnie podaje maksymalny output 384K dla obu modeli API. Zalecane ustawienie inferencji nie jest tym samym, co narzucone przez API maksimum.
Gdzie DeepSeek V4.1 Flash poprawia wyniki względem V4 Pro?
Oficjalna tabela benchmarków DeepSeek pokazuje najjaśniejsze poprawy w obciążeniach silnie zależnych od wykonania. Kolumna procentowa poniżej jest obliczona z opublikowanych wyników; porównania procentowe pominięto tam, gdzie metryka to ocena lub gdzie prosty procent byłby mylący.
| Benchmark | V4.1 Flash | V4 Pro 0813 | Różnica | Interpretacja |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 90.6 | 87.9 | +2.7 punktów; +3,1% | Bardziej niezawodne wykonywanie w terminalu |
| Terminal-Bench 3.0 | 30.0 | 11.8 | +18.2 punktów; +154,2% | Duży zysk na trudniejszych zadaniach terminalowych |
| Terminal-Bench 4.0 | 31.2 | 12.4 | +18.8 punktów; +151,6% | Duży zysk na nowszych zadaniach terminalowych |
| DeepSWE v1.1 | 74.2 | 62.7 | +11.5 punktów; +18,3% | Silniejsza praca na poziomie repozytorium |
| ProgramBench | 20.3 | 15.5 | +4.8 punktów; +31,0% | Lepsza synteza programów |
| NL2Repo-Bench | 64.0 | 61.5 | +2.5 punktów; +4,1% | Lepsze przejście z języka naturalnego do repo |
| CyberGym | 88.1 | 83.3 | +4.8 punktów; +5,8% | Silniejsze wykonywanie zadań cyber |
| HLE with tools | 63.9 | 60.0 | +3.9 punktów; +6,5% | Lepsze rozumowanie wspierane narzędziami |
| Automation-Bench | 54.8 | 43.2 | +11.6 punktów; +26,9% | Istotny zysk w automatyzacji |
| Agents’ Last Exam | 31.8 | 25.7 | +6.1 punktów; +23,7% | Silniejsze ogólne zachowanie agentów |
| Codeforces rating | 3,471 | 3,348 | +123 punkty ratingu | Lepsze kodowanie konkurencyjne |
| GPQA Diamond | 90.9 | 92.4 | −1.5 punktów | Przewaga V4 Pro pozostaje |
| HLE without tools | 36.8; 39.1 na podzbiorze tekstowym | 42.7 na podzbiorze tekstowym | −3.6 punktów na porównywalnym podzbiorze tekstowym | Przewaga V4 Pro pozostaje |

Wynik jest wielowymiarowy: V4.1 Flash jest zdecydowanie lepszy dla agentów do kodowania, obsługi terminala, automatyzacji, zadań bezpieczeństwa, użycia narzędzi, wizji, współbieżności i kosztu. Pozostała przewaga V4 Pro koncentruje się w wybranych testach czystego rozumowania. Dlatego obciążenia należy oceniać według mieszanki zadań, a nie pojedynczej łącznej tezy.
Dlaczego DeepSeek V4.1 Flash jest bardziej wydajny niż V4 Pro?
Asymetryczne obliczenia dla wejścia i wyjścia
V4.1 Flash aktywuje 8B parametrów podczas przetwarzania wejścia i 16B podczas generowania wyjścia. Ta asymetryczna konstrukcja celuje w różne potrzeby obliczeniowe prefill i dekodowania, obniżając koszt bez wymuszania tego samego budżetu aktywnych parametrów na oba etapy.
Mniejszy ślad pamięci podręcznej KV
DeepSeek podaje, że V4.1 Flash wykorzystuje jedną czwartą HBM i jedną ósmą pojemności SSD wymaganej przez pamięć podręczną KV poprzedniej generacji. Opublikowany wykres umieszcza globalną pamięć podręczną KV na poziomie 890 bajtów na token, w porównaniu do 3,514 bajtów dla V4 Flash.
Natywne wejście multimodalne i wyższa współbieżność
V4.1 Flash potrafi natywnie interpretować obrazy i udostępnia udokumentowany limit współbieżności 2 500, pięciokrotnie wyższy od bieżącej wartości 500 w V4 Pro. Te zmiany mają znaczenie dla agentów pracujących na zrzutach ekranu, ekstrakcji dokumentów, rozwiązywania problemów wizualnych oraz kolejek produkcyjnych o dużej skali.
Ile kosztuje DeepSeek V4.1 Flash w porównaniu z V4 Pro?
Aktualny oficjalny cennik API wycenia obie trasy osobno. Za 1M tokenów V4.1 Flash kosztuje $0.003/$0.006 dla wejścia z trafieniem w cache, $0.15/$0.30 dla wejścia bez trafienia w cache oraz $0.60/$1.20 dla wyjścia (poza szczytem/szczyt). V4 Pro kosztuje odpowiednio $0.022/$0.044, $0.66/$1.32 oraz $1.98/$3.96. Ceny mogą się zmieniać, więc budżety produkcyjne powinny odnosić się do aktualnej strony z cennikiem.
Jak migrować z DeepSeek V4 Pro lub V4 Flash do V4.1 Flash?
Użyj jawnego produkcyjnego ID modelu
Używaj deepseek-flash, gdy chcesz V4.1 Flash. Starsze nazwy deepseek-v4-flash i deepseek-v4-flash-vision-exp nadal kierują do V4.1 Flash i są rozliczane według nowej ceny Flash, ale jawne nazwanie ułatwia monitoring i przyszłe rollbacki. Używaj deepseek-v4-pro, gdy celowo chcesz obecnie wystawiony backend V4-Pro-0813.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_API_KEY",
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",  # or "deepseek-v4-pro"
    messages=[{"role": "user", "content": "Review this migration plan."}],
)

print(response.choices[0].message.content)
Retestuj zachowanie, nie tylko zgodność endpointu
- Uruchom reprezentatywne prompty w trybach thinking i non-thinking; porównaj skuteczność zadań, liczbę tokenów i latencję.
- Przetestuj ponownie schematy narzędzi, wyjście JSON, zachowanie Responses API, uzupełnianie prefiksowe i FIM, jeśli są używane.
- Dodaj testy wejścia obrazów, jeśli produkt będzie korzystał z nowej natywnej możliwości wizualnej.
- Ustal budżety od nowa, używając stawek poza szczytem i w godzinach szczytu, zamiast przenosić założenia z V4 Pro.
- Śledź współczynnik trafień pamięci podręcznej promptów, ponieważ przy skali może on dominować koszt wejścia.
Wybierz docelowy backend wprost
Bieżąca trasa deepseek-v4-pro wybiera V4-Pro-0813. Zespoły powinny zapisywać rozstrzygniętą wersję modelu, datę ewaluacji, zestaw promptów i okno cenowe, aby porównania pozostały replikowalne, jeśli routing znów się zmieni.
Jakie obciążenia najlepiej pasują do DeepSeek V4.1 Flash?
| Obciążenie | Zalecany wybór | Powód |
|---|---|---|
| Agenci do kodowania i utrzymanie repozytorium | V4.1 Flash | Wyższe wyniki w DeepSWE, ProgramBench, NL2Repo i terminalu |
| Automatyzacja oparta na narzędziach | V4.1 Flash | Wyższe wyniki w Automation-Bench, HLE-with-tools i dla agentów |
| Asystenci rozumiejący obrazy | V4.1 Flash | Natywne rozumienie obrazów |
| Serwowanie o wysokiej przepustowości lub wrażliwe na koszty | V4.1 Flash | Wyższa współbieżność i znacznie niższe ceny tokenów |
| Historical V4 Pro reproductionCurrent V4 Pro access and evaluation | V4 Pro | Oficjalna trasa obecnie identyfikuje V4-Pro-0813 |
| Czyste rozumowanie typu closed-book | Zweryfikuj na danych domenowych | V4 Pro pozostaje wyżej w GPQA Diamond i HLE bez narzędzi |
FAQ: DeepSeek V4.1 Flash vs V4 Pro
Czy DeepSeek V4.1 Flash jest lepszy niż V4 Pro?
Dla większości wymiarów produkcyjnych — agenci do kodowania, zadania terminalowe, automatyzacja, użycie narzędzi, wizja, przepustowość i cena — tak. V4 Pro nadal ma wyższe opublikowane wyniki w GPQA Diamond i HLE bez narzędzi, więc obciążenia czysto rozumujące należy testować z promptami specyficznymi dla domeny.
Czy nadal mogę wywoływać deepseek-v4-pro?
Tak. Bieżąca oficjalna strona API wymienia deepseek-v4-pro jako V4-Pro-0813, z własnym cennikiem i limitem współbieżności.
Jakiego identyfikatora modelu powinna użyć nowa integracja?
Użyj deepseek-flash dla V4.1 Flash lub deepseek-v4-pro dla V4-Pro-0813. Nie traktuj tych dwóch identyfikatorów jako aliasów.
Czy stare identyfikatory modelu V4 Flash nadal działają?
DeepSeek podaje, że żądania deepseek-v4-flash i deepseek-v4-flash-vision-exp są automatycznie kierowane do V4.1 Flash i rozliczane według nowej ceny Flash. Nadal zaleca się aktualizację skonfigurowanego identyfikatora modelu dla przejrzystości.
Czy DeepSeek V4.1 Flash obsługuje obrazy?
Tak. Natywne rozumienie obrazów jest częścią V4.1 Flash; historyczne API V4 Pro nie zapewniało tej funkcjonalności.
Czy DeepSeek V4.1 Flash jest tańszy niż obecny V4 Pro?
Tak. Bieżący oficjalny cennik podaje niższe ceny dla wejścia z trafieniem w cache, wejścia bez trafienia w cache oraz wyjścia dla V4.1 Flash niż dla V4 Pro.
Czy powinienem oczekiwać identycznych wyników po migracji?
Nie. Zgodność endpointu nie gwarantuje identycznych ścieżek rozumowania, wyboru narzędzi, użycia tokenów ani formatowania. Uruchom ponownie ewaluacje produkcyjne, zanim oprzesz się na poprzednich progach.