
TL;DR
Z.AI publicznie nazwało GLM-6.0 i umieściło Full Self-Training w centrum mapy drogowej następnej generacji. Ujawniony kierunek łączy samogenerowane doświadczenie w pre-trainingu, mid-trainingu i post-trainingu z samooceną i korektą, przekształcając trening w sterowaną pętlę sprzężenia zwrotnego zamiast jednorazowego przejścia generowania danych.
Najtrudniejsza jest kontrola: GLM-6.0 musiałby oczyszczać dane syntetyczne, wykrywać i naprawiać błędy, zatrzymywać nieproduktywne iteracje oraz zapobiegać nagradzaniu skrótów przez własny ewaluator. Te mechanizmy rodzą praktyczne pytania o niezależną weryfikację, bezpieczeństwo, koszt i governance. Ponieważ nie opublikowano kompletnej karty modelu, zestawu benchmarków, specyfikacji API, ceny ani daty wydania, artykuł ocenia architekturę treningu i przedstawione dowody — nie spekulacyjne specyfikacje.
Najważniejsze wnioski dotyczące GLM 6.0?
- Najmocniejsze publiczne dowody dotyczą systemu Full Self-Training, a nie wycieku liczby parametrów czy wyników benchmarków.
- Ujawniony kierunek obejmuje dane wytwarzane przez model, samodzielnie konstruowane środowiska treningowe oraz optymalizację infrastruktury wspomaganą przez model.
- Zakładana pętla sprzężenia zwrotnego rozciąga się na pre-training, mid-training i post-training, zamiast traktować samotrening wyłącznie jako technikę potreningową.
- Natywne modelowanie multimodalne, długohoryzontowe RL, planowanie, wykorzystanie narzędzi, odzyskiwanie oraz weryfikacja to istotne kierunki badawcze, ale nie są to jeszcze opublikowane specyfikacje GLM 6.0.
- Ox Alpha nie stanowi dowodu wycieku wydajności GLM 6.0; Z.AI zidentyfikowało go jako przedpremierową tożsamość GLM-5.3-Flash.
Co Z.AI faktycznie potwierdziło o GLM 6.0?
Materiały publiczne Z.AI ustanawiają cztery konkretne sygnały: nazwę GLM-6.0, Full Self-Training jako centralny kierunek treningowy, zamierzoną pętlę obejmującą pre-training, mid-training i post-training oraz mechanizm samooceny i korekty. Firma stwierdza również, że około 60% wpływów netto ma wspierać modele następnej generacji, Full Self-Training, trening na dużą skalę, inferencję, zasoby obliczeniowe i powiązaną infrastrukturę.
Ramy Full Self-Training Z.AI
Full Self-Training jest przedstawiany jako idea organizująca GLM-6.0, a nie niewielka funkcja potreningowa. Zamierzony system generowałby doświadczenia treningowe, uczył się na podstawie wyników, filtrował słabe próbki i powtarzał cykl pod jawną kontrolą jakości.
GLM-6.0 i samotrening w pre-, mid- i post-trainingu
Ujawniona sekwencja — pre-training, mid-training i post-training — implikuje, że samogenerowane doświadczenie może wpływać na wiedzę bazową, kształtowanie zdolności i dopasowanie do zadań, a nie pojawiać się tylko podczas końcowego dostrajania. Z.AI nie ujawniło zestawów danych, granic etapów ani proporcji mieszania, więc należy traktować to jako potwierdzony kierunek, a nie kompletny przepis.
Mechanizm samooceny i korekty w GLM-6.0
Mapa drogowa łączy Full Self-Training z samooceną, wykrywaniem błędów, korektą i samopurifikacją danych. W praktyce model musiałby oceniać trajektorie, korygować nieudane kroki, odrzucać niewiarygodne dane oraz decydować, kiedy dalsza iteracja nie poprawia niezależnie mierzonej wydajności. Projekt ewaluatora i reguły zatrzymania pozostają nieujawnione.
The GLM-6.0 and Full Self-Training disclosure powinno być czytane łącznie z public proceeds allocation Z.AI.
Co wiemy, a czego nie
Publiczny rejestr wspiera mapę drogową, ale nie gotową specyfikację. Poniższa tabela rozdziela potwierdzony kierunek od otwartych pytań, aby artykuł nie zamieniał ujawnionych zamiarów w niepoparte twierdzenia o produkcie.
| Twierdzenie | Status dowodów | Co jest potwierdzone | Co pozostaje nieznane |
|---|---|---|---|
| Nazwa GLM-6.0 | Publicznie wskazana | Z.AI nazwało model następnej generacji GLM-6.0. | Data wydania i końcowe pozycjonowanie. |
| Full Self-Training | Potwierdzona mapa | To deklarowany priorytet strategiczny. | Szczegóły implementacji i zachowanie skalowania. |
| Pre-training → Mid-training → Post-training | Potwierdzony kierunek | Samotrening ma obejmować cały cykl treningowy. | Zestawy danych, walidatory, granice etapów i proporcje danych. |
| Samoocena i korekta | Potwierdzony cel | Mapa obejmuje samopurifikację, wykrywanie błędów i korektę. | Niezawodność, niezależna weryfikacja i kryteria zatrzymania. |
| Specyfikacje | Nieujawnione | Brak kompletnej publicznej specyfikacji. | Parametry, okno kontekstu, modalności, cena i identyfikator API. |
| Benchmarki | Nieujawnione | Brak oficjalnego zestawu wyników GLM-6.0. | Oceny, metodologia i niezależnie replikowalne wyniki. |
Czym jest Full Self-Training i jak działa
Full Self-Training to zamknięta pętla uczenia, w której model pomaga tworzyć zadania lub środowiska, podejmuje próby ich rozwiązania, ocenia powstałe trajektorie, koryguje słabe kroki i zasila zaakceptowane doświadczenia z powrotem do treningu. Istotna zmiana polega na przejściu od jednorazowego potoku danych syntetycznych do procesu ciągłego pod kontrolą.
- Generate: konstruuj problemy, środowiska narzędziowe i kandydackie ścieżki rozwiązań.
- Act: wykonuj zadania i zachowuj działania, obserwacje oraz pośrednie rozumowanie jako trajektorie.
- Evaluate and correct: oceniaj wyniki za pomocą weryfikatorów, wykrywaj błędy, poprawiaj nieudane kroki i odrzucaj próbki o niskiej pewności.
- Train and stop: ucz się na zaakceptowanym doświadczeniu, a następnie kontynuuj tylko tak długo, jak niezależne ewaluacje pokazują użyteczną poprawę.
Rozciągnięcie tej pętli na pre-training, mid-training i post-training pozwoliłoby GLM-6.0 poprawiać jakość danych, kształtowanie kompetencji i dopasowanie do zadań na różnych etapach. Architektura wciąż zależy od wiarygodnych ewaluatorów: bez niezależnych kontroli samotrening może nagradzać własne ślepe punkty.
Jak Full Self-Training może zmienić GLM 6.0?
Ujawniony projekt lepiej rozumieć jako architekturę systemu niż pojedynczy nowy blok Transformera. Próbuje domknąć pętlę wokół modelu tak, aby model coraz bardziej pomagał generować zasoby potrzebne do kolejnego cyklu treningowego.
Jak GLM 6.0 mógłby wytwarzać dane treningowe?
Pierwsza pętla to samoprodukcja danych. Zamiast polegać wyłącznie na datasetach pisanych przez ludzi lub zbieranych zewnętrznie, modele mogą używać self-play, regułowych kontroli, wyników egzekucji, ocen modelu i wyrywkowych kontroli ludzkich do generowania i filtrowania nowych przykładów. Zaakceptowane przykłady trafiają następnie do pre-trainingu, mid-trainingu i post-trainingu.
Kluczowym ograniczeniem pozostaje weryfikacja: tania generacja syntetyczna jest użyteczna tylko wtedy, gdy system potrafi zidentyfikować poprawne, zróżnicowane i nieniedegrujące przykłady. Praktyczna pętla to generacja przez model → wykonanie zadania → weryfikacja regułami lub narzędziami → filtrowanie → ponowny trening.
Jak GLM 6.0 mógłby konstruować środowiska treningowe?
Druga pętla to samokonstrukcja środowisk. Agenci mogą zbierać lub transformować zadania ze świata rzeczywistego, podejmować próby ich wykonania, tworzyć weryfikatory i sprawdzać, czy zadanie jest faktycznie rozwiązywalne, zanim stanie się materiałem treningowym. Ma to szczególne znaczenie w kodowaniu i pracy agentów, gdzie stan terminalny, wynik narzędzia, stan przeglądarki, wyniki testów i odzyskiwanie po błędach dostarczają silniejszego nadzoru niż same odpowiedzi tekstowe.
Cel ewaluacji przesuwa się z tego, czy odpowiedź brzmi wiarygodnie, na to, czy działanie się powiodło, wynik jest niezależnie weryfikowalny i czy agent potrafi się podnieść po błędzie.
Jak GLM 6.0 mógłby optymalizować swoją infrastrukturę treningową?
Trzecia pętla to samooptymalizacja infrastruktury. W praktyce najlepiej interpretować to jako inżynierię systemów wspomaganą przez AI: silny model kodujący proponuje zmiany w operatorach, jądrach, harmonogramowaniu, cache’owaniu lub kodzie serwującym, podczas gdy zautomatyzowane benchmarki i walidacja kontrolowana przez ludzi decydują, które zmiany są akceptowane.
Powstaje cykl: lepszy model → lepsze propozycje systemowe → zweryfikowane zyski efektywności → więcej eksperymentów treningowych → lepszy model. Przegląd ludzki i replikowalne benchmarki pozostają punktami kontrolnymi, a nie opcjonalnymi dodatkami.
Co mówi obecna baza GLM 5.3 Flash o GLM 6.0?
Ponieważ GLM 6.0 nie ma publicznej karty modelu, najbardziej obronne porównanie oddziela obecne, zmierzone możliwości GLM od kierunku następnej generacji. Z.AI opisuje GLM-5.3-Flash jako model MoE o 320B łącznej liczbie parametrów i 18B aktywnych, trenowany na multimodalnym korpusie 30T tokenów. To specyfikacje GLM-5.3-Flash, a nie GLM 6.0.
| Wymiar porównania | GLM-5.3-Flash API w CometAPI | Ujawniony kierunek GLM 6.0 |
|---|---|---|
| Status wydania | Dostępny | W trakcie rozwoju; końcowa nazwa produktu niepotwierdzona niezależnie w cytowanym zgłoszeniu |
| Parametry | 320B łącznie / 18B aktywnych | Nieujawnione |
| Rdzenna architektura | MoE; hybrydowa uwaga rzadka + liniowa; mHC | Nieujawniona na poziomie bloków |
| Dane treningowe | Multimodalny korpus 30T tokenów | Samoprodukowane dane mają trafiać do pętli rekurencyjnej |
| Multimodalność | Natywne wejście multimodalne | Ujednolicone modelowanie multimodalne to kierunek badań, nie opublikowana specyfikacja |
| Etapy treningu | Opublikowana recepta etapowego treningu | Samotrening w pre-, mid- i post-trainingu |
| Środowiska treningowe | Środowiska projektowane i benchmarkowane przez badaczy | Agenci pomagają konstruować i weryfikować środowiska |
| Weryfikacja | Istniejące potoki ewaluacji i treningu | Silniejszy samoosąd, sprzężenie z egzekucją i samoweryfikacja |
| Infrastruktura | Zoptymalizowany stos inferencji | Modele pomagają w optymalizacji infrastruktury |
| Szczegóły API | Opublikowany ID modelu i działające API | Nieujawnione |
Tekst wydania Z.AI raportuje około 3,0× niższe obliczenia uwagi i 4,4× mniejszy rozmiar KV-cache dla GLM-5.3-Flash niż dla GLM-5.3 API. Towarzysząca oficjalna grafika oznacza porównanie dla miliona tokenów jako 3,40× dla obliczeń uwagi i 3,80× dla bufora KV na warstwę. Ponieważ dwa oficjalne zasoby podają różne wartości, należy je raportować w ich odpowiednich kontekstach, a nie łączyć w jeden pomiar.
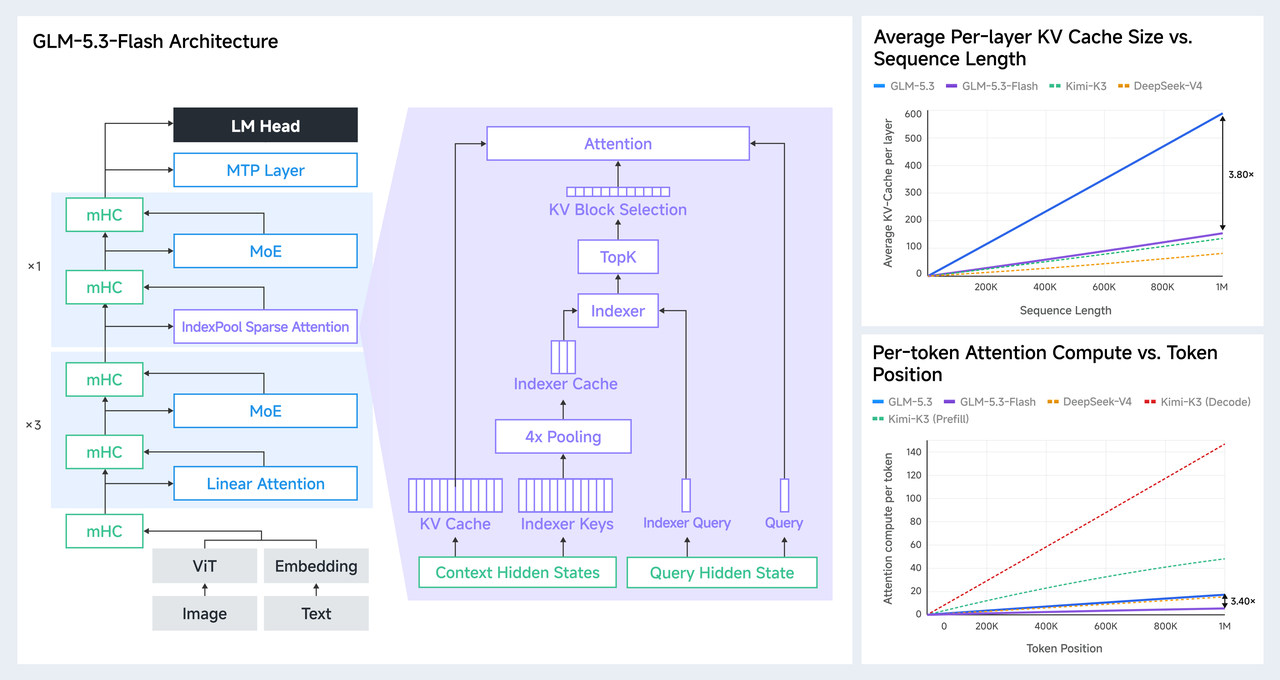
Oficjalna porównawcza architektura i efektywność GLM-5.3-Flash opublikowana przez Z.AI
Które wyniki benchmarków tworzą bazę GLM 6.0?
Nie ma publicznej, zweryfikowanej tabeli benchmarków GLM 6.0. Obecna generacja GLM służy jedynie jako punkt odniesienia, ponieważ poniższe ewaluacje mierzą planowanie, kodowanie, użycie narzędzi, automatyzację i długohoryzontową egzekucję — zdolności najbardziej relewantne dla ujawnionego kierunku Full Self-Training.
| Oficjalna ewaluacja Z.AI | GLM-5.3-Flash | GLM-5.2 | Zgłaszana różnica |
|---|---|---|---|
| Terminal Bench 2.1 | 84,3 | 81,0 | +3,3 |
| DeepSWE v1.1 | 63,4 | 46,2 | +17,2 |
| NL2Repo | 56,3 | 48,9 | +7,4 |
| Toolathlon Verified | 78,4 | 59,9 | +18,5 |
| AutomationBench v1.0.6 | 48,8 | 26,2 | +22,6 |
| Agents’ Last Exam | 26,3 | 20,4 | +5,9 |
| HLE with Tools | 55,3 | 54,7 | +0,6 |
| GDPval-AA v2 | 1773 Elo | 1504 Elo | +269 Elo |
Porównanie jest wielowymiarowe, a nie pojedynczym rankingiem. GLM-5.3-Flash wykazuje największe zgłaszane zyski na AutomationBench (+22,6), Toolathlon Verified (+18,5) i DeepSWE (+17,2), podczas gdy różnica w HLE-with-Tools wynosi tylko +0,6. Taki wzorzec sugeruje silniejsze zyski w zadaniach agentowych wymagających intensywnej egzekucji niż w każdej formie rozumowania wspomaganego narzędziami. Nie przewiduje to wyników GLM 6.0.
Dlaczego te benchmarki mają znaczenie
Benchmarki mają tu znaczenie tylko wtedy, gdy ujawniają zdolności, które Full Self-Training ma poprawić. Sześć kategorii w załączonej tabeli tworzy progresję od produkcji poprawnej pracy do utrzymania skutecznego zachowania w rzeczywistych środowiskach. Kodowanie sprawdza, czy model potrafi wykonać złożone zadanie; użycie narzędzi sprawdza, czy potrafi przełożyć działanie na sprzężenie zwrotne i wybrać kolejny krok; a automatyzacja sprawdza, czy potrafi utrzymać tę pętlę w długim przebiegu.
| Kategoria benchmarku | Dlaczego ma znaczenie dla GLM-6.0 |
|---|---|
| Kodowanie | Sprawdza wykonanie złożonych zadań |
| Użycie narzędzi | Sprawdza pętlę działanie → feedback |
| Automatyzacja | Sprawdza długohoryzontową egzekucję |
| HLE | Sprawdza rozwiązywanie złożonych problemów eksperckich |
| GDPval | Sprawdza jakość pracy profesjonalnej |
| Multimodalność | Sprawdza użycie informacji wizualnych |
HLE następnie podnosi trudność rozwiązywanych problemów, GDPval pyta, czy wynik jest użyteczny w pracy profesjonalnej, a ewaluacja multimodalna sprawdza, czy obserwacje wizualne mogą kierować kolejnymi działaniami. Czytane razem, te sześć kategorii przechodzi od izolowanej kompetencji do pełnej realizacji zadania: wygeneruj plan, działaj, obserwuj feedback, popraw błędy i kontynuuj aż do osiągnięcia celu.
Przyszły wynik GLM-6.0 będzie zatem znaczący nie dlatego, że podnosi agregacyjny wynik, ale dlatego, że zyski w tych wymiarach pokażą, iż samogenerowane doświadczenia treningowe przekładają się na niezawodną realizację zadań w świecie rzeczywistym. Ultimate celem Full Self-Training nie jest poprawa wyników testów, lecz poprawa zdolności modelu do wykonywania realnych zadań.
Dlaczego Full Self-Training może mieć znaczenie dla GLM 6.0?
Prawdziwa obietnica nie polega na tym, że GLM 6.0 po prostu „sam się wytrenuje”. Bardziej znacząca zmiana to możliwość maszynowego generowania i weryfikowania większych części całego pipeline’u rozwojowego. Dziś badacze wciąż wykonują znaczną część pracy wokół modelu: zbierają dane, projektują zadania, budują ewaluatory, konstruują środowiska, diagnozują błędy i stroją oprogramowanie systemowe. Full Self-Training przesuwa model w więcej z tych etapów.
Jeśli podejście zadziała, ważna zmienna skalowania staje się mniej kwestią tego, ile parametrów można dodać, a bardziej tego, ile użytecznych, zweryfikowanych cykli uczenia można wykonać na jednostkę zasobów obliczeniowych. To praktyczna interpretacja rekurencyjnego samodoskonalenia, a nie science-fiction o nieograniczonej autonomicznej samomodfikacji.
Ujawnioną strategię należy oceniać jako inżynierski system sprzężenia zwrotnego z weryfikatorami, replikowalnymi środowiskami, benchmarkami infrastruktury i kontrolą ludzką — a nie jako dowód nieograniczonego autonomicznego samodoskonalenia.
Co może pójść nie tak w Full Self-Training?
Pętla samotreningu może równie skutecznie kumulować błędy, jak i użyteczne doświadczenia. Cztery tryby porażki zasługują na szczególną uwagę:
- Error amplification: słabe syntetyczne trajektorie mogą stać się przyszłymi danymi treningowymi, pozwalając, by wiarygodnie brzmiące, lecz błędne wzorce wzmacniały się.
- Reward and evaluator gaming: jeśli ten sam system generuje pracę i ją ocenia, może optymalizować pod luki w weryfikatorze zamiast pod rzeczywisty sukces zadania.
- Distribution narrowing: wielokrotne uczenie się na danych generowanych przez model może zmniejszać różnorodność i utrudniać radzenie sobie z rzadkimi przypadkami w świecie rzeczywistym.
- Presja kosztów, bezpieczeństwa i governance: konstrukcja środowisk, dostęp do narzędzi i trwała iteracja zwiększają zapotrzebowanie na compute i poszerzają powierzchnię ataku.
Wiarygodna implementacja GLM-6.0 musi zatem mieć niezależne weryfikatory, pochodzenie danych, progi akceptacji, testy red-team, audyty ludzkie i jawne reguły zatrzymania. Samokorekta jest użyteczna tylko wtedy, gdy sygnał korekcyjny jest bardziej godny zaufania niż zachowanie, które koryguje.
Kiedy GLM 6.0 API może być dostępne?
Z.AI nie opublikowało daty wydania GLM 6.0 API, ID modelu, okna kontekstu, maksymalnej długości wyjścia, ceny tokena, deklaracji otwartych wag ani wymagań wdrożeniowych. Każda konkretna wartość byłaby obecnie spekulacją.
Deweloperzy mogą oceniać obecny kierunek poprzez GLM-5.3-Flash API w CometAPI dla natywnie multimodalnych i zorientowanych na efektywność obciążeń, GLM-5.3 API w CometAPI dla aktualnej gałęzi flagowej lub GLM-5.2 API w CometAPI jako porównawczego punktu odniesienia poprzedniej generacji.
Wniosek
GLM-6.0 ma mniejsze znaczenie jako obiecany produkt niż jako test tego, czy Z.AI potrafi przekształcić Full Self-Training w powtarzalny system inżynieryjny. Mapa łączy samogenerowane doświadczenia, etapowy trening, samoocenę, korektę i kontrolowaną iterację; rozstrzygające będzie to, czy mechanizmy te poprawią niezawodność w długich, narzędziowych, rzeczywistych przepływach pracy.
Dowody są wciąż niepełne. Z.AI nie opublikowało karty modelu GLM-6.0, daty wydania, identyfikatora API, cennika ani zestawu benchmarków. Dopóki te artefakty nie istnieją, obronny wniosek jest wąski: firma ujawniła kierunek treningowy, a nie gotowy profil możliwości.
Ostatecznym celem Full Self-Training nie jest poprawa wyników testów, lecz poprawa zdolności modelu do wykonywania realnych zadań.