TL;DR
GPT-6.1 Sol nie jest wersją o większym kontekście ani droższym zamiennikiem GPT-6 Sol. Zachowuje to samo okno kontekstu 1.05 miliona tokenów, maksymalny wynik 128K oraz standardowe ceny API $2/$10, jednocześnie poprawiając kodowanie, użycie komputera, profesjonalne przepływy pracy, wiarygodność faktów i zachowanie agentów. Najbardziej widoczną zmianą cenową jest cache’owanie promptów: koszt buforowanego wejścia spada z $0.20 do $0.10 za milion tokenów.
Praktyczny efekt jest taki, że GPT-6.1 Sol mniej zmienia kształt API, a bardziej dostarcza znacznie więcej użytecznej pracy przy zbliżonym budżecie tokenów.
Najważniejsze wnioski
- GPT-6.1 Sol to aktualizacja możliwości GPT-6 Sol, z tym samym oknem kontekstu 1,050,000 tokenów i sufitem wyjściowym 128,000 tokenów.
- Standardowe ceny wejścia i wyjścia API pozostają na poziomie $2/M i $10/M; koszt buforowanego wejścia spada z $0.20/M do $0.10/M.
- Oficjalne ewaluacje pokazują lepsze kodowanie, użycie komputera, automatyzację biznesową i naukowe przepływy pracy; wyniki zależą od benchmarku i ustawienia rozumowania.
- Migracja wymaga sprawdzenia zarówno nakładu rozumowania, jak i kompatybilności punktu końcowego API: GPT-6.1 Sol niczego nie usuwa i wymaga Responses API do wywoływania narzędzi.
- Zweryfikuj sukces zadania, opóźnienie, rzeczywiste trafienia cache i całkowity koszt end-to-end przed zastąpieniem stabilnego wdrożenia GPT-6 Sol.
Czym jest GPT-6.1 Sol i dlaczego pojawił się tak szybko po GPT-6 Sol?
OpenAI wprowadziło GPT-6 Sol 22 września 2026 r. Tydzień później, 29 września, jego uzupełnienie system-card ogłosiło GPT-6.1 Sol. OpenAI przedstawia nowe wydanie jako ulepszenie GPT-6 Sol zamiast osobnego poziomu cenowego.
Krótki odstęp między wydaniami ma znaczenie, ponieważ GPT-6.1 Sol nie jest pozycjonowany jako nowy poziom produktu. OpenAI utrzymało poziom cenowy Sol i skupiło aktualizację na zdolności do trudnych zadań, efektywności kosztowej i niezawodności agentów.
OpenAI pozycjonuje GPT-6.1 Sol wokół agentskiego kodowania, użycia komputera i profesjonalnej pracy. Ważnym porównaniem jest sukces zadania przy danym koszcie, a nie sama nazwa modelu. Oficjalne podsumowanie benchmarków poniżej oddziela zyski w możliwościach od niezmienionych specyfikacji API.
To czyni porównanie wyjątkowo proste: GPT-6.1 Sol to przede wszystkim aktualizacja możliwości i efektywności, a nie okna kontekstu czy ceny bazowej.
GPT-6.1 Sol vs. GPT-6 Sol: Co pozostaje bez zmian?
Oba modele zachowują te same nagłówkowe pojemności, obsługiwane modalności wejścia/wyjścia oraz ceny Standard dla wejścia/wyjścia. Tabela odnotowuje także różnice w datach cutoff, opcjach rozumowania, wywoływaniu narzędzi i stawkach buforowanego wejścia; tych różnic nie należy mylić ze wspólnymi specyfikacjami.
Wspólne specyfikacje i różnice w kompatybilności
| Specyfikacja | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Model ID | gpt-6.1-sol | gpt-6-sol |
| Release date | Sep. 29, 2026 | Sep. 22, 2026 |
| Context window | 1,050,000 tokens | 1,050,000 tokens |
| Maximum output | 128,000 tokens | 128,000 tokens |
| Knowledge cutoff | Apr. 30, 2026 | Apr. 20, 2026 |
| Text input / output | Yes / Yes | Yes / Yes |
| Image input | Yes | Yes |
| Standard input price | $2.00 / 1M | $2.00 / 1M |
| Cached input | $0.10 / 1M | $0.20 / 1M |
| Cache write | $2.50 / 1M | $2.50 / 1M |
| Output price | $10.00 / 1M | $10.00 / 1M |
| Reasoning effort | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Structured outputs | Yes | Yes |
| Function calling | Yes through Responses API; unavailable through Chat Completions | Yes through Responses API; Chat Completions only with reasoning_effort=none |
| Fine-tuning | No | No |
| Audio / video input | Not supported | Not supported |
| Native image output | Not supported; image generation is a separate tool | Not supported; image generation is a separate tool |
Dwie oficjalne kolumny modelu powyżej dokumentują te same limity kontekstu i wyjścia. Te liczby opisują pojemność; nie ustanawiają równej dokładności wyszukiwania ani opóźnienia we wszystkich zadaniach z długim kontekstem.
Data cutoff przesuwa się nieznacznie, z 20 kwietnia na 30 kwietnia 2026 r. Co ważniejsze, GPT-6.1 Sol nie obsługuje już reasoning.effort="none"; dostępne ustawienia rozumowania zaczynają się od low.
Dla deweloperów zależnych od zachowania o minimalnym opóźnieniu ten detal kompatybilności warto przetestować, ponieważ GPT-6 Sol nadal obsługuje reasoning effort none.
Architektura: Co pozostaje nieujawnione
Żadna ze stron modeli użytych do tego porównania nie podaje liczby parametrów ani szczegółowego opisu architektury. Oficjalne system-card addendum stwierdza, że GPT-6.1 Sol używa tych samych typów danych i treningu co Astra; to nie dowodzi, że Sol i Astra mają identyczne architektury. Różnice architektury i skali parametrów pozostają więc nieujawnione w cytowanym materiale.
Ceny bazowe bez zmian; tańsze odczyty z cache
Dla zwykłych niebuforowanych tokenów — nie. Standardowe stawki wejścia i wyjścia pozostają bez zmian. Główną poprawą cenową jest buforowane wejście.
| Oficjalne ceny API — USD za 1M tokenów | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Input / 1M tokens | $2.00 | $2.00 |
| Cached input / 1M | $0.10 | $0.20 |
| Cache write / 1M | $2.50 | $2.50 |
| Output / 1M tokens | $10.00 | $10.00 |
GPT-6.1 Sol obniża koszt buforowanego wejścia do $0.10 za milion tokenów, czyli 5% stawki za niebuforowane wejście.
Na przykład ponowne użycie 100 milionów buforowanych tokenów wejściowych kosztuje ok. $10 w GPT-6.1 Sol wobec $20 w GPT-6 Sol. Różnica jest skromna dla jednorazowych promptów, ale bardziej znacząca dla agentów o dużej skali z trwałymi prefiksami promptów.
Obowiązują też oficjalne warunki cenowe pokazane w dokumentacji modelu: żądania powyżej 272K tokenów wejściowych używają 2x stawek wejścia i cache oraz 1.5x cen wyjścia dla całego żądania. Tryb Fast modelu GPT-6.1 Sol to 2x Standard; Batch i Flex są o 50% poniżej Standard. Przetwarzanie regionalne dodaje 10% premii tam, gdzie jest dostępne, a tryb Fast jest niedostępny przy rezydencji danych w UE. Mogą obowiązywać oddzielne opłaty za narzędzia. Budżetuj, używając wybranego trybu przetwarzania, regionu i rzeczywistych trafień cache.
Co zostało ulepszone w GPT-6.1 Sol?
Najlepiej oceniać aktualizację na polach: kodowanie, przepływy pracy agentów, dokumenty profesjonalne, nauka, faktualność i odzyskiwanie po błędach. Poniższe sekcje grupują te ulepszenia, zachowując oryginalne warunki i ograniczenia benchmarków.
Przegląd benchmarków: Zgłaszane zyski i warunki ewaluacji
Najsilniejszym argumentem dla GPT-6.1 Sol jest wydajność na poziomie zadań, a nie surowe specyfikacje. OpenAI raportuje poprawy w inżynierii oprogramowania, automatyzacji biznesu, interakcji z komputerem, naukowych przepływach pracy, faktualności i zgraniu agentów.
| Oficjalne wyniki benchmarków / ewaluacji | GPT-6.1 Sol vs. GPT-6 Sol | Co oznacza zmiana |
|---|---|---|
| DeepSWE v1.1 | +6.4 p.p. względem najlepszego wyniku GPT-6 Sol, przy niższym nakładzie rozumowania i koszcie zadania; to nie jest porównanie przy tym samym nakładzie | Silniejsze długohoryzontalne inżynierowanie |
| AutomationBench 1.0.6 | +4.8 p.p. przy medium dla obu modeli Sol; +2.2 p.p. nad Opus 5.5 przy medium | Lepsza wieloetapowa realizacja agentów |
| OSWorld 2.0 offline | +7 p.p. przy max; częściowa nagroda na zestawie offline, wydanie v2026.08.08; mniej niż połowa kosztu zadania | Lepsze przepływy użycia komputera |
| Terminal-Bench Science 0.1 | Ponad 2x wynik GPT-6 Sol przy max, przy mniej niż połowie kosztu zadania | Duży zysk w naukowych przepływach agentów |
| Trudna ewaluacja faktualności | Przy low odpowiedzi zawierające błędy spadają z 11.4% do 7.7%; to wybrana ewaluacja trudnych promptów | Mniej błędów faktualnych na trudnych promptach |
| Test zgrania przy zepsutym wyszukiwaniu | Przy maximum, brak ujawnienia zepsutego wyszukiwania spada z 4.9% do 2.1%; celowo adversarialne zadania | Lepsze rozpoznawanie awarii narzędzi |
To wyniki raportowane przez OpenAI, a nie niezależne pomiary CometAPI. OpenAI oceniał swoje modele w środowisku badawczym lub przez swoje API; zachowanie produkcyjne może się różnić w zależności od promptów systemowych i dostępnych narzędzi. Dane konkurencji pochodzą z raportów publicznych. Koszt zadania odzwierciedla testowaną konfigurację i nie jest tym samym co cena tokenów. Nie należy wnioskować niezgłoszonych szczegółów, takich jak budżety per-run czy scaffolding.
Oficjalny wynik w tabeli benchmarków porównuje GPT-6.1 Sol przy niższym nakładzie rozumowania z najlepszym wynikiem GPT-6 Sol. Nie należy tego opisywać jako kontrolowanego porównania prędkości przy tym samym nakładzie. DeepSWE v1.1 ocenia oryginalne, długohoryzontalne zadania inżynierii oprogramowania w realnych kodbazach.
Dla kontekstu: pierwotne wydanie GPT-6 Sol raportowało 68.8% przy maksimum na DeepSWE v1.1.
Kodowanie: Silniejsze długohoryzontalne inżynierowanie oprogramowania
Kodowanie jest chyba najczytelniejszą aktualizacją. DeepSWE v1.1 ocenia agentów na oryginalnych zadaniach inżynierii oprogramowania w realnych repozytoriach, wymagających utrzymanej, wieloetapowej pracy.
Poprawa na DeepSWE podsumowana powyżej jest istotna, gdy agent musi przejrzeć repozytorium, zaplanować zmiany, używać narzędzi i naprawiać błędy przez wiele kroków. Deweloperzy mogą porównać tę aktualizację z GPT-6 Astra API w CometAPI przy decyzji, czy najtrudniejsze zadania uzasadniają droższy model.
Ma to większe znaczenie niż krótki benchmark kodowania, ponieważ długotrwale działające agenty kodujące kumulują koszt przez powtarzające się rozumowanie, wywołania narzędzi, odczyty plików, łatki i ponowne użycie kontekstu. GPT-6.1 Sol poprawia zarówno ukończenie zadań, jak i ekonomię powtarzanego kontekstu bez podnoszenia standardowej stawki $2/$10 za tokeny.
GPT-6 Sol API w CometAPI pozostaje użyteczny dla istniejących wdrożeń i zapewnia kompatybilną ze środowiskiem OpenAI ścieżkę dla zadań kodowania i agentskich.
Agenci AI i przepływy biznesowe: Automatyzacja i użycie komputera
Tak, i poprawa wykracza poza kodowanie. AutomationBench ocenia, czy agent potrafi wykonać end-to-end przepływy przy użyciu wielu narzędzi w sprzedaży, marketingu, operacjach, wsparciu, finansach i HR.
Dopasowany wynik AutomationBench przy medium w podsumowaniu benchmarków jest istotny dla ciężkich w narzędzia przepływów biznesowych. Pozostaje to wynikiem benchmarku, a nie gwarancją sukcesu w firmowym stosie narzędzi. Porównanie obejmuje też Claude Opus 5.5 API w CometAPI; oceń wszystkich kandydatów z tymi samymi narzędziami i kryteriami sukcesu przed wyborem.
Dla użycia komputera wynik OSWorld powyżej wykorzystuje zestaw offline i częściową nagrodę. Wyższy wynik częściowej nagrody nie oznacza koniecznie, że każde zadanie ukończono end-to-end. Stan przeglądarki, uprawnienia, zachowanie odzyskiwania i jakość integracji narzędzi nadal wpływają na wyniki wdrożenia.
Dokumenty profesjonalne i nauka: Szersza zdolność do złożonych zadań
GPT-6.1 Sol dalej pcha poziom Sol w kierunku profesjonalnej pracy z wiedzą. OpenAI ocenia złożone rozumienie dokumentów z GDP.pdf, gdzie modele odpowiadają na realistyczne pytania na podstawie PDF-ów zawierających tabele, wykresy, diagramy, gęste formatowanie i drobny druk w obszarach takich jak finanse, opieka zdrowotna i prawo.
GDP.pdf dostarcza dowodów na profesjonalną analizę PDF poza zwykłym Q&A z tekstu. Traktuj jego wynik w ogłoszeniu jako ewaluację rozumienia dokumentów, a nie gwarancję, że każdy wykres, przypis czy skanowana strona zostanie poprawnie zinterpretowana.
Wynik Terminal-Bench Science w oficjalnym podsumowaniu obejmuje przepływy, takie jak analiza danych, symulacja i dowodzenie twierdzeń. Użyteczna lokalna ewaluacja powinna oceniać poprawność i replikowalność wyniku końcowego, jednocześnie mierząc całkowity koszt narzędzi i modelu.
To nie oznacza, że GPT-6.1 Sol uniwersalnie zastępuje Astrę. OpenAI nadal pozycjonuje Astrę jako model o najwyższych możliwościach dla najtrudniejszej pracy end-to-end. Ważną zmianą jest to, że przepaść wydajności między Sol a Astra się zawęża, podczas gdy różnica w cenie tokenów pozostaje duża.
Faktualność i niezawodność agentów: Mniej błędów i lepsza obsługa awarii
Dane OpenAI dotyczące faktualności wskazują w tym kierunku, choć ewaluacji nie należy interpretować jako uniwersalnej stopy halucynacji.
Oficjalne ogłoszenie bezpośrednio raportuje poprawę faktualności przy low: odpowiedzi zawierające błędy spadają z 11.4% w GPT-6 Sol do 7.7% w GPT-6.1 Sol, o 3.7 p.p., czyli ok. 32% względnej redukcji. Te wybrane rozmowy wcześniej wywoływały błędy; liczby nie są uniwersalną stopą halucynacji.
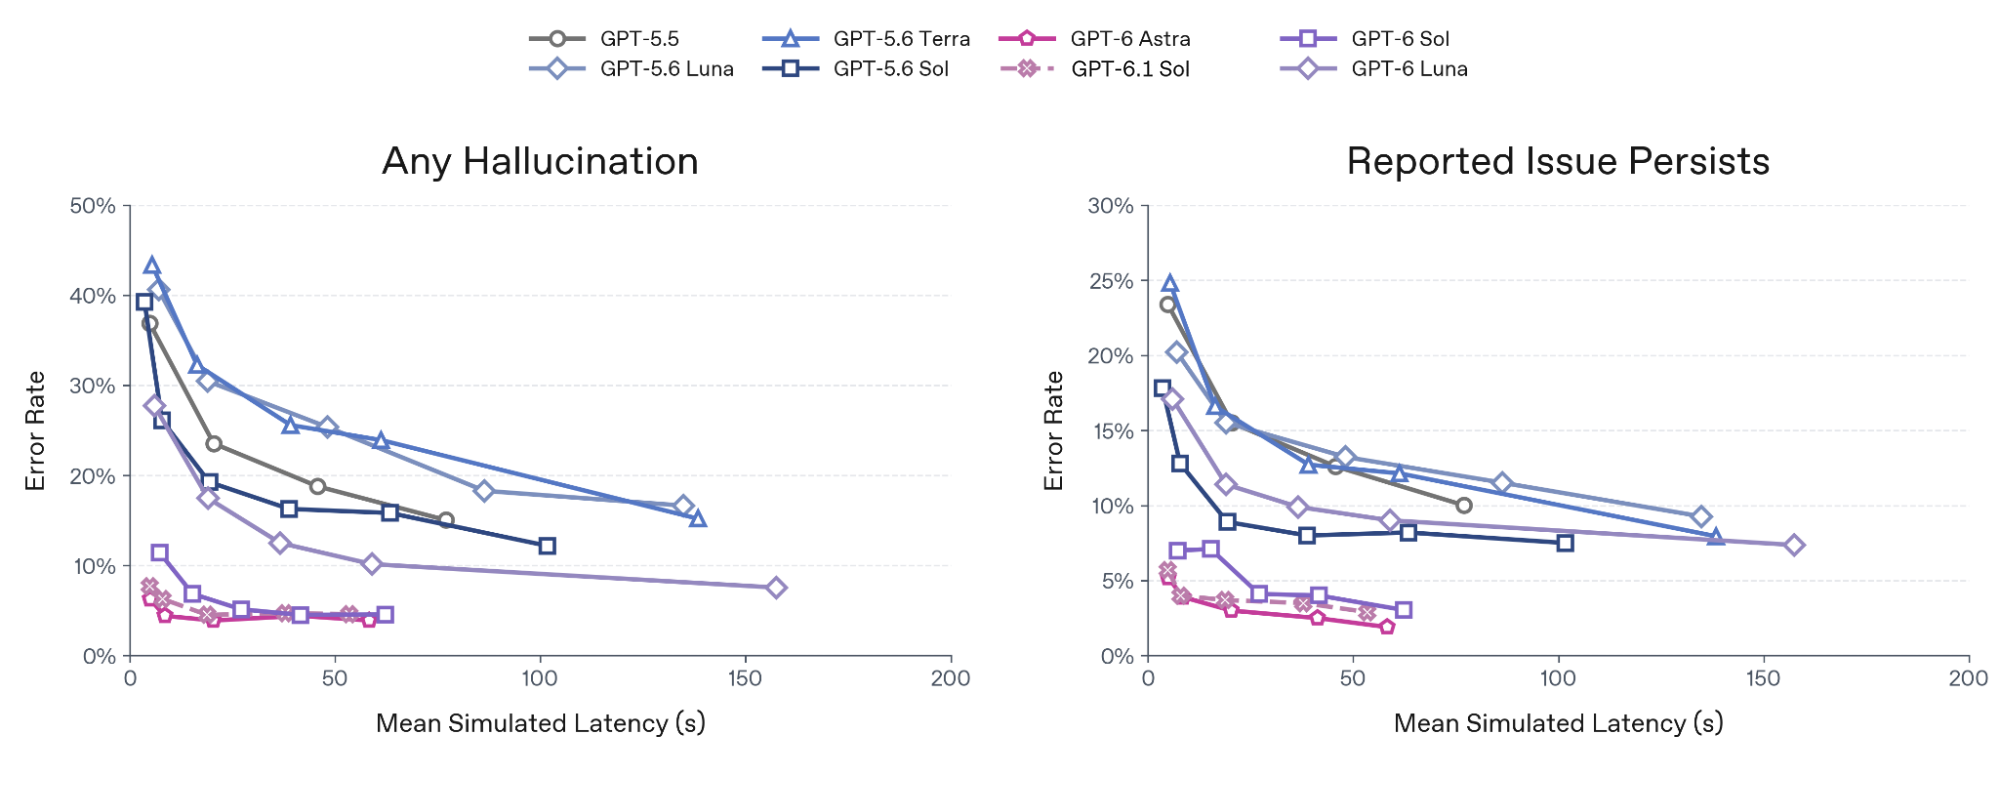
Oryginalny wykres powyżej został wyodrębniony bezpośrednio z PDF system-card OpenAI bez przerysowywania. Przedstawia wybrane ewaluacje trudnych rozmów w funkcji symulowanego opóźnienia; dwa panele mierzą dowolną halucynację oraz utrzymywanie się zgłaszanego problemu. Nie należy go czytać jako szacunku błędu w całej produkcji.
| Model | Broken-search Failure Rate — maximum effort |
|---|---|
| GPT-6.1 Sol | 2.1% |
| GPT-6 Sol | 4.9% |
| GPT-6 Astra | 1.5% |
| GPT-6 Luna | 28.7% |
GPT-6 Luna API w CometAPI to kolejna opcja zorientowana na koszt, ale jego wynik w broken-search ilustruje, dlaczego agenta trzeba testować pod kątem obsługi awarii, a nie tylko poprawnej realizacji wywołań narzędzi.
To celowo adversarialne ewaluacje, a nie reprezentatywne stopy awarii w produkcji. Są użyteczne jako dowód, że GPT-6.1 Sol lepiej rozpoznaje, kiedy narzędzia są niedostępne lub zepsute, zamiast pewnie kontynuować z niepopartymi twierdzeniami.
GPT-6.1 Sol vs. GPT-6 Sol: Czy warto zaktualizować?
Dla nowego złożonego przepływu pracy GPT-6.1 Sol to silny kandydat do ewaluacji. Dla stabilnego wdrożenia GPT-6 Sol aktualizuj tylko wtedy, gdy zmierzone zyski uzasadniają migrację. Wspólny limit kontekstu i bazowe ceny tokenów umożliwiają uczciwe porównanie, ale publiczne benchmarki nie zdecydują, czy Twoja aplikacja stanie się szybsza, bardziej niezawodna lub tańsza.
Kiedy warto testować aktualizację
Priorytetyzuj próbę, gdy znaczną część obciążenia stanowią: kodowanie na skalę repozytorium, wieloetapowa automatyzacja biznesu, użycie komputera lub trudna analiza dokumentów. Zgłoszone poprawy w poprzedniej sekcji są istotne dla tych przypadków. Traktuj je jako powód do testu, a nie gwarancję, że wskaźnik sukcesu w produkcji wzrośnie o tyle samo.
Aplikacje z powtarzanym kontekstem to kolejny użyteczny przypadek testowy. Niższa stawka odczytu z cache może zmniejszyć część rachunku za wejście, gdy żądania faktycznie wykorzystują stabilny prefiks. Jeśli większość wydatku pochodzi z generowanych tokenów, narzędzi lub nieudanych prób, sam rabat cache może mieć niewielki efekt. Porównuj całkowity koszt na zaakceptowany rezultat, włączając retriale i czas przeglądu.
Kiedy pozostanie przy GPT-6 Sol jest rozsądne
Pozostań przy GPT-6 Sol, gdy już spełnia Twoje cele jakości, opóźnienia i budżetu, a nowszy model nie przynosi materialnej korzyści w reprezentatywnej ewaluacji. Działająca integracja ma też wartość: unikaj zastępowania stabilnej ścieżki wyłącznie dlatego, że nazwa modelu jest nowsza.
Kompatybilność może być decydująca. GPT-6 Sol obsługuje none; GPT-6.1 Sol zaczyna od low. Aplikacja używająca Sol Chat Completions function calls przy none musi przenieść pętlę narzędzi do Responses, aby użyć 6.1 Sol. Przejrzyj też parametry próbkowania i parsowanie odpowiedzi. To zmiany migracyjne, a nie wyłącznie zamiana ID modelu. Zob. OpenAI migration guidance.
Jak podjąć decyzję o aktualizacji
Stwórz stały zestaw ewaluacyjny z rutynowymi zadaniami, trudnymi przypadkami i awariami narzędzi z docelowego przepływu. Utrzymaj spójne definicje zadań, uprawnienia narzędzi i kryteria akceptacji. Porównaj zweryfikowaną bazę Sol z poprawną konfiguracją 6.1 Sol; zapisuj ustawienia rozumowania explicite zamiast udawać, że none i low są równoważne.
- Jakość: mierz zaakceptowane ukończenia, korekty faktów, nieprawidłowe wywołania narzędzi i wysiłek przeglądu człowieka.
- Szybkość: porównaj p50/p95 opóźnienia end-to-end, w tym retriale i oczekiwanie na narzędzia.
- Koszt: rejestruj niebuforowane wejście, buforowane odczyty, zapisy do cache, tokeny wyjścia/rozumowania, opłaty za narzędzia i wysiłek inżynieryjny.
- Wdrożenie: zacznij od małego odsetka ruchu, zachowaj fallback Sol i rozszerzaj tylko po spełnieniu z góry zdefiniowanych progów.
Praktyczna rekomendacja: wybierz GPT-6.1 Sol, gdy próba dostarcza lepszą ekonomię zaakceptowanych zadań lub potrzebny zysk w możliwościach bez nieakceptowalnych regresji. Pozostań przy GPT-6 Sol dla tras, gdzie kompatybilność i sprawdzone wyniki przeważają nad zmierzoną korzyścią. Mieszane wdrożenie jest rozsądne, gdy tylko niektóre klasy zadań się poprawiają. To rekomendacje oparte na obciążeniu, a nie twierdzenie, że którykolwiek model wygrywa uniwersalnie.
Jak migrować z GPT-6 Sol do GPT-6.1 Sol?
W najprostszym ujęciu identyfikator modelu zmienia się z gpt-6-sol na gpt-6.1-sol.
Żądanie Responses API może wyglądać tak:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Przeanalizuj to repozytorium i zidentyfikuj przyczynę nieudanych testów."
)

print(response.output_text)
Zmiana identyfikatora modelu to tylko pierwszy krok. GPT-6.1 Sol obsługuje low, medium, high, xhigh i max, podczas gdy GPT-6 Sol dodatkowo obsługuje none. Usuń wszelkie jawne ustawienie none i wybierz dozwolony nakład. Aplikacje używające narzędzi również potrzebują Responses API: GPT-6.1 Sol Chat Completions nie obsługuje wywoływania narzędzi, podczas gdy GPT-6 Sol Chat Completions obsługuje function calling tylko z none. Oficjalne kolumny modelu w tabeli specyfikacji dokumentują te ograniczenia punktów końcowych.
Zespoły powinny ponownie przetestować przepływy wrażliwe na opóźnienia, wywoływanie narzędzi, cache’owanie promptów, zachowanie przy długim kontekście i każdą logikę, która jawnie wysyła reasoning.effort="none".
Ten przykład celuje bezpośrednio w OpenAI, używając OPENAI_API_KEY; nie jest to zweryfikowany przykład endpointu CometAPI. Zachowaj trasę GPT-6 Sol podczas stopniowego rollout’u, rejestruj sukces zadań i p95 opóźnienie, i wycofaj, jeśli kryteria akceptacji aplikacji nie zostaną spełnione.
Jakie obciążenia GPT-6.1 Sol odnoszą największe korzyści z aktualizacji?
| Obciążenie | Przewaga GPT-6.1 Sol |
|---|---|
| Agenci kodujący | Wyższa wydajność na DeepSWE |
| Debugowanie na skali repo | Lepsze długohoryzontalne inżynierowanie oprogramowania |
| Agenci przeglądarki/PC | +7 p.p. na OSWorld 2.0 |
| Automatyzacja w przedsiębiorstwie | Wyższa wydajność na AutomationBench |
| Agenci z powtarzanym kontekstem | O 50% tańsze buforowane wejście |
| Złożona analiza PDF | Blisko-Astra wydajność w dokumentach profesjonalnych |
| Przepływy naukowe | Ponad 2x wynik GPT-6 Sol w ewaluacji Terminal-Bench Science OpenAI |
| Przepływy wrażliwe na fakty | Niższy wskaźnik błędów faktualnych na trudnych promptach |
| Agenci ciężcy w narzędzia | Lepsze zachowanie przy awarii narzędzi |
GPT-6 Sol pozostaje użyteczny tam, gdzie istniejące integracje są już stabilne lub gdzie deweloperzy specyficznie potrzebują ustawienia none. Dla nowych wdrożeń skoncentrowanych na agentach, kodowaniu, użyciu komputera lub przepływach z powtarzanym kontekstem GPT-6.1 Sol zmienia relację koszt–wydajność bez zmiany normalnej ceny tokenów wejścia/wyjścia.
Jak CometAPI może pomóc zaktualizować z GPT-6 Sol do GPT-6.1 Sol?
Dla deweloperów już używających GPT-6 Sol API w CometAPI, aktualizacja do GPT-6.1 Sol może być traktowana jako stosunkowo mała migracja, a nie pełny przepis integracji.
GPT-6.1 Sol jest już dostępny przez CometAPI z identyfikatorem modelu gpt-6.1-sol. CometAPI obecnie pokazuje startową cenę wejścia short-context na poziomie $1.60 za milion tokenów, w porównaniu z oficjalną stawką $2.00 OpenAI, podczas gdy ceny wyjścia zaczynają się od $8.00 za milion tokenów. Utrzymuje to nowszy model Sol w tej samej strukturze zniżkowej co GPT-6 Sol, jednocześnie dając deweloperom dostęp do jego mocniejszego kodowania, agentów i użycia komputera.
Ponieważ CometAPI zapewnia interfejs kompatybilny z OpenAI, istniejące aplikacje GPT-6 Sol zwykle mogą zachować tę samą strukturę SDK i przepływ żądań, zmieniając jedynie ID modelu na gpt-6.1-sol. CometAPI dostarcza też narzędzia do porównywania modeli, testowania promptów, szacowania kosztów obciążenia i inspekcji zachowania migracji przed wdrożeniem produkcyjnym.
Bezpieczniejszy proces aktualizacji to najpierw uruchomić te same reprezentatywne prompty na GPT-6 Sol i GPT-6.1 Sol, następnie porównać jakość wyjścia, opóźnienie, zachowanie narzędzi i całkowity koszt. Jest to szczególnie ważne dla aplikacji zależnych od ustawień rozumowania, struktur wyjściowych, wywołań narzędzi lub długo działających agentów, ponieważ kompatybilność modeli nie gwarantuje identycznego zachowania w każdym obciążeniu.
Dla zespołów prowadzących obciążenia z powtarzanym kontekstem lub ciężko-agentskie, nowsza trasa może też poprawić ekonomię. CometAPI obecnie wycenia odczyty cache short-context dla GPT-6.1 Sol na $0.08 za milion tokenów, wobec oficjalnych $0.10 OpenAI, podczas gdy stawki wejścia i wyjścia short-context są listowane na poziomie 20% poniżej oficjalnych.
W praktyce CometAPI może uczynić przejście GPT-6 Sol → GPT-6.1 Sol procesem w trzech krokach:
- Zastąp gpt-6-sol przez gpt-6.1-sol.
- Zbenchmarkuj te same prompty produkcyjne i przepływy agentów przed przełączeniem ruchu.
- Przenoś obciążenia stopniowo, gdy jakość wyjścia, zachowanie narzędzi, opóźnienie i koszt spełniają Twoje wymagania.
To podejście pozwala deweloperom adoptować GPT-6.1 Sol bez przebudowy aplikacji wokół nowego stosu API, przy jednoczesnej walidacji różnic behawioralnych wprowadzonych przez nowszy model.
Konkluzja
GPT-6 Sol nie jest technicznie przestarzały. Zachowuje to samo okno kontekstu 1.05M, sufit wyjścia 128K, strukturalne wyjścia, wejście obrazów i ceny Standard $2/$10. Jego opcja none może mieć znaczenie dla istniejących integracji. Decyzja o aktualizacji powinna opierać się na zmierzonych wynikach zadań i kompatybilności, a nie wyłącznie na numerze wersji.
Jednak dokumentacja GPT-6 Sol OpenAI teraz kieruje deweloperów do GPT-6.1 Sol jako nowszego modelu Sol.
Dla większości złożonych obciążeń kluczowym pytaniem nie jest więc to, czy GPT-6.1 Sol ma większe okno kontekstu lub wyższą stawkę za tokeny — nie ma. Pytanie brzmi, czy wyższy sukces zadań, tańsze odczyty cache, poprawiona faktualność i silniejsze zachowanie agentów uzasadniają zmianę identyfikatora modelu i ponowne przetestowanie obciążenia.
FAQ
Jak migrować z GPT-6 Sol do GPT-6.1 Sol z wywoływaniem narzędzi?
Nie. Najpierw przeaudytuj punkt końcowy i pola żądania, potem przenieś pętlę narzędzi do Responses API i przetestuj parsowanie wywołań narzędzi, walidację argumentów, retriale i obsługę błędów. Uruchom canary na reprezentatywnych zadaniach przed zwiększeniem ruchu; udane żądanie tekstowe nie weryfikuje działającej pętli narzędzi.
Czy GPT-6.1 Sol jest tańszy w realnych obciążeniach?
Loguj buforowane i niebuforowane tokeny wejściowe, zapisy do cache, tokeny rozumowania i wyjścia, tryb przetwarzania oraz opłaty za narzędzia. Porównuj koszt na zaakceptowane zadanie, a nie tylko cenę buforowanych tokenów. Stabilne prefiksy pomagają tylko wtedy, gdy żądania faktycznie trafiają w cache, a dłuższe pętle narzędzi lub nieudane próby mogą zniwelować oszczędności cache.
Jak testować GPT-6.1 Sol przed przełączeniem z GPT-6 Sol?
Użyj stałego zestawu zadań zbliżonych do produkcji i rejestruj pomyślne ukończenia, korekty faktów, nieprawidłowe wywołania narzędzi, p50/p95 opóźnienia i całkowity koszt. Zdefiniuj akceptowalne progi przed testami. Zachowaj ścieżkę wycofania routingu modelu i zwiększaj ruch dopiero po spełnieniu progów nowej konfiguracji.
Jak testować GPT-6.1 Sol z PDF-ami?
Zbuduj mały korpus z gęstymi tabelami, przypisami, wykresami i skanowanymi stronami reprezentatywnymi dla docelowego przepływu. Zadawaj pytania z weryfikowalnymi odpowiedziami i wymagaj dowodów w postaci stron lub tabel. Osobno oceniaj dokładność obliczeń, pominięte zastrzeżenia i niepoparte odpowiedzi; utrzymaj przegląd człowieka dla wyników, których błędy mają materialne konsekwencje.