Buduj z CometAPIPotrzebujesz jednego API dla wielu modeli?Przetestuj proces w Playground, a potem utwórz klucz API, gdy model i koszt pasują do Twojego zastosowania.
Jak korzystać z interfejsu API DeepSeek V4.1 Flash
Jak korzystać z interfejsu API DeepSeek V4.1 Flash z CometAPI przy użyciu cURL, Pythona i JavaScript. Zbadaj tryb rozumowania, dane wejściowe, strumieniowanie i praktyki produkcyjne.
Dla deweloperów korzystających z DeepSeek V4.1 Flash przez CometAPI integracja jest praktycznie zgodna z OpenAI: użyj https://api.cometapi.com/v1 jako bazowego URL, ustaw model na deepseek-v4.1-flash i wywołuj standardowy interfejs Chat Completions.
Jest jedna istotna różnica w nazewnictwie: w pierwszej stronie API DeepSeek używa deepseek-flash, a w CometAPI obowiązuje deepseek-v4.1-flash. Traktuj identyfikatory modeli jako konfigurację zależną od dostawcy.
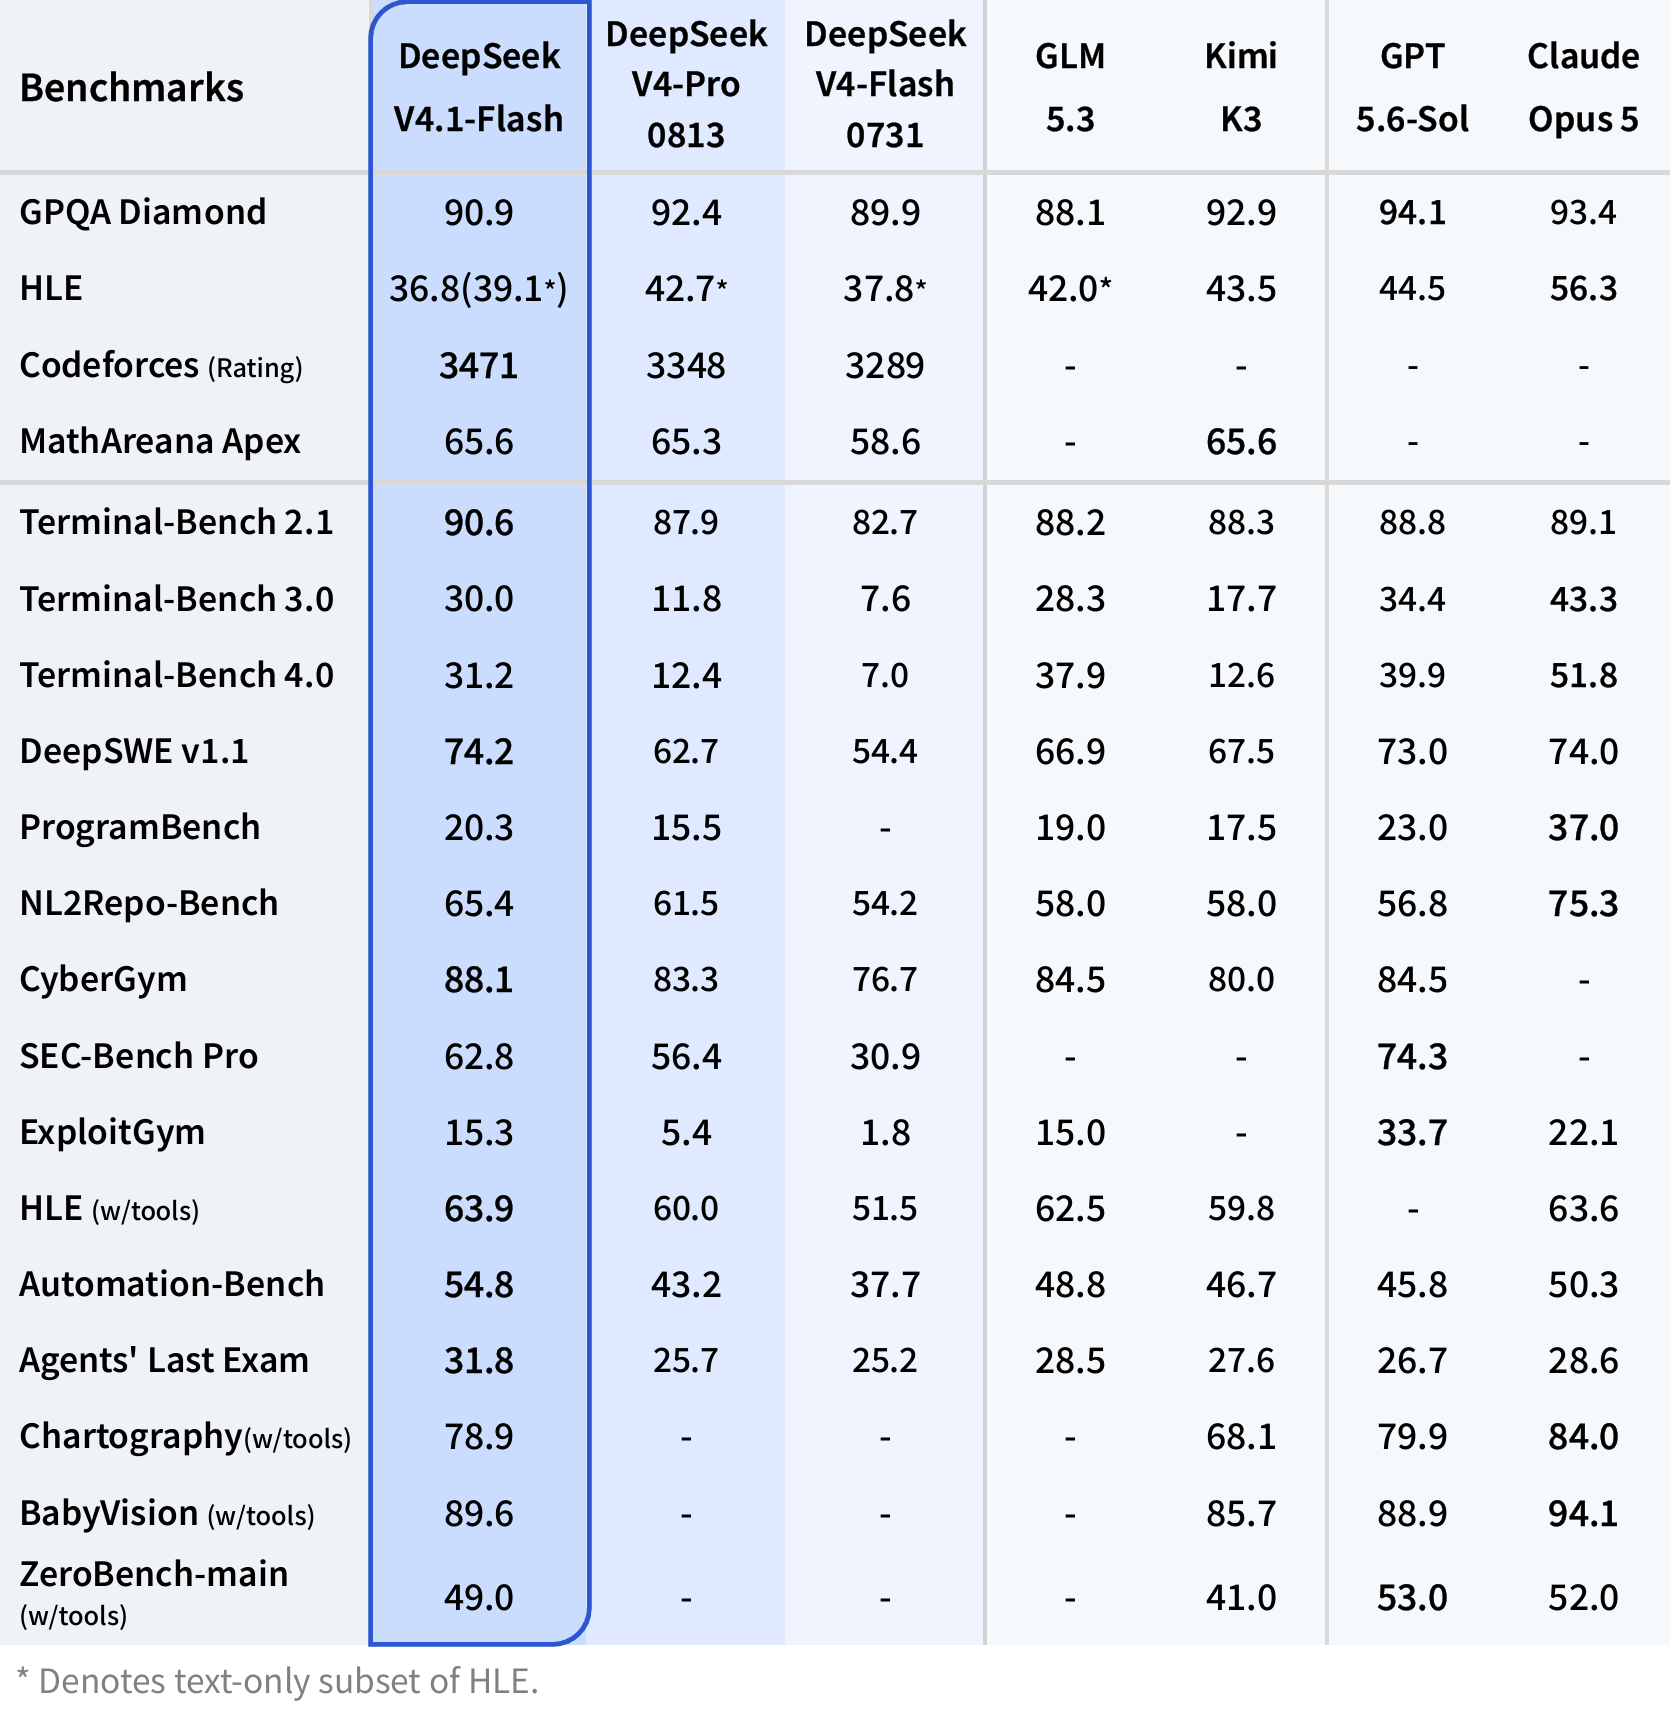
Największe mierzalne różnice koncentrują się na kodowaniu, terminalu, repozytoriach, automatyzacji i benchmarkach agentów korzystających z narzędzi.
Przed wdrożeniem do produkcji zweryfikuj zaawansowane pola, takie jak sterowanie rozumowaniem, ładunki wizji, strumieniowanie, wywołania narzędzi i strukturyzowane wyjście na dokładnie tym routingu dostawcy, który wdrożysz.
What Is the DeepSeek V4.1 Flash API?
DeepSeek V4.1 Flash to najnowszy model Flash zbudowany na architekturze Mixture-of-Experts o 552B parametrach. Jego konstrukcja Causal Encoder-Decoder aktywuje 8B parametrów do przetwarzania wejścia i 16B do generowania wyjścia.
Dla planowania integracji oficjalne API DeepSeek udostępnia okno kontekstu 1M tokenów i maksymalne wyjście 384K tokenów. Usługa wspiera interfejsy zgodne z OpenAI (Chat Completions i Responses API), API kompatybilne z Anthropic, strumieniowanie, wyjście JSON, wywołania narzędzi oraz natywny input obrazów. Ten przewodnik używa trasy Chat Completions w CometAPI, dlatego przed produkcją potwierdź przenoszenie funkcji na tej trasie.
Specification
Oficjalne szczegóły API DeepSeek V4.1 Flash
Architecture
552B MoE, Causal Encoder-Decoder
Active parameters
8B dla wejścia; 16B dla wyjścia
Context length
1M tokenów
Maximum output
384K tokenów
Interfaces
Chat Completions, Responses API, API zgodne z Anthropic
Streaming
Obsługiwane
Structured output
Wyjście JSON oraz JSON Schema na obsługiwanych endpointach
Tool calls
Obsługiwane, w tym użycie narzędzi w trybie rozumowania
Vision input
JPEG, PNG, GIF i WebP
Image limits
32 MiB inline; 64 MiB na plik; do 600 obrazów na żądanie
First-party model ID
deepseek-flash
CometAPI model ID
deepseek-v4.1-flash
Uwaga dostawcy: identyfikatory modeli i zaawansowane pola żądania są specyficzne dla tras. Używaj deepseek-v4.1-flash dla przykładów CometAPI w tym przewodniku i testuj wizję, wywołania narzędzi, strukturyzowane wyjście oraz sterowanie rozumowaniem na wdrożonym endpointzie.
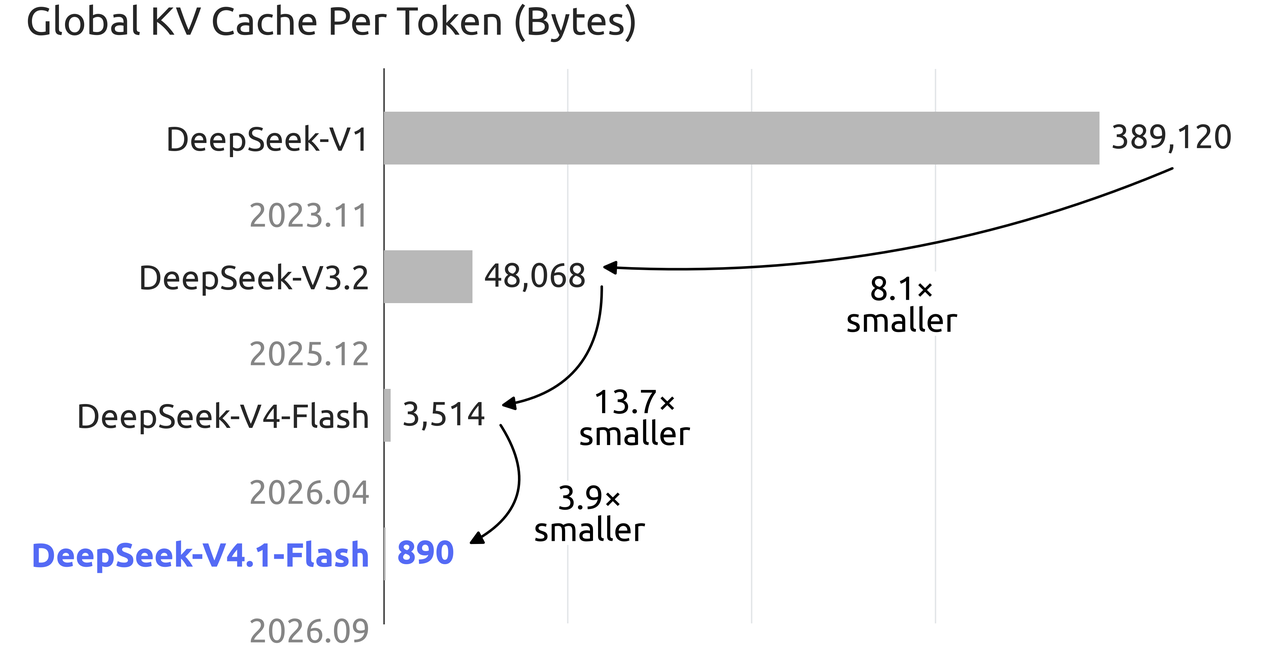
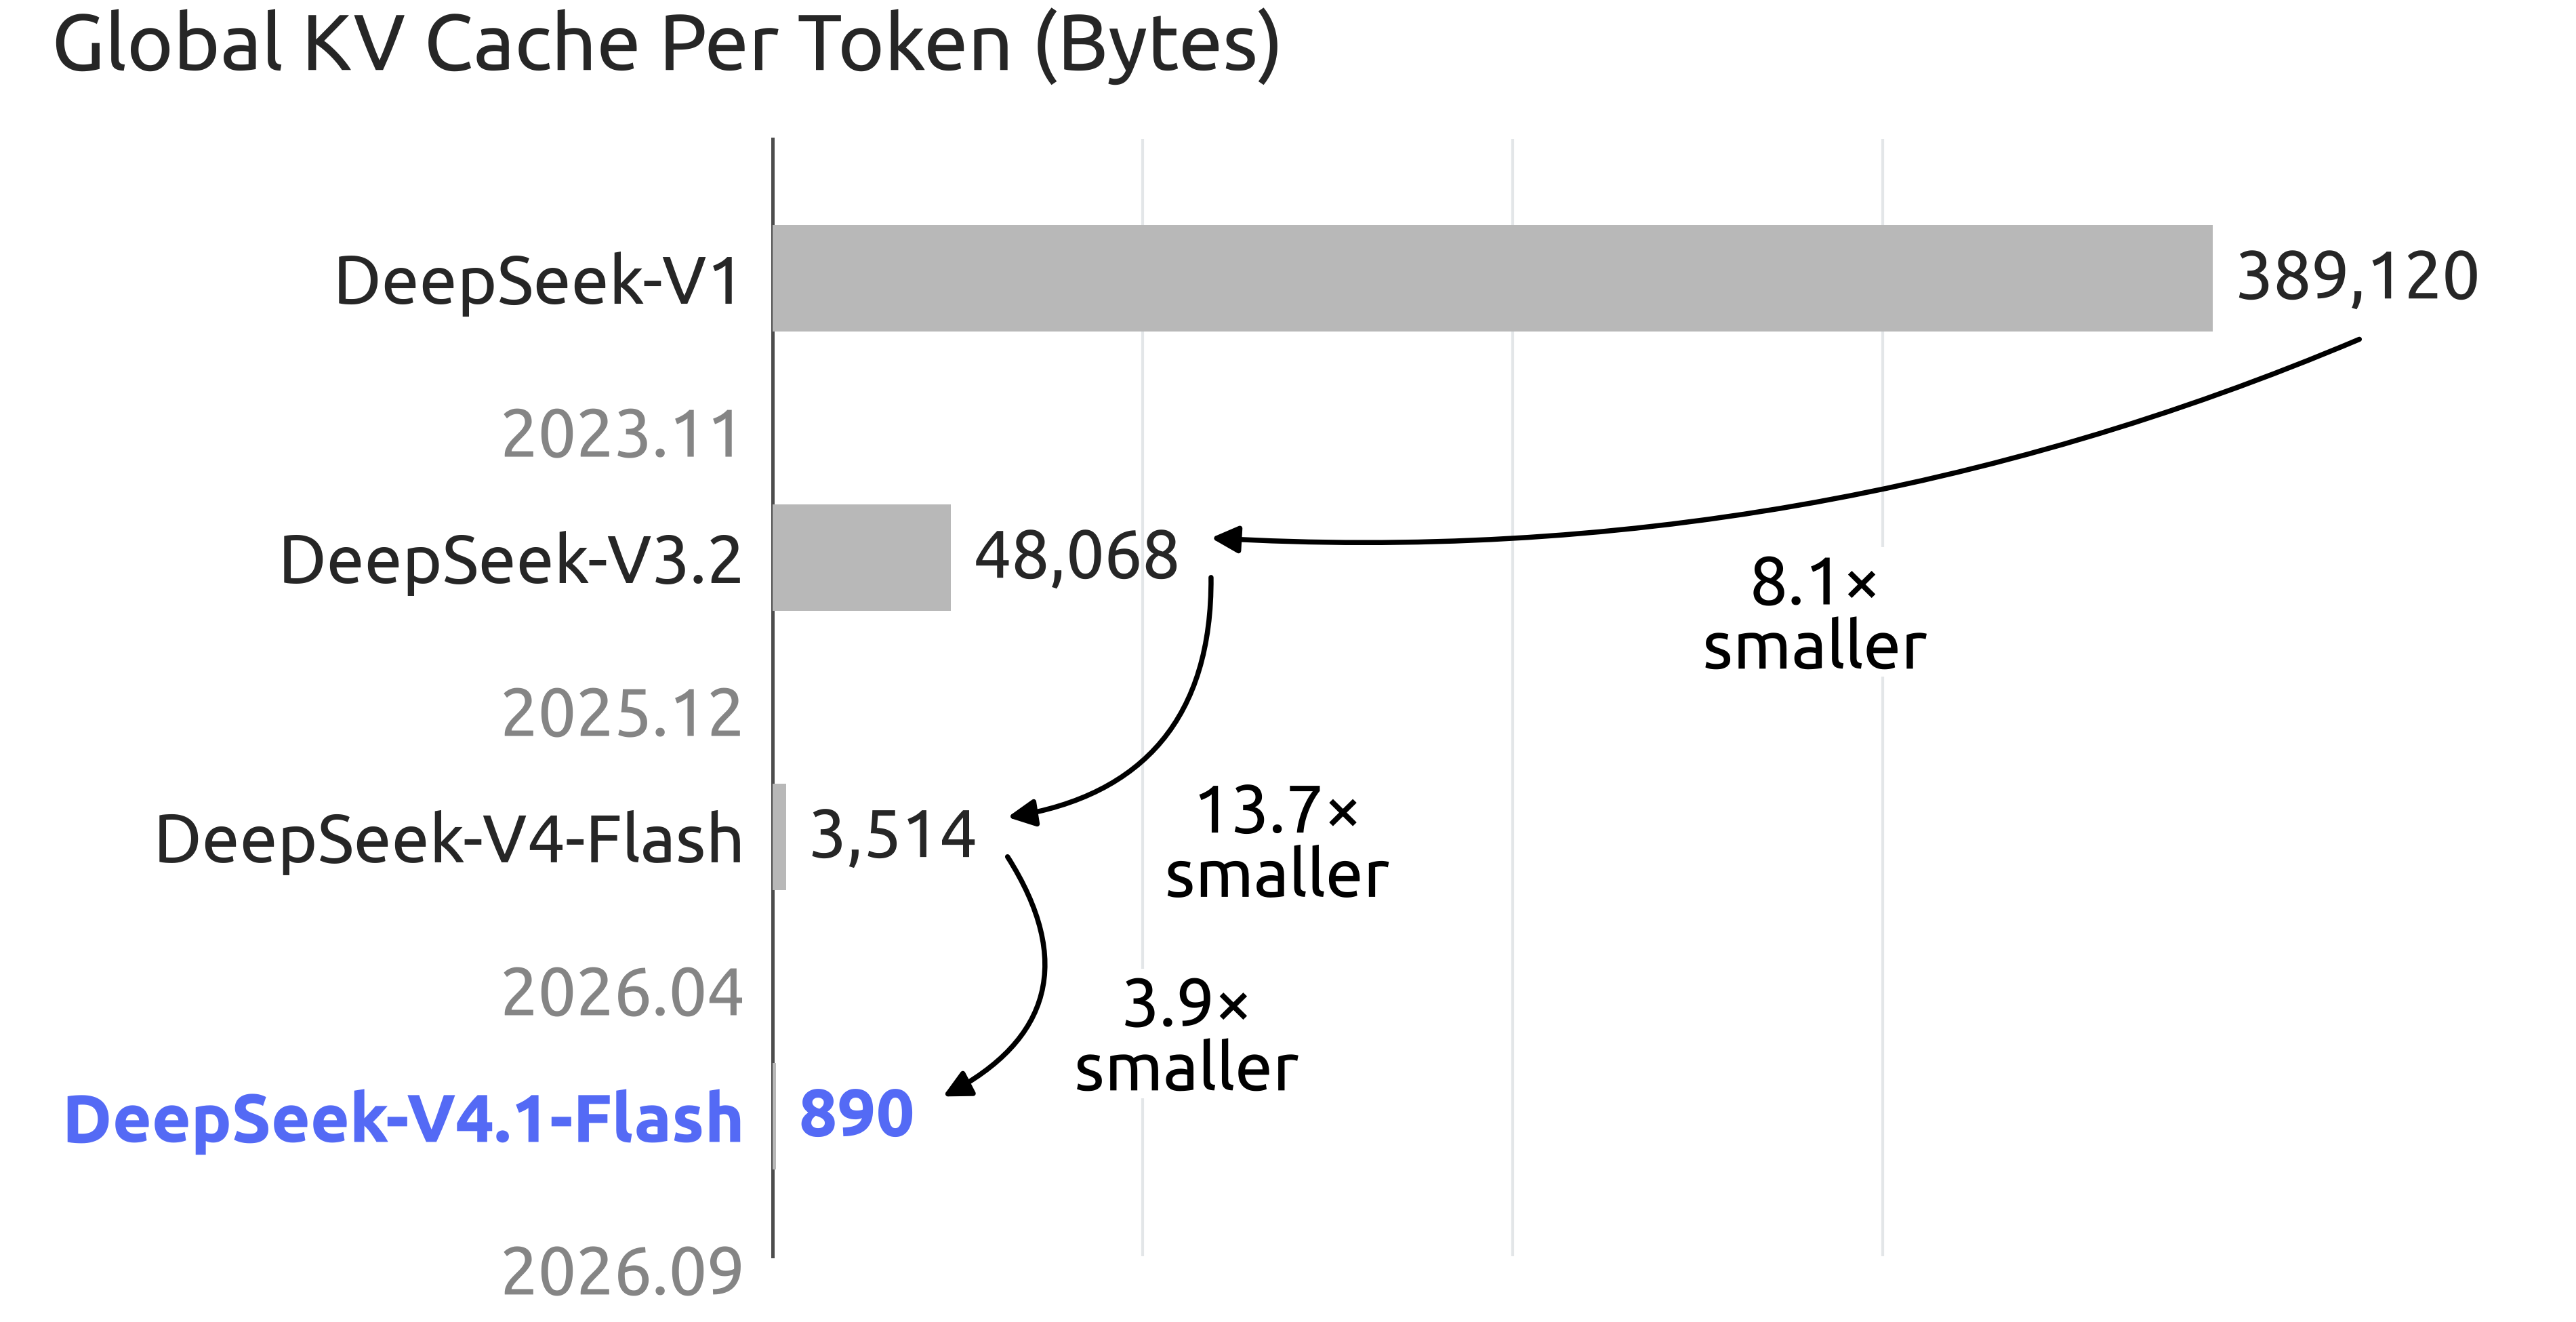
DeepSeek podaje też, że globalna pamięć podręczna KV to ok. 890 bajtów na token wobec 3 514 bajtów na token w poprzedniej generacji V4 Flash. Ta redukcja najbardziej pomaga długotrwałym agentom, którzy wielokrotnie wykorzystują duże prompty, schematy narzędzi i historię rozmowy.
How Strong Is DeepSeek V4.1 Flash for Coding and AI Agents?
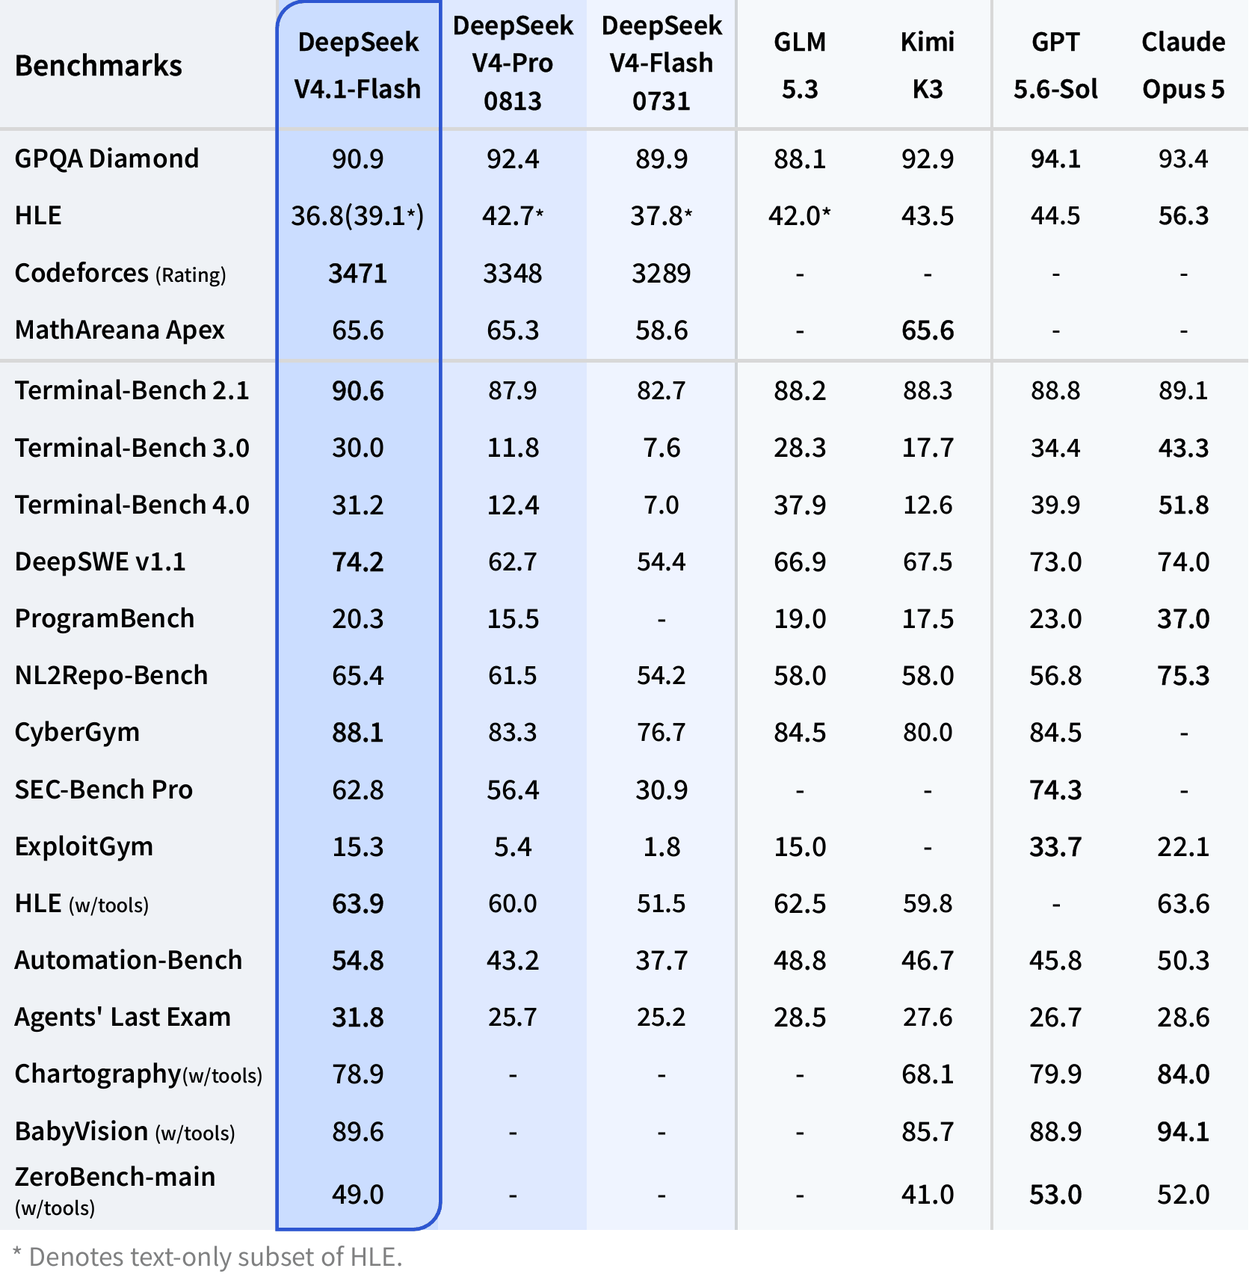
Ten przewodnik koncentruje się na dowodach z benchmarków, które bezpośrednio informują o wyborze API. DeepSeek charakteryzuje V4.1 Flash jako przewyższający modele flagowe, w tym V4 Pro, w swoim opublikowanym pakiecie ewaluacji. Najbardziej praktyczne zyski pojawiają się w pracy terminalowej, inżynierii oprogramowania, zadaniach na repozytoriach, automatyzacji i agentach wspomaganych narzędziami; zespoły produkcyjne powinny jednak zweryfikować model na własnych promptach i kryteriach ukończenia zadań.
Benchmark
DeepSeek V4.1 Flash
DeepSeek V4 Pro
DeepSeek V4 Flash
GPQA Diamond
90.9
92.4
89.9
Terminal-Bench 2.1
90.6
87.9
82.7
DeepSWE v1.1
74.2
62.7
54.4
NL2Repo-Bench
65.4
61.5
54.2
HLE with tools
63.9
60.0
51.5
Automation-Bench
54.8
43.2
37.7
Agents' Last Exam
31.8
25.7
25.2
Wniosek praktyczny jest węższy niż „V4.1 jest mądrzejszy”. DeepSeek V4.1 Flash jest szczególnie atrakcyjny przy powtarzalnym użyciu narzędzi, akcjach terminalowych, kodowaniu w skali repozytorium, automatyzacji i długich trajektoriach agentów. Czyste zadania wiedzy lub rozumowania mogą dawać inny ranking.
Why Use the DeepSeek V4.1 Flash API Through CometAPI?
Główna zaleta integracyjna polega na tym, że DeepSeek V4.1 Flash API w CometAPI można wywoływać tym samym wzorcem klienta zgodnym z OpenAI używanym dla innych modeli, co redukuje zmiany SDK w aplikacjach wielomodelowych.
Setting
Value
Base URL
https://api.cometapi.com/v1
Chat endpoint
/chat/completions
Model ID
deepseek-v4.1-flash
Authentication
Bearer API key
Python SDK
Zgodny z OpenAI SDK
JavaScript SDK
Zgodny z OpenAI SDK
To również pozwala uniknąć częstego błędu integracji: skopiowania identyfikatora z pierwszego API DeepSeek do żądania CometAPI. Trasy dostawców odnoszą się do tej samej rodziny modeli, ale udokumentowane identyfikatory modeli są inne.
Utwórz klucz API CometAPI, zapisz go w zmiennej środowiskowej i skonfiguruj bazowy URL zgodny z OpenAI jako https://api.cometapi.com/v1. Nie umieszczaj produkcyjnych poświadczeń w kodzie źródłowym.
Użyj identyfikatora modelu deepseek-v4.1-flash z użyciem standardowego endpointu Chat Completions.
curl "https://api.cometapi.com/v1/chat/completions"
  -H "Content-Type: application/json"
  -H "Authorization: Bearer ${COMETAPI_KEY}"
  -d '{
    "model": "deepseek-v4.1-flash",
    "messages": [
      {
        "role": "user",
        "content": "Explain three ways to reduce latency in a high-throughput API service."
      }
    ]
  }'
Pomyślna odpowiedź wykorzystuje znaną strukturę completion w stylu OpenAI, więc aplikacje już czytające choices[0].message.content wymagają minimalnej pracy migracyjnej.
Python SDK Example
pip install openai
``````python
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Write a Python retry helper with exponential backoff."
        }
    ],
)

print(response.choices[0].message.content)
W produkcji dodaj jawne limity czasu, ograniczone ponowienia, logowanie żądań i monitorowanie zużycia.
JavaScript SDK Example
npm install openai
``````js
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
});

const response = await client.chat.completions.create({
  model: "deepseek-v4.1-flash",
  messages: [
    {
      role: "user",
      content: "Create a typed rate limiter interface for an Express API."
    }
  ],
});

console.log(response.choices[0].message.content);
Abstrakcja klienta pozostaje niezmieniona, podczas gdy bazowy URL i identyfikator modelu stają się konfiguracją dostawcy.
DeepSeek V4.1 Flash API Features
Configure Reasoning and Thinking Mode
DeepSeek dokumentuje działanie zarówno z rozumowaniem, jak i bez niego. Kierując ruch przez CometAPI, zweryfikuj, że pola specyficzne dla dostawcy są przekazywane dokładnie zgodnie z oczekiwaniami, zanim oprzesz na nich kontrakt produkcyjny.
Przetestuj każdy obsługiwany poziom wysiłku względem własnych celów dla opóźnienia, zużycia tokenów i ukończenia zadania, ponieważ mapowanie dostawcy może się różnić.
Analyze Images with Vision Input
DeepSeek V4.1 Flash akceptuje obrazy JPEG, PNG, GIF i WebP. Oficjalne limity obejmują 32 MiB na obraz inline, 64 MiB na obraz plikowy, do 600 obrazów na żądanie oraz limit 8 192 znaków dla zewnętrznych URL obrazów. Obrazy należą do wiadomości użytkownika lub dewelopera, a nie systemu czy asystenta.
response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "Identify the three most important anomalies."},
                {
                    "type": "image_url",
                    "image_url": {"url": "https://example.com/dashboard.png"}
                }
            ]
        }
    ],
)
Zbadaj rozmiar obrazów, dostępność URL, preprocessing, użycie tokenów i opóźnienie na dokładnie tej trasie CometAPI, której użyjesz w produkcji.
Stream Responses with SSE
Strumieniowanie obniża postrzegane opóźnienie poprzez dostarczanie wyjścia inkrementalnego do interfejsów kodowania, czatu i agentów.
stream = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Explain distributed-cache invalidation."
        }
    ],
    stream=True,
)

for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
Klienci produkcyjni powinni obsługiwać przerwane strumienie, puste delty, odzyskiwanie po timeoutach, granice ponowień i końcowe rozliczanie zużycia.
How Much Does the DeepSeek V4.1 Flash API Cost?
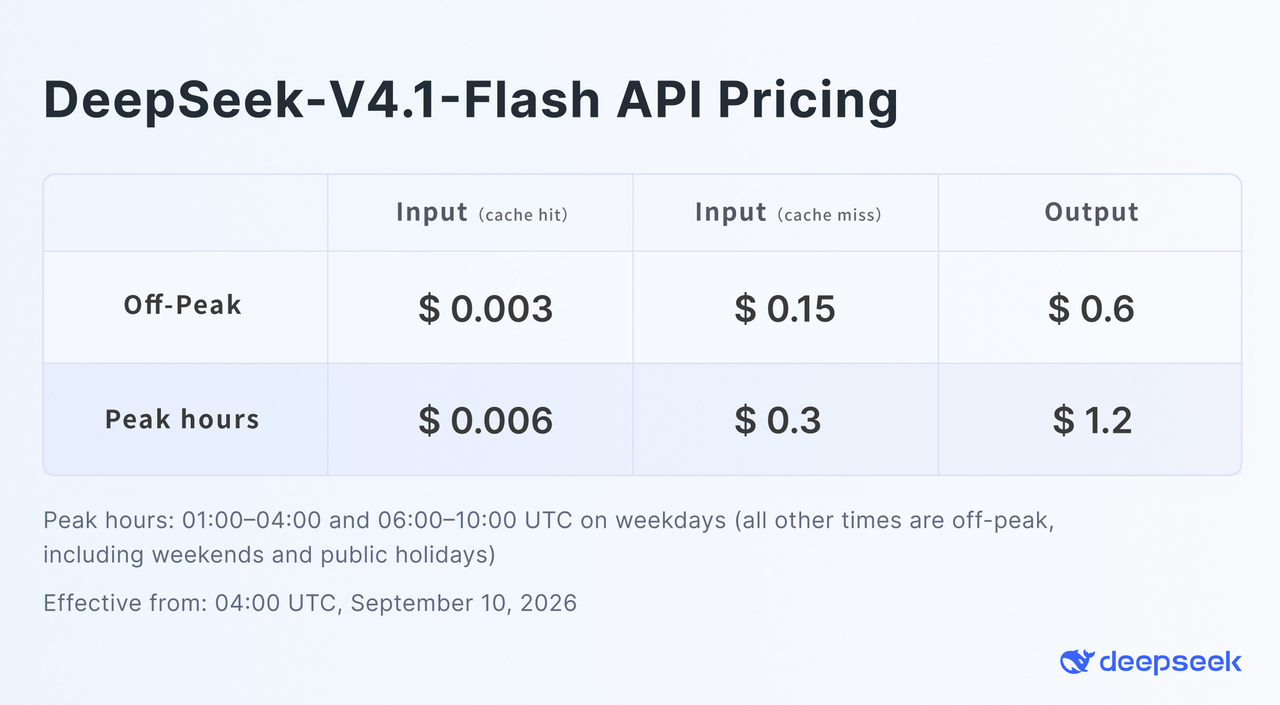
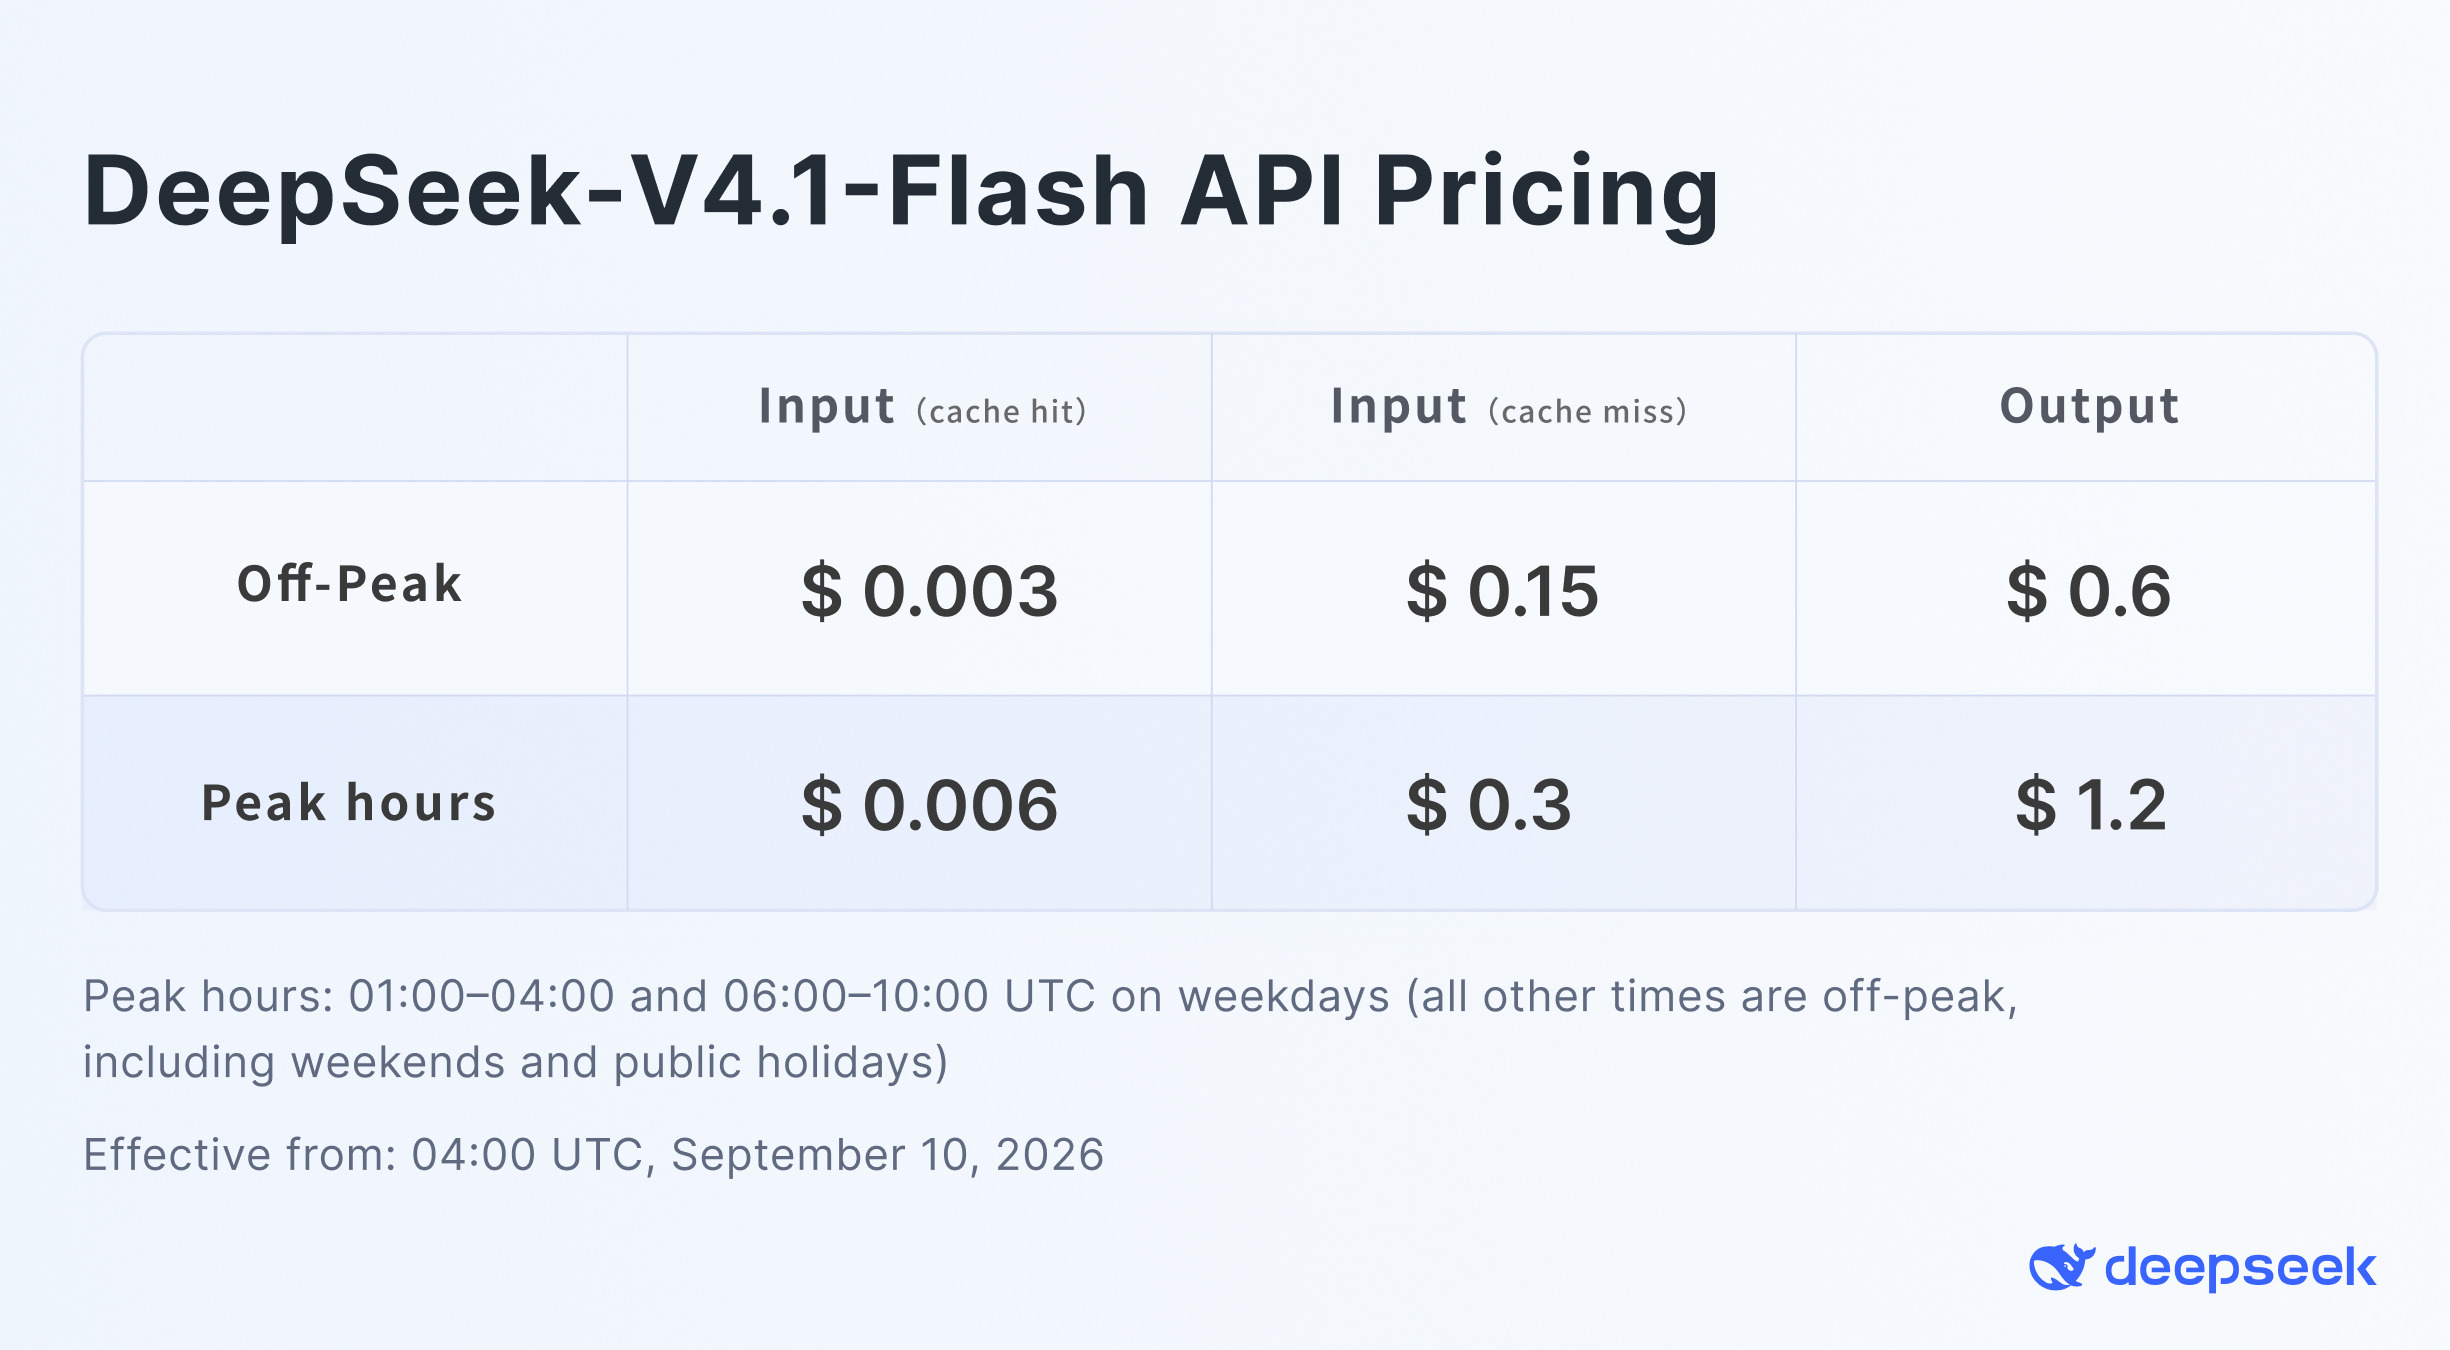
Udokumentowane ceny API DeepSeek wykorzystują okna szczytowe i poza szczytem. Oficjalny obraz cennika pokazuje stawki poza szczytem: $0.003/M za trafienie w cache (wejście), $0.15/M za chybienie w cache (wejście) i $0.60/M za wyjście; stawki w szczycie są dwukrotnie wyższe.
Prosty przykład stawek bazowych dla 100M tokenów wejściowych z chybień i 20M tokenów wyjściowych:
Input:
100 x $0.12 = $12.00

Output:
20 x $0.48 = $9.60

Total base cost:
$21.60
Rzeczywisty koszt produkcyjny zależy od miksu tokenów z cache, mnożników szczytu, warunków żądania i aktualnej stawki dostawcy. Duża różnica między ceną za trafienie i chybienie w cache sprawia, że stabilne, wielokrotnie używane prefiksy — instrukcje systemowe, schematy narzędzi i wspólny kontekst — są ważną dźwignią kosztową.
DeepSeek V4.1 Flash API vs V4 Pro vs V4 Flash
Dimension
DeepSeek V4.1 Flash
DeepSeek V4 Pro
DeepSeek V4 Flash
Primary positioning
Efektywne rozumowanie, agenci, wizja
Wysokiej klasy rozumowanie V4
Poprzednia szybka warstwa V4
Native vision
Tak
Zależne od modelu/trasy
Oddzielna trasa wizji w poprzedniej generacji
Thinking
Tak
Tak
Tak
Agent performance
Najsilniejszy z trzech w wielu opublikowanych testach agentów
stwierdza, że DeepSeek V4 Pro pozostaje dostępny po 14 września 2026 r. z niezmienionym rozliczaniem. Zweryfikuj aktualną dokumentację, zanim oprzesz się na zachowaniu routingu lub migracji.
What Should You Test Before Putting DeepSeek V4.1 Flash API into Production?
Routing modeli: potwierdź deepseek-v4.1-flash w CometAPI i trzymaj identyfikatory specyficzne dla dostawcy w konfiguracji, a nie w logice aplikacji.
Regresję promptów: uruchom reprezentatywne prompty produkcyjne i porównuj ukończenie zadań, a nie tylko wyniki benchmarków.
Strukturyzowane wyjście: waliduj każdą odpowiedź JSON względem schematu aplikacji i zdefiniuj ścieżkę naprawy lub ponowienia.
Wywołania narzędzi: testuj typy argumentów, błędne wywołania, wywołania równoległe i warunki zakończenia pętli.
Sterowanie rozumowaniem: zweryfikuj, które pola CometAPI przenosi i zmierz wpływ każdego ustawienia na opóźnienie i tokeny.
Wizja: testuj rzeczywiste zrzuty ekranu i dokumenty, w tym limity rozmiarów, niedostępne URL i nieobsługiwane role wiadomości.
Strumieniowanie: obsłuż puste delty, przerwane połączenia, granice ponowień i końcowe rozliczanie zużycia.
Długi kontekst i cache: zmierz jakość odpowiedzi, odsetek trafień cache i koszt wraz ze wzrostem długości promptu.
Niezawodność: rejestruj latencję p50, p95 i p99; przećwicz ścieżki 429, 5xx, timeout i fallback.
Kontrola kosztów: śledź tokeny wejścia, wejścia z cache, rozumowania i wyjścia na ukończone zadanie.
Dla obciążeń agentowych porównuj koszt na ukończone zadanie — nie tylko dolary za milion tokenów. Model może być droższy na token wyjściowy, a mimo to tańszy end-to-end, jeśli redukuje ponowienia i wywołania narzędzi; odwrotnie, wyższy wysiłek rozumowania może dodać tokeny bez poprawy ukończenia.
Is the DeepSeek V4.1 Flash API Worth Using?
Dla nowych integracji DeepSeek, DeepSeek V4.1 Flash jest mocnym domyślnym kandydatem w rodzinie Flash, ponieważ łączy lepszą opublikowaną wydajność agentową z natywną wizją i agresywnym cennikiem.
Jego najsilniejsze przypadki użycia to nie zwykły czat. Lepiej pasuje do agentów kodujących, zautomatyzowanej inżynierii oprogramowania, analizy w długim kontekście, asystentów multimodalnych, wysokowolumenowej automatyzacji przepływów pracy oraz agentów używających narzędzi, gdzie powtarzany kontekst może dominować w całkowitym koszcie.
Dla deweloperów, którzy chcą zachować architekturę SDK w stylu OpenAI, DeepSeek V4.1 Flash API w CometAPI oferuje wzorzec integracji użyty w całym tym przewodniku: zachowaj standardowy interfejs klienta, wskaż go na https://api.cometapi.com/v1 i użyj deepseek-v4.1-flash.
DeepSeek V4.1 Flash API FAQ
How should I organize provider-specific model IDs?
Przechowuj dostawcę, bazowy URL i identyfikator modelu razem w konfiguracji zależnej od środowiska. Zapobiega to przypadkowemu wysłaniu identyfikatora pierwszej strony, takiego jak deepseek-flash, do trasy CometAPI oczekującej deepseek-v4.1-flash.
How can I improve cache reuse in long-running agents?
Utrzymuj stabilne instrukcje systemowe, schematy narzędzi i wspólny kontekst referencyjny na początku promptu. Dodawaj zmienne dane użytkownika i wyniki narzędzi później, aby wielokrotnego użytku prefiks zmieniał się rzadziej.
What is the safest way to compare V4.1 Flash with V4 Pro?
Odegraj ten sam zestaw zadań produkcyjnych, ogranicz budżety ponowień i porównaj współczynnik ukończenia, opóźnienie, liczbę wywołań narzędzi oraz całkowite tokeny. Niższa cena za token nie gwarantuje niższego kosztu na udane zadanie.
What fallback policy should an agent use?
Zdefiniuj, które błędy podlegają ponowieniu, ustaw ścisły limit ponowień i wybierz model awaryjny dopiero po zachowaniu stanu narzędzia wymaganego do bezpiecznego wznowienia. Loguj każdy fallback, aby widoczny był cichy dryf jakości.
How should image inputs be validated before sending them?
Sprawdź rzeczywisty podpis pliku, obsługiwany format, rozmiar w bajtach, dostępność URL i rolę wiadomości. Usuń zbędne metadane i unikaj wysyłania wrażliwych obrazów, chyba że Twoje polityki retencji i dostępu wyraźnie na to pozwalają.
When should I consider the Responses API instead of Chat Completions?
Używaj Chat Completions, gdy utrzymujesz istniejący przepływ wiadomości zgodny z OpenAI. Rozważ Responses API, gdy aplikacja korzysta z typowanych elementów wejściowych, obrazów jako wyjścia narzędzi lub wyjścia JSON Schema, a następnie potwierdź, że wybrana trasa dostawcy obsługuje wymagane pola.
How should I handle schema validation failures?
Odrzucaj nieprawidłowe wyjście, zanim trafi do systemów downstream, rejestruj błąd walidacji i ponów próbę z ograniczonym promptem naprawczym. Jeśli powtarzana naprawa się nie powiedzie, przekieruj zadanie do bezpiecznego fallbacku zamiast akceptować wiarygodny, ale nieprawidłowy JSON.