Buduj z CometAPIPotrzebujesz jednego API dla wielu modeli?Przetestuj proces w Playground, a potem utwórz klucz API, gdy model i koszt pasują do Twojego zastosowania.
Cennik API Kimi K2 2026: koszty K2.7, Batch i WebSearch
Porównaj ceny API Kimi K2.7, K2.6 i K2.5, stawki pamięci podręcznej, oszczędności Batch, opłaty za WebSearch, ceny CometAPI oraz rzeczywiste koszty agenta programistycznego.
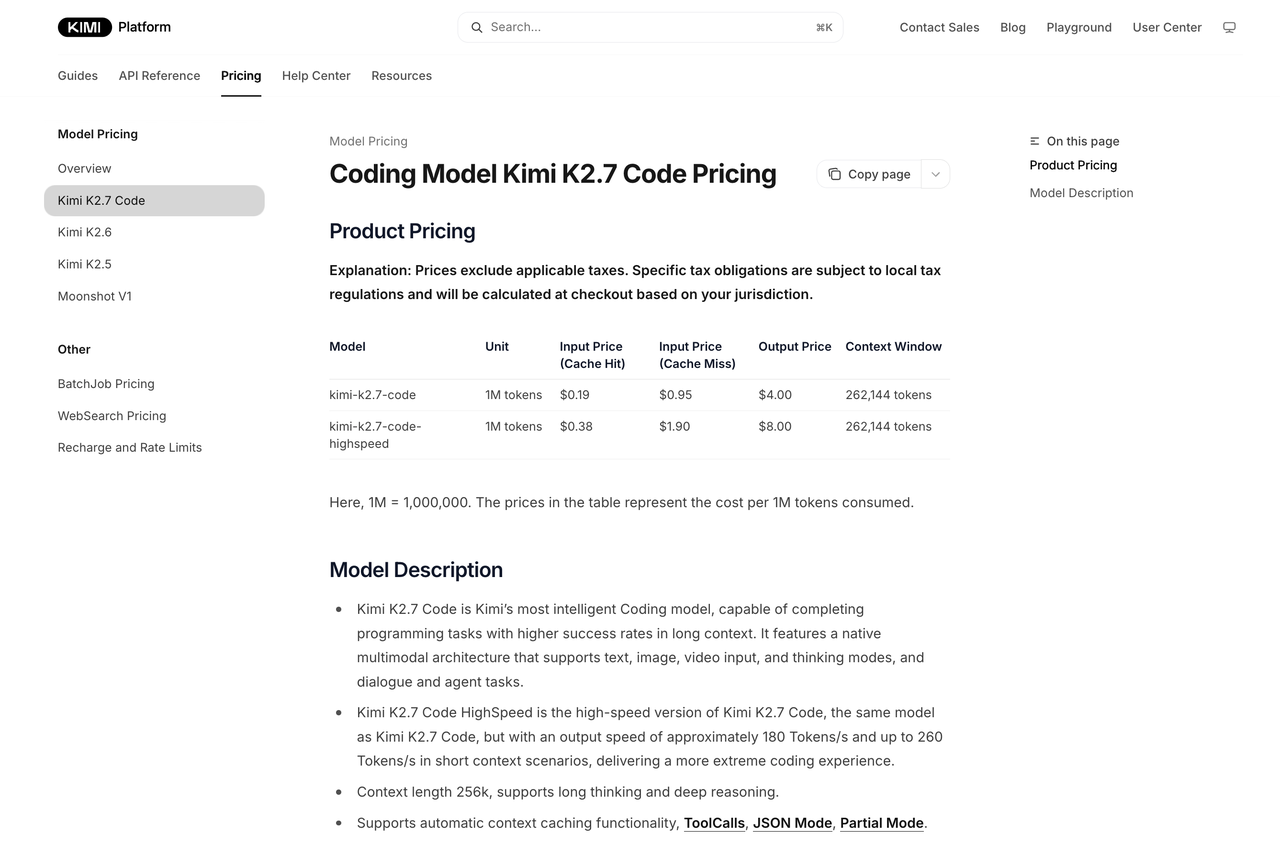
TL;DR Moonshot AI obecnie wycenia Kimi K2.7 Code na $0.19 za 1M tokenów wejściowych z trafieniem w cache, $0.95 za 1M tokenów wejściowych z brakiem trafienia w cache oraz $4.00 za 1M tokenów wyjściowych. Kimi K2.7 Code HighSpeed podwaja te stawki do $0.38 / $1.90 / $8.00.
Główne kwestie kosztowe:
Buforowanie (Caching): w K2.7 tokeny wejściowe z trafieniem w cache są o 80% tańsze niż tokeny z brakiem trafienia.
HighSpeed: szybsza trasa kosztuje dwukrotnie więcej na poziomie tokenów.
wspierane modele kosztują 60% stawek czasu rzeczywistego, co odpowiada oszczędności 40%.
Sprawdzone pod kątem przejrzystości, atrybucji źródeł i aktualnej terminologii API.
Batch API:
WebSearch: Moonshot pobiera $0.005 za każde udane wywołanie wbudowanego wyszukiwania, plus tokeny użyte do przetwarzania wyników.
Zgodność: K2.7 Code wymaga trybu Thinking, podczas gdy wbudowany WebSearch Moonshot wymaga wyłączonego Thinking.
Dla agentów kodujących najbardziej użyteczną metryką nie jest cena za milion tokenów, lecz koszt za ukończone zadanie, uwzględniający rozumowanie, cache, ponowienia, wywołania narzędzi, opóźnienia i poprawki ludzkie.
Wejście z brakiem trafienia w cache lub standardowe
Wyjście
Kontekst
Moonshot K2.7 Code
$0.19 / 1M
$0.95 / 1M
$4.00 / 1M
256K
Moonshot K2.7 Code HighSpeed
$0.38 / 1M
$1.90 / 1M
$8.00 / 1M
256K
Moonshot K2.6
$0.16 / 1M
$0.95 / 1M
$4.00 / 1M
256K
Moonshot K2.5
$0.10 / 1M
$0.60 / 1M
$3.00 / 1M
256K
CometAPI K2.7 Code
Nie wyszczególniono osobno
$0.76 / 1M
Około $3.20 / 1M
256K
Ceny K2.7 Moonshot są obecnie promocyjne. Moonshot i CometAPI stosują też różne struktury rozliczania wejścia, więc podane stawki nie powinny być porównywane bezpośrednio.
Wyjaśnienie cennika Moonshot Kimi K2
K2.7 Code i K2.6 mają te same ceny wejścia z brakiem trafienia w cache i wyjścia. Główne różnice na poziomie tokenów to nieco wyższa opłata K2.7 Code za wejście z cache, podczas gdy HighSpeed podwaja wszystkie stawki K2.7.
Model
Najlepiej nadaje się do
kimi-k2.7-code
Agenci kodujący, edycje repozytoriów i długohoryzontalne zadania inżynierskie
kimi-k2.7-code-highspeed
Interaktywne kodowanie, gdzie niższa latencja ma mierzalną wartość
kimi-k2.6
Ogólne rozumowanie multimodalne, agenci i wbudowany WebSearch
kimi-k2.5
Tańsze ogólne i multimodalne obciążenia
Moonshot opisuje HighSpeed jako ten sam bazowy model K2.7 Code serwowany przez szybszą trasę. Udokumentowana prędkość wyjścia to około 180 tokenów na sekundę, do 260 tokenów na sekundę w scenariuszach z krótszym kontekstem. Pojemność może się wahać, gdy Moonshot rozszerza zasoby.
HighSpeed to zatem przede wszystkim wybór związany z opóźnieniem, a nie odrębny poziom jakości modelu.
Alternatywa dla bezpośredniego API Moonshot: CometAPI
Deweloperzy mogą uzyskać dostęp do Kimi K2.7 Code bezpośrednio przez Moonshot AI lub przez kompatybilne z OpenAI API CometAPI.
Sposób dostępu
Wejście standardowe
Wejście z cache
Wyjście
Bezpośrednie API Moonshot
$0.95 / 1M cache miss
$0.19 / 1M
$4.00 / 1M
CometAPI
$0.76 / 1M
Nie wyszczególniono
Około $3.20 / 1M
Podane ceny wejścia i wyjścia CometAPI są o około 20% niższe, podczas gdy Moonshot może być bardziej opłacalny przy obciążeniach z wysokim współczynnikiem trafień w cache.
Wybierz CometAPI, jeśli chcesz jednego API dla Kimi i innych dostawców modeli. Wybierz bezpośredni dostęp Moonshot, jeśli Twój przepływ pracy często ponownie wykorzystuje te same prompty lub kontekst repozytorium.
Przy obecnie podanych stawkach CometAPI jest około 20% tańsze niż ceny Moonshot dla wejścia z brakiem trafienia w cache i wyjścia.
Jednak CometAPI nie pokazuje osobnej ceny za trafienie w cache na stronie modelu K2.7. Jego cena standardowego wejścia $0.76 nie powinna być porównywana bezpośrednio ze stawką $0.19 za wejście z cache w Moonshot.
Zespoły, które wielokrotnie ponownie używają długich promptów systemowych, definicji narzędzi lub kontekstu repozytorium, powinny przetestować obie trasy na swoim rzeczywistym ruchu. Obciążenie z bardzo wysokim udziałem trafień w cache może dać inny wynik niż takie, które wysyła głównie nowy kontekst.
Kimi rozlicza tokeny wejściowe jako trafienia w cache lub braki trafień.
Braki trafień zazwyczaj obejmują nową lub zmodyfikowaną treść, taką jak:
nowe pliki repozytorium
zaktualizowane instrukcje
świeże wyniki narzędzi
zmieniająca się historia rozmowy
Trafienia mogą obejmować treści powtarzalne, takie jak stabilne prompty systemowe, schematy narzędzi, konwencje kodowania i niezmieniony kontekst repozytorium.
Dla K2.7 Code wejście z cache kosztuje $0.19 za 1M tokenów w porównaniu z $0.95 za wejście bez cache. Oznacza to, że token z trafieniem w cache jest o 80% tańszy.
Policzenie tych samych 1M tokenów w całości po stawce braku trafienia kosztowałoby $0.95. W tym przykładzie mieszany profil cache obniża koszt wejścia o $0.608.
Dlatego pulpity produkcyjne powinny rejestrować osobno tokeny z trafieniem i z brakiem trafienia w cache zamiast raportować jedynie całkowite wykorzystanie wejścia.
Cennik Kimi Batch API
Batch API Moonshot kosztuje 60% odpowiadającej mu ceny modelu czasu rzeczywistego, co daje zespołom 40% oszczędności w obsługiwanych zadaniach asynchronicznych. Obecna dokumentacja wymienia K2.7 Code, K2.6 i K2.5 jako wspierane modele Batch.
Model Batch
Wejście z trafieniem w cache
Wejście z brakiem trafienia
Wyjście
kimi-k2.7-code
$0.114 / 1M
$0.57 / 1M
$2.40 / 1M
kimi-k2.6
$0.096 / 1M
$0.57 / 1M
$2.40 / 1M
kimi-k2.5
$0.06 / 1M
$0.36 / 1M
$1.80 / 1M
Batch API dobrze sprawdza się w:
analizie kodu na poziomie repozytorium
dużych przebiegach ewaluacyjnych
klasyfikacji offline
nocnym wzbogacaniu
generowaniu syntetycznych testów
analizie migracji
zaległościach przeglądów bezpieczeństwa
Jest mniej odpowiednie dla asystentów IDE, czatu na żywo i innych przepływów, w których użytkownik czeka na natychmiastową odpowiedź.
Dla przetwarzania w tle oszczędność 40% może być cenniejsza niż przełączenie na tańszy model o niższym współczynniku ukończenia zadań.
Cennik i kompatybilność Kimi WebSearch
Moonshot pobiera $0.005 za każde udane wywołanie wbudowanego$web_search. Nie ma osobnej opłaty narzędziowej, gdy model kończy bez uruchomienia narzędzia wyszukiwania.
Treść wyników wyszukiwania może zostać dodana do następnego żądania modelu i jest rozliczana jako tokeny wejściowe. Moonshot definiuje wynikowe obliczenie tokenów jako:
Kompletny przebieg wyszukiwania może zatem obejmować:
Initial model request
+ WebSearch tool fee
+ search-result input tokens
+ follow-up model request
+ retries
Istnieje też istotne ograniczenie modelu. Wbudowany WebSearch Moonshot wymaga wyłączonego Thinking, podczas gdy K2.7 Code nie obsługuje trybu bez Thinking. Oficjalny przykład WebSearch używa zatem K2.6 z wyłączonym Thinking.
Dla wbudowanego wyszukiwania Moonshot używaj K2.6 lub K2.5 z wyłączonym Thinking.
Agent kodujący na K2.7 nadal może wywołać niezależnie zaimplementowaną usługę wyszukiwania poprzez zwykłe wywołania funkcji. W takim przypadku cena wyszukiwania jest określana przez zewnętrznego dostawcę, a nie przez wbudowaną opłatę Moonshot $0.005.
Przykład 1: koszt K2.7 Code dla zadania programistycznego
Załóżmy, że przepływ pracy agenta kodującego używa:
30,000 tokenów wejściowych z brakiem trafienia w cache
8,000 tokenów wyjściowych, w tym rozumowania
brak wbudowanego wywołania WebSearch
Standardowe K2.7 Code
Składnik
Obliczenie
Koszt
Wejście
30,000 ÷ 1M × $0.95
$0.03
Wyjście
8,000 ÷ 1M × $4.00
$0.03
Suma
$0.06
K2.7 Code HighSpeed
Składnik
Obliczenie
Koszt
Wejście
30,000 ÷ 1M × $1.90
$0.06
Wyjście
8,000 ÷ 1M × $8.00
$0.06
Suma
$0.12
Dla tego samego użycia tokenów HighSpeed kosztuje dokładnie dwa razy więcej.
CometAPI K2.7 Code
Przy aktualnych stawkach CometAPI:
Składnik
Obliczenie
Koszt
Wejście
30,000 ÷ 1M × $0.76
$0.02
Wyjście
8,000 ÷ 1M × $3.19998
Około $0.0256
Suma
Około $0.0484
To około 20% poniżej kosztu $0.0605 tokenów z brakiem trafienia w cache Moonshot w tym przykładzie. Obliczenie nie obejmuje podatków, narzędzi zewnętrznych ani innych usług platformowych.
Przykład 2: K2.6 z wbudowanym WebSearch
Załóżmy, że przepływ pracy K2.6 z wyłączonym Thinking używa:
30,000 tokenów wejściowych z brakiem trafienia w cache w całym przebiegu
8,000 tokenów wyjściowych
jednego udanego wbudowanego wywołania WebSearch
Te 30,000 tokenów wejściowych obejmuje treści wyników wyszukiwania przeniesione do kolejnego żądania.
Składnik
Obliczenie
Koszt
Wejście
30,000 ÷ 1M × $0.95
0.0285
Wyjście
8,000 ÷ 1M × $4.00
0.0320
WebSearch
1 × $0.005
0.0050
Suma
0.0655
W tym przykładzie bezpośrednia opłata WebSearch stanowi około 7.6% całości. W dłuższych przebiegach badawczych tokeny dodane przez wyniki wyszukiwania mogą kosztować więcej niż samo wywołanie narzędzia.
Szczegóły inżynieryjne, które mogą zmienić końcowy rachunek
K2.7 Code zwraca błąd, jeśli Thinking jest wyłączony. Jego rozumowanie zwracane jest przez reasoning_content, a zarówno rozumowanie, jak i widoczna odpowiedź wpływają na wykorzystanie tokenów.
Podczas wieloetapowych wywołań narzędzi aplikacje muszą zachowywać reasoning_content asystenta w kontekście rozmowy. Dłuższe pętle agenta mogą zatem zwiększyć zarówno bieżące użycie wyjściowe, jak i późniejsze użycie wejściowe.
max_tokens to limit, a nie stała opłata
Parametr max_tokens definiuje maksymalną liczbę, którą model może wygenerować. Wyższe ustawienie daje modelowi dość miejsca na ukończenie rozumowania i odpowiedzi, ale pełna rezerwa nie jest automatycznie rozliczana.
Koszty bazują na faktycznie przetworzonych i wygenerowanych tokenach.
Kilka parametrów zapytania jest stałych
K2.7 Code wymaga stałych wartości dla kilku parametrów:
Parametr
Wymagana wartość
temperature
1
top_p
0.95
n
1
presence_penalty
0
frequency_penalty
0
Podanie innej wartości może zwrócić błąd. Aplikacje używające tego samego wrappera kompatybilnego z OpenAI u wielu dostawców powinny sprawdzić zakodowane na sztywno domyślne wartości przed przełączeniem modeli.
GitHub udostępnił Kimi K2.7 Code w Copilot powszechnie 1 lipca 2026 r., opisując go jako pierwszy model open-weight oferowany w selektorze modeli Copilot. Dostępność początkowo obejmowała plany indywidualne i została rozszerzona na plany Business i Enterprise 7 lipca.
Adopcja przez GitHub jest użytecznym sygnałem dystrybucyjnym, ale nie dowodzi, że K2.7 przewyższy inne modele w każdym obciążeniu związanym z kodowaniem.
Moonshot publikuje Kimi K2.7 Code na Hugging Face na podstawie zmodyfikowanej licencji MIT. Karta modelu opisuje architekturę mixture-of-experts z 1 bilionem parametrów i 32 miliardami aktywowanych parametrów oraz oknem kontekstu 256K. Zawiera także instrukcje wdrożeniowe dla frameworków takich jak Transformers, vLLM i SGLang.
Moonshot raportuje około 30% niższe zużycie tokenów thinking niż w K2.6 oraz 10% poprawę zdolności agentowych. To wyniki zgłaszane przez dostawcę i należy je zweryfikować na niezależnych obciążeniach.
Dyskusja na Hacker News jest bardziej zróżnicowana niż materiały premierowe. Niektórzy deweloperzy skupiają się na dostępności open-weight Kimi, efektywności tokenów i integracji z narzędziami agentów kodujących. Inni argumentują, że niższa cena tokenów nie gwarantuje niższego kosztu projektu, jeśli model wymaga większej liczby ponowień, nadzoru lub kontekstu.
Ta debata wspiera główną rekomendację tego przewodnika: porównuj modele na prawdziwych repozytoriach i mierz ukończenie zadań, ponowienia i poprawki ludzkie — nie tylko reklamowane stawki tokenów.
DeepSeek V4 Pro obecnie podaje okno kontekstu 1M z wejściem z trafieniem w cache w cenie $0.003625, wejściem z brakiem trafienia w cache $0.435 i wyjściem $0.87 za milion tokenów.
Wstępna stawka Claude Sonnet 5 to $2 za milion tokenów wejściowych, $0.20 za milion tokenów odczytu z cache i $10 za milion tokenów wyjściowych do 31 sierpnia 2026 r. Zapisy do cache są wyceniane osobno, a Anthropic zauważa, że nowszy tokenizator modelu może generować więcej tokenów dla tego samego tekstu niż wcześniejsze modele Claude.
Standardowa stawka GPT-5.6 Sol dla krótkiego kontekstu to $5 za milion tokenów wejściowych, $0.50 za milion tokenów wejściowych z cache i $30 za milion tokenów wyjściowych. OpenAI podaje również oddzielne stawki za zapis do cache, długi kontekst, Batch, Flex i Priority.
Przy podanych stawkach za token Kimi K2.7 Code jest tańszy niż Claude Sonnet 5 i GPT-5.6 Sol, podczas gdy DeepSeek V4 Pro jest tańszy jeszcze bardziej. Nie przesądza to jednak, który model zapewni najniższy koszt dla konkretnego przepływu kodowania.
Który model Kimi wybrać?
Typ zadania
Zalecany punkt wyjścia
Edycje repozytorium i długie zadania kodowe
kimi-k2.7-code
Interaktywne kodowanie, gdzie liczy się latencja
kimi-k2.7-code-highspeed
Ogólne rozumowanie multimodalne i agenci
kimi-k2.6
Wbudowany WebSearch Moonshot
kimi-k2.6 lub kimi-k2.5 z wyłączonym Thinking
Tańsze obciążenia ogólne
kimi-k2.5
Ewaluacje offline i przetwarzanie wsadowe
Batch API
K2.7 Code to naturalny punkt wyjścia dla zadań kodowania wrażliwych na jakość. HighSpeed warto testować, gdy szybsze odpowiedzi poprawiają doświadczenie dewelopera, konwersję lub przepustowość.
K2.6 jest bardziej elastyczny dla ogólnych, multimodalnych i opartych na wyszukiwaniu przepływów, podczas gdy K2.5 ma najniższe standardowe stawki tokenów Kimi.
Jak ocenić rzeczywisty koszt
Zbuduj zestaw ewaluacyjny z zadań produkcyjnych zamiast polegać wyłącznie na publicznych benchmarkach.
Przydatne przypadki testowe obejmują:
implementację funkcji na poziomie repozytorium
przegląd pull requestów
debugowanie i generowanie testów
analizę kodu w długim kontekście
wieloetapowe wywołania narzędzi
wsparcie deweloperskie oparte na wyszukiwaniu
Śledź:
ukończenie zadań
współczynnik trafień w cache
tokeny wejściowe i wyjściowe
wolumen tokenów thinking
skuteczność wywołań narzędzi
liczbę ponowień
latencję p50 i p95
poprawki ludzkie
całkowity koszt przepływu
Oblicz:
Cost per completed task =
total workflow cost ÷ successfully completed tasks
Na przykład, jeśli zespół wyda $10 i pomyślnie ukończy 80 zadań:
Cost per completed task = $10 ÷ 80 = $0.125
Model z tańszymi tokenami może wciąż kosztować więcej, jeśli wymaga wielokrotnych prób, dłuższego rozumowania lub rozległych poprawek ręcznych.
Przykłady routingu, fallbacków i ewaluacji znajdziesz w CometAPI Cookbook.
Najczęściej zadawane pytania
Ile kosztuje Kimi K2.7 Code?
Moonshot obecnie podaje dla K2.7 Code:
$0.19 za 1M tokenów wejściowych z trafieniem w cache
$0.95 za 1M tokenów wejściowych z brakiem trafienia w cache
$4.00 za 1M tokenów wyjściowych
Stawki są oznaczone jako promocyjne na czas ograniczony.
Ile kosztuje K2.7 Code przez CometAPI?
CometAPI obecnie podaje $0.76 za 1M tokenów wejściowych i $3.19998 za 1M tokenów wyjściowych.
Osobna stawka za trafienie w cache nie jest pokazana na stronie modelu.
Czy Kimi Batch API obniża koszty i czy obsługuje K2.7 Code?
Tak. Wnioskowanie wsadowe kosztuje 60% ceny czasu rzeczywistego, co odpowiada 40% oszczędności.
Aktualna dokumentacja Batch Moonshot wymienia K2.7 Code, K2.6 i K2.5 jako wspierane modele.
Ile kosztuje Kimi WebSearch?
Wbudowane $web_search kosztuje $0.005 za każde udane wywołanie.
Treść wyników wyszukiwania może być też rozliczana jako tokeny wejściowe, gdy zostanie dodana do następnego żądania modelu.
Czy można wyłączyć Thinking w K2.7 Code?
Nie. Żądania z wyłączonym Thinking zwracają błąd.
Czy Kimi jest kompatybilny z OpenAI?
Tak. Moonshot dokumentuje kompatybilność z formatem API OpenAI, chociaż dla Thinking, parametrów i wieloetapowych wywołań narzędzi nadal obowiązują specyficzne dla modelu ograniczenia.
Przetestuj Kimi K2.7 Code z CometAPI
Kimi K2.7 Code oferuje konkurencyjne ceny dla obciążeń agentów kodujących, ale najlepsza trasa zależy od czegoś więcej niż reklamowana stawka za token.
Przed wyborem dostawcy porównaj:
Total workflow cost =
tokens + retries + tools + latency + human correction
CometAPI pozwala deweloperom testować Kimi obok GPT, Claude, Gemini, DeepSeek, Grok i innych rodzin modeli w ujednoliconym przepływie API.