

TL;DR
MiMo-V2.5 to mocniejszy domyślny wybór do pracy multimodalnej, rutynowych agentów i produkcji wrażliwej na koszty. MiMo-V2.5-Pro to opcja specjalistyczna do trudnego rozumowania, kodowania na poziomie repozytorium i długotrwałego korzystania z narzędzi. Oba oferują okno kontekstu 1M tokenów i do 128K tokenów wyjściowych, ale Pro używa znacznie większego językowego backbone’u i kosztuje około 3.1× więcej za zwykłe tokeny wejścia i wyjścia.
MiMo-V2.5 vs. Pro: szybka decyzja
| Specyfikacja — oficjalne wydanie | MiMo-V2.5 | MiMo-V2.5-Pro | Rekomendowany model | Powód |
|---|---|---|---|---|
| Pozycjonowanie główne | Model wielomodalny i wydajne agenty | Flagowy agent i złożone programowanie | Wybór zależny od zadań | Wejścia multimodalne przemawiają za V2.5; trwałe trudne prace tekstowe za Pro. |
| Architektura | Sparse MoE | Sparse MoE | Wybór zależny od zadań | Sama wielkość modelu nie gwarantuje lepszego wyboru dla każdego zadania. |
| Łączna liczba parametrów | 310B | 1.02T | Wybór zależny od zadań | Większy model celuje w trudne rozumowanie, ale rozmiar nie jest wynikiem zadania. |
| Aktywowane parametry | 15B | 42B | Wybór zależny od zadań | Decyduj według ukończenia zadania i kosztu. |
| Warstwy LLM | 48 | 70 | Wybór zależny od zadań | Liczba warstw opisuje architekturę, nie jest uniwersalną przewagą. |
| Routowani eksperci | 256 | 384 | Wybór zależny od zadań | Różnica ma znaczenie tylko, jeśli poprawia docelowe obciążenie. |
| Eksperci aktywowani na token | 8 | 8 | Oba | Oba aktywują ośmiu ekspertów na token. |
| Okno kontekstu | 1M tokenów | 1M tokenów | Oba | Oba reklamują okno 1M tokenów; przetestuj skuteczne pozyskiwanie. |
| Maksymalna długość wyjścia | 128K tokenów | 128K tokenów | Oba | Oba reklamują do 128K tokenów wyjściowych. |
| Tryby wejścia | Tekst, obraz, wideo i audio | Tekst | MiMo-V2.5 | Akceptuje obraz, wideo i audio; Pro skupia się na tekście. |
| Wywoływanie narzędzi | Tak | Tak | Wybór zależny od zadań | Oba wywołują narzędzia; sprawdź skuteczność na faktycznej trajektorii. |
| Otwarte wagi i licencja | Tak; MIT | Tak; MIT | Oba | Oba oferują otwarte wagi (MIT); koszty serwowania się różnią. |
Różnica rozstrzygająca: multimodalność vs agent-first
V2.5 natywnie przyjmuje tekst, obrazy, wideo i audio. Xiaomi łączy językowy backbone z 729M-parametrowym enkoderem wizji i 261M-parametrowym enkoderem audio, dzięki czemu informacje multimodalne uczestniczą bezpośrednio w tym samym przepływie rozumowania.
- Analizuj zrzuty ekranu przed wywołaniem narzędzi.
- Rozumiej wideo i jego ścieżkę audio łącznie.
- Wydobywaj informacje z diagramów i obrazów dokumentów.
- Obsługuj agentów z interfejsem wizualnym i wsparciem multimodalnym.
- Wnioskuj nad długimi sekwencjami wideo.
V2.5-Pro podąża innym projektem. Xiaomi obecnie określa tekst jako tryb wejścia i podkreśla głębokie rozumowanie, rozwój kodu oraz długotrwałą orkiestrację narzędzi.
Jeśli przepływ pracy zawiera wejście obrazowe, wideo lub audio, zacznij od V2.5. Testuj Pro, gdy trudna część polega na rozumowaniu nad tekstem, kodem źródłowym, narzędziami lub długą trajektorią agenta.

Oficjalne porównanie benchmarków multimodalnych Xiaomi.
Dlaczego V2.5-Pro może być lepszy w trudnych zadaniach
Skala modelu: 310B/15B vs. 1.02T/42B
Oba modele używają rzadkiego Mixture-of-Experts (MoE), hybrydowej uwagi sliding-window i globalnej oraz trzech modułów Multi-Token Prediction. Karta modelu V2.5 dokumentuje 310B łącznie i 15B aktywnych parametrów; karta modelu Pro zwiększa to do 1.02T łącznie i 42B aktywowanych na token.
| Architektura — oficjalna karta modelu | V2.5 | Pro | Różnica |
|---|---|---|---|
| Łączna liczba parametrów | 310B | 1.02T | Około 3.3× |
| Aktywowane parametry | 15B | 42B | 2.8× |
| Rozmiar ukrytej reprezentacji | 4,096 | 6,144 | 1.5× |
| Warstwy LLM | 48 | 70 | +22 |
| Głowy uwagi | 64 | 128 | 2× |
| Routowani eksperci | 256 | 384 | 1.5× |
| Eksperci na token | 8 | 8 | Takie samo |
| Warstwy MTP | 3 | 3 | Takie samo |
V2.5 używa wzoru uwagi 5:1, podczas gdy Pro przechodzi na wzór lokalno-globalny 6:1. Xiaomi podaje, że projekty te redukują wymagania KV-cache niemal 6× i 7× odpowiednio względem pełnej uwagi w całej sieci.
Łączna liczba parametrów nie przekłada się liniowo na jakość odpowiedzi. Większy backbone Pro ma największe znaczenie, gdy trudność rozumowania lub długość trajektorii sprawia, że niewielkie zyski niezawodności na krok kumulują się.
Dlaczego niewielkie zyski w niezawodności się kumulują
Długie zadanie agenta ma wiele zależnych kroków. Błąd we wczesnym wywołaniu narzędzia może wymusić ponowienia lub unieważnić późniejszą pracę, więc umiarkowany wzrost niezawodności na krok może mieć większy wpływ na ukończenie end-to-end. Oceń ten efekt na reprezentatywnych zadaniach zamiast zakładać, że rozmiar modelu go gwarantuje.
Gdzie V2.5-Pro faktycznie poprawia wyniki?
Najczystsze porównanie liczbowo to ocena bazowego modelu Xiaomi, gdzie oba modele pojawiają się w tych samych ustawieniach. Unika to łączenia wyników uzyskanych w niespokrewnionych harnessach czy konfiguracjach post-treningowych.
Wiedza ogólna: małe do umiarkowanych zysków
W bazowym porównaniu modeli Xiaomi, Pro zyskuje 1.2 punktu na BBH, 3.1 na MMLU i 2.7 na MMLU-Pro. Są to mierzalne, ale mniejsze zyski niż na trudniejszych zadaniach rozumowania.
Matematyka i nauki ścisłe: większe zyski
Pro zyskuje 8.6 punktu na GPQA-Diamond, 16.3 na GSM8K i 18.5 na MATH w tej samej ocenie bazowego modelu. To najczytelniejszy dowód, by wybierać Pro, gdy trudne rozumowanie decyduje o sukcesie zadania.
Programowanie: lepszy, ale nie zawsze znacząco lepszy
Raportowane zyski to 4.3 punktu na HumanEval+, 3.2 na MBPP+, 4.1 na LiveCodeBench v6 i 4.9 na SWE-Bench AgentLess. Testuj zadania na poziomie repozytorium i użycie narzędzi osobno: te wyniki bazowego modelu nie obejmują wszystkich produkcyjnych przepływów agentów.
Wynik benchmarku: Pro nie jest trzy razy lepszy tylko dlatego, że kosztuje około trzy razy więcej. Jego wartość rośnie wraz ze wzrostem trudności rozumowania i długości zadania.
Te wiersze to oceny bazowych modeli, a nie obietnica, że produkcyjne API odtworzy te same wyniki. Rezultaty agentów zależą od narzędzi, promptów, ponowień, środowiska wykonawczego i budżetów tokenów.
Post-trening i agenci o długim horyzoncie
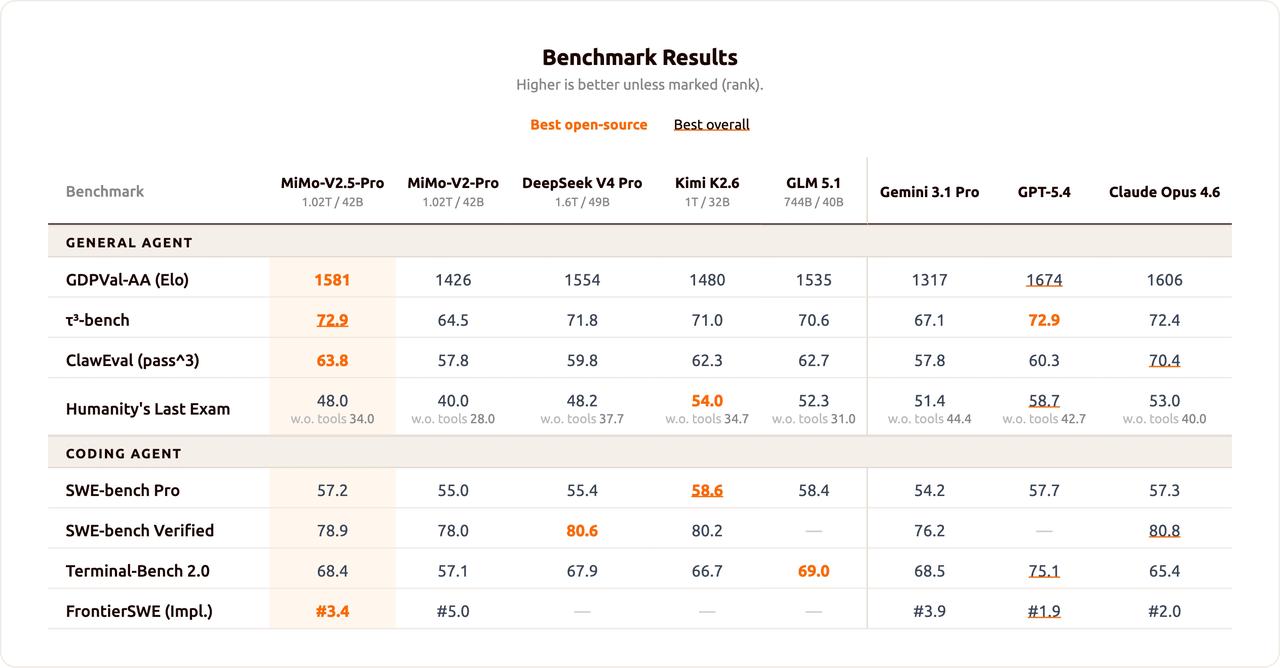
Modele produkcyjne dodają nadzorowane dostrajanie (SFT), agentowe uczenie z wzmocnieniem i Multi-Teacher On-Policy Distillation. Xiaomi raportuje wyniki post-treningowe 56.1 na SWE-bench Pro, 65.8 na Terminal-Bench 2.0 i 62.1 Pass³ na ogólnej części Claw-Eval dla V2.5.
Pro jest wyraźniej zoptymalizowany pod długohoryzontowe inżynierie oprogramowania. Xiaomi opisuje setki wywołań narzędzi w utrzymywanych trajektoriach i publikuje wynik 78.9% na SWE-bench Verified.
Jedno oficjalne studium przypadku pokazuje, jak Pro ukończył kompilator SysY w 4.3 godziny z 672 wywołaniami narzędzi i wszystkimi 233 testami zaliczonymi. Wniosek nie jest taki, że każde zadanie kodowania potrzebuje Pro; chodzi o to, że niewielkie różnice w niezawodności mogą przesądzić, czy przepływ pracy z setkami zależnych działań zostanie ukończony.

Oficjalny wykres benchmarków kodowania i agentów Xiaomi.
Długi kontekst: ta sama pojemność, różne obciążenia
Oba modele zapewniają okno kontekstu 1M tokenów i do 128K tokenów wyjściowych w obecnym API Xiaomi. Sam rozmiar kontekstu więc ich nie odróżnia.
V2.5 jest atrakcyjny, gdy długi kontekst zawiera materiał multimodalny, taki jak wideo, obrazy dokumentów czy wizualne ślady agenta. Pro to model do testów, gdy sam kontekst staje się problemem rozumowania: duże repozytorium, długi kontrakt, korpus badawczy lub trajektoria agenta zawierająca wiele sekwencyjnych działań.
Duże okno kontekstu opisuje pojemność, nie gwarantowaną wierność rozumowania. Oceń pozyskiwanie, retencję instrukcji i korzystanie z dowodów na długościach istotnych dla aplikacji.
Cena i efektywność kosztowa
Zagraniczne ceny pay-as-you-go Xiaomi jasno pokazują kompromis.
| Cennik — oficjalna tabela cen | V2.5 | Pro | Współczynnik |
|---|---|---|---|
| Niecache’owane wejście na 1M tokenów | $0.14 | $0.435 | 3.11× |
| Cache’owane wejście na 1M tokenów | $0.0028 | $0.0036 | 1.29× |
| Wyjście na 1M tokenów | $0.28 | $0.87 | 3.11× |
| Okno kontekstu | 1M | 1M | Takie samo |
| Maksymalna długość wyjścia | 128K | 128K | Takie samo |
Żądanie z 1M niecache’owanymi tokenami wejścia i 200K tokenami wyjściowymi kosztuje szacunkowo $0.196 na V2.5 i $0.609 na Pro przed trafieniami cache, kosztami wyszukiwania w sieci lub specyficznym billingiem dostawcy.
Różnica cen dla cache jest mniejsza: Pro jest około 29% droższy dla wejścia trafionego w cache, a nie o 211% droższy. Dlatego agenci długotrwałego działania ze stabilnymi promptami systemowymi, definicjami narzędzi lub prefiksami repozytoriów powinni zmierzyć faktyczną stopę trafień cache.
Szacuj koszt na pomyślnie ukończone zadanie. Agent Pro, który ukończy trudny przepływ raz, może kosztować mniej niż powtarzane nieudane próby na tańszym modelu.
Który model wybrać?
| Obciążenie — oficjalne wskazówki | Lepszy wybór | Dlaczego |
|---|---|---|
| Rutynowy czat tekstowy | V2.5 | Niższy koszt; Pro często zbędny |
| Generowanie na dużą skalę | V2.5 | Około 3.1× niższa cena standardowych tokenów |
| Rozumienie obrazu, wideo, audio | V2.5 | Natywne wejście multimodalne |
| Rutynowe wywołania narzędzi | V2.5 | Silne możliwości agenta przy niższym koszcie |
| Trudna matematyka i nauki ścisłe | Pro | Większe zyski w benchmarkach |
| Kodowanie na poziomie repozytorium | Pro | Zaprojektowany do złożonego inżynierowania |
| Setki zależnych wywołań narzędzi | Pro | Lepsze dopasowanie do trwałego wykonania |
| Kontekst 1M wrażliwy na koszty | V2.5 | Ten sam nominalny kontekst przy znacznie niższym koszcie |
Wynik wyboru: V2.5 to domyślny wybór do aplikacji multimodalnych, rutynowych agentów i obciążeń wrażliwych na koszty. Pro to upgrade do trudnego rozumowania, złożonego inżynierowania oprogramowania i długich autonomicznych trajektorii.
Lepsza strategia produkcyjna: trasuj między oboma
Często nie jest potrzebny jeden globalny wybór modelu. Kieruj multimodalne i rutynowe żądania do V2.5, a eskaluj tylko trudne rozumowanie tekstowe, złożone kodowanie lub długohoryzontowe wykonanie do Pro.
| Wymiar oceny | Miara | Dlaczego to istotne | Sygnał trasowania |
|---|---|---|---|
| Kompletność | Ukończone zadania / próby | Oddaje niezawodność end-to-end | Eskaluj klasy o niskiej kompletności |
| Jakość | Ocena człowieka lub wg rubryki | Zapobiega dominacji kosztu tokenów | Eskaluj zadania wysokiej wagi |
| Niezawodność narzędzi | Błędy i ponowienia | Małe błędy kumulują się u agentów | Eskaluj długie trajektorie |
| Opóźnienie | Czas do akceptowanego wyniku | Uwzględnia narzut ponowień | Trzymaj interaktywne zadania lekkie |
| Koszt | Wydatki na zaakceptowane zadanie | Odzwierciedla porażki i ponowienia | Używaj najtańszego modelu, który się sprawdza |
Przetestuj oba API w CometAPI
MiMo-V2.5 API w CometAPI i MiMo-V2.5-Pro API w CometAPI wspierają ocenę side-by-side przez jedną warstwę agregacji. Wyślij te same prompty, instrukcje systemowe, narzędzia i limity wyjścia do obu modeli, a następnie porównaj sukces zadania i koszt.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["mimo-v2.5", "mimo-v2.5-pro"]
prompt = """
Review this implementation plan.
Identify hidden technical risks and propose the three highest-priority fixes.
"""

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2000,
    )
    print(f"\n--- {model} ---")
    print(response.choices[0].message.content)
Uruchom reprezentatywną partię zawierającą proste żądania, trudne rozumowanie, edycję kodu, zadania z długim kontekstem i wywołania narzędzi agenta. Zarejestruj współczynnik ukończenia, tokeny, opóźnienie, błędy narzędzi, ponowienia, jakość odpowiedzi i koszt na pomyślnie ukończone zadanie.
Ograniczenia
Ograniczenia V2.5
Mniejszy językowy backbone pozostawia niewykorzystaną wydajność wraz ze wzrostem trudności rozumowania. Luka jest umiarkowana na BBH, ale staje się znacznie większa na GPQA-Diamond i MATH. Okna kontekstu 1M tokenów nie należy też mylić z gwarantowaną wiernością rozumowania na 1M tokenów.
Ograniczenia Pro
Zwykłe ceny wejścia i wyjścia są około 3.1× wyższe niż w V2.5, a wejście tylko tekstowe czyni go nieodpowiednim jako bezpośrednie zastępstwo w aplikacjach multimodalnych. Model z otwartymi wagami o 1.02T parametrach jest też wymagającym projektem do samodzielnego hostowania, mimo że na token aktywowanych jest 42B parametrów.
Ostateczny werdykt
Wybierz V2.5 do aplikacji multimodalnych, rutynowych agentów i produkcji wrażliwej na koszty. Wybierz Pro do trudnego rozumowania, złożonego inżynierowania oprogramowania i długotrwałych autonomicznych agentów. Dla mieszanych obciążeń trasuj większość ruchu do V2.5 i eskaluj tylko te żądania, których trudność lub długość trajektorii uzasadnia wyższy koszt.
FAQ
Czy Pro zawsze jest lepszy niż V2.5?
Nie. Pro jest silniejszy w trudnym rozumowaniu tekstowym i kodowaniu, ale V2.5 obsługuje wejście obrazowe, wideo i audio oraz jest znacznie tańszy.
Czy oba modele obsługują okno kontekstu 1M tokenów?
Tak. Oba reklamują 1M tokenów kontekstu i do 128K tokenów wyjściowych. Aplikacje powinny mimo to testować pozyskiwanie i rozumowanie na rzeczywistych długościach działania.
Z którego modelu powinien korzystać agent multimodalny?
Zacznij od V2.5, ponieważ natywnie przyjmuje wejście wizualne i audio. Pro obecnie celuje w przepływy o wejściu tekstowym.
Kiedy Pro jest wart wyższej ceny?
Najbardziej uzasadniony jest wtedy, gdy lepsza niezawodność rozumowania wpływa na ukończenie trudnej matematyki, kodowania na poziomie repozytorium lub długich trajektorii z wieloma zależnymi wywołaniami narzędzi.
Czy systemy produkcyjne powinny używać tylko jednego modelu?
Niekoniecznie. Warstwa trasująca może utrzymywać rutynową i multimodalną pracę na V2.5, jednocześnie eskalując trudne rozumowanie tekstowe i zadania agentów do Pro.