Buduj z CometAPIPotrzebujesz jednego API dla wielu modeli?Przetestuj proces w Playground, a potem utwórz klucz API, gdy model i koszt pasują do Twojego zastosowania.
OpenAI udostępnia serię GPT-5.4: co zmienia GPT-5.4
GPT-5.4 pojawia się jako ukierunkowana rodzina modeli do „profesjonalnej pracy” z dwiema głównymi wersjami — GPT-5.4 Thinking i GPT-5.4 Pro — oraz silnym naciskiem na pracę z dokumentami o długim kontekście, natywne możliwości obsługi komputera (agent) i poprawioną zgodność z faktami oraz wydajność realizacji zadań w procesach biurowych, prawnych i finansowych. Wydanie to następuje po wcześniejszych aktualizacjach w linii GPT-5 (w szczególności GPT-5.3 Instant i GPT-5.3-Codex) i przynosi mierzalne ulepszenia w wewnętrznych i publicznych benchmarkach, głębszą integrację z narzędziami (w tym z wtyczką ChatGPT for Excel) oraz większy obsługiwany kontekst (do 1 miliona tokenów).
Najnowsze wydanie OpenAI, GPT-5.4, pojawia się jako ukierunkowana rodzina modeli do „pracy profesjonalnej” z dwoma głównymi wariantami — GPT-5.4 Thinking i GPT-5.4 Pro — oraz silnym naciskiem na pracę z długim kontekstem dokumentów, natywne możliwości obsługi komputera (agent) oraz poprawioną zgodność z faktami i wydajność zadań w przepływach pracy biurowych, prawnych i finansowych. Wydanie to następuje po wcześniejszych aktualizacjach linii GPT-5 (w szczególności GPT-5.3 Instant i GPT-5.3-Codex) i wnosi mierzalne ulepszenia na wewnętrznych i publicznych benchmarkach, głębszą integrację narzędzi (w tym wtyczkę ChatGPT dla Excel) oraz większy obsługiwany kontekst (obsługa do 1 miliona tokenów).
Teraz CometAPI obsługuje i , i oferuje je ze zniżkami.
GPT-5.4 jest przedstawiany przez OpenAI jako najbardziej kompetentny model z serii GPT-5 dostrojony do profesjonalnych, intensywnych dokumentowo i agentowych przepływów pracy. Oferowany jest co najmniej w dwóch opublikowanych wersjach:
GPT-5.4 Thinking — wariant skoncentrowany na rozumowaniu, który odsłania więcej procesu myślowego modelu i jest zoptymalizowany pod kątem wieloetapowego rozumowania i zadań agentowych (dostępny w ChatGPT jako tryb „Thinking”).
GPT-5.4 Pro — warstwa wnioskowania o wyższym priorytecie/większej mocy obliczeniowej dla obciążeń o wysokiej przepustowości lub wrażliwych na opóźnienia, z wyższymi cenami API (odzwierciedlającymi dodatkowe obliczenia).
OpenAI podkreśla natywne możliwości obsługi komputera przez GPT-5.4 — umożliwiające modelom obsługę oprogramowania za pomocą programowych akcji myszy/klawiatury oraz orkiestrację sekwencji wielu narzędzi — co jest przedstawiane jako jakościowy skok w budowaniu agentów wykonujących realne zadania.
Nowe i podkreślane możliwości
Obsługa długiego kontekstu: GPT-5.4 ma obsługiwać bardzo duże konteksty (obsługa do 1,000,000 tokenów w kontekstach ChatGPT i Codex), dzięki czemu model może „trzymać w pamięci” podczas sesji ogromne projekty, książki, bazy kodu lub zbiory danych. To przełomowe dla przeglądu dokumentów, umów prawnych oraz inżynierskich projektów wieloplikowych.
Nattywne korzystanie z komputera / działanie agentowe: GPT-5.4 to pierwszy model ogólnego przeznaczenia OpenAI z natywnymi możliwościami korzystania z komputera — potrafi generować sekwencje akcji w interfejsie i kodu do obsługi oprogramowania (np. przez Playwright lub wydając polecenia myszy/klawiatury na podstawie zrzutów ekranu). Ta zdolność ma pozwolić deweloperom budować agentów, którzy realizują zadania w aplikacjach webowych i desktopowych.
Ulepszenia w pracy biurowej: Duży nacisk na arkusze kalkulacyjne, prezentacje i dokumenty — wewnętrzne benchmarki pokazują duże wzrosty w modelowaniu arkuszy, estetyce prezentacji i jakości redagowania dokumentów.
Zgodność z faktami i redukcja halucynacji: OpenAI raportuje ograniczenie błędów faktograficznych względem poprzednich modeli na wewnętrznych zestawach ewaluacyjnych (patrz benchmarki poniżej).
W porównaniu z wcześniejszymi modelami, jak GPT-5.2 Thinking i GPT-5.3 Codex, GPT-5.4 łączy te możliwości w jeden model zaprojektowany do obsługi długotrwałych zadań i złożonych przepływów pracy z minimalną interwencją użytkownika.
Kluczowe funkcje i najważniejsze aspekty techniczne GPT-5.4
1) Ogromne okna kontekstu (do 1,000,000 tokenów)
Najbardziej widoczną zdolnością jest obsługa okien kontekstu do 1,000,000 tokenów przez API. Rozszerza to zakres tego, co może pomieścić pojedyncza sesja modelu: całe książki, długie bazy kodu lub kompletne teczki wielodokumentowe bez dzielenia na wiele wywołań. Dla przepływów pracy w przedsiębiorstwach intensywnych pod względem wiedzy (przegląd materiałów prawnych, synteza badań, analiza kodu na dużą skalę) możliwość utrzymania milionowego kontekstu zmniejsza nakład pracy integracyjnej i poprawia spójność.
Implikacja: przepływy, które wcześniej wymagały orkiestracji (wyszukiwania, dzielenia, zewnętrznej pamięci), mogą teraz utrzymywać więcej surowego kontekstu w pamięci roboczej modelu — upraszczając potoki i zmniejszając kompromisy między opóźnieniem a spójnością.
2. Nattywne użycie komputera i narzędzi
OpenAI podkreśla silniejszą zdolność do obsługi narzędzi i konektorów (np. arkusze kalkulacyjne, edytory dokumentów, środowiska wykonywania kodu) bardziej niezawodnie niż wcześniejsze modele. GPT-5.4 rozszerza wcześniejsze prace nad „korzystaniem z narzędzi” o:
Lepszy dobór narzędzi i parametryzację wywołań.
Bardziej niezawodne planowanie sekwencji przy wywoływaniu zewnętrznych API lub przechodzeniu przez działania podobne do interfejsu użytkownika.
Zmniejszenie narzutu tokenów dla agentowych przepływów dzięki sprytniejszej architekturze wywołań narzędzi.
Możliwości agentowe i deweloperskie:
Automatyzacja na pulpicie i w sieci: Dzięki jawnej obsłudze wydawania akcji myszy i klawiatury na podstawie zrzutów ekranu GPT-5.4 może być osadzany w agentach, którzy obsługują rzeczywiste przepływy pracy (np. wypełnianie formularzy, nawigacja po pulpitach nawigacyjnych, wykonywanie wieloetapowych procedur). OpenAI raportuje najlepsze wyniki w klasie na benchmarkach w stylu systemów operacyjnych.
Interfejs narzędziowy i sterowalność: GPT-5.4 jest bardziej sterowalny przez wiadomości dewelopera i lepiej decyduje, kiedy i jak wywoływać zewnętrzne narzędzia, konektory i API — kluczowa zdolność do budowania niezawodnych multi-narzędziowych agentów, którzy minimalizują zbędne lub ryzykowne działania.
Praktyczny efekt: Zadania automatyzacji (np. „otwórz ten arkusz, policz te pivoty, wygeneruj notatki do slajdów”) wymagają mniej cykli niepowodzeń/ponowień i niższego nadzoru człowieka.
3) Pięć poziomów wysiłku rozumowania, tryby ekstremalne
OpenAI wskazuje wiele poziomów wysiłku rozumowania — pozwalając użytkownikom wymieniać opóźnienie/koszt na głębsze wewnętrzne rozumowanie krok po kroku (tryby nieformalnie określane jako xhigh lub extreme reasoning). Zostały one przeznaczone do problemów, w których więcej wewnętrznej deliberacji znacząco poprawia poprawność (złożone dowody, długie transformacje kodu, wieloetapowe analizy finansowe). Cennik API i logika rozliczeń odzwierciedlają dodatkową pracę modelu wykonywaną w tych trybach.
Praktyczny efekt: Ten podział pozwala klientom wybrać kompromisy odpowiednie dla ich obciążeń zamiast oczekiwać, że jeden model będzie „do wszystkiego”.
4) Produktywność i tworzenie treści
Modelowanie w arkuszach kalkulacyjnych: GPT-5.4 wykazuje duże ulepszenia w zadaniach arkuszowych typowych dla audytu, finansów i analiz. OpenAI raportuje średni wynik 87.3% na wewnętrznych zadaniach w stylu „modelowania bankowości inwestycyjnej” dla GPT-5.4 vs. 68.4% dla GPT-5.2. To dramatyczny wzrost dokładności zadań w modelowaniu numerycznym i konstrukcji formuł.
Prezentacje i materiały wizualne: Oceniający ludzie preferowali prezentacje generowane przez GPT-5.4 w 68.0% przypadków względem tych z GPT-5.2 ze względu na lepszą estetykę, różnorodność i integrację z generowaniem obrazów. Odzwierciedla to poprawę zarówno treści, jak i formy przy tworzeniu slajdów.
Redagowanie dokumentów i długich tekstów: GPT-5.4 zoptymalizowano pod kątem utrzymywania spójności w długich dokumentach, lepszego cytowania i mniejszej liczby wewnętrznych sprzeczności przy obsłudze dużych kontekstów, dzięki rozszerzonemu oknu kontekstu i dedykowanemu dostrojeniu rozumowania.
5) Bezpieczeństwo, środki zaradcze i kwestie cybernetyczne
Mniej halucynacji: OpenAI raportuje, że na zestawie zanonimizowanych promptów, gdzie użytkownicy sygnalizowali błędy faktograficzne, pojedyncze twierdzenia GPT-5.4 są o 33% mniej prawdopodobne, że będą fałszywe, a pełne odpowiedzi są o 18% mniej prawdopodobne, że zawierają jakiekolwiek błędy, względem GPT-5.2 — kluczowa metryka dla adopcji w przedsiębiorstwach, gdzie liczy się zgodność z faktami.
Środki bezpieczeństwa w cyberprzestrzeni (wariant Thinking): GPT-5.4 Thinking podkreśla rozszerzony zestaw zabezpieczeń przed ryzykami cybernetycznymi, bazując na ochronach używanych w poprzednich modelach Codex/5.3. GPT-5.4 Thinking został zaprojektowany z dodatkowymi barierami dla scenariuszy nadużyć o wysokich możliwościach.
Benchmarki wydajności — co mówią liczby
OpenAI i kilka serwisów opublikowało wczesne wyniki benchmarków w ramach wdrożenia. Ponieważ różne benchmarki testują różne możliwości (nawigacja w sieci vs. wiedza domenowa vs. bezpieczeństwo), warto zebrać główne liczby i ich znaczenie.
Zgłaszane wyniki pokazują zauważalne ulepszenia względem wcześniejszych członków rodziny GPT-5.x i bliską rywalizację z innymi modelami najwyższej klasy.
Benchmarki interakcji z webem i pulpitem
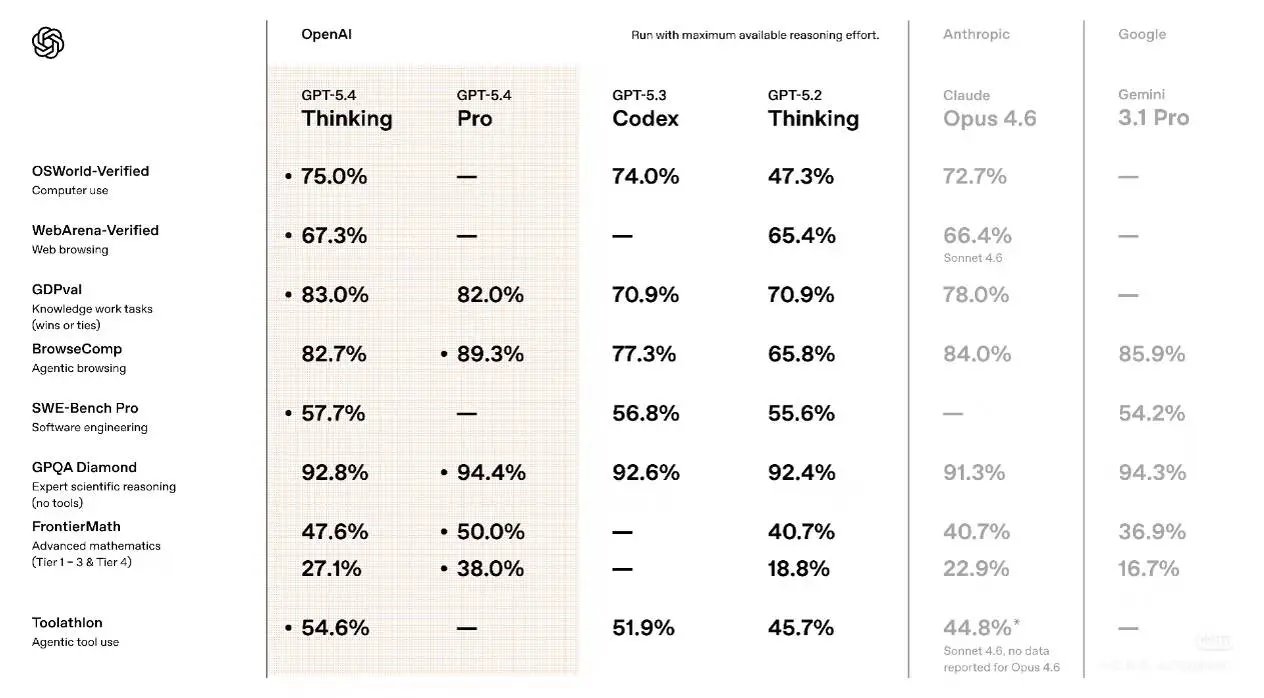
WebArena-Verified (testy użycia przeglądarki): GPT-5.4 osiąga 67.3% skuteczności przy użyciu zarówno sygnałów DOM, jak i zrzutów ekranu, w porównaniu do 65.4% GPT-5.2 — widoczny, choć niewielki wzrost. Mierzy to zadania, w których model musi wchodzić w interakcję z żywymi stronami i elementami UI.
Online-Mind2Web (zadania przeglądarkowe oparte na zrzutach): GPT-5.4 osiągnął 92.8% skuteczności przy użyciu wyłącznie obserwacji zrzutów ekranu — szczególnie silna poprawa względem wcześniejszych bazowych trybów agentowych (OpenAI zestawiło to z wydajnością trybu Agent w ChatGPT Atlas).
OSWorld-Verified (nawigacja desktopowa): niezależne raporty wskazały wynik GPT-5.4 75.0% w teście oceniającym nawigację w środowisku desktopowym i realizację zadań. Ten wynik uplasował 5.4 ponad wieloma publicznymi bazami dla zadań automatyzacji end-to-end.
Wniosek: Ulepszenia 5.4 są najbardziej wyraźne tam, gdzie liczy się rozumienie kontekstu wizualnego, możliwości interfejsu i długich sekwencji działań — czyli w przepływach agentowych.
Benchmarki zdrowotne, bezpieczeństwa i wiedzy
Raport wdrożeniowy bezpieczeństwa OpenAI pokazuje mieszane sygnały:
HealthBench: GPT-5.4 uzyskał 62.6% w HealthBench (niewielki spadek z 63.3% GPT-5.2), co wskazuje na subtelne kompromisy między możliwościami a niektórymi wskaźnikami zdrowotnymi w raportowanych migawkach.
Hard: GPT-5.4 uzyskał 40.1% w zestawie ewaluacyjnym „Hard” (nieco mniej niż 42.0%).
Consensus: GPT-5.4 osiągnął 96.6% w „Consensus”, metryce odzwierciedlającej zgodność z wyselekcjonowanymi odpowiedziami konsensualnymi (wzrost o ~2.1 punktu).
OpenAI odnotowało również zmiany średniej długości odpowiedzi w ewaluacjach zdrowotnych (GPT-5.4 średnio ~3,311 znaków vs. 2,676 dla GPT-5.2), co może wpływać na sposób ujmowania wrażliwych tematów.
Interpretacja: Metryki bezpieczeństwa i zdrowia pokazują, że 5.4 ogólnie zwiększył zbieżność z konsensusem i zmienił rozwlekłość odpowiedzi, mimo że niektóre wąskie wyniki zdrowotne nieznacznie spadły. Ten wzorzec często odzwierciedla równoważenie celów modelu — bardziej zdecydowane, dłuższe odpowiedzi mogą wspierać użyteczność i konsensus, jednocześnie wymagając uważnego monitorowania w wrażliwych domenach.
Przykłady i twierdzenia specyficzne dla domeny
Wczesne testy dostarczyły konkretnych, zdziedzinowanych twierdzeń (OpenAI i źródła zewnętrzne):
Benchmark rozumowania prawniczego (BigLaw Bench) — GPT-5.4 osiąga ~91% na wycinkach rozumowania prawnego w wczesnych testach, silny sygnał dla zadań analizy dokumentów; należy zauważyć, że to wczesne, nie zrecenzowane wyniki.
Redukcja halucynacji: Odpowiedzi GPT-5.4 są ~33% mniej prawdopodobne, że zawierają fałszywe twierdzenia, i ~18% mniej prawdopodobne, że zawierają błędy faktograficzne w porównaniu z pewnymi wcześniejszymi bazami. Te odsetki podkreślono w raportach wtórnych i komunikacji firmy; jak w przypadku każdego takiego twierdzenia, zależą one od zestawu benchmarków i metodologii próbkowania.
Jak uzyskać dostęp do GPT-5.4 i za niego zapłacić
Plany ChatGPT i dostęp dla przedsiębiorstw
Według OpenAI i raportów produktowych:
Użytkownicy ChatGPT Plus / Team / Pro byli pierwszymi grupami, które otrzymały GPT-5.4 Thinking w produkcie. Administratorzy Enterprise i Education mogą włączyć wczesny dostęp przez ustawienia administracyjne. Użytkownicy Free/Go nie mają gwarantowanego natychmiastowego dostępu. Deweloperzy mogą wywoływać endpointy gpt-5.4 i gpt-5.4-pro przez API.
Przegląd cen API (opublikowane ceny deweloperskie)
Cennik deweloperski OpenAI wymienia GPT-5.4 jako model z czołówki z opłatami per token. Według cen opublikowanych w momencie ogłoszenia, przykładowe stawki dla GPT-5.4 są w przybliżeniu następujące:
Model
Wejście
Buforowane wejście
Wyjście
gpt-5.4 (<272K długość kontekstu)
$2.50
$0.25
$15.00
gpt-5.4 (>272K długość kontekstu)
$5.00
$0.50
$22.50
gpt-5.4-pro (<272K długość kontekstu)
$30.00
$180.00
gpt-5.4-pro (>272K długość kontekstu)
$60.00
$270.00
W CometAPI (platforma agregująca API dużych modeli w jednym miejscu):
Model
Cena Comet (USD / M tokenów)
Cena oficjalna (USD / M tokenów)
Zniżka
gpt-5.4
Wejście:$2/M; Wyjście:$16/M
Wejście:$2.5/M; Wyjście:$20/M
-20%
gpt-5.4-pro
Wejście:$24/MWyjście:$192/M
Wejście:$30/MWyjście:$240/M
-20%
Dlatego gorąco polecam CometAPI, ponieważ może znacznie obniżyć koszty API.
Rozważania dotyczące zarządzania kosztami
Jeśli planujesz używać modelu na dużą skalę, zwłaszcza w ustawieniach długich dokumentów lub wysokiej przepustowości, powinieneś rozważyć:
Buforowanie i deduplikację wejść (aby korzystać z cen dla buforowanego wejścia, gdzie to możliwe).
Inżynierię promptów w celu kompresji kontekstu i unikania nadmiarowych tokenów.
Strategie wsadowania i postprocessing, które minimalizują kosztowne generowanie wyjścia.
Monitorowanie użycia trybów rozumowania, ponieważ głębsze tryby rozumowania mogą wiązać się z wyższym kosztem obliczeniowym.
Porównanie: GPT-5.4 vs GPT-5.3
Gdzie GPT-5.4 przewyższa GPT-5.3
Głębia rozumowania i orkiestracja narzędzi: 5.4 Thinking został explicite dostrojony, by przewyższyć 5.3 w wieloetapowym rozumowaniu i zastosowaniach agentowych. Widać to w benchmarkach interakcji web/desktop i metrykach sukcesu agentów.
Pojemność kontekstu: Oferowane przez 5.4 1M tokenów to wyraźny krok techniczny poza to, co 5.3 zapewniał w głównym API, umożliwiając nowe klasy zadań jednosesyjnych.
Wzrosty wydajności domenowej: Wczesne liczby OpenAI i raporty zewnętrzne wskazują na poprawę w niektórych benchmarkach prawnych i dokumentowych, gdzie dłuższy kontekst i specjalne dostrojenie 5.4 pomagają.
Kompromisy i gdzie 5.3 może być wciąż preferowany
Lekkie użycie konwersacyjne:GPT-5.3 Instant pozostaje zoptymalizowany pod szybkie, ekonomiczne przepływy konwersacyjne; organizacje szukające najmniejszego opóźnienia/kosztu dla krótkich interakcji czatowych mogą go preferować.
Stabilność metryk bezpieczeństwa: niektóre wyniki zdrowotne i „hard” wykazały niewielkie spadki dla 5.4 względem 5.2 w migawkach OpenAI; przedsiębiorstwa w wrażliwych, regulowanych domenach powinny zweryfikować model na własnych zestawach ewaluacyjnych przed pełnym wdrożeniem.
Zastosowania i implikacje dla branż
Połączenie przez GPT-5.4 głębokiego rozumowania, pamięci długiego kontekstu i użycia narzędzi otwiera kilka praktycznych i strategicznych możliwości.
1. Usługi profesjonalne i konsulting
Firmy tworzące długie materiały (np. pisma procesowe, wielorozdziałowe raporty konsultingowe, pakiety due diligence M&A) mogą trzymać całe dokumenty i zbiory danych w kontekście, umożliwiając spójną syntezę międzydokumentową, zautomatyzowane QA i generowanie podsumowań dla zarządu bez ręcznego łączenia fragmentów. Zwycięstwa w benchmarkach APEX-Agents są zgodne z tym pozycjonowaniem.
2. Inżynieria oprogramowania i rozumienie baz kodu
Dłuższy kontekst oznacza, że pojedyncze wywołanie modelu może zawierać całe repozytoria lub długie ścieżki logów. Ulepszenia GPT-5.4 w benchmarkach SWE wskazują lepszą wydajność w debugowaniu, refaktoryzacji i przeglądach kodu — szczególnie w połączeniu z Pro dla stałych obciążeń.
3. Agenci autonomiczni i automatyzacja w przedsiębiorstwie
Systemy agentowe działające na narzędziach (arkusze, systemy ticketowe, interfejsy webowe) korzystają z lepszego doboru narzędzi w GPT-5.4, mniejszego narzutu tokenów dla przepływów agentowych i ulepszonego utrzymywania stanu w dłuższym horyzoncie. To czyni GPT-5.4 atrakcyjnym dla potoków automatyzacji przedsiębiorstw i „asystentów, którzy działają” w wielu systemach.
Sedno — co zmienia GPT-5.4
GPT-5.4 stanowi pragmatyczny, napędzany możliwościami krok w kierunku modeli, które potrafią obsłużyć długie, wielodokumentowe rozumowanie, wykonywać przepływy agentowe z większą niezawodnością oraz skalować się do profesjonalnych potoków przez kontrakty Pro. Dla organizacji, których przepływy pracy są długohoryzontalne i zależne od narzędzi, GPT-5.4 to jakościowa zmiana potencjału produktywności
Deweloperzy mogą uzyskać dostęp do GPT-5.4, GPT-5.4-pro, oraz GPT 5.3 Chat przez CometAPI już teraz. Aby zacząć, poznaj możliwości modelu w Playground i zapoznaj się z API guide po szczegółowe instrukcje. Przed uzyskaniem dostępu upewnij się, że zalogowałeś się do CometAPI i uzyskałeś klucz API. CometAPI oferuje cenę znacznie niższą od oficjalnej, aby pomóc w integracji.