
TL;DR
A Z.AI nomeou publicamente o GLM-6.0 e colocou o Full Self-Training no centro de seu roadmap de próxima geração. A direção divulgada conecta experiência autogerada ao longo do pré-treinamento, meio do treinamento e pós-treinamento com autoavaliação e correção, transformando o treinamento em um loop de feedback governado, em vez de uma única etapa de geração de dados.
A parte difícil é o controle: o GLM-6.0 precisaria purificar dados sintéticos, detectar e reparar erros, interromper iterações improdutivas e impedir que seu avaliador recompense atalhos. Esses mecanismos levantam questões práticas sobre verificação independente, segurança, custo e governança. Como nenhum cartão de modelo completo, suíte de benchmarks, especificação de API, preço ou data de lançamento é público, o artigo avalia a arquitetura de treinamento e suas evidências — não especificações especulativas.
Principais conclusões para o GLM 6.0?
- A evidência pública mais forte diz respeito ao sistema de Full Self-Training, não a uma contagem de parâmetros vazada ou a um resultado de benchmark.
- A direção divulgada abrange dados produzidos pelo próprio modelo, ambientes de treinamento auto-construídos e otimização de infraestrutura assistida por modelo.
- O loop de feedback pretendido abrange pré-treinamento, meio do treinamento e pós-treinamento, em vez de tratar o auto-treinamento como uma técnica apenas de pós-treinamento.
- Modelagem multimodal nativa, aprendizado por reforço de horizonte mais longo, planejamento, uso de ferramentas, recuperação e verificação são direções de pesquisa relevantes, mas ainda não são especificações publicadas do GLM 6.0.
- Ox Alpha não é evidência de desempenho vazado do GLM 6.0; a Z.AI o identificou como a identidade de pré-lançamento do GLM-5.3-Flash.
O que a Z.AI realmente confirmou sobre o GLM 6.0?
O material público da Z.AI estabelece quatro sinais concretos: o nome GLM-6.0, o Full Self-Training como direção central de treinamento, um loop pretendido ao longo do pré-treinamento, meio do treinamento e pós-treinamento, e um mecanismo de autoavaliação e correção. A empresa também afirma que aproximadamente 60% das receitas líquidas se destinam a apoiar modelos de próxima geração, Full Self-Training, treinamento em larga escala, inferência, computação e infraestrutura relacionada.
Framework de Full Self-Training da Z.AI
O Full Self-Training é apresentado como a ideia organizadora do GLM-6.0, não como um pequeno recurso de pós-treinamento. O sistema pretendido geraria experiência de treinamento, aprenderia com resultados, filtraria amostras fracas e repetiria o ciclo sob controles explícitos de qualidade.
Auto-treinamento do GLM-6.0 ao longo do pré-, meio- e pós-treinamento
A sequência divulgada — pré-treinamento, meio do treinamento e pós-treinamento — implica que a experiência autogerada poderia influenciar o conhecimento de base, a modelagem de capacidades e o alinhamento a tarefas, em vez de surgir apenas durante o ajuste final. A Z.AI não divulgou os conjuntos de dados, limites de estágio ou proporções de mistura, portanto isso deve ser tratado como uma direção confirmada e não uma receita completa.
Mecanismo de autoavaliação e correção do GLM-6.0
O roadmap vincula o Full Self-Training à autoavaliação, detecção de erros, correção e autopurificação de dados. Na prática, o modelo precisaria julgar trajetórias, revisar etapas fracassadas, descartar dados não confiáveis e decidir quando iterações adicionais não melhoram mais o desempenho medido de forma independente. O design do avaliador e as regras de parada permanecem não divulgados.
O anúncio de GLM-6.0 e Full Self-Training deve ser lido em conjunto com a da Z.AI alocação pública de receitas.
O que sabemos versus o que não sabemos
O registro público sustenta um roadmap, mas não uma especificação finalizada. A tabela separa direção confirmada de questões em aberto para que o artigo não transforme intenção divulgada em uma alegação de produto sem suporte.
| Claim | Evidence status | What is supported | What remains unknown |
|---|---|---|---|
| GLM-6.0 name | Publicly identified | Z.AI has named the next-generation model GLM-6.0. | Release date and final positioning. |
| Full Self-Training | Confirmed roadmap | It is a stated strategic priority. | Implementation details and scaling behavior. |
| Pre-training → Mid-training → Post-training | Confirmed direction | Self-training is intended to span the training lifecycle. | Datasets, validators, stage boundaries, and data ratios. |
| Self-evaluation and correction | Confirmed objective | The roadmap includes self-purification, error detection, and correction. | Reliability, independent verification, and stopping criteria. |
| Specifications | Not disclosed | No complete public specification. | Parameters, context window, modalities, price, and API identifier. |
| Benchmarks | Not disclosed | No official GLM-6.0 result set. | Scores, methodology, and independently reproducible results. |
O que é Full Self-Training e como funciona
Full Self-Training é um loop de aprendizado fechado no qual um modelo ajuda a criar tarefas ou ambientes, tenta executá-los, avalia as trajetórias resultantes, corrige etapas fracas e alimenta a experiência aceita de volta no treinamento. A mudança importante é de um pipeline de dados sintéticos de uma única vez para um processo continuamente governado.
- Gerar: construir problemas, ambientes de ferramentas e caminhos de solução candidatos.
- Agir: concluir tarefas e preservar ações, observações e raciocínios intermediários como trajetórias.
- Avaliar e corrigir: pontuar resultados com verificadores, detectar erros, revisar etapas que falharam e rejeitar amostras de baixa confiança.
- Treinar e parar: aprender com a experiência aceita e continuar apenas enquanto avaliações independentes mostrarem melhoria útil.
Estender esse loop ao longo do pré-treinamento, meio do treinamento e pós-treinamento permitiria que o GLM-6.0 melhorasse a qualidade dos dados, a modelagem de capacidades e o alinhamento a tarefas em diferentes estágios. A arquitetura ainda depende de avaliadores confiáveis: sem verificações independentes, o auto-treinamento pode recompensar seus próprios pontos cegos.
Como o Full Self-Training poderia mudar o GLM 6.0?
O design divulgado é melhor entendido como uma arquitetura de sistema do que como um único novo bloco de Transformer. Ele tenta fechar o loop ao redor do modelo para que o modelo ajude cada vez mais a gerar os recursos necessários para o próximo ciclo de treinamento.
Como o GLM 6.0 poderia produzir dados de treinamento?
O primeiro loop é a autoprodução de dados. Em vez de depender apenas de conjuntos de dados escritos por humanos ou coletados externamente, modelos podem usar auto-jogo, verificações baseadas em regras, resultados de execução, julgamento por modelos e verificações amostrais humanas para gerar e filtrar novos exemplos. Os exemplos aceitos então retornam ao pré-treinamento, meio do treinamento e pós-treinamento.
A restrição importante é a verificação: geração sintética barata é útil apenas quando o sistema consegue identificar exemplos corretos, diversos e não degenerados. Um loop prático é geração pelo modelo → execução da tarefa → verificação por regra ou ferramenta → filtragem → retreinamento.
Como o GLM 6.0 poderia construir ambientes de treinamento?
O segundo loop é a autoconstrução de ambientes. Agentes podem coletar ou transformar tarefas do mundo real, tentar essas tarefas, criar validadores e verificar se a tarefa é realmente solucionável antes de se tornar material de treinamento. Isso é especialmente relevante para codificação e trabalho de agentes, onde estado terminal, saída de ferramentas, estado do navegador, resultados de testes e recuperação de falhas fornecem supervisão mais forte do que respostas apenas em texto.
A meta de avaliação migra de “uma resposta soa plausível?” para “uma ação é bem-sucedida, o resultado é verificável de forma independente e o agente consegue se recuperar após falha?”.
Como o GLM 6.0 poderia otimizar sua infraestrutura de treinamento?
O terceiro loop é a auto-otimização de infraestrutura. Na prática, isso é melhor interpretado como engenharia de sistemas assistida por IA: um modelo de codificação forte propõe mudanças em operadores, kernels, agendamento, cache ou código de serving, enquanto benchmarks automatizados e validação controlada por humanos determinam quais mudanças são aceitas.
O ciclo resultante é: modelo melhor → melhores propostas de sistemas → ganhos de eficiência validados → mais experimentos de treinamento → modelo melhor. Revisão humana e benchmarks reproduzíveis permanecem pontos de controle, não opcionais.
O que a linha de base atual do GLM 5.3 Flash nos diz sobre o GLM 6.0?
Como o GLM 6.0 não tem um cartão de modelo público, a comparação mais defensável separa as capacidades GLM medidas atuais da direção de próxima geração. A Z.AI descreve o GLM-5.3-Flash como um modelo MoE de 320B no total e 18B ativos, treinado em um corpus multimodal de 30T tokens. Essas são especificações do GLM-5.3-Flash, não do GLM 6.0.
| Comparison dimension | GLM-5.3-Flash API in CometAPI | GLM 6.0 disclosed direction |
|---|---|---|
| Release status | Available | In development; final product name not independently established by the cited filing |
| Parameters | 320B total / 18B active | Not disclosed |
| Core architecture | MoE; hybrid sparse + linear attention; mHC | Not disclosed at block level |
| Training data | 30T-token multimodal corpus | Self-produced data intended to enter a recursive loop |
| Multimodality | Native multimodal input | Unified multimodal modeling is a research direction, not a published specification |
| Training stages | Published staged training recipe | Self-training across pre-, mid-, and post-training |
| Training environments | Researcher-designed and benchmarked environments | Agents help construct and validate environments |
| Verification | Existing evaluation and training pipelines | Stronger self-judgment, execution feedback, and self-verification |
| Infrastructure | Optimized inference stack | Models assist with infrastructure optimization |
| API details | Published model ID and live API | Not disclosed |
O texto de lançamento da Z.AI relata aproximadamente 3.0× menos computação de atenção e 4.4× menor tamanho de KV-cache para o GLM-5.3-Flash do que para o GLM-5.3 API . O gráfico oficial que acompanha rotula a comparação de um milhão de tokens como 3.40× para computação de atenção e 3.80× para KV cache por camada. Como os dois ativos oficiais usam números diferentes, eles devem ser reportados com seus respectivos contextos, em vez de fundidos em uma única medição.
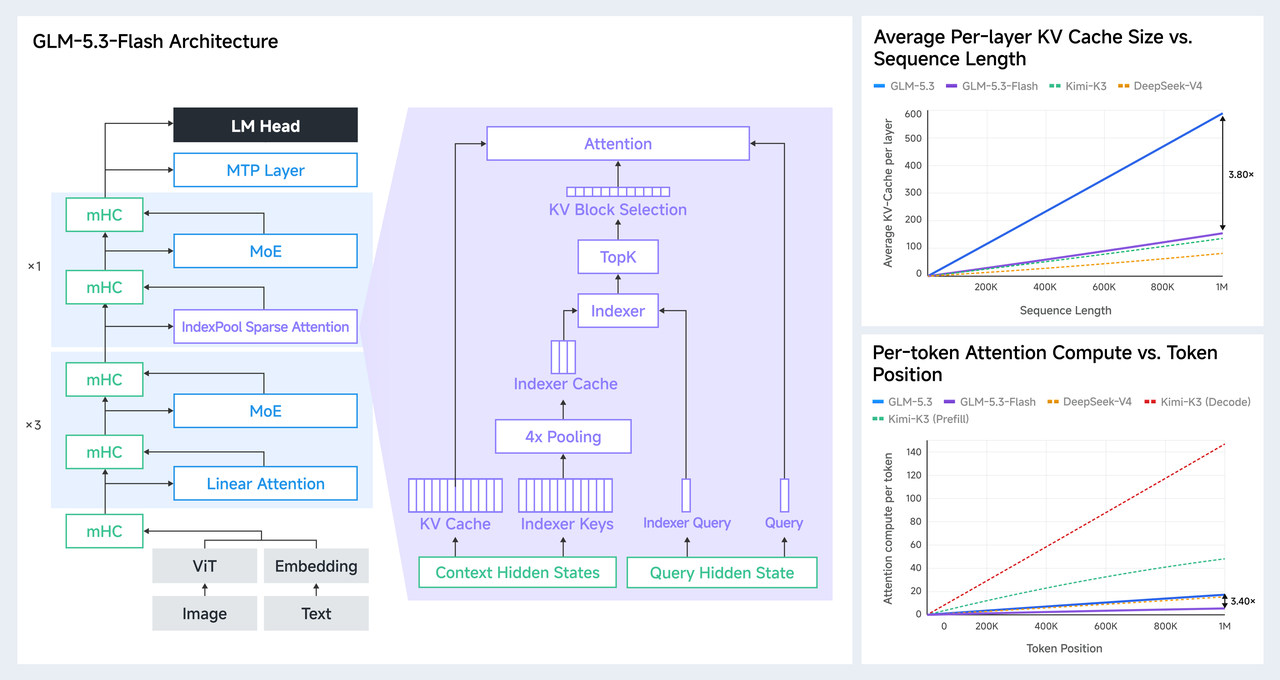
Comparação oficial de arquitetura e eficiência do GLM-5.3-Flash publicada pela Z.AI
Quais resultados de benchmark formam a linha de base do GLM 6.0?
Não há tabela verificada de benchmarks do GLM 6.0 pública. A geração GLM atual é útil apenas como linha de base porque as avaliações abaixo medem planejamento, codificação, uso de ferramentas, automação e execução de longo horizonte — as capacidades mais relevantes para a direção de Full Self-Training divulgada.
| Official Z.AI evaluation | GLM-5.3-Flash | GLM-5.2 | Reported difference |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 81.0 | +3.3 |
| DeepSWE v1.1 | 63.4 | 46.2 | +17.2 |
| NL2Repo | 56.3 | 48.9 | +7.4 |
| Toolathlon Verified | 78.4 | 59.9 | +18.5 |
| AutomationBench v1.0.6 | 48.8 | 26.2 | +22.6 |
| Agents’ Last Exam | 26.3 | 20.4 | +5.9 |
| HLE with Tools | 55.3 | 54.7 | +0.6 |
| GDPval-AA v2 | 1773 Elo | 1504 Elo | +269 Elo |
A comparação é multidimensional, e não um ranking de pontuação única. O GLM-5.3-Flash mostra seus maiores ganhos reportados no AutomationBench (+22.6), Toolathlon Verified (+18.5) e DeepSWE (+17.2), enquanto a diferença no HLE-with-Tools é de apenas +0.6. Esse padrão sugere ganhos mais fortes em tarefas de agente intensivas em execução do que em toda forma de raciocínio assistido por ferramentas. Isso não prevê as pontuações do GLM 6.0.
Por que esses benchmarks importam
Benchmarks importam aqui apenas se revelarem as capacidades que o Full Self-Training pretende melhorar. As seis categorias na tabela embutida formam uma progressão de produzir trabalho correto para sustentar comportamento eficaz em ambientes reais. Codificação testa se o modelo consegue executar uma tarefa complexa; uso de ferramentas testa se ele consegue transformar uma ação em feedback e escolher o próximo passo; e automação testa se ele consegue preservar esse loop ao longo de um fluxo de trabalho longo.
| Benchmark Category | Why It Matters for GLM-6.0 |
|---|---|
| Coding | Tests complex task execution |
| Tool Use | Tests the action-to-feedback loop |
| Automation | Tests long-horizon workflow execution |
| HLE | Tests complex expert-level problem solving |
| GDPval | Tests professional work quality |
| Multimodal | Tests the use of visual feedback |
O HLE então eleva a dificuldade dos problemas sendo resolvidos, o GDPval pergunta se a saída é útil no trabalho profissional, e a avaliação multimodal testa se observações visuais podem orientar ações subsequentes. Lidas juntas, as seis categorias migram de competência isolada para conclusão de tarefas de ponta a ponta: gerar um plano, agir, observar feedback, corrigir erros e continuar até que o objetivo seja atingido.
Um futuro resultado do GLM-6.0 seria, portanto, significativo não porque produza uma pontuação agregada mais alta, mas porque ganhos nessas dimensões mostrariam que a experiência de treinamento autogerada se transfere para execução confiável no mundo real. O objetivo final de Full Self-Training não é melhorar notas de testes, e sim melhorar a capacidade do modelo de concluir tarefas do mundo real.
Por que o Full Self-Training pode ser importante para o GLM 6.0?
A verdadeira promessa não é que o GLM 6.0 simplesmente “se treine”. A mudança mais significativa é que partes maiores do pipeline de desenvolvimento podem se tornar geradas e verificadas por máquina. Hoje, pesquisadores ainda fazem grande parte do trabalho ao redor do modelo: coletar dados, projetar tarefas, construir avaliadores, construir ambientes, diagnosticar falhas e ajustar software de sistemas. O Full Self-Training empurra o modelo para mais desses estágios.
Se a abordagem funcionar, a variável importante de escala deixa de ser quantos parâmetros podem ser adicionados e passa a ser quantos ciclos de aprendizado úteis e verificados podem ser executados por unidade de computação. Essa é uma interpretação prática de aprimoramento recursivo de si, em vez da versão de ficção científica de auto-modificação autônoma irrestrita.
A estratégia divulgada deve ser avaliada como um sistema de feedback engenheirado com validadores, ambientes reproduzíveis, benchmarks de infraestrutura e controles humanos — não como evidência de aprimoramento recursivo autônomo sem restrições.
O que pode dar errado com o Full Self-Training?
Um loop de auto-treinamento pode amplificar erros com a mesma eficiência com que amplifica experiência útil. Quatro modos de falha merecem atenção particular:
- Amplificação de erros: trajetórias sintéticas fracas podem se tornar dados de treinamento futuros, permitindo que padrões plausíveis porém incorretos se reforcem.
- Exploração do avaliador e do sinal de recompensa: se o mesmo sistema gera trabalho e o julga, ele pode otimizar para lacunas do verificador em vez de sucesso genuíno na tarefa.
- Estreitamento de distribuição: aprender repetidamente com dados gerados pelo modelo pode reduzir a diversidade e tornar casos raros do mundo real mais difíceis de lidar.
- Pressão de custo, segurança e governança: construção de ambientes, acesso a ferramentas e iteração persistente aumentam a demanda computacional e ampliam a superfície de ataque.
Uma implementação crível do GLM-6.0, portanto, precisa de validadores independentes, proveniência de dados, limiares de aceitação, testes de red team, auditorias humanas e regras explícitas de parada. Auto-correção é útil apenas quando o sinal de correção é mais confiável do que o comportamento sendo corrigido.
Quando a API do GLM 6.0 pode ficar disponível?
A Z.AI não publicou data de lançamento da API do GLM 6.0, ID do modelo, janela de contexto, saída máxima, preço por token, compromisso de pesos abertos ou requisitos de implantação. Qualquer valor específico atualmente seria especulação.
Desenvolvedores podem avaliar a direção atual por meio da API GLM-5.3-Flash no CometAPI para cargas de trabalho multimodais nativas e voltadas à eficiência, da API GLM-5.3 no CometAPI para o branch principal atual, ou da API GLM-5.2 no CometAPI como linha de base de comparação da geração anterior.
Conclusão
O GLM-6.0 importa menos como um produto prometido do que como um teste de se a Z.AI consegue transformar o Full Self-Training em um sistema de engenharia repetível. O roadmap conecta experiência autogerada, treinamento em estágios, autoavaliação, correção e iteração controlada; a evidência decisiva será se esses mecanismos melhoram a confiabilidade em fluxos de trabalho longos, com uso de ferramentas, no mundo real.
Essa evidência ainda é incompleta. A Z.AI não publicou um cartão de modelo do GLM-6.0, data de lançamento, identificador de API, preços ou suíte de benchmarks. Até que esses artefatos existam, a conclusão defensável é estreita: a empresa divulgou uma direção de treinamento, não um perfil de capacidades finalizado.
O objetivo final de Full Self-Training não é melhorar notas de testes, e sim melhorar a capacidade do modelo de concluir tarefas do mundo real.