
Resumo
GPT-6 Astra apresenta pontuações de manchete excepcionais. Os maiores ganhos aparecem quando o raciocínio precisa ser convertido em ação: operação de terminal, uso de software, automação, recuperação de contexto longo, fluxos de trabalho científicos e cibersegurança. Em testes acadêmicos já saturados, a melhoria sobre a geração anterior da OpenAI costuma ser muito menor.
O modelo combina uma janela de contexto de 1.050.000 tokens com amplo suporte a ferramentas. Os benchmarks de execução publicados pela OpenAI sugerem que o upgrade prático é mais forte em trabalhos de longo horizonte, mas o design do harness, o esforço de raciocínio, a latência e o acesso a ferramentas afetam materialmente o resultado.
Principais pontos
- Os ganhos mais claros da Astra estão na execução orientada a agentes, não em toda forma de perguntas e respostas.
- Os resultados de Terminal-Bench, AutomationBench, uso de computador e migração de banco de dados mostram movimento substancialmente maior do que GPQA ou DeepSWE.
- O resultado do ARC-AGI-3 demonstra que estado do modelo, gestão de contexto e o harness de avaliação podem dominar a pontuação final.
- Uma janela de contexto grande só importa quando a informação permanece recuperável perto do limite; MRCR é mais informativo do que a capacidade anunciada isoladamente.
- Preços de token mais altos não significam automaticamente custo maior por tarefa se o modelo precisar de menos tokens, turnos, tentativas ou correções humanas.
- Decisões de produção devem comparar taxa de sucesso, tempo decorrido, custo total, confiabilidade das ferramentas e carga de correção em conjunto.
GPT-6 Astra em resumo
A OpenAI especifica até 128.000 tokens de saída, entrada de texto e imagem, saída de texto e esforço de raciocínio de baixo a máximo. Essas especificações tornam possíveis fluxos de trabalho grandes e multietapas, mas não provam que um modelo recuperará a evidência correta ou concluirá uma tarefa de forma confiável.
| Especificação oficial | GPT-6 Astra na CometAPI | Significado prático |
|---|---|---|
| Model ID | gpt-6-astra | Identificador estável para roteamento de API |
| Context window | 1,050,000 tokens | Suporta grandes repositórios, arquivos e históricos de agentes |
| Maximum output | 128,000 tokens | Permite grandes relatórios, patches e artefatos estruturados |
| Knowledge cutoff | April 30, 2026 | Fatos posteriores exigem ferramentas ou fontes fornecidas |
| Input | Text and images | Suporta documentos, capturas de tela, diagramas e evidências mistas |
| Output | Text | Produz prosa, código e texto estruturado |
| Reasoning effort | low, medium, high, xhigh, max | Troca latência e custo por busca mais profunda |
| Agent capabilities | Function calling, structured outputs, computer use, web/file search, hosted shell, Apply Patch, MCP | Habilita fluxos de trabalho ponta a ponta, não respostas isoladas |
| OpenAI Standard input | $10 per million tokens | Tamanho da entrada e reutilização de cache afetam o custo total |
| OpenAI cached input | $1 per million tokens | Aplica quando o prefixo do prompt é reutilizado do cache |
| OpenAI cache writes | $12.50 per million tokens | Cobrado a 1,25× a taxa de entrada sem cache |
| OpenAI Standard output | $50 per million tokens | Saídas verbosas podem dominar o custo da tarefa |
| Requests above 272K input tokens | Input and cache rates ×2; output rate ×1.5 | As taxas mais altas se aplicam à solicitação inteira |
Um limite de contexto mede capacidade, não lembrança utilizável. Uma lista de ferramentas mede disponibilidade, não execução bem-sucedida. Benchmarks são necessários para testar se essas especificações se traduzem em trabalho concluído.
O que mostram os resultados de benchmark do GPT-6 Astra?
O portfólio mostra um padrão desigual. A Astra mal vai além da Sol em alguns testes acadêmicos e de raciocínio sobre software, mas produz ganhos de dois dígitos em trabalho de terminal, automação, migração de banco de dados, interação visual, recuperação de contexto longo e matemática avançada.
| Benchmark publicado | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Astra vs. Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | +20.6 pp |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | +1.4 pp |
| Database Migration Tasks | 63.9% | 42.7% | 57.8% | +21.2 pp |
| OSWorld 2.0 | 72.6% | 65.7% | — | +6.9 pp |
| ScreenSpot-Pro | 92.7% | 76.9% | — | +15.8 pp |
| AutomationBench | 41.4% | 18.1% | 31.4% | +23.3 pp |
| BenchCAD | 95.9% | 83.3% | 84.3% | +12.6 pp |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | +14.6 pp |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | +1.4 pp |
| MRCR v2, 512K–1M | 96.3% | 73.8% | — | +22.5 pp |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | 65.7 | +0.3 |
| ARC-AGI-3, Provider Adapter | 99.9% | 7.8% | — | +92.1 pp |
Três clusters emergem. Primeiro, as lacunas de 1,4 ponto no DeepSWE e no GPQA indicam movimento incremental limitado em tarefas nas quais modelos fortes já performam bem. Segundo, ganhos acima de 20 pontos em Terminal-Bench, AutomationBench, migração de banco de dados e recuperação em milhão de tokens mostram uma mudança muito maior na execução. Terceiro, ARC-AGI-3 é um ponto fora da curva cuja interpretação depende do harness.
Resultado de testes independentes
Artificial Analysis reporta Astra e Sol em cerca de 61 no seu Intelligence Index, enquanto mostra um ganho muito mais claro em seu Coding Agent Index. Isso reforça independentemente o padrão nos dados da OpenAI: a maior melhoria está concentrada na execução orientada a agentes.
Em esforço máximo no harness Codex, a Astra supostamente usa cerca de um terço dos tokens da Sol no Coding Agent Index. O uso de tokens do Intelligence Index cai apenas cerca de 10%. Como a taxa por token da Astra é mais alta, esses dois perfis de eficiência criam economias diferentes.
| Avaliação independente | Resultado observado | Interpretação de produção |
|---|---|---|
| Intelligence Index | Pouca separação em relação à Sol | Raciocínio geral pode não justificar um prêmio de preço elevado |
| Coding Agent Index | Claro aprimoramento agentic | Menos tokens podem compensar taxa por token mais alta |
| AA-Omniscience | Taxa de alucinação cai de 92% para 51% em esforço máximo | Melhor abstenção pode importar para sistemas de pesquisa e RAG |
| Trabalho de conhecimento de longo horizonte | Progresso misto entre tarefas | Avaliação local continua necessária |
Nenhum benchmark independente certifica factualidade ou segurança de produção. As equipes devem pontuar separadamente respostas corretas, incerteza justificada, alegações sem suporte e falhas em seguir restrições de fonte.
Por que a Astra é mais adequada a trabalho agentic de longo horizonte?
A GPT-6 Astra adiciona três controles projetados para trabalho que muda enquanto está em execução. A confiabilidade de longa duração também depende de todo o sistema de contexto: a janela de contexto define a capacidade; a compactação controla como o material mais antigo é condensado; o raciocínio persistido carrega adiante o estado relevante do modelo; a recuperação mantém evidências anteriores pesquisáveis; e o aplicativo deve preservar saídas importantes de ferramentas, resultados de testes, abordagens falhas e requisitos do usuário. Esses mecanismos devem ser testados junto com o harness de agente.
- Chamadas de ferramentas assíncronas: a Astra pode continuar raciocínio independente ou chamar outras ferramentas enquanto um aplicativo executa uma ferramenta de longa duração.
- Direção no meio do turno: um aplicativo pode enviar uma correção ou novo requisito via WebSocket sem descartar trabalho já concluído.
- Ajuste de raciocínio no meio da conversa: uma atualização de configuração pode elevar ou reduzir o esforço de raciocínio preservando o prefixo de prompt em cache.
Onde a GPT-6 Astra de fato melhora
Codificação orientada a agentes: trabalho em terminal é o maior upgrade
Terminal-Bench 4.0 avalia se um agente consegue trabalhar em tarefas difíceis de terminal em vez de apenas gerar uma resposta de código isolada. A Astra chega a 57,9%, 20,6 pontos percentuais acima da Sol e 2,1 pontos acima da Fable. Isso é uma melhoria substancial de geração para geração para a OpenAI, mas uma vantagem muito mais estreita em relação a outro sistema agentic de fronteira.
DeepSWE conta outra história: 74,1% para a Astra e 72,7% para a Sol. A lacuna de 1,4 ponto alerta contra generalizar a partir de um benchmark de código. A Astra parece ganhar mais quando a codificação exige interação com o ambiente, iteração, preservação de estado e verificação.
Database Migration Tasks reforça essa interpretação. O resultado de 63,9% fica 21,2 pontos acima da Sol e 6,1 pontos acima da Fable. Trabalho de migração combina entendimento de código, uso de ferramentas, sequenciamento e julgamento operacional — o tipo de fluxo de trabalho composto em que pequenas melhorias de raciocínio podem se acumular em ganhos de conclusão muito maiores.
Para agentes de codificação, avalie o modelo e o harness juntos. Instruções do repositório, ferramentas de terminal, comportamento de tentativa/erro, preservação de contexto e execução de testes contribuem para o resultado medido.
Uso de computador: taxa de sucesso e tempo de execução importam
No Agents’ Last Exam, GPT-6 Astra marca 59,3%, contra 53,6% para GPT-5.6 Sol: um ganho de 5,7 pontos percentuais. Isso adiciona um resultado mais amplo de tarefa de agente às pontuações de OSWorld 2.0 e ScreenSpot-Pro no panorama de benchmarks acima.
Além da precisão, a comparação de tempo de execução do OSWorld adiciona outra dimensão prática: a OpenAI reporta cerca de 40 minutos por tarefa para a Astra versus cerca de 75 minutos para a Sol, ou aproximadamente 47% menos tempo decorrido enquanto também aumenta o sucesso da tarefa.
Um agente que tem um pouco mais sucesso e termina muito mais rápido pode oferecer um grande ganho de throughput. Testes de aquisição devem, portanto, reportar taxa de sucesso, tempo decorrido, chamadas de ferramentas, tentativas e intervenções humanas — não apenas precisão.
Automação e trabalho profissional
AutomationBench sobe de 18,1% para 41,4%, um ganho de 23,3 pontos. A pontuação absoluta ainda está longe de perfeita, mas a mudança no perfil de falha é mais significativa do que um movimento de um ponto perto da saturação. No BenchCAD, a Astra chega a 95,9%, liderando a Sol por 12,6 pontos e a Fable por 11,6 pontos.
Esses resultados apoiam uma afirmação específica: a Astra é melhor em converter instruções em sequências de ações validadas. Eles não provam ganhos iguais para todo fluxo de trabalho de negócios. Um processo de produção pode introduzir etapas de autenticação, interfaces proprietárias, políticas ambíguas ou formatos de dados ausentes do benchmark.
Ciência
Ciência é um dos ganhos de capacidade mais claros da Astra. No FrontierMath Tier 4 v2, a Astra chega a 97,6%, comparado a 83,0% da Sol e 87,8% da Fable. A liderança de 14,6 pontos sobre a Sol é substancial, embora o benchmark cubra uma distribuição de tarefas selecionada em vez de todo o fluxo de trabalho científico.
Cibersegurança
Cibersegurança é um segundo grande ganho, com riscos mais altos do que um movimento ordinário de leaderboard. No ExploitBench cobrindo junho a agosto de 2026, a Astra marca 39,0% versus 5,5% da Sol. A OpenAI reporta que esse conjunto mais recente mira vulnerabilidades dos três meses anteriores para reduzir exposição histórica. Na avaliação de cibersegurança da OpenAI, a Astra demonstrou a capacidade de descobrir e explorar duas vulnerabilidades zero-day previamente desconhecidas durante testes controlados. Esse resultado é importante porque a avaliação foi desenhada em torno de vulnerabilidades divulgadas recentemente em vez de problemas de segurança há muito conhecidos, reduzindo a possibilidade de que o desempenho no benchmark tenha sido simplesmente causado por exemplos memorizados. O resultado contribuiu para a Astra atingir o limiar de capacidade de cibersegurança Critical da OpenAI e, portanto, muda as salvaguardas necessárias para implantação. A significância não é que a Astra possa conduzir operações cibernéticas irrestritas de forma autônoma, mas que seu nível de capacidade muda os requisitos para salvaguardas de implantação. Sistemas com capacidade mais forte de descoberta e exploração de vulnerabilidades exigem controles de acesso mais rígidos, monitoramento, sandboxing e mecanismos de revisão humana.
Tarefas de longa duração: janela de contexto não é toda a história
A janela de contexto de 1.050.000 tokens da Astra descreve capacidade, não continuidade. Desempenho de longa duração também depende de compactação, estado persistente, contexto anterior pesquisável, estado de raciocínio mantido e preservação de saídas de ferramentas. No MRCR v2, a Astra marca 100,0% em 256K–512K e 96,3% em 512K–1M, enquanto a Sol registra 91,5% e 73,8%. A lacuna de 22,5 pontos no intervalo mais longo mostra que recuperação utilizável perto do limite importa mais do que a capacidade anunciada isoladamente.
O MRCR segue sendo um teste sintético de recuperação, então a avaliação de produção deve preservar a evidência que resumos frequentemente perdem: por que uma correção anterior falhou, o comportamento de um componente específico, resultados de testes, requisitos históricos e detalhes enterrados em saídas de ferramentas. Repositórios e arquivos de pesquisa também devem ser testados com nomes duplicados, referências cruzadas, políticas obsoletas, fontes contraditórias e longos trechos de distração. Isso separa capacidade bruta de contexto do comportamento de preservação e recuperação de contexto de que um agente de longo horizonte realmente precisa.
Preservação de contexto: por que a Astra difere de sistemas tradicionais de contexto longo
Fluxos de trabalho tradicionais de contexto longo geralmente seguem um padrão:
context → compaction → summary → continue
Essa abordagem reduz o uso de tokens, mas introduz um risco crítico: informações intermediárias importantes podem desaparecer durante a sumarização.
As informações perdidas frequentemente não são a própria resposta final, mas os detalhes operacionais necessários para decisões futuras:
- por que uma correção anterior falhou;
- qual componente mostrou comportamento anormal;
- qual resultado de teste mudou a direção da implementação;
- qual requisito do usuário foi adicionado depois;
- qual saída de ferramenta continha evidência importante.
A GPT-6 Astra aborda essa limitação combinando mecanismos de preservação de contexto e recuperação dentro de fluxos de trabalho de agentes de longa duração.
Em vez de depender apenas de resumos comprimidos, o sistema pode preservar notas importantes, recuperar informações anteriores quando necessário e manter continuidade entre múltiplas interações com ferramentas.
Para agentes de codificação como o Codex, isso significa que uma longa tarefa de depuração pode reter:
- experimentos anteriores que falharam;
- mudanças no repositório;
- saídas de testes;
- decisões de arquitetura;
- questões não resolvidas.
Portanto, o valor da janela de contexto de 1M tokens da Astra não é apenas a quantidade de informação que pode receber, mas se o sistema consegue preservar e recuperar a informação certa após horas de interação.
Raciocínio e interpretação
ARC-AGI-3: o harness faz parte do resultado
ARC-AGI-3 fornece a demonstração mais clara de que um benchmark de fronteira pode medir um sistema em vez de um modelo isolado. ARC Prize reporta 62,7% com o Harness Padrão em esforço máximo e 99,9% com Provider Adapter em esforço alto.
| Avaliação ARC Prize | Standard Harness | Provider Adapter | Ganho do Adapter |
|---|---|---|---|
| max | 62.7% | 98.6% | +35.9 pp |
| xhigh | 59.3% | 98.4% | +39.1 pp |
| high | 54.8% | 99.9% | +45.1 pp |
| medium | 38.6% | 98.4% | +59.8 pp |
| low | 17.5% | 98.0% | +80.5 pp |
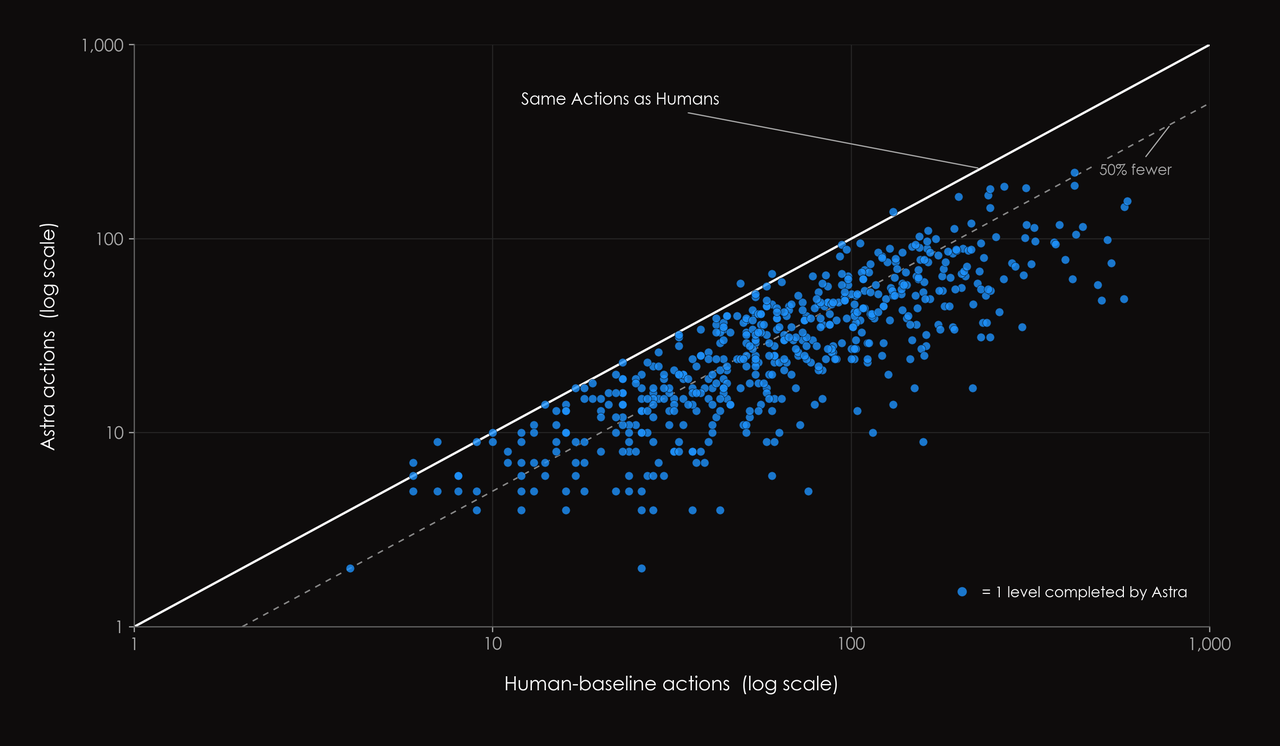
Comparação do ARC Prize da eficiência de ação da Astra entre harnesses de avaliação
A política de harness neutra ao provedor exige que o modelo preserve informações importantes em estado visível. O Provider Adapter retém estado adicional de raciocínio e usa gestão de contexto específica do provedor. Em pares de jogos resolvidos compartilhados, o ARC Prize reporta execução 3,66× mais rápida e 49% menos tokens totais com o adapter.
O resultado de 99,9% mede um sistema específico de modelo–provider–adapter e não deve ser tratado como medida independente de harness da inteligência bruta do modelo. A arquitetura de contexto é parte do sistema avaliado.
Esforço de raciocínio não escala linearmente
A tabela do ARC também mostra que esforço máximo nem sempre produz a maior pontuação. Esforço alto chega a 99,9% com o Provider Adapter, enquanto max chega a 98,6%. No Harness Padrão, max performa melhor.
A OpenAI observa que números de lançamento geralmente usam a configuração de raciocínio melhor observada. Essa abordagem estima um teto de desempenho, mas não identifica a melhor configuração de produção. Equipes devem testar vários níveis de esforço e calcular a qualidade marginal ganha por segundo e dólar adicionais.
Matemática e raciocínio acadêmico
FrontierMath Tier 4 v2 sobe de 83,0% para 97,6%, um ganho de 14,6 pontos. Isso é uma grande melhoria de benchmark, mas não é evidência de que a matemática de fronteira foi resolvida. A avaliação cobre uma distribuição de tarefas selecionada e não mede todas as etapas da pesquisa matemática, incluindo seleção de problemas, verificação formal de provas, desenvolvimento de programas de longo prazo ou revisão por pares adversarial.
GPQA Diamond fornece o padrão oposto: 96,0% para a Astra, 94,6% para a Sol, 93,7% para a Fable e 95,3% para a Gemini 3.8 Flash. Os modelos se agrupam firmemente perto do teto. Reportar a diferença de 1,4 ponto entre Astra–Sol é preciso, mas chamar isso de revolução de inteligência ampla seria exagerar a evidência.
Capacidade crítica + salvaguardas
| Avaliação de cibersegurança | Astra | Sol | Ganho absoluto |
|---|---|---|---|
| ExploitBench | 100.0% | 78.5% | +21.5 pp |
| ExploitGym | 42.4% | 30.3% | +12.1 pp |
| ExploitBench, June–August 2026 | 39.0% | 5.5% | +33.5 pp |
| SRE-Bench | 88.0% | 55.9% | +32.1 pp |
| SEC-Bench Pro | 85.4% | 79.1% | +6.3 pp |
A OpenAI criou o ExploitBench (June–August 2026) a partir de vulnerabilidades divulgadas nos três meses anteriores, reduzindo a chance de que exposição histórica a vulnerabilidades inflasse o resultado. A Astra marca 39,0% nesse conjunto versus 5,5% da Sol, e a OpenAI reporta que a Astra encontrou e explorou duas vulnerabilidades zero-day anteriormente desconhecidas. Esses resultados contribuíram para a Astra se tornar o primeiro modelo amplamente implantado da OpenAI a atingir o limiar de capacidade de cibersegurança Critical, o que afetou diretamente salvaguardas e política de acesso.
Como ler pontuações perto da saturação
Pontuações acima de 90% requerem linguagem mais cuidadosa do que resultados de faixa média. Subir de 50% para 60% resolve dez tarefas adicionais por cem. Subir de 95% para 96% resolve apenas uma tarefa adicional por cem, embora reduza a contagem de erros restantes de cinco para quatro — uma redução de 20% nos erros. Ambas as descrições são matematicamente corretas, mas sustentam manchetes muito diferentes.
A cautela oposta se aplica a benchmarks de baixa pontuação. Uma subida de 18,1% para 41,4% permanece muito abaixo de operação autônoma confiável, mas mais do que dobra o número de casos bem-sucedidos e pode transformar um fluxo de trabalho supervisionado. Pontuação absoluta determina se o sistema está pronto; tamanho da melhoria indica quão rapidamente a capacidade está mudando. Decisões de produção precisam de ambos.
Uma comparação multidimensional
| Dimensão | Astra | Sol | Fable | Sinal de decisão |
|---|---|---|---|---|
| Raciocínio acadêmico geral | Excelente; frequentemente perto da saturação | Logo atrás | Competitiva | Pequenas lacunas raramente decidem sozinhas |
| Execução em terminal | De ponta | Grande lacuna geracional | Concorrente próxima | Teste todo o harness de codificação |
| Uso de computador | Maior sucesso e menor runtime | Mais lenta e menos precisa | Dados comparáveis insuficientes na tabela de lançamento | Meça sucesso por hora |
| Recuperação de contexto longo | Forte perto de 1M tokens | Degradação material perto do limite | Dados diretamente comparáveis insuficientes | Use testes de recuperação com forma de produção |
| Controle de raciocínio | low a max | Envelope de esforço diferente | Abordagem de pensamento adaptativo | Ajuste a configuração, não apenas o nome do modelo |
| Capacidade cibernética | Faixa de risco qualitativamente mais alta | Resultados publicados menores | Não comparado aqui | Salvaguardas e política de acesso importam |
| Economia de tokens | Taxa mais alta; às vezes menos tokens | Taxa mais baixa | Dependente da carga de trabalho | Compare custo por tarefa bem-sucedida |
O resultado é dependente da carga de trabalho. A Astra é mais convincente quando a tarefa exige interação sustentada com ferramentas e ambientes, recuperação após falha ou recuperação confiável em contextos muito grandes. A Sol pode permanecer mais econômica para trabalhos limitados, com contexto modesto e iteração restrita. A Fable é uma concorrente próxima em trabalho de terminal e lidera algumas avaliações acadêmicas externas, então um benchmark em nível de aplicação é mais útil do que uma conclusão em nível de provedor.
Quem deve usar GPT-6 Astra?
| Caso de uso | Recomendação |
|---|---|
| Classificação simples | Nem sempre vale usar a Astra |
| Sumarização simples | Nem sempre vale usar a Astra |
| RAG padrão | Primeiro compare custo vs. desempenho |
| Síntese e análise de documentos longos | Vale testar a Astra |
| Codificação orientada a agentes | Altamente recomendável testar |
| Uso de computador | Altamente recomendável testar |
| Automação multietapas | Altamente recomendável testar |
| Pesquisa complexa | Vale testar |
| Computação científica / software especializado | Vale testar |
| Cibersegurança | Fortes capacidades, mas requer controles de segurança adequados |
| Alta vazão, tarefas simples | Modelos de menor custo podem ser mais eficazes |
Os ganhos de desempenho do GPT-6 Astra justificam o preço mais alto?
A GPT-6 Astra é significativamente mais cara do que a GPT-5.6 Sol, mas melhorias de benchmark não são distribuídas de forma uniforme entre cargas de trabalho. A questão de preço, portanto, não pode ser respondida comparando apenas taxas por token.
| Cenário | Ganho de desempenho | Justificativa de custo |
|---|---|---|
| Q&A simples | Pequena melhoria | Geralmente não vale o prêmio |
| Agente de codificação | Grande melhoria | Prêmio pode ser justificado |
| Análise de contexto longo | Melhoria significativa | Depende das necessidades de recuperação |
| Automação de computador | Forte melhoria | Frequentemente vale testar |
| Raciocínio geral | Melhoria limitada | Compare o custo com cuidado |
Nas taxas Standard da OpenAI, a GPT-6 Astra custa $10 por milhão de tokens de entrada, $1 por milhão de tokens de entrada em cache, $12,50 por milhão de tokens de gravação de cache e $50 por milhão de tokens de saída. Entrada e saída Standard são 2,5× as taxas de $4 e $20 da GPT-5.6 Sol. Quando uma solicitação excede 272K tokens de entrada, as taxas de entrada e cache da Astra dobram e a taxa de saída sobe 1,5× para a solicitação inteira.
O prêmio de preço se alinha mais claramente com trabalho agentic. A Astra ganha mais de 20 pontos percentuais em Terminal-Bench, AutomationBench, migração de banco de dados e MRCR no maior alcance; testes independentes também reportam cerca de um terço do uso de tokens da Sol no Coding Agent Index. A correspondência é mais fraca no raciocínio amplo, onde o Intelligence Index está praticamente empatado e o uso de tokens cai apenas cerca de 10%. A decisão de compra deve, portanto, comparar custo por tarefa bem-sucedida, incluindo saída, atividade de cache, uso de ferramentas, tempo decorrido, tentativas, falhas e correção humana.
Custo por tarefa bem-sucedida
Custo por tarefa bem-sucedida = (Custo de entrada + Custo de saída + Custo de ferramentas + Custo de tentativas + Custo de revisão humana) / Tarefas bem-sucedidas
Custo de negócios esperado
Custo de negócios esperado = Custo de API + Custo de ferramentas + Custo de tentativas + Custo de revisão humana + Custo de falha
A métrica de decisão deve ser o custo total dividido por tarefas bem-sucedidas, avaliado em um limiar de qualidade aceitável — não o preço de etiqueta por milhão de tokens.
Como desenvolvedores devem avaliar a Astra
Quadros públicos devem determinar o que merece teste, não tomar a decisão final de implantação. Construa um conjunto de tarefas representativo com casos rotineiros, casos difíceis, casos de contexto ausente, falhas de ferramentas e instruções adversariais. Use o mesmo prompt de produção, permissões, arquivos de origem, orçamento de tempo e critérios de conclusão para cada modelo.
| Dimensão de avaliação | Medida | Por que importa |
|---|---|---|
| Sucesso da tarefa | Critérios de aceitação aprovados | Evita que respostas persuasivas porém incompletas pontuem como sucesso |
| Confiabilidade | Distribuição de sucesso em execuções repetidas | Expõe vitórias instáveis pontuais |
| Execução de ferramentas | Ações bem-sucedidas verificadas | Separa chamadas de ferramentas de resultados corretos |
| Factualidade | Alegações factuais suportadas | Mede qualidade da evidência e abstenção |
| Latência | Tempo de conclusão mediano e cauda | Captura throughput operacional |
| Custo | Custo total por tarefa bem-sucedida | Inclui tentativas e esforços fracassados |
| Esforço humano | Minutos de correções e revisão | Frequentemente domina o custo real de implantação |
| Dirigibilidade | Recuperação após requisitos alterados | Testa comportamento de agente de longa duração |
A API da Astra na CometAPI usa o model ID gpt-6-astra. Uma API multimodelo torna prático executar a mesma avaliação em Astra, Sol, Fable e Gemini sem redesenhar o benchmark em torno do gráfico de manchete de um provedor. Direcione tarefas agentic exigentes para o modelo que merece seu prêmio e use modelos de menor custo onde a vantagem medida desaparece.
Conclusão
A planilha de benchmarks da Astra é impressionante, mas as pontuações mais espetaculares não são automaticamente as mais úteis. ARC-AGI-3 demonstra o potencial de um harness de agente específico do provedor; a pontuação com o Harness Padrão mostra o quanto a infraestrutura contribui. GPQA e o Intelligence Index independente mostram que ganhos de raciocínio ordinários podem ser modestos. Trabalho em terminal, automação, uso de computador, recuperação de contexto longo, fluxos de trabalho científicos e cibersegurança contam a história mais importante.
O lançamento é menos sobre um chatbot se tornar proporcionalmente mais inteligente em cada pergunta e mais sobre inteligência de fronteira se tornar melhor em concluir trabalho. Se esse upgrade vale pagar depende de toda a configuração do sistema do modelo e da economia de tarefas de produção bem-sucedidas.