Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
เริ่มต้นฟรี เริ่มต้นฟรี
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog Gemini 4 เอาชนะ GPT-6 และ Claude Fable 5.1 ได้แล้วหรือยัง? อธิบายผลเบนช์มาร์กที่หลุดออกมา Gemini 4 เอาชนะ GPT-6 และ Claude Fable 5.1 ได้แล้วหรือยัง? อธิบายผลเบนช์มาร์กที่หลุดออกมา - CometAPI
new / งานวิจัย CometAPI
Gemini 4 เอาชนะ GPT-6 และ Claude Fable 5.1 ได้แล้วหรือยัง? อธิบายผลเบนช์มาร์กที่หลุดออกมา Gemini 4 จะทำผลงานได้ดีกว่า GPT-6 Astra ของ OpenAI และ Claude Fable 5.1 ของ Anthropic ในเกณฑ์มาตรฐานสำคัญด้านเอเจนต์และการเขียนโค้ด โดยบางส่วนเชื่อมโยงการปรับปรุงประสิทธิภาพเข้ากับ RSI.
Anna ทีมวิจัยโมเดล AI และ API Gemini 4 จะทำผลงานได้ดีกว่า GPT-6 Astra ของ OpenAI และ Claude Fable 5.1 ของ Anthropic ในเกณฑ์มาตรฐานสำคัญด้านเอเจนต์และการเขียนโค้ด โดยบางส่วนเชื่อมโยงการปรับปรุงประสิทธิภาพเข้ากับ RSI.
ใช้สรุปนี้เพื่อดูคำตอบอย่างรวดเร็ว แล้วอ่านคู่มือเพื่อดูบริบท ตัวอย่าง และรายละเอียดการใช้งาน
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)สรุปย่อ ผลทดสอบที่หลุดออกมาและการทดสอบแบบเงียบบน Arena.ai ในช่วงกลางเดือนกันยายน 2026 ชี้ว่า Gemini 4 Pro ของ Google ซึ่งยังไม่เปิดตัว กลายเป็นผู้นำแนวหน้ารุ่นใหม่ แซง GPT-6 Astra และ Claude Fable 5.1 ในด้านวิศวกรรมซอฟต์แวร์ งานเชิงเอเจนต์ งานความรู้ การให้เหตุผล และชุดเกณฑ์มาตรวัดแบบมัลติโหมด
ประเด็นสำคัญ
Gemini 4 Pro นำหน้าผลประเมินที่หลุดบน DeepSWE v1.1 (88.7%), GDPval-AA v2 (2064 Elo), Terminal-bench 2.1 (95.3%), OSWorld-2.0 (86.8%) และชุดงานเอเจนต์/การให้เหตุผลอื่นๆ อีกหลายรายการตั้งราคาต่ำกว่า GPT-6 Astra ($12/$60) และ Claude Fable 5.1 ($10/$50) ขณะเดียวกันมีหน้าต่างบริบทระดับ 1M-class ที่เทียบเท่าหรือสูงกว่า
การทดสอบแบบสเตลธ์บน Arena.ai ภายใต้ชื่อชั่วคราว (เช่น gemini-3.8-flash) ให้เดโค้ด SVG, Three.js และการโค้ดเชิงเอเจนต์ที่โดดเด่น
มีข่าวลือเรื่อง RSI (recursive self-improvement) แต่ยังไม่มีหลักฐานสาธารณะว่ามีการปรับปรุงโมเดลแบบวนปิดสำหรับตัว Gemini 4 เอง
เรียนรู้ต่อ
เชื่อมโยงบทความนี้กับการตัดสินใจถัดไป ดูทุกหัวข้อ เผยแพร่เมื่อ Sep 20, 2026 อัปเดตล่าสุด Sep 28, 2026 ตรวจสอบความชัดเจน การอ้างอิงแหล่งที่มา และคำศัพท์ API ปัจจุบันแล้ว
Google ยืนยันการลงทุนอย่างหนักในโมเดลฐาน Gemini 4 ที่ใหญ่ขึ้น แต่กำหนดการเปิดตัวสู่สาธารณะยังไม่เป็นทางการ แพลตฟอร์มอย่าง CometAPI ได้รวมโมเดล Gemini, GPT-6 Astra , Claude Fable/Opus และโมเดลอื่นๆ อีกหลายร้อยโมเดลไว้หลังปลายทางแบบเข้ากันได้กับ OpenAI ในอัตราค่าใช้จ่ายที่แข่งขันได้—เหมาะสำหรับเบนช์มาร์กแนวหน้ารุ่นใหม่ทันทีที่เปิดตัว
เรารู้อะไรบ้างเกี่ยวกับ Gemini 4 ? (ข่าวหลุด แหล่งที่มา และบริบทที่ยืนยันแล้ว) ณ วันที่ 20 กันยายน 2026 Gemini 4 Pro ยังไม่ได้รับการประกาศอย่างเป็นทางการจาก Google ไม่มี model card หรือปลายทาง API สาธารณะ ทุกอย่างนอกเหนือจากถ้อยแถลงก่อนหน้าของ Google เกี่ยวกับการลงทุนใน “โมเดลฐาน Gemini 4 ที่ใหญ่กว่า” (ประกาศผลประกอบการเดือนกรกฎาคม 2026) มาจากข่าวหลุดของชุมชน การทดสอบแบบปิดบังบน Arena.ai และตารางเกณฑ์มาตรวัดที่เผยแพร่หมุนเวียนกัน
แหล่งและข้ออ้างอิงสำคัญ ได้แก่:
ผู้ปล่อยข่าวหลุด Pankaj Kumar และโพสต์ต่อเนื่อง (ช่วงต้นถึงกลางกันยายน) กล่าวถึงเช็คพอยต์ภายในรุ่น Pro พร้อมคาดการณ์เปิดสาธารณะในเดือนตุลาคม และอาจมีรุ่น Flash-Lite ก่อนหน้า
นักพัฒนาหลายรายรายงานว่าได้เรียกใช้โมเดลสมรรถนะสูงที่ติดป้ายว่า “gemini-3.8-flash” (หรือชื่อชั่วคราวใกล้เคียง) บน Arena.ai เอาต์พุตรวมถึงการสร้าง SVG ที่ซับซ้อน (เช่น นกกระทุงขี่จักรยาน ผีเสื้อจักรกลใน Three.js) การสร้าง JSON ยาวแบบไม่ซ้ำซ้อน และพฤติกรรมเอเจนต์ที่แข็งแรง บางรายอ้างถึงรายละเอียดแบ็กเอนด์ เช่น บริบทระดับหลายล้านโทเค็น เพดานเอาต์พุต 256k หน่วยความจำข้ามเซสชัน และความสามารถเครื่องมือ/อินเทอร์เน็ตแบบเนทีฟ
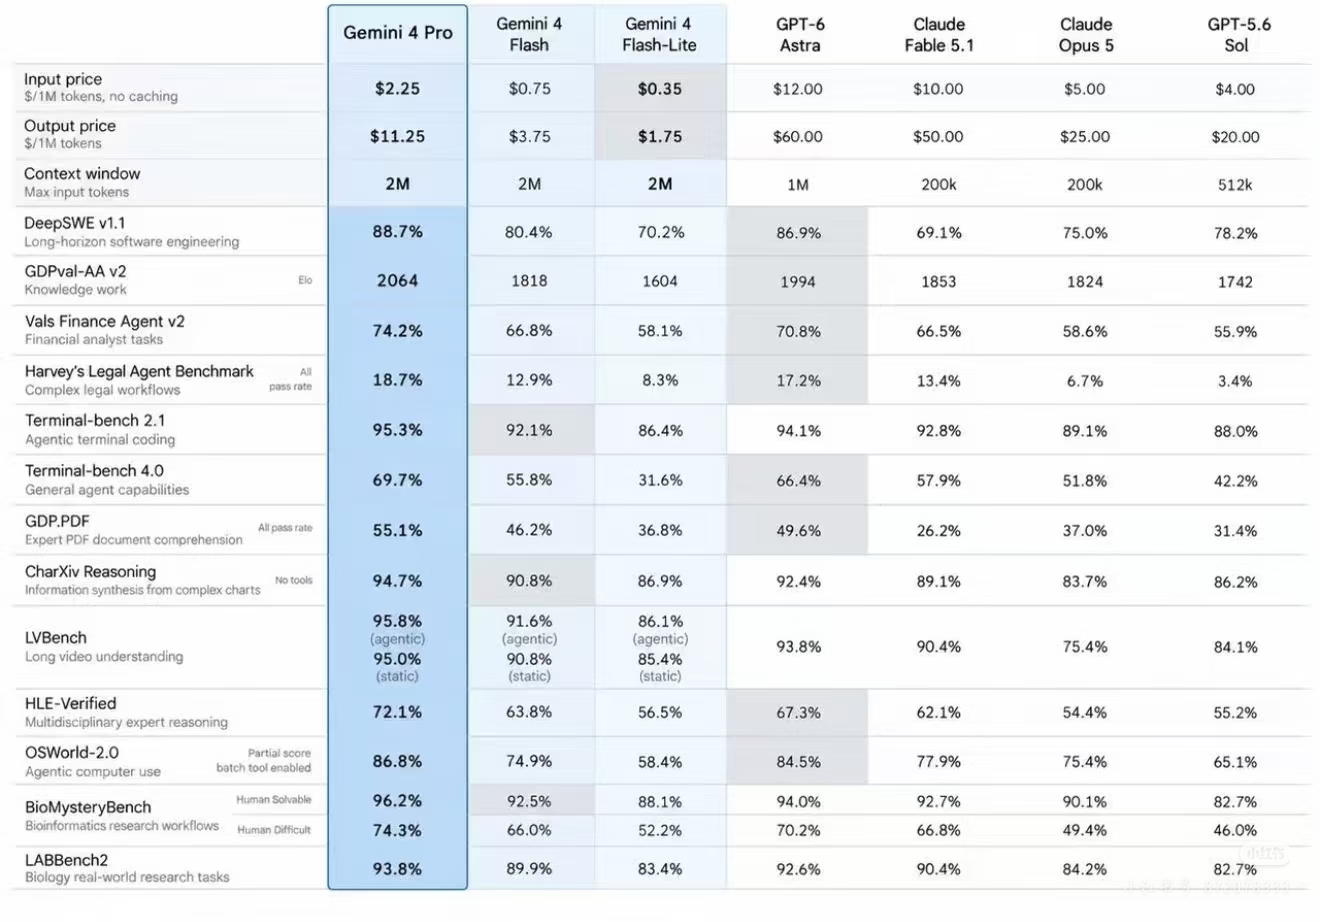
มีตารางเปรียบเทียบที่ถูกแชร์อย่างกว้างขวางซึ่งระบุ Gemini 4 Pro เทียบกับ Gemini 4 Flash, Gemini 4 Flash-Lite, GPT-6 Astra, Claude Fable 5.1, Claude Opus 5 และ GPT-5.6 Sol
Google ยังไม่ยืนยันการทดสอบบน Arena หรือในตารางดังกล่าว รูปแบบในอดีตชี้ว่าบริษัทมักทำการประเมินแบบสเตลธ์บนแพลตฟอร์มสาธารณะล่วงหน้าหลายสัปดาห์ก่อนเปิดตัวจริง
หน้าต่างบริบท ตารางที่หลุดแสดงอินพุตสูงสุด 2M โทเค็นสำหรับตระกูล Gemini 4—เป็นสองเท่าของ 1M ของ GPT-6 Astra และสูงกว่ามากเมื่อเทียบกับ 200k ของสาย Claude Fable/Opus 5 (บางรุ่นของ Claude เคยเสนอหน้าต่างที่มีผลลัพธ์ใหญ่กว่าได้ด้วยกลไกอื่น) ข้ออ้างเรื่อง ghost-routing บางส่วนลือถึงเพดาน 10M; ยังไม่ได้รับการยืนยัน
ราคา Gemini 4 (ตัวเลขที่หลุด) ตารางที่เผยแพร่หมุนเวียนระบุ:
Gemini 4 Pro: $2.25 อินพุต / $11.25 เอาต์พุต ต่อ 1M โทเค็น (ไม่มีแคช)
Gemini 4 Flash: $0.75 / $3.75
Gemini 4 Flash-Lite: $0.35 / $1.75
ตัวเลขเหล่านี้ต่ำกว่าอัตรา $12/$60 ของ GPT-6 Astra และ $10/$50 ของ Claude Fable 5.1 อย่างมาก (Fable 5.1 มีส่วนลด cache-read เชิงรุกที่ทำให้ต้นทุนที่มีผลลดลงสำหรับเวิร์กโหลดเชิงเอเจนต์) ราคาทางการปัจจุบันของ Gemini 3.x Pro อยู่ในช่วงอินพุต $2–$4 / เอาต์พุต $12–$18 ขึ้นกับความยาวบริบท ดังนั้นตัวเลขของรุ่น Pro ที่หลุดมาจึงดูเป็นไปได้ในฐานะการปรับของเจเนอเรชันถัดไป
ราคาสาธารณะจริงจะทราบเมื่อเปิดตัว Google ในอดีตมักใช้อัตราโทเค็นที่แข่งขันได้และมีระดับใช้ฟรีเพื่อขับเคลื่อนการยอมรับ
ประสิทธิภาพของ Gemini 4 Pro: เจาะลึกเกณฑ์มาตรวัดที่หลุด ตารางที่หมุนเวียนกันจัดวาง Gemini 4 Pro ไว้บนสุดเกือบทุกหมวด ตัวเลขเหล่านี้ยัง “ไม่เป็นทางการและยังไม่ได้รับการยืนยัน” จาก Google หรือห้องทดลองอิสระ ณ เวลาที่เขียน ควรถือเป็นสัญญาณเชิงทิศทางมากกว่าการจัดอันดับที่ชัดเจน
วิศวกรรมซอฟต์แวร์และการโค้ดแบบเอเจนต์
DeepSWE v1.1 (วิศวกรรมซอฟต์แวร์ระยะยาว): 88.7% (เทียบกับ GPT-6 Astra 86.9%, Claude Fable 5.1 69.1%, Claude Opus 5 75.0%)
Terminal-bench 2.1 (การโค้ดเชิงเอเจนต์ในเทอร์มินัล): 95.3% (เทียบกับ Astra 94.1%, Fable 92.8%)
Terminal-bench 4.0 (ความสามารถเอเจนต์ทั่วไป): 69.7% (ช่องว่างสัมพัทธ์ที่ใหญ่ที่สุดเมื่อเทียบกับ Flash และคู่แข่ง)
งานความรู้และงานระดับมืออาชีพ
GDPval-AA v2 (Elo, งานความรู้): 2064 (เป็นโมเดลเดียวที่เกิน 2000; Astra 1994, Fable 1853)
Vals Finance Agent v2: 74.2%
Harvey’s Legal Agent Benchmark (เวิร์กโฟลว์กฎหมายที่ซับซ้อน อัตราผ่านทั้งหมด): 18.7%
การให้เหตุผล มัลติโหมด และเฉพาะทาง
CharXiv Reasoning (สังเคราะห์ข้อมูลจากกราฟซับซ้อน ไม่ใช้เครื่องมือ): 94.7%
LVBench (ความเข้าใจวิดีโอยาว): 95.8% แบบเอเจนต์ / 95.0% แบบสแตติก
HLE-Verified (การให้เหตุผลโดยผู้เชี่ยวชาญสหสาขา): 72.1%
OSWorld-2.0 (การใช้งานคอมพิวเตอร์แบบเอเจนต์ คะแนนบางส่วน เปิดใช้เครื่องมือแบบ batch): 86.8%
BioMysteryBench & LABBench2 (ชีวสารสนเทศและเวิร์กโฟลว์วิจัยชีววิทยา): คะแนนนำทั้งชุดที่มนุษย์แก้ได้และชุดที่ยาก
หากผลเหล่านี้ถูกต้องในเชิงทิศทาง แสดงให้เห็นถึงความแข็งแกร่งเป็นพิเศษในงานระยะยาวหลายขั้นตอนที่ใช้เครื่องมือ—ตรงกับพื้นที่ที่ GPT-6 Astra และ Claude Fable 5.1 ถูกวางโพสิชันให้เป็นผู้นำหลังการเปิดตัวช่วงต้นกันยายน
การทดสอบเชิงคุณภาพบน Arena สนับสนุนภาพดังกล่าว: การสร้าง SVG และ Three.js ที่ซับซ้อนจากโมเดลสเตลธ์ถูกตัดสินว่าดีกว่าหรือแข่งขันได้สูงเมื่อเทียบกับ Astra ในการเปรียบเทียบแบบเคียงข้างกันโดยชุมชน
Gemini 4 จะทำงานอย่างไร? Gemini 4 (Pro) ยังไม่เปิดตัว ดังนั้นคำอธิบายว่า “จะทำงานอย่างไร” ต้องอ้างอิงจากถ้อยแถลงอย่างเป็นทางการของ Google รายละเอียดที่หลุดเล็กน้อยเกี่ยวกับเช็คพอยต์ภายในช่วงต้น เส้นทางพัฒนาของตระกูล Gemini 3.x และข้อสรุปทางวิศวกรรมที่สมเหตุสมผล สิ่งต่อไปนี้ไม่ควรถือเป็นสเปกที่ยืนยันแล้ว
แนวทางการฝึกและสเกล Google อธิบายว่า Gemini 4 คือ “การรัน pre-training ที่ทะเยอทะยานที่สุดจนถึงปัจจุบัน” สร้างบนโมเดลฐานที่ใหญ่กว่าอย่างมีนัยสำคัญกว่าเจเนอเรชันก่อน เป้าหมายชัดเจนเพื่อคงความสามารถระดับแนวหน้า โดยเฉพาะในการโค้ดและเอเจนต์อัตโนมัติ
จำนวนพารามิเตอร์ที่ใหญ่ขึ้นหรือความจุที่มีประสิทธิภาพมากขึ้น (ผ่าน mixture-of-experts ความเบาบางที่ดีขึ้น หรือสเกลแบบหนาแน่น)
การลงทุนคอมพิวต์ที่หนักขึ้นระหว่างการ pre-training
เน้นข้อมูลฝึกแบบมัลติโหมดต่อเนื่อง (ข้อความ รูปภาพ วิดีโอ เสียง โค้ด ทราจ็กทอรีการใช้เครื่องมือ)
คาดว่าโมเดลนี้จะทำหน้าที่เป็นฐานความสามารถสูงรุ่นใหม่ที่สามารถแตกสายรุ่น Flash ที่เร็วกว่าในภายหลัง
สไตล์การอินเฟอเรนซ์และการให้เหตุผล คำบรรยายที่หลุดของเช็คพอยต์ช่วงต้นชื่อ “argon” กล่าวถึงโหมด High thinking-effort ที่ใช้เวลาประมาณ 2.4 นาทีต่อการสร้างหนึ่งครั้ง และรองรับเพดานเอาต์พุตที่สูงขึ้นอย่างมาก (รายงานที่ 256k โทเค็น เทียบกับเดิมราวๆ 64k)
เส้นทางการให้เหตุผลที่ใช้คอมพิวต์หนักเป็นตัวเลือก (คล้ายโหมดคิดขยายหรือ “ความพยายามสูงสุด” ในโมเดลคู่แข่ง)
ความสามารถในการใช้การคำนวณภายในมากขึ้นกับปัญหายากก่อนให้คำตอบ
การรองรับเอาต์พุตยาวและสอดคล้องมากขึ้น เช่น โค้ดเบสครบถ้วน แผนหลายขั้น หรือรายงานยาว
ผู้ใช้น่าจะสามารถควบคุมการแลกเปลี่ยนระหว่างความเร็ว/ต้นทุนกับความลึกของการให้เหตุผลได้ เช่นเดียวกับรุ่น Gemini Flash ปัจจุบันที่มีระดับการคิดต่ำ/กลาง/สูง
พื้นที่ความสามารถหลักที่เน้น อ้างอิงจากถ้อยแถลงสาธารณะของ Sundar Pichai และเส้นทางพัฒนา:
การโค้ดและวิศวกรรมซอฟต์แวร์ แข็งแกร่งขึ้นในงานระยะยาว: รีแฟกเตอร์หลายไฟล์ ดีบักข้ามรีโพ การวนลูปแก้ไขตัวเอง และอัตราสำเร็จที่สูงขึ้นในงานซอฟต์แวร์สมจริง
พฤติกรรมอัตโนมัติ/เชิงเอเจนต์ ความสามารถในการวางแผน ใช้เครื่องมือ สังเกตผลลัพธ์กลางทาง กู้คืนจากข้อผิดพลาด และเดินหน้าสู่เป้าหมายหลายขั้นดีขึ้น สิ่งนี้ต่อยอดจากคุณสมบัติการใช้คอมพิวเตอร์และเอเจนต์ที่มีอยู่ใน Gemini 3.5/3.8 Flash
ความน่าเชื่อถือของบริบทยาว รายงานจากชุมชนกล่าวถึงเป้าหมายในช่วง 1.5 ล้านโทเค็น (หรือมากกว่า) เป้าหมายเชิงปฏิบัติไม่ใช่แค่หน้าต่างใหญ่ขึ้น แต่เป็นการดึงข้อมูลกลับที่แม่นยำและลดการเสื่อมเมื่อทำงานกับเอกสารยาวมาก โค้ดเบส หรือทราซเอเจนต์หลายชั่วโมง
ความเข้าใจและการสร้างแบบมัลติโหมด การจัดการข้อความ + รูปภาพ + วิดีโอ + เสียงแบบเนทีฟ พร้อมคาดว่าดีขึ้นในเหตุผลเชิงพื้นที่ ความเข้าใจวิดีโอ และปฏิสัมพันธ์เสียง/เอเจนต์แบบเรียลไทม์ (ต่อยอดจากรุ่น Gemini 3.8 Live กันยายน 2026)
การใช้เครื่องมือและเอาต์พุตมีโครงสร้าง การเรียกฟังก์ชันที่แข็งแรงขึ้น การรันโค้ด การค้นหาที่มีแหล่งอ้างอิง และเอาต์พุต JSON/XML เชิงโครงสร้างที่น่าเชื่อถือสำหรับการผนวกเข้ากับแอปและเอเจนต์
แตกต่างจาก Gemini 3.x อย่างไร
สเกล: โมเดลฐานใหญ่ขึ้นอย่างชัดเจน ไม่ใช่การเกลาเพิ่มทีละน้อย
ความจุเอาต์พุต: เพดานโทเค็นที่สูงขึ้นตามข่าวหลุด ทำให้สร้างยาวได้ในครั้งเดียว
ความลึกในการให้เหตุผล: โหมดความพยายามสูงที่ชัดเจนขึ้นสำหรับปัญหายาก
โฟกัสเอเจนต์: เน้นงานอัตโนมัติหลายขั้นระยะยาวมากกว่างานแบบครั้งเดียวหรือระยะสั้น
การวางโพสิชัน: ตั้งใจให้เป็นโมเดล Pro ระดับแนวหน้ารุ่นใหม่ ขณะที่สาย Flash เดินหน้าเร่งรอบเพื่อความเร็วและความคุ้มค่า
ความสัมพันธ์กับการปรับปรุงตนเองแบบวนซ้ำ (RSI) ผู้บริหาร Google เชื่อมโยงการใช้จ่ายทุน AI ขนาดใหญ่ของบริษัทกับเป้าหมายระยะยาวของการปรับปรุงตนเองแบบวนซ้ำ—ระบบที่สามารถปรับปรุงตนเองหรือกระบวนการที่สร้างเจเนอเรชันถัดไปได้อย่างมีนัยสำคัญ งานวิจัยที่เกี่ยวข้อง (เช่น งาน Dream-RSI) แสดงเอเจนต์ที่ปรับปรุงกลยุทธ์การสำรวจของตนเองโดยไม่เปลี่ยนน้ำหนักโมเดล
Gemini 4 Pro จะเหนือกว่า GPT-6 และ Claude Fable 5.1 หรือไม่? ราคาอินพุต/เอาต์พุต $2.25 / $11.25 $12.00 / $60.00 $10.00 / $50.00 Gemini 4 Pro ถูกกว่า Astra ราว ~5× หน้าต่างบริบท 2M 1M 200k ได้เปรียบอย่างมีนัยสำคัญสำหรับ Gemini DeepSWE v1.1 88.7% 86.9% 69.1% ขึ้นนำด้านการโค้ดอย่างชัดเจน GDPval-AA v2 (Elo) 2064 1994 1853 นำในงานความรู้ Terminal-bench 4.0 69.7% 66.4% 57.9% ความสามารถเอเจนต์ทั่วไป OSWorld-2.0 86.8% 84.5% 77.9% การใช้งานคอมพิวเตอร์ HLE-Verified 72.1% 67.3% 62.1% การให้เหตุผลระดับผู้เชี่ยวชาญ LVBench (วิดีโอ) 95.8% / 95.0% 93.8% 90.4% ความแข็งแกร่งด้านมัลติโหมด วิจัยด้านชีวฯ/LAB Highest scores Strong
Gemini 4 Pro นำหน้าใน “ทุกแถวหลัก” ในตาราง โดยมักทิ้งระยะอย่างมีนัยสำคัญ ขณะเดียวกันราคาที่อ้างอิงมีความก้าวร้าวกว่าทั้ง GPT-6 Astra และ Claude Fable 5.1 มาก
ข้อควรระวังสำคัญ
ตารางนี้ไม่ใช่ประกาศอย่างเป็นทางการของ Google ณ วันที่ 20 กันยายน 2026 Google ยังไม่เผยแพร่ model card ปลายทาง API ราคา หรือเกณฑ์มาตรวัดที่ยืนยันแล้วสำหรับ Gemini 4 Pro ตัวเลขมาจากแหล่งชุมชน/การพบเห็นบน Arena/ข่าวหลุดเช็คพอยต์ภายใน (เกี่ยวข้องกับโค้ดเนม “argon”)
แผ่นข้อมูลที่หมุนเวียนก่อนหน้านี้บางฉบับถูกชี้ว่าเป็นการคาดการณ์หรือคัดลอกบางส่วน ควรถือทุกเปอร์เซ็นต์และราคาว่า “ยังไม่ยืนยัน” จนกว่า Google จะประกาศ
หน้าต่างบริบทของ Claude Fable 5.1 ที่ระบุไว้เป็น 200k ต่ำกว่าตัวเลข 1M ที่เอกสารทางการของ Anthropic ระบุทั่วไป อาจสะท้อนการตั้งค่าเฉพาะของการประเมินหรือเป็นข้อผิดในตารางที่หลุด
GPT-6 Astra และ Claude Fable 5.1 ยังคงเป็นโมเดลแนวหน้าที่เปิดสาธารณะและถูกประเมินอย่างอิสระเพียงสองรายในตอนนี้ ตัวติดตามภายนอกอย่าง Artificial Analysis ยังชี้ว่าทั้งสองสูสีโดยรวม (แต่มีจุดแข็งต่างกัน)
สภาพความเป็นจริงเชิงปฏิบัติ (20 กันยายน 2026) Gemini 4 Pro ยังไม่เปิดตัว (อ้างว่าทรงพลัง) บริบทยาว การโค้ด เอเจนต์ มัลติโหมด ต้นทุน ก้าวร้าวมาก (อ้างอิง) GPT-6 Astra เปิดตัวแล้ว คณิต การใช้คอมพิวเตอร์ เทอร์มินัล อัตโนมัติ ไซเบอร์ พรีเมียม Claude Fable 5.1 เปิดตัวแล้ว เอเจนต์ระยะยาว การให้เหตุผล คุณภาพการโค้ด ประสิทธิภาพการอ่านแคช พรีเมียม Gemini 4 Flash / Flash-Lite อ้างว่าเป็นรุ่นพี่น้อง เวิร์กโหลดเน้นความเร็ว + ประหยัดต้นทุน ต่ำมาก
สรุปเร็ว
ครองอันดับในทุกหมวด: Gemini 4 Pro อยู่ที่ #1 ในทุกหมวดที่ระบุ โดยมากทิ้งระยะชัดเจน
จุดแข็งเฉพาะ: การโค้ด/เอเจนต์ระยะยาว (DeepSWE, Terminal-bench) งานความรู้ มัลติโหมด (วิดีโอ + กราฟ) และโดเมนเฉพาะ (การเงิน กฎหมาย ชีววิทยา การใช้งานคอมพิวเตอร์)
การวางราคา: ราว 1/5 ของ GPT-6 Astra และ Claude Fable 5.1 ทั้งฝั่งอินพุตและเอาต์พุต ขณะให้คะแนนสูงกว่า
Astra เน้นการใช้คอมพิวเตอร์ เกณฑ์ความปลอดภัยไซเบอร์ และการค้นพบทางวิทยาศาสตร์; Fable 5.1 เน้นงานความรู้ระยะยาว การโค้ดที่กลั่นกรอง การป้องกัน และต้นทุนอ่านแคชที่ต่ำกว่า โปรไฟล์ที่หลุดของ Gemini 4 Pro ดูจะแข็งแกร่งที่สุดในวิศวกรรมซอฟต์แวร์เชิงเอเจนต์กว้างๆ และการให้เหตุผลแบบมัลติโหมด
ระหว่างรอการเข้าถึง Gemini 4 Pro อย่างเป็นทางการ ทีมงานจะได้ประโยชน์จากเกตเวย์แบบหนึ่งเดียวที่รองรับแนวหน้าปัจจุบันอยู่แล้ว (ตระกูล Gemini 3.x, GPT-6 Astra, Claude Fable 5.1 / Opus 5 และโมเดลอื่น 500+ รายการ) CometAPI ให้สิ่งนั้น: ปลายทางเดียวที่เข้ากันได้กับ OpenAI ใช้คีย์เดียว ระบบคิดเงินตามการใช้งานที่มักถูกกว่าผู้ให้บริการโดยตรง 20–40% และความสามารถในการสลับโมเดลด้วยการเปลี่ยนพารามิเตอร์เดียว
สร้างต้นแบบไปป์ไลน์เอเจนต์บน Gemini Flash/Pro ปัจจุบัน, GPT-6 Astra และ Claude Fable 5.1 ผ่าน CometAPI
เบนช์มาร์กพรอมต์เดียวกันข้ามโมเดลเพื่อสร้างเส้นฐาน
เมื่อ Gemini 4 Pro (และรุ่น Flash) ปรากฏในแค็ตตาล็อกของ CometAPI—โดยปกติแพลตฟอร์มจะเพิ่มโมเดล Google ใหม่อย่างรวดเร็ว—เปลี่ยนค่า model ID แล้วรันประเมินซ้ำโดยแทบไม่ต้องแก้โค้ด
ใช้แดชบอร์ดต้นทุนเพื่อติดตามการใช้โทเค็นข้ามผู้ให้บริการ และกำหนดเส้นทางทราฟฟิกปริมาณสูงหรือไวต่อเวลาไปยังโมเดลที่คุ้มค่าที่สุดซึ่งยังคงตอบโจทย์ความสามารถ
แนวทางนี้ช่วยตัดปัญหาคีย์หลายตัว ลดความเสี่ยงการล็อกอินผู้ขาย และทำให้ทีมพร้อมรับ Gemini 4 Pro ตั้งแต่วันแรกที่เปิดสาธารณะ
หากข่าวหลุดถูกต้องในเชิงทิศทาง Gemini 4 Pro คือความพยายามที่แข็งแกร่งที่สุดของ Google ในการทวงตำแหน่งแนวหน้าในวิศวกรรมซอฟต์แวร์เชิงเอเจนต์และการให้เหตุผลแบบมัลติโหมดบริบทยาว การผสมผสานระหว่างสมรรถนะที่อ้างอิง หน้าต่างบริบทใหญ่ และการตั้งราคาที่ก้าวร้าว จะทำให้มันเป็นตัวเลือกเริ่มต้นในเวิร์กโหลดการผลิตจำนวนมาก จนกว่าจะมีการเปิดตัวทางการและการประเมินอิสระ แนวทางที่รอบคอมือตือการเบนช์มาร์กอย่างต่อเนื่องบนโมเดลแนวหน้าที่เปิดอยู่—ทำได้ง่ายผ่านแพลตฟอร์มที่รวมการเข้าถึงไว้แล้ว จับตาประกาศทางการในอีกไม่กี่สัปดาห์ข้างหน้าเพื่อดูว่าความคาดหวังจะแปลงเป็นความจริงเชิงผลิตได้มากน้อยเพียงใด
คำถามที่พบบ่อย
Gemini 4 Pro เปิดตัวแล้วหรือยัง? ยังไม่ได้เปิดตัว จากแค็ตตาล็อกล่าสุดและถ้อยแถลงของ Google (ช่วงกลางถึงปลายกันยายน 2026) ยังไม่มีการเปิดสาธารณะหรือระบุรหัสโมเดลอย่างเป็นทางการ
คาดว่าจะเปิดตัว Gemini 4 Pro เมื่อใด? ผู้ปล่อยข่าวหลุดระบุเดือนตุลาคม 2026 (มีการคาดเดาปลายกันยายนบ้าง) Google ยังไม่ได้ให้วันทางการ ควรมองเป็นช่วงเวลาโดยรอการยืนยันผ่านแค็ตตาล็อก API หรือบล็อกโพสต์
Google บรรลุ RSI กับ Gemini 4 Pro หรือไม่? หลักฐานสาธารณะชี้ให้เห็นถึงการใช้ลูปเอเจนต์ขั้นสูงเพื่อปรับปรุงโมเดลและการวิจัยเรื่องการปรับปรุงเชิงกลยุทธ์แบบวนซ้ำ (เช่น Dream-RSI) ข้ออ้างเรื่อง RSI แบบเต็มที่ทำให้เกิดโมเดลนี้ยังไม่ได้รับการยืนยันจากอิสระ
เทียบกับ GPT-6 Astra และ Claude Fable 5.1 บนเกณฑ์มาตรวัดอย่างไร? ชาร์ตจากชุมชนที่หลุดอ้างว่านำในหลายชุดงานเอเจนต์/การโค้ด ยังไม่มีคะแนนที่เปิดเผยและยืนยันอย่างเป็นทางการสำหรับ Gemini 4 Pro ที่เปิดตัวแล้ว ข้อมูลสาธารณะปัจจุบันแนะนำให้ประเมินโมเดลที่ใช้งานได้จริง (Astra และ Fable 5.1) กับงานของคุณ
ควรรอ Gemini 4 Pro ก่อนเริ่มพัฒนาหรือไม่? ไม่ควร เริ่มส่งงานด้วยโมเดลที่แข็งแกร่งที่สุดที่มีอยู่วันนี้ (เข้าถึงผ่าน CometAPI หรือ API โดยตรง) เตรียมชุดประเมินไว้ และรับรุ่นใหม่เมื่อถึงเวลา หากการทดสอบอิสระและภายในของคุณยืนยันความคุ้มค่า
จะเข้าถึงโมเดลแนวหน้าปัจจุบันได้ง่ายจากที่ใด? ผู้ให้บริการแบบรวมอย่าง CometAPI มีการเข้าถึงที่เข้ากันได้กับ OpenAI ไปยังโมเดลระดับ GPT-6 Astra, Claude Fable 5.1, Gemini ปัจจุบัน และอื่นๆ พร้อมการเรียกเก็บเงินที่ง่ายและการสลับโมเดลที่สะดวก ตรวจดูรายชื่อโมเดลสดและเอกสารเพื่อดู ID และราคาล่าสุด
เวิร์กโฟลว์เชิงวิทยาศาสตร์