
TL;DR
Google, 30 Eylül 2026'da Gemini 4 Argon'u karmaşık, uzun süreli iş akışları için bir öncü model olarak duyurdu. Yayınlanan sonuçlar net bir desen gösteriyor: profesyonel bilgi işi, uzun bağlam görevleri ve seçili yazılım mühendisliği değerlendirmelerinde güçlü performans; bazı terminal ve bilgisayar kullanımı kıyaslamalarında ise daha zayıf sonuçlar. Google, modeli kademeli bir şekilde kullanıma sunuyor. Ayrı olarak, CometAPI 1 Ekim itibarıyla katalog erişilebilirliği bildiriyor; dağıtımdan önce hesap uygunluğu ve başarılı bir test isteği doğrulanmalıdır. Daha faydalı performans hikayesi, kazanımların nerede ortaya çıktığıdır.
Argon, Vals Index'te %68.9, Vals Finance Agent v2'de %65.4, DeepSWE v1.1'de %77.9, LVBench'te %91.7 ve GraphWalks'ta 256K–1M bağlamda %84.2 skor alıyor. Aynı zamanda FrontierSWE v2, Terminal-Bench 4.0, Terminal-Bench Science ve OSWorld-2.0'da rakip öncü modellerin gerisinde kalıyor.
Sonuçlar, Argon için iş yüküne özgü bir bakışı destekliyor. En güçlü skorları profesyonel bilgi işi, çok uzun bağlam görevleri ve seçili çok modlu ile yazılım mühendisliği değerlendirmeleri etrafında kümeleniyor. Diğer modeller, çeşitli terminal ve bilgisayar kullanımı testlerinde avantajlarını koruyor.
Key Takeaways
- Gemini 4 Argon, kurumsal bilgi işi, uzun bağlamlı muhakeme, çok modlu anlama ve bazı uzun ufuklu kodlama değerlendirmelerinde en güçlüdür.
- 1 milyon token’lık maksimum çıktı limiti, uzun muhakeme süreçleri için daha fazla üretim marjı sağlar; halka açık bir girdi-bağlam spesifikasyonu ortaya koymaz.
- Argon, bazı yayımlanmış bilgi işi ve uzun bağlam sonuçlarında önde, ancak GPT-6 Astra ve Claude Opus 5.5 bazı kodlama ve bilgisayar kullanımı değerlendirmelerinde ileridedir.
- Kıyaslama skorları, belirli model ve ajan yapılandırmalarını tarif eder. Metrikler, girdi koşulları ve değerlendirme ayarları, manşet yüzdeleri kadar önemlidir.
- Google'ın yayılımı ve CometAPI erişimi ayrı erişilebilirlik iddialarıdır. Trafiği taşımadan önce etkin yol, model tanımlayıcısı ve hesap uygunluğunu doğrulayın.
What Is Gemini 4 Argon?
Gemini 4 Argon, kısa bir soruya yanıt vermekten ziyade birçok adım boyunca muhakeme gerektiren zorlu iş akışlarına odaklanan Google DeepMind'ın yeni öncü Gemini modelidir.
Google’ın resmi konumlandırması gerçek dünya yazılım mühendisliği, hukuk ve finans gibi kurumsal bilgi işi, savunmacı siber güvenlik, çok modlu anlama ve uzun süreli ajan tabanlı görevleri vurguluyor.
Bu, son Flash sürümlerinden önemli bir ayrımdır. CometAPI'deki Gemini 3.8 Flash API ölçekli ajan iş yükleri için daha düşük maliyetli bir iş atı olarak tasarlanmıştır. Argon ise Google'ın yığınının öncü ucunu temsil eder, derinliği ve sürdürülebilir yürütmeyi önceliklendirir.
Model Specifications
| Specification | Gemini 4 Argon |
|---|---|
| Developer | Google DeepMind |
| Announced | September 30, 2026 |
| Model family | Gemini 4 |
| Positioning | Frontier reasoning and long-horizon model |
| Maximum output | 1,000,000 tokens |
| Long-context evaluation | Tested through 256K–1M on GraphWalks |
| Public input context limit | Not formally specified in a standard public API spec table at launch |
| Multimodal understanding | Yes; includes charts, documents and long-video evaluation |
| Agentic coding | Yes |
| Computer use | Evaluated |
| Cybersecurity | Specialized defensive capabilities |
| Google public API model ID | Not announced in Google's initial public documentation; CometAPI uses gemini-4-argon as its catalog identifier. |
Output Budget and Trade-offs
Google, Argon için maksimum çıktı limitini 1 milyon token olarak duyuruyor; bu, lansman duyurusunda belirtilen önceki 64K limitinden yüksek. Bu, daha uzun muhakeme süreçleri için marj sağlar. Ancak bu, çok çağrılı bir ajan oturumunun tamamı için garanti edilmiş toplam bir bütçe ya da her görevin iyileşeceğinin kanıtı olarak yorumlanmamalıdır.
Maksimum çıktı zekayla aynı şey değildir. Bir modele daha fazla çıktı token’ı vermek otomatik olarak daha yetkin yapmaz; yalnızca olası bir darboğazı kaldırır. Modelin o bütçeyi verimli kullanması gerekir.
Ayrıca maliyet ve gecikme açısından bir ödünleşim vardır. Yüz binlerce token üreten bir model, nominal token başı fiyat cazip görünse bile pahalı ve yavaş olabilir.

Makaledeki seçili kıyaslama sonuçları yeniden üretildi. Modelleri her satır içinde karşılaştırın; metrikler ve değerlendirme koşulları farklıdır. Bu grafik, dekoratif gradyan görselinin yerine geçer ve bağımsız bir test temsil etmez.
Maksimum çıktı limiti ve bir girdi bağlam penceresi farklı kapasiteleri açıklar. GraphWalks değerlendirme aralığı, test edilen girdilere dair kanıttır; halka açık bir API spesifikasyonunun yerine geçmez.
How Does Gemini 4 Argon Perform on Benchmarks?
Google DeepMind'ın performans tablosu, ajan iş akışları, profesyonel bilgi işi ve çok modlu görevleri kapsar. Aşağıdaki değerler, yayınlanan karşılaştırmayı yeniden üretir. Bunlar görev performansını ölçer; token çıktısı veya yanıt gecikmesini değil; “—” bu karşılaştırmada bir sonucun raporlanmadığı anlamına gelir.
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | Evaluation conditions |
|---|---|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% | Vals AI |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% | Private set; Zapier leaderboard |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% | Vals AI |
| Harvey's Legal Agent | 19.6% | 5.4% | 6.7% | 3.8% | Vals AI |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% | mini-swe harness; mixed sources |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% | Proximal leaderboard |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% | Vals AI leaderboard |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% | Self-test / leaderboard |
| PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% | v1.1; OpenCode; 10h; one H100 |
| Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% | Verifier timeout ×6 |
| LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% | Linux tools; internet |
| RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% | Surge leaderboard |
| GraphWalks up to 128K | 99.7% | 98.7% | 91.4% | 90.6% | BFS F1; 650 items |
| GraphWalks 256K–1M | 84.2% | 71.8% | 65.0% | 66.8% | BFS F1; 200 items |
| Agent's Last Exam | 39.5% | 34.2% | — | 38.2% | Binary pass; ALE-Claw; 5h |
| OSWorld-2.0 | 69.2% | 72.6% | — | — | Offline partial score; best of 3 runs |
| Chartography | 71.6% | 71.0% | 46.2% | 66.3% | No tools; Surge leaderboard |
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% | No tools; model-specific frame sampling |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% | pass@1; pass@4 breaks ties |
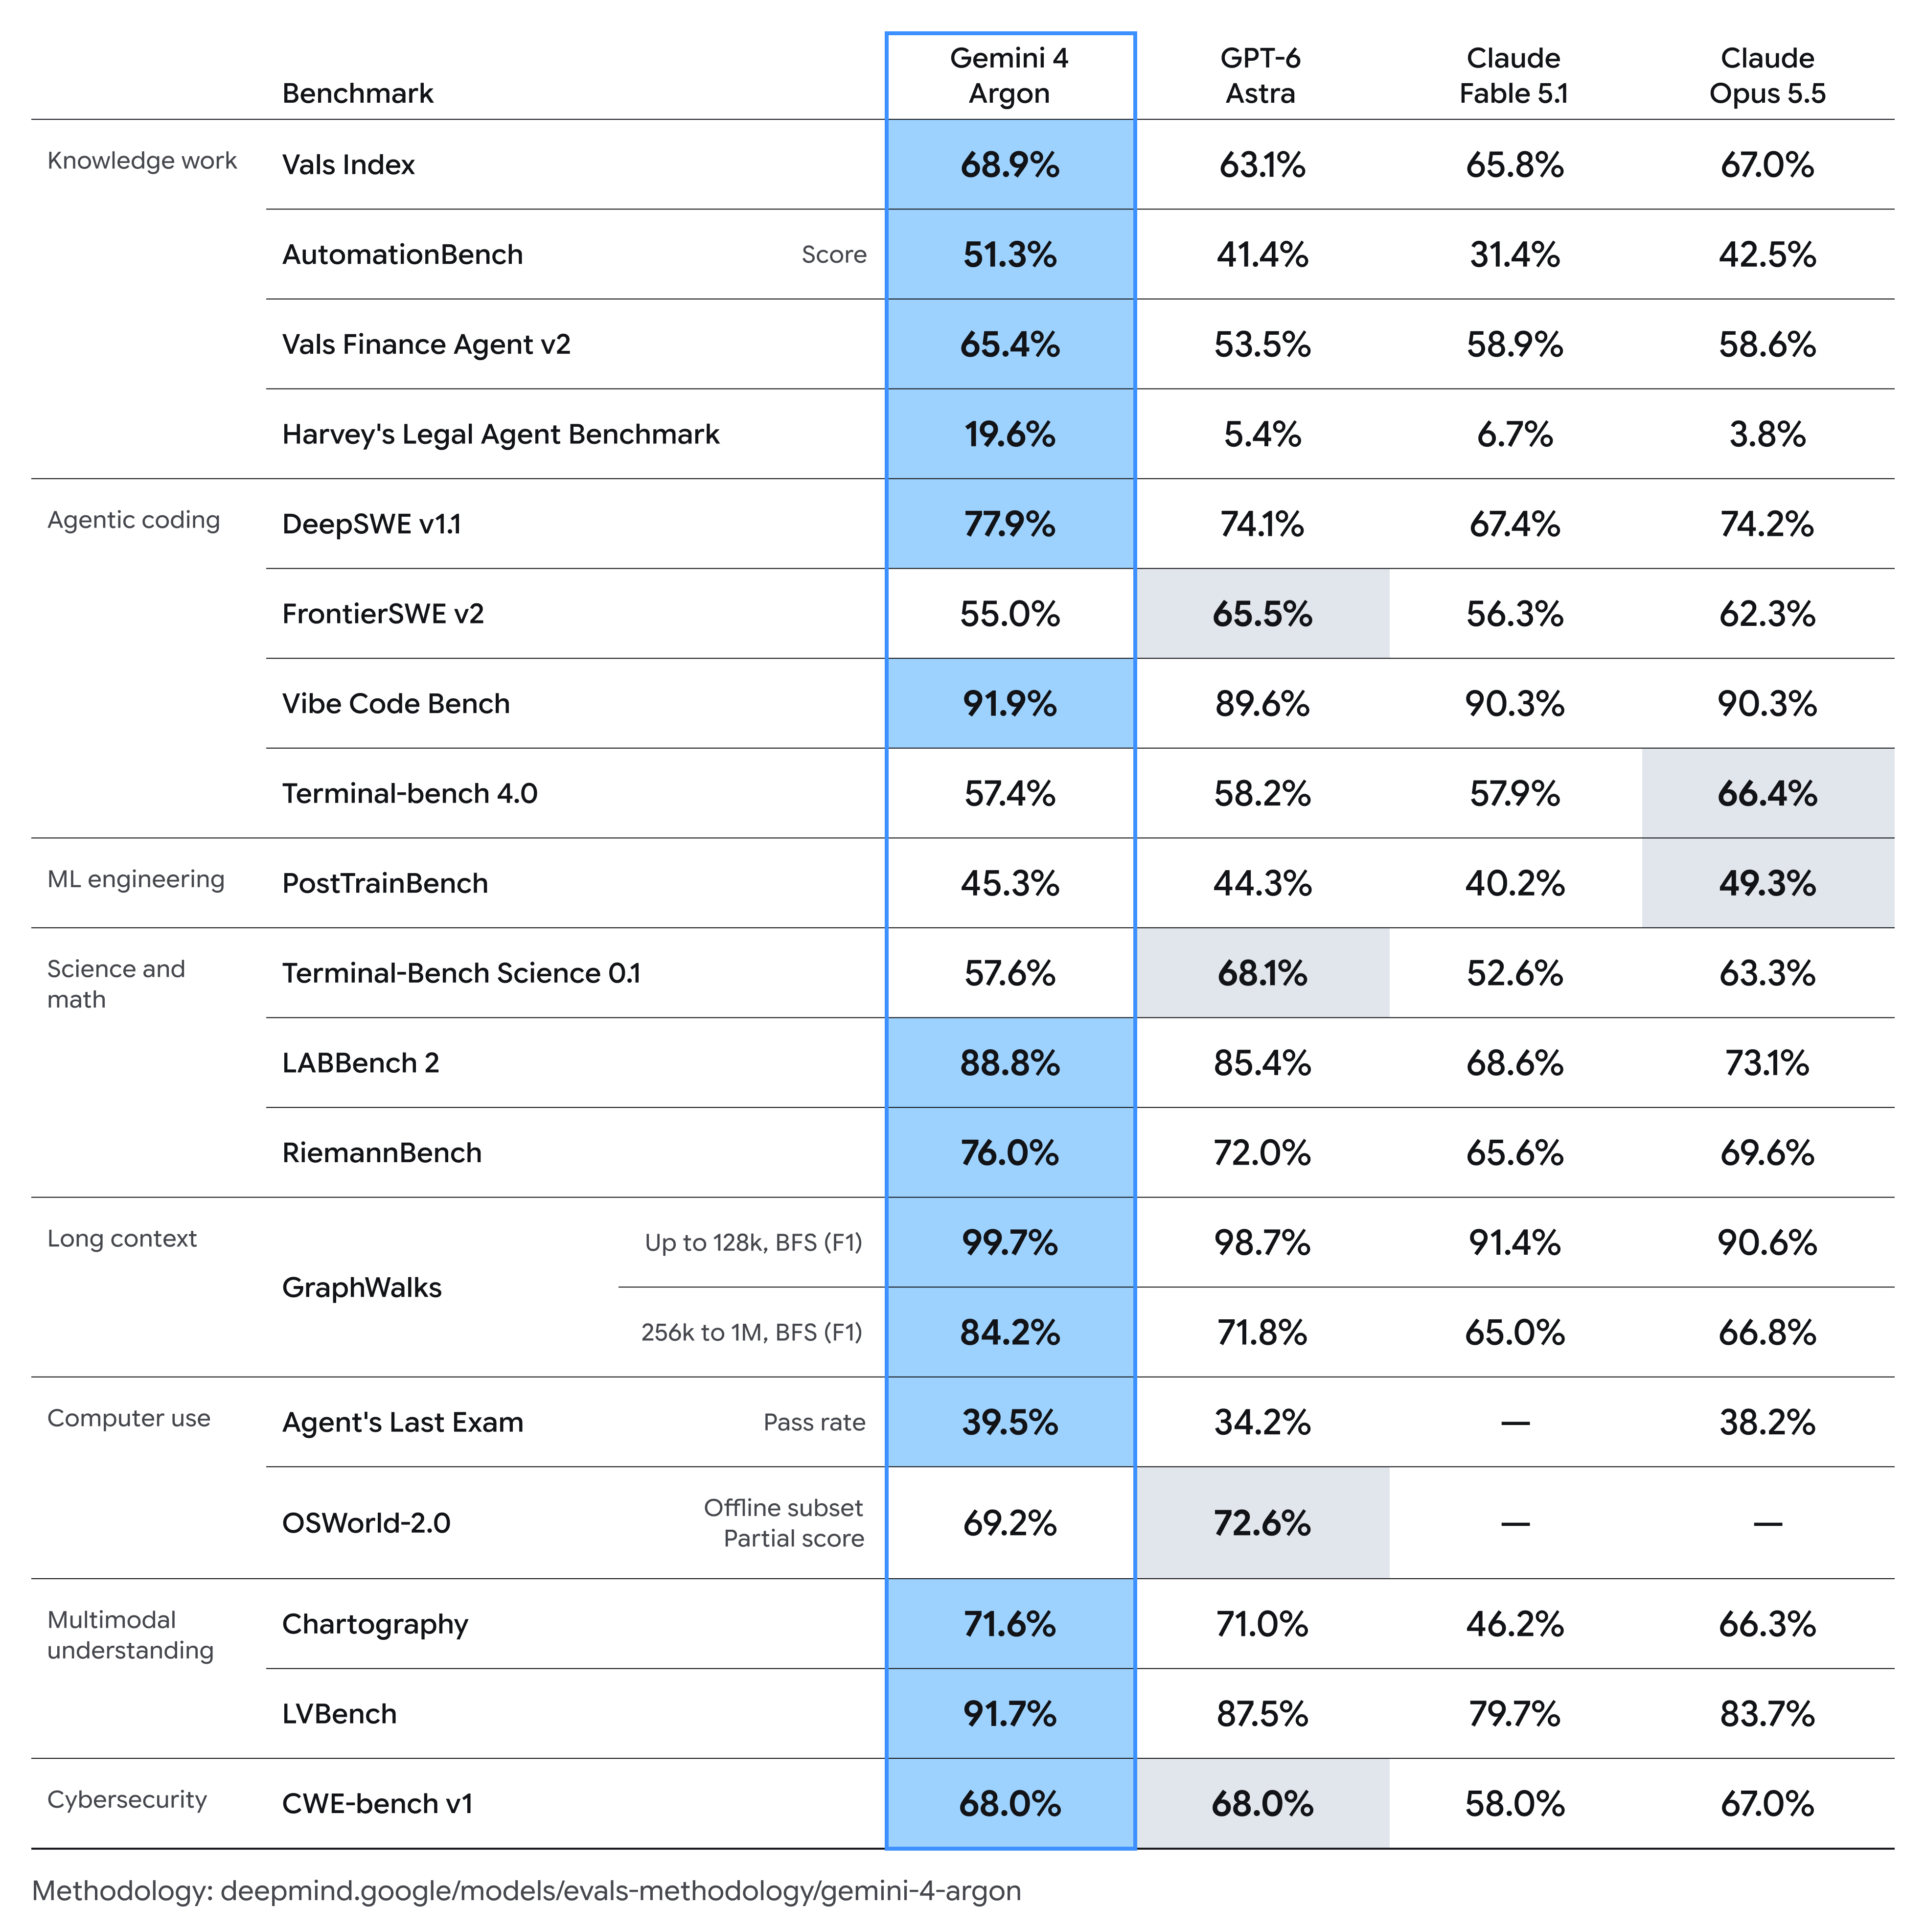
Google'ın resmi Gemini 4 Argon karşılaştırmalı kıyaslaması
Aksi belirtilmedikçe, Argon sonuçları tek deneme ve en yüksek düşünme ayarını kullanır. Diğer model sonuçları genellikle sağlayıcı raporlarından gelir; kıyaslama bazlı istisnalarla. LVBench, Gemini için 1 FPS, GPT-6 Astra için 800 kare, Fable 5.1 için 300 ve Opus 5.5 için 600 kullanır. Bu girdiler özdeş değildir; her satırı kontrol edilmiş bir yeniden koşum gibi görmek yerine bildirilen yapılandırmaları karşılaştırın.
Evaluation Conditions and Limitations
Tablo faydalıdır, ancak bağımsız, evrensel bir liderlik tablosu olarak yorumlanmamalıdır.
- Kıyaslama seçimi Google'ın seçimidir.
- Kıyaslamaya özgü değerlendirme ayarları satırlar arasında farklıdır; ajan çerçeveleri, zaman bütçeleri, araçlar ve girdi örneklemesi dahil.
- Resmi metodoloji, rakip sonuçlarında varsayılan olarak sağlayıcı raporlarını kullanır; kıyaslama bazlı liderlik tabloları ve kendi hesaplanan istisnalarla.
- En yüksek kıyaslama ayarı, varsayılan bir üretim çıkarım yapılandırmasını yansıtmayabilir.
- Başlık bir kıyaslama skoru, token kullanımını, araç çağrılarını, tekrar denemeleri, geçen süreyi veya insan müdahalesini açıklamaz.
Üretim sistemleri için, daha iyi bir metrik genellikle token başına fiyat yerine başarıyla tamamlanan görev başına maliyettir.
Which Workload Is Gemini 4 Argon Best For?
Knowledge Work Performance
Argon'un sonuçlarındaki en net desen, profesyonel, çok adımlı bilgi işinde ortaya çıkar.
Vals Index’te Argon %68.9’a ulaşır; Claude Opus 5.5 için bu değer %67.0’tır. Sayısal fark mütevazıdır, ancak desen, uzmanlaşmış iş akışlarında daha belirginleşir.
- Vals Finance Agent v2: %65.4; Google’ın tablosunda gösterilen en güçlü rakibin 6.5 puan üzeri.
- AutomationBench: %51.3; Claude Opus 5.5’in 8.8 puan üzerinde.
- Harvey's Legal Agent Benchmark: %19.6; raporlanan bir sonraki en yüksek modelde %6.7.
Performans profili, modelin bilgi toplama, durumu koruma, birkaç aşama boyunca muhakeme etme ve yalnızca kapalı uçlu bir soruya yanıt vermek yerine profesyonel bir çıktı üretmesi gerektiğinde Argon'un en çok fayda sağladığını öne sürer.
Düşük mutlak hukuk-ajan skoru da önemlidir. %19.6’lık bir skor tek başına kaç ölçütün veya tam iş akışının başarısız olduğunu ortaya koymaz. Faydalı çıkarım, Argon’un bu değerlendirmede büyük bir göreli iyileşme göstermesidir; bu sonuç, hukuki işlerin güvenilir otomasyonunu tesis etmez.
Long-Context Reasoning
Argon'un en çarpıcı avantajı, GraphWalks’un 256K–1M sürümü olabilir.
- Gemini 4 Argon: %84.2
- GPT-6 Astra: %71.8
- Claude Opus 5.5: %66.8
- Claude Fable 5.1: %65.0
Bu, yayımlanan karşılaştırmada en yakın modele karşı 12.4 puanlık bir avantajdır.
Daha kısa bağlam uzunluklarında fark çok daha küçüktür: 128K’ya kadar GraphWalks’ta Argon %99.7 ve GPT-6 Astra %98.7 skor alır. Bu, Argon’un, karşılaştırılan modellere göre, bu çok uzun bağlam değerlendirmesinde daha yavaş bozulduğunu düşündürür.
Google, bu farkı belirli bir dikkat mekanizmasına, getirme sistemine, eğitim tarifine veya çıkarım zamanı stratejisine atfetmek için yeterli mimari bilgi açıklamamıştır. “Gemini 4 yeni bir dikkat mimarisi sunuyor” gibi iddialar, bu nedenle kamuya açık kanıtların ötesine geçer.
Coding Performance
Resmi kıyaslama tablosu basit bir “evet”i desteklemiyor.
Argon bazı kodlama biçimlerinde son derece iyi performans gösterirken bazılarında açıkça geride kalıyor. DeepSWE v1.1’de %77.9’a ulaşıyor; Claude Opus 5.5 için %74.2 ve GPT-6 Astra için %74.1. Vibe Code Bench skoru da %91.9 ile güçlü.
- FrontierSWE v2: Argon %55.0 vs. GPT-6 Astra %65.5.
- Terminal-Bench 4.0: Argon %57.4 vs. Claude Opus 5.5 %66.4.
- Terminal-Bench Science 0.1: Argon %57.6 vs. GPT-6 Astra %68.1.
Bu bölünme geliştiriciler için önemlidir. Kodlama uzun mühendislik iş akışına, hatırı sayılır bağlama ve planlamaya dönüştüğünde Argon özellikle güçlü görünürken, terminal ağırlıklı yürütme daha rekabetçidir. Bir depo taşıma kıyaslaması ile etkileşimli bir terminal kıyaslamasını “kodlama yeteneğinin” birbirinin yerine geçebilen ölçüleri olarak değerlendirmeyin.
Defensive Cybersecurity
Siber güvenlik temel bir dağıtım alanıdır. Google’ın savunmacı siber güvenlik konumlandırması otonom zafiyet keşfi, doğrulama ve yamalamayı içerir. Bu bir sağlayıcı yetenek iddiasıdır; aşağıdaki CWE-bench sonucu, kendi değerlendirmesinde zafiyet giderimini ölçer.
CWE-bench v1’de Argon %68 skor alır; GPT-6 Astra ile eşit ve Claude Opus 5.5’in %67’sinin biraz önünde.
Google ayrıca kötüye kullanıma karşı daha güçlü korumalar, dolaylı prompt enjeksiyonu, riskli ajan davranışı ve yürütme ortamı ele geçirilmesine karşı önlemleri vurgular. Bu, Argon’u klasik bir model yükseltmesi kadar bir ajan güvenliği sürümü yapar.
Multimodal Understanding
Argon, Chartography’de %71.6 ve uzun video anlama için LVBench’te %91.7 skor alır. LVBench sonucu, Google’ın tablosunda GPT-6 Astra’ya göre 4.2 puan yüksektir. Modeller farklı kare örnekleme yapılandırmaları aldığından, bu, salt model üstünlüğü değil, raporlanan kurulumların bir karşılaştırmasıdır.
Bu önemlidir çünkü birçok profesyonel iş akışı yalnızca metin değildir. Bir finans araştırma ajanı bir grafiği inceleyebilir; bir kurumsal asistan raporları, PDF’leri ve ekran görüntülerini birleştirebilir; bir video analiz sistemi bireysel kareleri bağımsız işlemekte yerine uzun bir dizi boyunca olayları korumak zorunda kalabilir.
Argon’un çok modlu algıyı sürdürülebilir muhakemeyle birleştirmesi, yalnızca çok modlu desteğe göre daha anlamlıdır.
Science and Mathematics Performance
Sonuçlar karışık ama genel olarak güçlü. Argon, LABBench 2’de %88.8 ve RiemannBench’te %76.0’a ulaşır; Google’ın tablosunda karşılaştırılan modellerin önünde. Ancak Terminal-Bench Science 0.1’de GPT-6 Astra %68.1’e ulaşırken Argon %57.6’dadır.
Bu fark daha geniş bir desene işaret eder: Argon, bilimsel bilgiyi muhakeme etmede, araç odaklı bilimsel yürütmenin her biçiminden daha güçlü görünmektedir.
Computer-Use Performance
Agent's Last Exam’de Argon, GPT-6 Astra %34.2 ve Claude Opus 5.5 %38.2 iken, %39.5 ikili geçiş oranı alır. OSWorld-2.0’ın çevrimdışı alt kümesinde kısmi skor %69.2’dir; GPT-6 Astra’nın %72.6’sının altındadır. OSWorld değeri tam görev başarı oranı değildir ve eksik Claude girişleri sıfır yetenek anlamına gelmez.
Dolayısıyla mevcut veriler, bilgisayar kullanımı için her alanda bir üstünlük göstermiyor. Üretim dağıtımında, kıyaslama skorlarını, gezinme doğruluğu, hatalı tıklamalar, tekrar deneme sıklığı, istenmeyen işlemler, tamamlanma süresi ve insan düzeltme oranı gibi görev düzeyi testlerle destekleyin.
Gemini 4 Argon vs GPT-6 Astra and Claude
| Dimension | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|
| Knowledge work | Very strong | Strong | Very strong | Strong |
| Long-context benchmark | Strongest published result | Strong | Moderate–strong | Moderate |
| Long-horizon coding | Very strong | Very strong | Very strong | Strong |
| Terminal coding | Competitive | Strong | Strongest in selected test | Competitive |
| Scientific terminal agents | Competitive | Strongest in selected test | Strong | Competitive |
| Multimodal understanding | Very strong | Very strong | Strong | Competitive |
| Computer use | Competitive | Strong | Mixed / limited comparison | Limited comparison |
| Cybersecurity | Tied at top on CWE-bench v1 | Tied at top | Very close | Lower |
Bu karşılaştırmada Argon, uzun bağlam, belge yoğun ve profesyonel ajan işlerinde öne çıkıyor. Geliştiriciler, CometAPI üzerinden GPT-6 Astra, Claude Opus 5.5 ve Claude Fable 5.1'i karşılaştırabilir.
Performance-based selection
Yukarıdaki nitel etiketler, seçili kıyaslama tablosunu özetler; evrensel bir sıralama değildir. İş, Argon’un lider olduğu değerlendirmelere benziyorsa pilot için Argon’u tercih edin; terminal ağırlıklı iş yüklerinde varsayılan seçmeden önce Astra ve Opus’u test edin.
Specifications and deployment constraints
Bu performans karşılaştırması, bir mimari avantaj veya genel bir fiyat-performans galibi tesis etmez. Argon’un parametre sayısı ve mimarisi, incelenen Google lansman materyallerinde belirtilmemiştir. Halka açık girdi-bağlam sınırı, resmi API dokümantasyonu gerektirir. CometAPI, gemini-4-argon rotasını bildirir; Google’ın daha geniş yayılımından bağımsız olarak desteklenen parametreleri ve hesap erişimini doğrulayın. Dağıtımdan önce her rotanın sınırlarını ve gerçek görev maliyetlerini karşılaştırın.
How Can Developers Access Gemini 4 Argon Through CometAPI?
CometAPI, modeli gemini-4-argon altında mevcut olarak rapor eder. Hesap panosunda bir API anahtarı oluşturun, playground’da bu tanımlayıcıyı seçin ve entegrasyondan önce bir test isteği çalıştırın. OpenAI uyumlu örneği temel URL olarak https://api.cometapi.com/v1 kullanır. Modelin desteklenen uç noktasını ve parametrelerini hesap dokümantasyonunda doğrulayın; yalnızca bir katalog rozeti, başarılı bir çağrının kanıtı değildir.
- Bir CometAPI hesabı oluşturun ve panoda bir API anahtarı üretin.
- gemini-4-argon’u seçin ve playground’da temsilî bir isteği doğrulayın.
- Uyumlu istemciyi CometAPI temel URL’si, anahtarınız ve model tanımlayıcısı ile yapılandırın; dağıtımdan önce desteklenen istek şemasını ve faturalandırmayı doğrulayın.
CometAPI and official pricing
Google, giriş döneminde milyon girdi token’ı başına 2$ ve milyon çıktı token’ı başına 10$ fiyat, önbelleğe alınmış girdiyi ise girdi oranına göre %95 indirimli olarak duyurdu. Giriş döneminden sonra duyurulan oranlar milyon girdi başına 4$ ve milyon çıktı başına 20$. Bunlar Google’ın duyurulan oranlarıdır; CometAPI fiyatları veya anında genel API erişimi onayı değildir.
| Billing basis | Gemini 4 Argon API in CometAPI | Google official announcement | Comparison |
|---|---|---|---|
| Input / 1M tokens | $3.20 | $4.00 after introductory period | 20% below announced post-intro rate |
| Output / 1M tokens | $16.00 | $20.00 after introductory period | 20% below announced post-intro rate |
Conclusion
Gemini 4 Argon'un kıyaslama profili, basit bir liderlik tablosu iddiasından daha ilginçtir.
En güçlü sonuçlar, profesyonel bilgi işi, uzun bağlam ve sürdürülebilir ajan yürütmesi etrafında kümelenir. Bu desen, iş yükü seçimi için faydalıdır; ancak altta yatan mimariyi tanımlamaz veya kazanımlara hangi mekanizmanın neden olduğunu kanıtlamaz.
Raporlanan finans, hukuk, uzun video ve yazılım mühendisliği sonuçları, bu iş yükleri için odaklı bir pilotu destekler. Aynı avantajın üretimde sürüp sürmeyeceği, girdi karması, ajan çerçevesi, çıkarım ayarları ve doğrulama gereksinimlerine bağlıdır.
Aynı zamanda sonuçlar, öncü model performansının giderek daha uzmanlaştığını gösterir. Argon, DeepSWE’de önderlik ederken FrontierSWE’de geride kalabilir; Agent's Last Exam’de liderken OSWorld’de geride kalabilir; LABBench’te önderlik ederken Terminal-Bench Science’ta geri kalabilir. Bu kıyaslamalar, bir ajan sisteminin farklı yönlerini zorlar.
Geliştiriciler için en önemli ders, model seçiminin giderek marka veya aile düzeyinden ziyade iş yükü düzeyinde yapılması gerektiğidir.
FAQ
How should developers validate Gemini 4 Argon on their own workloads?
Temsilî bir görev seti oluşturun ve açık kabul kriterleri belirleyin. Araçlar, zaman sınırları, girdi hazırlığı ve tekrar deneme politikalarını modeller arasında karşılaştırılabilir tutun. Tamamlanan görevleri, toplam token’ları, geçen süreyi ve insan düzeltmesini kaydedin. Küçük bir pilotla başlayın ve üretim trafiğini yönlendirmeden önce hata vakalarını inceleyin.
Can Gemini 4 Argon's benchmark percentages be averaged into one score?
Hayır. Tablo, F1, geçiş oranları ve kısmi skorlar dahil farklı metrikleri birleştirir. Tüm yüzdeleri ortalamak yerine görev odaklı kriterler kullanın.
Should a Gemini 4 Argon agent always use its full output budget?
Hayır. Kalite ve güvenilirlik gereksinimlerinizi karşılayan en küçük test edilmiş bütçeyi seçin. Maksimum çıktı limiti bir tavan olup bir hedef değildir.
How should teams evaluate Gemini 4 Argon access through CometAPI?
Belirtilen CometAPI rotasını kullanarak hesap düzeyi erişilebilirlik kontrolü ve küçük bir istekle başlayın. Yanıt kalitesi, gecikme, limitler ve faturalandırılan token’ları ölçün; ardından alternatif modeller için kullanılan aynı kabul testlerini uygulayın. CometAPI’nin erişim iddiasını Google’ın daha geniş yayılımından ayrı değerlendirin ve rota gereksinimlerinizi karşılayana kadar yönlendirmeyi yapılandırılabilir tutun.