
TL;DR
Claude Fable 5.1, zorlu otonom kodlama ve uzun vadeli işler için daha güçlü benchmark kanıtına sahip. GPT-5.6 Sol, bağımsız maksimum-çaba karşılaştırmasında daha düşük sıradan token maliyetleri, geniş yerel araç yığını ve daha düşük ilk token’a kadar süre sunuyor. Doğru varsayılan, yalnızca en yüksek benchmark puanına değil, başarısız bir görevin maliyetine bağlıdır.
8 Eylül 2026 tarihli Intelligence Index anlık görüntüsünde, Fable 5.1 53, GPT-5.6 Sol ise 47 puan aldı. Çıktı hızı, 69,9 ve 69,8 token/s ile pratikte eşit. Bu sonuçlar kalite-maliyet kararını destekler; evrensel bir hız kazananı belirlemez.
Öne çıkanlar
- Daha yüksek fiyatı kendi değerlendirmelerinizce haklıysa, en zor otonom görevler için Fable 5.1’i seçin.
- Maliyet duyarlı sınır (frontier) çıkarımı ve entegre araçlardan fayda sağlayan uygulamalar için GPT-5.6 Sol ile başlayın.
- Başlangıç gecikmesini çıktı hızından ayrı karşılaştırın: GPT-5.6 Sol’un ölçülen ilk token’a kadar süresi daha düşükken throughput neredeyse eşit.
- Model önbellek yazma, okuma, saklama ve uzun bağlam ücretlerini ayrı değerlendirin. Manşet giriş/çıkış fiyatları her ajan iş yükünü açıklamaz.
Veriler 8 Eylül 2026’da kontrol edilmiştir. Bağımsız sonuçlar, GPT-5.6 Sol’u maksimum çabayla ve Fable 5.1’i Uyarlamalı Muhakeme, Maksimum Çaba, Default Fallback ile kullanır. Sağlayıcı ve bağımsız benchmark’lar farklı değerlendirme kurulumları kullanır. Fiyatlar, aksi belirtilmedikçe milyon token (MTok) başına USD’dır.
GPT-5.6 Sol vs Fable 5.1: hızlı karar
| Boyut | GPT-5.6 Sol | Claude Fable 5.1 | Daha iyi seçenek |
|---|---|---|---|
| Bağımsız Intelligence Index v4.3 (8 Eyl) | 47 | 53 | Fable 5.1 |
| Bağımsız Terminal-Bench 4.0 (7 Eyl) | 39,9% | 52,0% | Fable 5.1 |
| Anthropic-run Terminal-Bench 4.0 | 37,3% | 55,8% | Fable 5.1 |
| Bağlam penceresi | 1,05M | 1M | Pratikte eşit |
| Maksimum çıktı | 128K | 128K | Berabere |
| Metin/görüntü girişi | Yes | Yes | Berabere |
| Resmi giriş fiyatı / MTok | $4 | $10 | Sol |
| Resmi çıkış fiyatı / MTok | $20 | $50 | Sol |
| Resmi önbellek okuma / MTok | $0.40 | $0.25 | Fable 5.1 |
| Bağımsız çıktı hızı (8 Eyl) | 69,8 tok/s | 69,9 tok/s | Pratikte eşit |
| API araç kapsamı | Çok geniş | Güçlü | Sol |
| Uzun süreli otonom çalışma | Mükemmel | Çekirdek güç | Fable 5.1 |
| Maliyet duyarlı üretim | Daha iyi varsayılan | Premium yükseltme | Sol |
Kullanışlı bir başlangıç politikası, rutin frontier işleri için Sol ve bir görev, kalite veya otonomi eşiğinizi geçemediğinde Fable 5.1 ile yükseltme rotasıdır. Bu politikayı, başarılı görev başına maliyete göre doğrulayın.
GPT-5.6 Sol, altı muhakeme çaba düzeyi sunar; “none”dan “max”a, varsayılan “medium”dur. Fable 5.1, her zaman açık uyarlamalı düşünme kullanır; çaba, muhakeme derinliğini kontrol eder ve varsayılan “high”dır.
GPT-5.6 Sol’un ek 50.000 token’lık bağlamı, çoğu mimariyi belirleme olasılığı düşüktür. Bir istek bir milyon tokene yaklaştıkça faturalama ve önbellek yeniden kullanımının önemi artar; aşağıdaki uzun bağlam bölümü nedenini gösterir.
GPT-5.6 Sol nedir?
GPT-5.6 Sol, OpenAI’nin GPT-5.6 ailesinde, zorlu kodlama, araştırma, planlama ve ajan iş akışları için yüksek yetenek katmanıdır. Bu karşılaştırmada temel cazibesi, muhakeme kontrolleri ile çevresindeki yürütme ortamının birleşimidir.
Responses API aracılığıyla GPT-5.6 Sol, geniş bir yerel araç portföyünü destekler: web araması, dosya araması, kod yorumlayıcı, barındırılan kabuk, apply patch, bilgisayar kullanımı, MCP, skills ve araç araması. Bu, bir uygulamanın entegre etmesi gereken ayrı çalışma zamanı bileşenlerinin sayısını azaltabilir.
OpenAI ayrıca aile için programatik araç çağırma ve çok ajanlı yürütmeyi tanımlar. Bu platform özellikleri, bir modelin tek bir yanıt döndürmek yerine araçlar arasında işi koordine etmesi gerektiğinde önemlidir.
Claude Fable 5.1 nedir?
Claude Fable 5.1, zorlu kodlama, profesyonel bilgi işi, araştırma ve uzun süre çalışan ajanları hedefler. Doğrudan benchmark sonuçları, kısa bir yanıt yerine toparlanma, sebat ve başarılı tamamlanmanın daha önemli olduğu görevler için güçlü bir aday yapar.
Anthropic, planlama, başarısız adımlardan toparlanma ve ilerleme iletişimi dahil olmak üzere sürdürülen otonom yürütmeyi vurgular. Bu konumlandırmayı, her iş akışının doğru tamamlanacağı garantisi değil, daha uzun görevleri test etme nedeni olarak değerlendirin.
Fable 5.1, API davranışında GPT-5.6 Sol’dan da farklıdır: zorunlu araç seçimi kısıtlamaları, modelin belirli bir aracı çağırmasını gerektiren iş akışlarında önemlidir. Deterministik bir ajan döngüsünü taşırken desteklenen tool_choice modes’u kontrol edin.
Bu nedenle entegrasyon sorusu pratiktir: Uygulamanız daha otonom bir muhakeme döngüsünü tolere edebilir mi, yoksa her adım üzerinde daha ince kontrol mü gerektirir? Bir rota seçmeden önce araç davranışını tam olarak test edin.
Benchmark karşılaştırması: Fable 5.1’in doğrudan kanıtı daha güçlü
Rakip sağlayıcılar arasındaki benchmark karşılaştırmaları yanlış kullanılmaya açıktır. OpenAI’nin orijinal GPT-5.6 lansman değerlendirmeleri Fable 5.1’den önceye dayanırken, Anthropic’in Fable 5.1 sürümü daha yeni doğrudan GPT-5.6 Sol karşılaştırmaları içerir.
Bu kanıtları okumanın en temiz yolu üç katmandadır: Anthropic’in doğrudan karşılaştırması, güncel bağımsız testler ve OpenAI’nin GPT-5.6 Sol yetenek profili.
Anthropic’in doğrudan Fable 5.1 vs GPT-5.6 Sol sonuçları
Resmi benchmark sonuçları, her iki model için raporlanan puanlara sahip beş görevi içerir. Aşağıdaki yüzde puanı ve Elo farkları, bu yayımlanan değerlerden hesaplanmıştır.
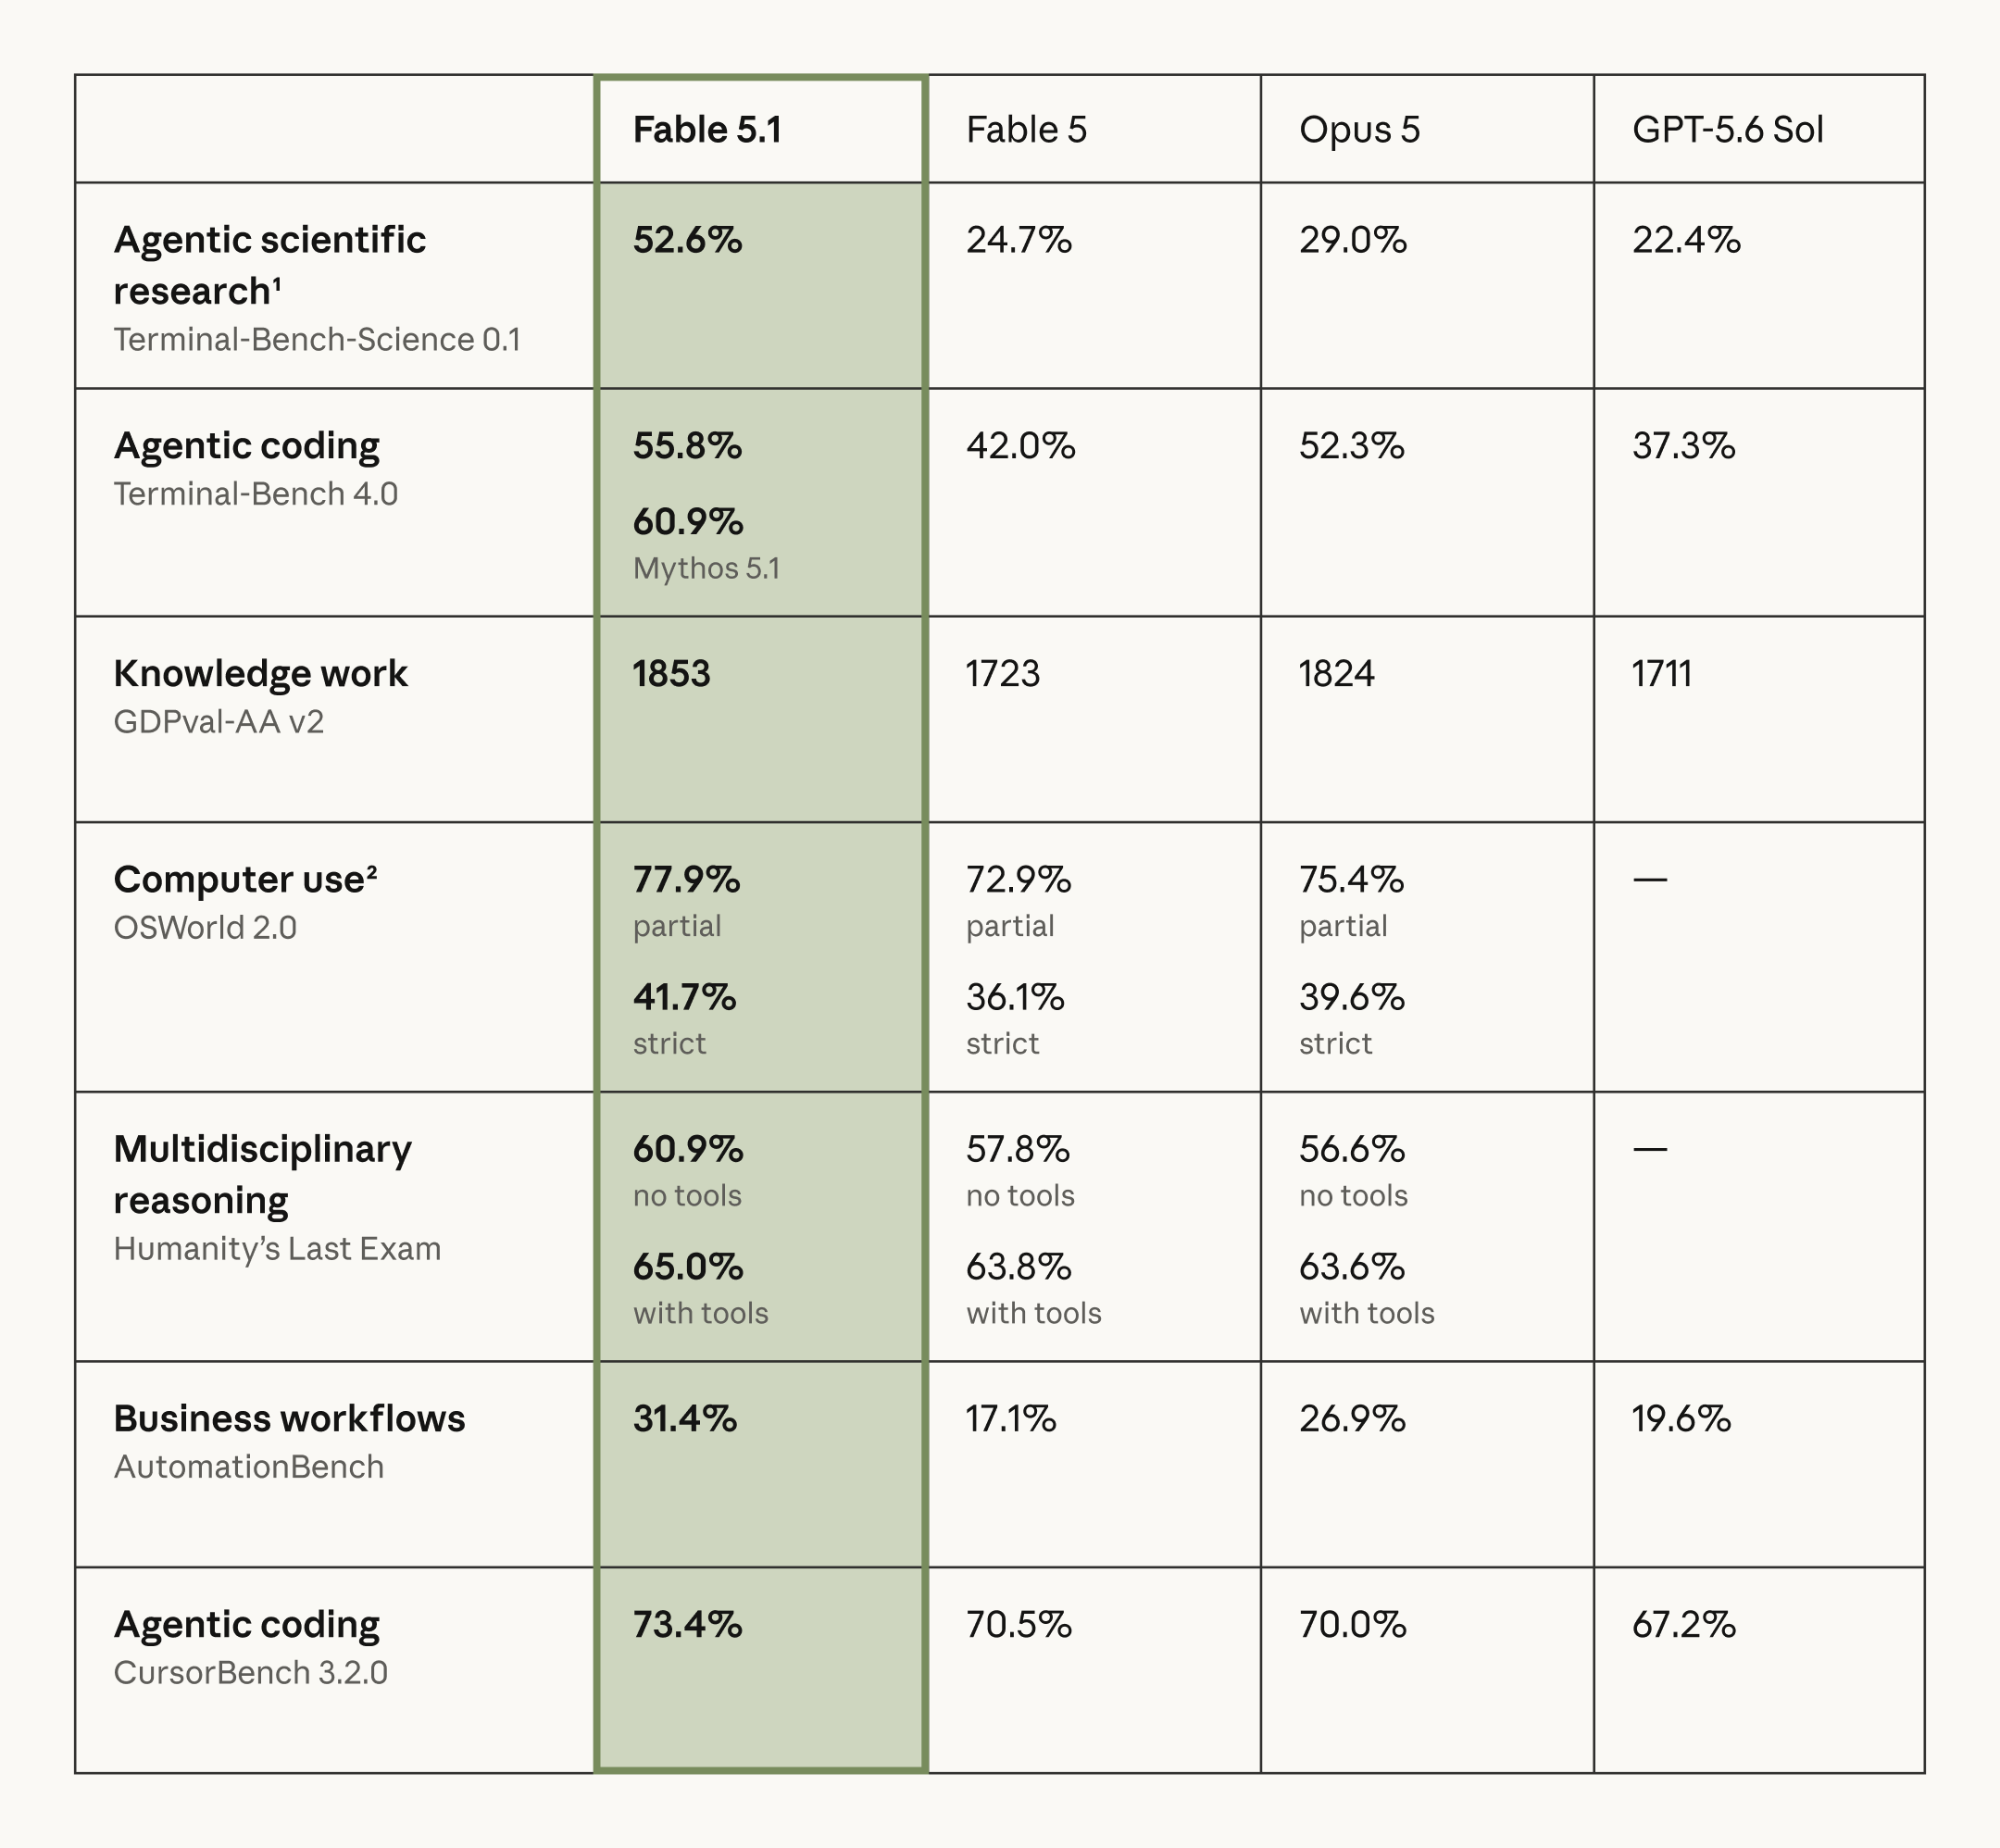
| Benchmark | GPT-5.6 Sol | Claude Fable 5.1 | Fable 5.1 farkı |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 22,4% | 52,6% | +30,2 puan |
| Terminal-Bench 4.0 | 37,3% | 55,8% | +18,5 puan |
| GDPval-AA v2 | 1711 Elo | 1853 Elo | +142 Elo |
| AutomationBench | 19,6% | 31,4% | +11,8 puan |
| CursorBench 3.2.0 | 67,2% | 73,4% | +6,2 puan |
Sonuç alışılmadık derecede tutarlı: Anthropic’in yayımladığı her satırda Fable 5.1, GPT-5.6 Sol’un önünde. En büyük farklar, sıradan kısa biçimli muhakemeden ziyade ajansal bilimsel araştırma ve terminal tabanlı kodlamada görülür.
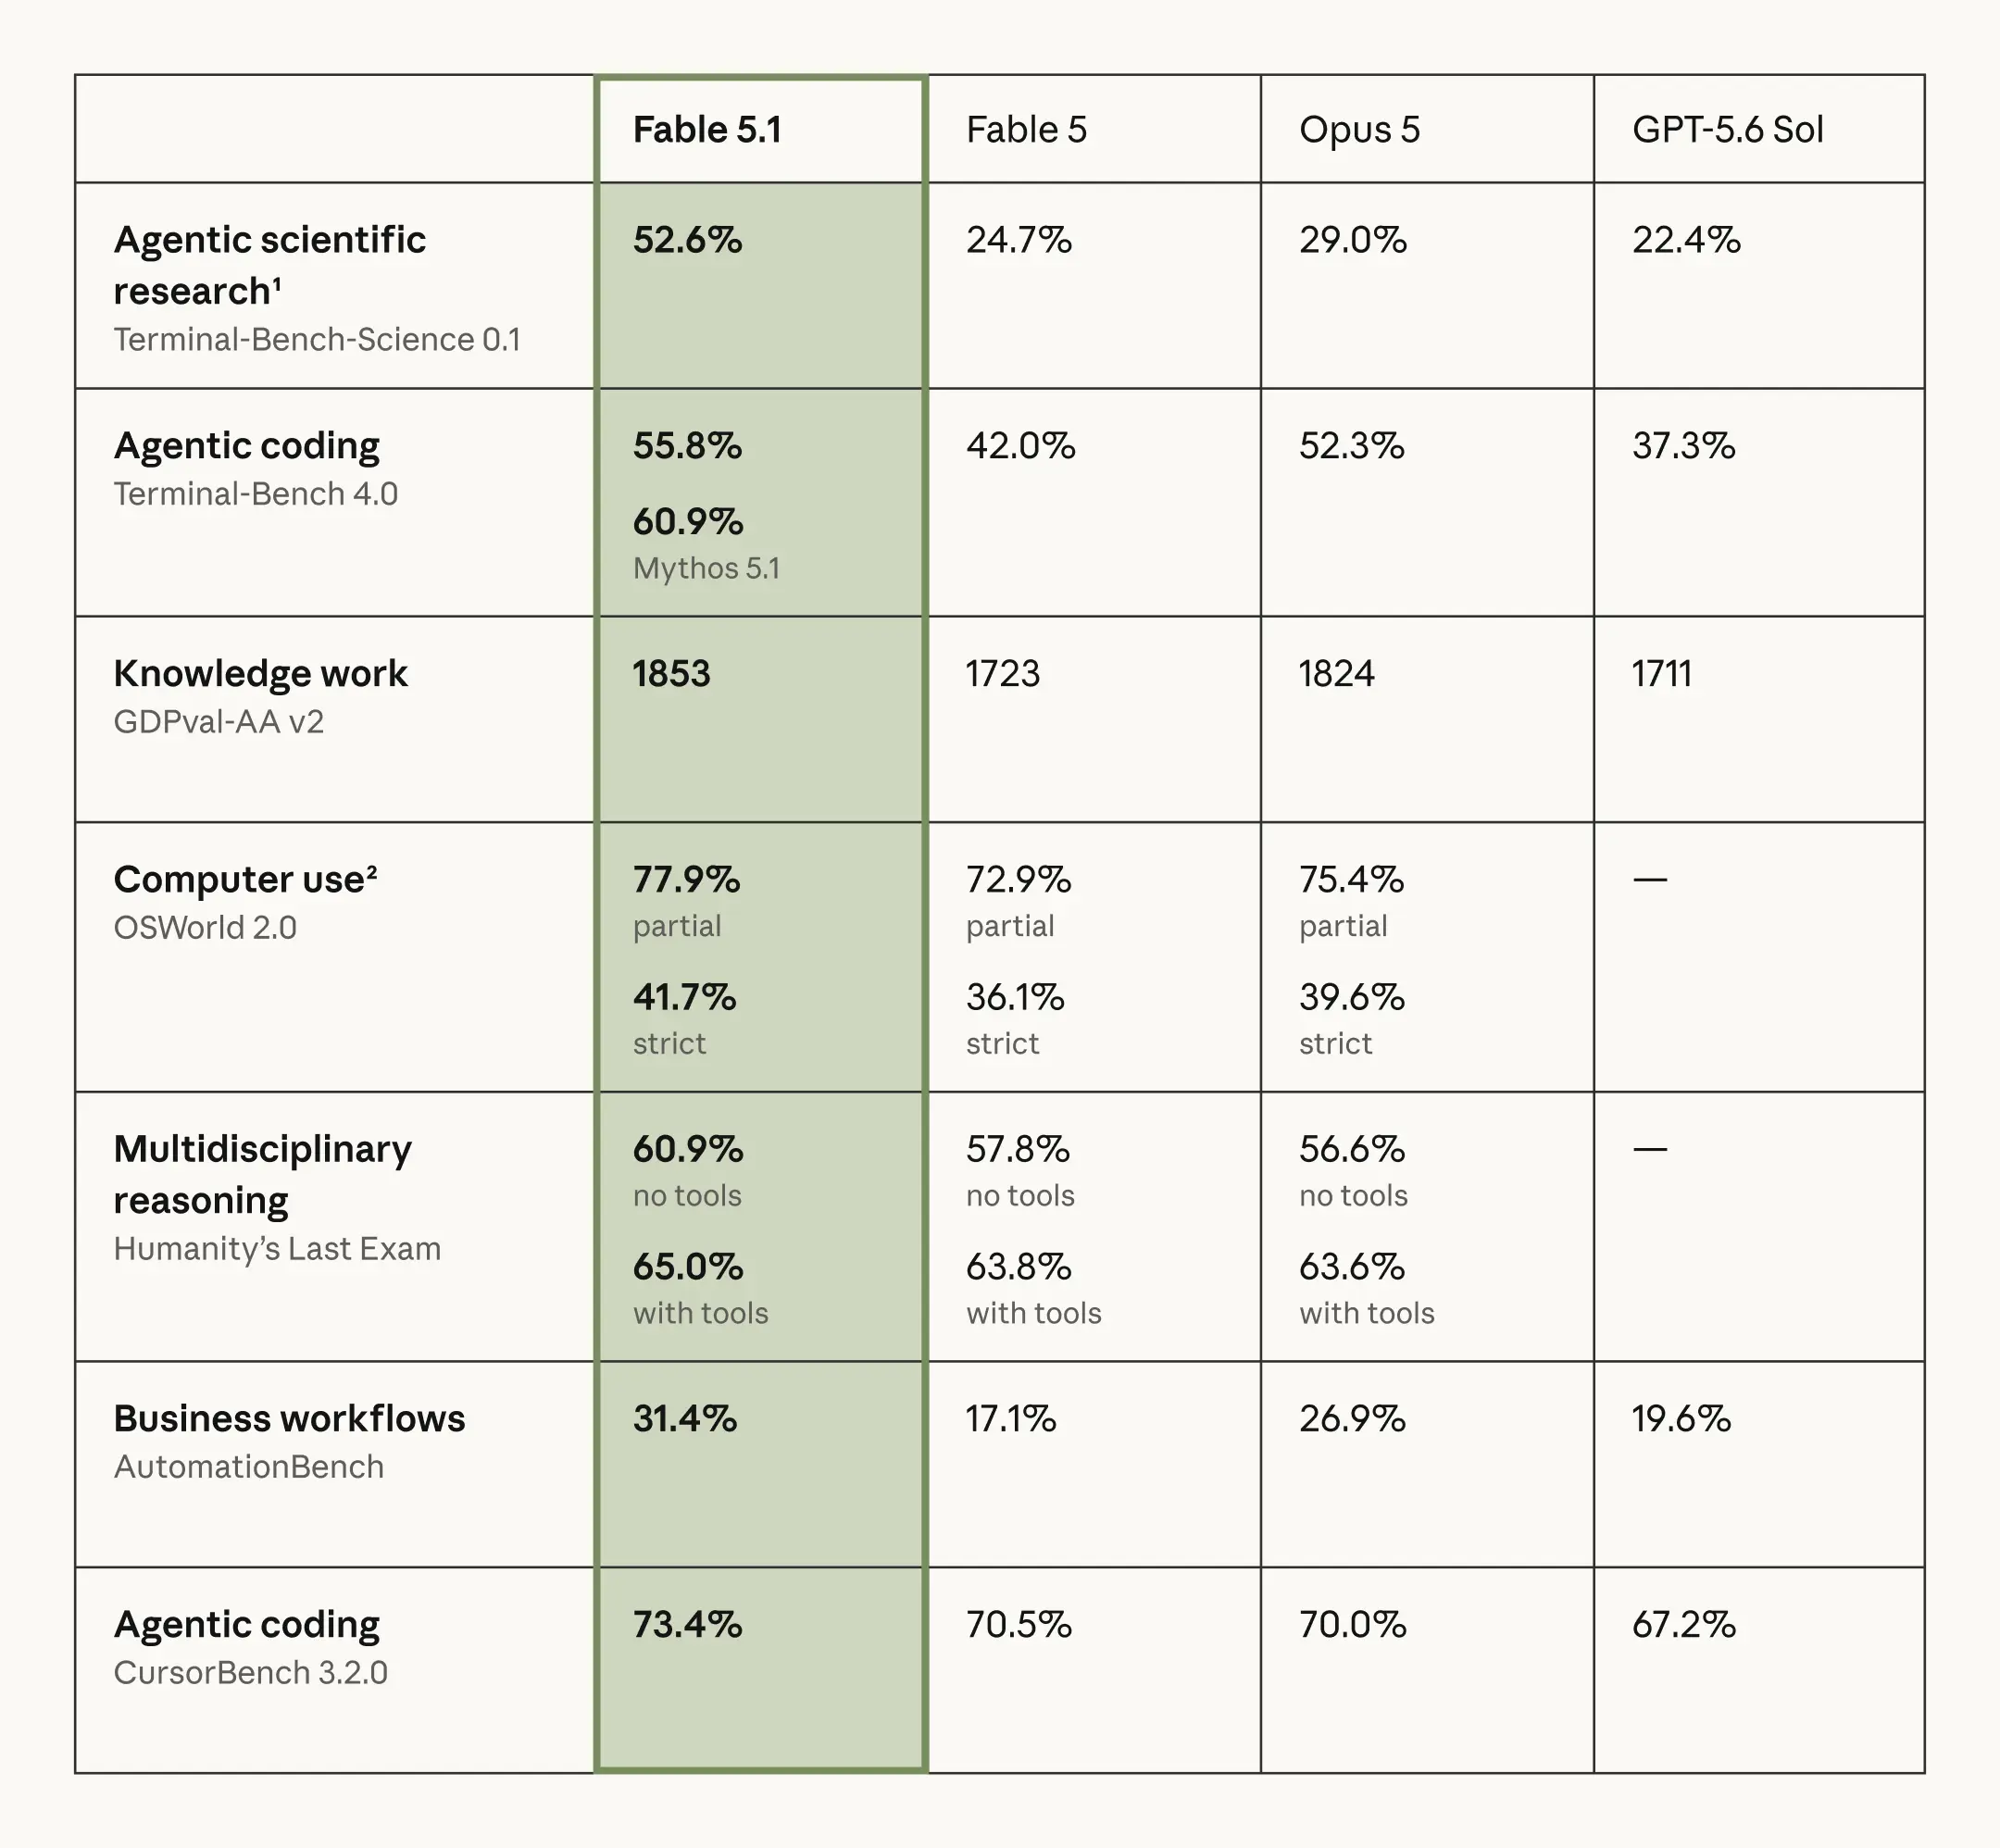
Kaynak: Anthropic — orijinal benchmark görseli.
Bunlar sağlayıcı tarafından yürütülen değerlendirmelerdir: Anthropic, hem kendi modelini hem rakip modeli test etmiştir. Doğrudan karşılaştırmalı kanıt sağlarlar, ancak bağımsız test değildirler. Anthropic, Terminal-Bench-Science için model başına ±3,5–4,5 yüzde puanı standart hata bildirir; yukarıdaki tablo güven aralıklarını değil, nokta tahminlerini gösterir.
Sağlayıcı sonuçları Fable 5.1’i destekler, ancak bağımsız kanıtların kendi tarih ve yapılandırmaları vardır.
Bağımsız benchmark’lar: tarihli sonuçları canlı ölçümlerden ayırın
Artificial Analysis, 7 Eylül’de Terminal-Bench 2.1’i Terminal-Bench 4.0 ile değiştiren ve AutomationBench-AA ekleyen Intelligence Index v4.3’ü tanıttı. Sürüm, Fable 5.1 için 53, GPT-5.6 Sol için 47 bildirdi; bu, 8 Eylül karşılaştırmasında gösterilen yuvarlatılmış puanlarla eşleşiyor. Tablo, sürümün terminal sonuçlarını daha sonraki performans anlık görüntüsünden ayırır.
| Bağımsız AA metriği / v4.3 sürümü | GPT-5.6 Sol (max) | Claude Fable 5.1 (max) | Sonuç |
|---|---|---|---|
| Intelligence Index v4.3 (8 Eyl) | 47 | 53 | Fable |
| Terminal-Bench 4.0 (7 Eyl sürümü) | 39,9% | 52,0% | Fable |
| OSWorld 2.0 | 62,6% | 41,7% | |
| Çıkış hızı (8 Eyl) | 69,8 tok/s | 69,9 tok/s | Pratikte eşit |
| İlk token’a kadar süre (8 Eyl) | 132,10 s | 277,47 s | Sol |
| AA normalize token-karışım fiyatı / MTok | $3.08 | $7.175 | Sol |
Anlık görüntü: 8 Eylül 2026; açıkça 7 Eylül olarak tarihlenen Terminal-Bench satırı hariç. Fable 5.1, Uyarlamalı Muhakeme, Maksimum Çaba, Default Fallback kullanır; Sol “max” kullanır. Canlı ölçümler değişebilir. AA’nın normalize token karışımı fiyatı 7:2:1 önbellek vuruşu/giriş/çıkış oranını kullanır; bu, her API isteğinin maliyeti değildir.
OSWorld 2.0, bu karşılaştırmada Sol için bildirilen en büyük avantajdır: Fable 5.1’e kıyasla 62,6%’ya karşı 41,7%, 20,9 puanlık bir fark. Bu, Intelligence Index ve Terminal-Bench’teki daha güçlü Fable sonuçlarını dengeler.
Kanıt, belirli bir dengeyi destekler: Fable 5.1 daha yüksek Intelligence Index’e sahipken, Sol daha düşük ilk token’a kadar süre ve daha düşük normalize fiyat sunar. Çıktı throughput’u pratikte eşittir. Bu ölçümler, kaliteye duyarlı toplu işler ve etkileşimli uygulamalar için farklı seçimleri destekler.
Tarihli bağımsız Terminal-Bench karşılaştırması, sağlayıcının testine benzer bir yöne işaret eder: 52,0% ve 39,9%; sağlayıcının 55,8% ve 37,3% değerleriyle karşılaştırıldığında. Değerlendirme kurulumları farklı olduğu için iki boşluk birbirinin yerine geçmez.
OpenAI’nin benchmark’ları GPT-5.6 Sol hakkında hâlâ ne anlatıyor?
OpenAI’nin lansman değerlendirmeleri, GPT-5.6 Sol’un yetenekleri hakkında ek bağlam sağlar. Bunlar, yukarıda tartışılan daha yeni başa baş sonuçlardan önceye dayanır; bu nedenle Fable 5.1 ile doğrudan karşılaştırma için kullanılmamalıdır.
OpenAI, GPT-5.6 Sol için Terminal-Bench 2.1’de 88,8% raporlar. Bu, lansman kurulumunda güçlü ajan tabanlı kodlama yeteneğinin kanıtıdır; daha eski benchmark sürümü, Terminal-Bench 4.0 puanlarıyla sayısal olarak karşılaştırılmamalıdır.
Kodlama için GPT-5.6 Sol vs Fable 5.1
Düz kod üretimi için her iki model de birçok üretim iş yükü için fazlasıyla yeterlidir. Ayrışma, kodlama ajansal yazılım mühendisliğine dönüştüğünde netleşir: büyük bir depoyu incelemek, birden çok dosyayı düzenlemek, komutlar çalıştırmak, hataları teşhis etmek, testler yazmak ve görev geçene kadar yinelemek.
Burada Claude Fable 5.1’in güncel benchmark kanıtı daha güçlü. Hem sağlayıcı hem bağımsız Terminal-Bench 4.0 karşılaştırmalarında öndedir ve Anthropic’in CursorBench sonucu da 67,2%’ye karşı 73,4% ile Fable’ı destekler.
Pratik bir kodlama değerlendirmesi için depo genelinde değişiklikler, testler, inceleme ve performans çalışmalarını dahil edin. Başarılı kısa bir kod parçası, birkaç dosyayı ve başarısız denemeleri kapsayan bir görevi tamamlamanın zayıf bir vekilidir.
Çevresindeki yürütme ortamı ham model kalitesi kadar önemli olduğunda GPT-5.6 Sol cezbedici olmaya devam eder. Kabuk yürütme, apply-patch, kod yorumlayıcı, dosya arama, bilgisayar kullanımı ve MCP için yerel destek, kendi orkestrasyon altyapınızı ne kadar inşa etmeniz gerektiğini azaltabilir.
Kodlama kararı: En zor otonom depo işleri vurgulayan değerlendirmelerde Fable 5.1’i seçin. Biraz daha düşük benchmark yeteneği, daha düşük maliyet ve geniş entegre yürütme yığını karşılığında kabul edilebilirse GPT-5.6 Sol’u seçin.
Muhakeme kontrolleri ve geliştirici deneyimi
İki API zekâyı farklı şekilde ortaya koyar.
Sol’un “none”dan “max”a muhakeme aralığı, bir ekibin kalite ve gecikmeyi çeşitli ayarlarda test etmesine olanak tanır. Daha düşük çaba, muhakeme çalışmasını azaltabilir; ancak doğru ayar, görevin başarısızlık maliyetine bağlıdır.
Fable’ın her zaman açık uyarlamalı düşünmesi, çaba ayarını farklı bir alıştırma haline getirir. Aynı çaba etiketlerini özdeş hesaplama bütçeleri olarak görmek yerine, uygulamanızın dağıtacağı ayarları karşılaştırın.
Dolayısıyla “varsayılan Sol” ile “varsayılan Fable” arasında evrensel olarak adil bir karşılaştırma yoktur. Varsayılan muhakeme yapılandırmaları farklıdır. Üretim değerlendirmeleri, ya eşdeğer çaba bütçelerini ya da uygulamanızın gerçekten dağıtacağı tam ayarları karşılaştırmalıdır.
GPT-5.6 Sol vs Fable 5.1: Hangisi AI ajanları için daha iyi?
Seçim, darboğazın zor muhakeme mi yoksa onu çevreleyen çalışma zamanı mı olduğuna bağlıdır.
Atıfta bulunulan terminal, otomasyon ve profesyonel iş benchmark’larında Fable’ın üstünlüğü, en zor görevler için mantıklı bir aday yapar. Bu üstünlüğü ajanınıza genellemeden önce tamamlanma oranını ve başarısız adımlardan toparlanmayı ölçün.
GPT-5.6 Sol’un belgelenmiş Responses araç portföyü, arama, dosyalar, kabuk yürütme ve yama üzerine kurulu uygulamalar için çekicidir. Bu, görev doğruluğu yanında değerlendirilecek bir entegrasyon avantajıdır; onun yerine geçmez.
| Ajan gereksinimi | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|
| Zor uzun ufuklu muhakeme | Mükemmel | En iyi uyum |
| Terminal/depo özerkliği | Mükemmel | Daha güçlü kanıt |
| Yerel entegre araç portföyü | Daha güçlü | Güçlü |
| Zorunlu araç seçimi | Desteklenir; seçilen API’yi kontrol edin | Kısıtlı; tool_choice modes’u kontrol edin |
| Çok ajanlı platform entegrasyonu | Güçlü avantaj | Ajan mimarisiyle mevcut |
| Uzun işler sırasında ilerleme iletişimi | İyi | Çekirdek davranış |
| Maliyet duyarlı yüksek hacimli ajanlar | Daha iyi | Premium |
| Tekrarlanan devasa önbellekli bağlam | İyi | Potansiyel olarak çok cazip |
Yalnızca küçük bir görev payı yükseltme gerektirdiğinde her ikisini kullanmak ekonomik olabilir. Ek başarılı tamamlamaların, ikinci modelin daha yüksek fiyatını ve başlangıç gecikmesini telafi edip etmediğini ölçün.
Uzun bağlam: 1,05M vs 1M önemli fark değil
Manşet sayılar neredeyse aynıdır: GPT-5.6 Sol 1,05M token, Fable ise 1M sunar. 5%’lik kapasite farkının, büyük bir depoyu, hukuk külliyatını, araştırma arşivini veya çok saatlik ajan geçmişini analiz edip edemeyeceğinizi belirlemesi olası değildir. Her ikisi de zaten milyon-token sınıfındadır.
GPT-5.6 Sol için, 272K üzerindeki girişler daha yüksek uzun bağlam ücretlerini tetikler: MTok başına $8 giriş, $0,80 önbellek okuma ve $30 çıkış. Önbellek yazımları da $5’ten $10/MTok’a yükselir.
Fable 5.1, standart 1M bağlam ücretlerini korur: $10/MTok giriş, $50/MTok çıkış ve $0,25/MTok önbellek okuma. Bu belgelenmiş yapılandırmada 272K üzerinde ayrı bir premium yoktur.
100K önbelleksiz giriş token’ı, 900K önbellek okuma token’ı ve 20K toplam ücretli çıkış token’ı olan bir turu düşünün. GPT-5.6 Sol maliyeti 0.1 × $8 + 0.9 × $0.80 + 0.02 × $30 = $2.12. Fable 5.1 maliyeti 0.1 × $10 + 0.9 × $0.25 + 0.02 × $50 = $2.225.
Bu önbellek ağırlıklı tur, Fable’ın daha ucuz önbellek okumaları nedeniyle fiyat farkını neredeyse kapatır. Sonuç, iş yükünün token karışımına bağlıdır; bu, iki modelin tam bir ajan oturumu için aynı maliyette olduğu anlamına gelmez.
Maliyet varsayımları: 900K token’lık önek zaten önbellekte ve 100K yeni giriş, yeni bir önbellek yazımı olarak faturalandırılmıyor. Tahmin, ilk önbellek yazımı ve araç ücretlerini dışlar. 20K çıktı tahsisi, faturalandırılan muhakeme token’ları dahil tüm ücretli çıktıları içerir.
Fiyatlandırma: Sol sıradan iş yüklerinde kazanır, Fable bir önemli önbellek metriğinde kazanır
Kontrol edilen oranlarda Sol, MTok başına $4 giriş / $20 çıkış ve $0,40 önbellek okumasına mal olur. Fable 5.1, $10 giriş, $50 çıkış ve $0,25 önbellek okumasıdır. Tablo, CometAPI’deki GPT-5.6 Sol API ve Claude Fable 5.1 API oranlarından sağlayıcı fiyatlarını ayırır.
| Fiyat bileşeni | GPT-5.6 Sol Resmi fiyatlar | Claude Fable 5.1 Resmi fiyatlar |
|---|---|---|
| Resmi giriş / MTok | $4.00 | $10.00 |
| Resmi çıkış / MTok | $20.00 | $50.00 |
| Resmi önbellek okuma / MTok | $0.40 | $0.25 |
| Resmi önbellek yazma / MTok | $5.00 (30 dakika) | $12.50 (5 dakika) |
| 272K üzeri giriş: giriş / önbellek okuma / yazma / çıkış | $8 / $0.80 / $10 / $30 | Aynı belgelenmiş temel oranlar |
| CometAPI giriş / MTok | $3.20 | $8.00 |
| CometAPI çıkış / MTok | $16.00 | $40.00 |
Önbellek yazma süreleri farklıdır: Sol, 30 dakikalık varsayılan saklama süresi kullanırken, Fable 5.1 oranı 5 dakikalık yazım içindir. Kullandığınız sağlayıcı ve rota için önbellek oluşturma, yenileme ve sona erme davranışını kontrol edin.
Doğrudan sağlayıcı oranlarında, Fable 5.1, hem önbelleksiz giriş ($10 vs $4/MTok) hem de çıkış ($50 vs $20/MTok) için Sol’dan 2,5× daha pahalıdır. Bu oranları tarihli bir karşılaştırma olarak değerlendirin; çünkü sağlayıcı promosyonları ve ağ geçidi fiyatları değişebilir.
100K giriş ve 10K toplam ücretli çıkışlı kısa bağlamlı bir istek, doğrudan sağlayıcı oranlarında Sol ile yaklaşık $0,60, Fable ile $1,50 tutar. Yukarıda gösterilen CometAPI oranlarında aynı karışım $0,48 veya $1,20 olur. Bu örnekler önbellek yazımları ve araç ücretlerini dışlar.
Fable’ın kısa bağlam önbellek okuma oranı 37,5% daha düşüktür: ($0.40 − $0.25) ÷ $0.40. Bu, büyük bir sabit öneki yeniden kullanan ajanlar için önemli olabilir; ancak toplam tasarruf, yeni giriş, yazım sıklığı ve çıkış hacmine yine de bağlıdır.
Fiyatlandırma kararı: Yeni bağlamlı trafik için Sol daha ucuz başlangıç noktasıdır. Önbellek okuma payı büyüdükçe Fable daha rekabetçi hale gelir; önbellek yaratma ve yenilemeyi içeren tam oturum maliyetini karşılaştırın.
Hız ve gecikme
Maksimum çaba testleri, ilk görünür token’dan önce önemli süreyi muhakemeye ayırabilir.
8 Eylül throughput ve gecikme ölçümleri, Fable için 69,9 ve Sol için 69,8 çıktı token/s gösterir. İlk token’a kadar süre ise 277,47 saniye ve 132,10 saniyedir. Çıktı throughput’u pratikte eşittir; bu yapılandırmada Sol, görünür çıktı üretmeye daha erken başlar.
Bunlar maksimum çaba benchmark ölçümleridir; her API çağrısı için vaat edilen gecikme değildir. İstem uzunluğu, muhakeme yapılandırması, sağlayıcı yükü, araçlar ve önbellek durumu sonucu değiştirebilir. İlk token’a kadar süre ile tam yanıt süresi farklı metriklerdir.
Etkileşimli işler için daha düşük gözlenen başlangıç gecikmesi Sol lehine olabilir. Asenkron araştırma veya gece boyunca depo işleri için, ilk token’ı beklemekten ziyade başarılı tamamlanma daha önemli olabilir. Kullanmayı planladığınız ayarlar ve eşzamanlılıkta her iki modeli de benchmark edin.
Koruma önlemleri üretimde bir farktır
Her iki model de yetenekleri hassas siber güvenlik ve bilimsel alanlara uzandığı için daha güçlü korumalar uygular; ancak bunları farklı şekilde uygularlar.
OpenAI, GPT-5.6 ailesi için katmanlı korumalar ve izleme tanımlar. Hassas alanlardaki uygulamalar, dağıtım davranışlarının bir parçası olarak ilgili korumaları değerlendirmelidir.
Anthropic’in yeniden yönlendirme ve saklama şartları, bazı hassas siber güvenlik veya biyoloji isteklerini daha az yetenekli modellere yönlendirmeyi ve bu yönlendirilen istekler için Fable ücreti alınmamasını açıklar. Varsayılan veri saklama süresi 30 gündür; uygun kurumsal düzenlemeler için istisnalar vardır.
Sıradan kodlama ve bilgi işleri için bu farklılıklar hiç ortaya çıkmayabilir. Güvenlik ürünleri, düzenlenmiş iş yükleri veya gizlilik duyarlı dağıtımlar için, bunlar benchmark kalitesi ve fiyatın yanında değerlendirme kontrol listesine aittir.
Hangi modeli seçmelisiniz?
Genel karşılaştırma, iş yükü şekline indirgenebilir.
| İş yükü | GPT-5.6 Sol | Claude Fable 5.1 | Öneri |
|---|---|---|---|
| Zor otonom kodlama | Mükemmel | Daha güçlü güncel benchmark’lar | Fable 5.1 |
| Uzun ufuklu araştırma | Mükemmel | Çekirdek güç | Fable 5.1 |
| Yüksek hacimli frontier API | Çok daha ucuz | Pahalı | Sol |
| Etkileşimli kod asistanı | Daha düşük ölçülen max-çaba TTFT | Daha yüksek ölçülen max-çaba TTFT | Dağıtım ayarlarını test edin |
| Araç ağırlıklı API ajanı | Daha geniş yerel araç yığını | Güçlü | Sol |
| Milyon-token önbellekli ajan | Rekabetçi | Çok düşük önbellek okuma fiyatı | Her ikisini test edin |
| Azami muhakeme kalitesi | Mükemmel | Bağımsız lider | Fable 5.1 |
| Sıradan istek başı maliyet | Açık avantaj | Premium | Sol |
| Görüntü/belge muhakemesi | Güçlü | Güçlü | İş yükünde test edin |
| Tek sağlayıcılı OpenAI yığını | Doğal uyum | Geçiş/ağ geçidi gerekir | Sol |
| Model bağımsız yönlendirme | Güçlü | Güçlü | Her ikisini CometAPI ile kullanın |
Bir yönlendirme politikasının karmaşıklığına değmesi gerekir. Tek model taban çizgisini, zor görevleri Fable 5.1’e yükselten Sol-önce politikasıyla karşılaştırın ve yalnızca, başarılı görev başına maliyeti gerekli kalitede iyileştiriyorsa yönlendiriciyi tutun.
CometAPI üzerinden GPT-5.6 Sol ve Fable 5.1’i nasıl karşılaştırırsınız?
CometAPI, GPT-5.6 Sol ve Claude Fable 5.1’i zaten entegre eder. Her iki modele de kendi yerel istek formatlarıyla erişin, aynı değerlendirme setini gönderin ve dönen sonuçları eşleşen ayarlarda karşılaştırın.
Her model için yerel formatlı istekler kullanın ve istemleri, veri setlerini, çaba ayarlarını, eşzamanlılığı ve puanlama kurallarını sabit tutun. Çalıştırmaları tekrar edin; her model için tek bir ardışık istek, güvenilir gecikme veya kaliteyi tahmin etmek için yeterli değildir.
Üretim değerlendirmesi için sabit bir istem seti kullanın, çalıştırmaları dönüşümlü sırada tekrarlayın, çaba ayarını kaydedin ve doğruluk, test geçiş oranı, araç başarısı, yeniden denemeler, token kullanımı, geçen süre ve başarılı görev başına toplam maliyeti puanlayın. Ortak taban çizgisinden sonra her modeli ayrı ayrı ayarlayın.
Son karar: GPT-5.6 Sol mu, Claude Fable 5.1 mi?
Fable 5.1, en zor otonom kodlama ve uzun vadeli işler için daha güçlü doğrudan kanıtlara sahiptir. Beş ortak sağlayıcı benchmark satırında ve tarihli bağımsız terminal karşılaştırmasında öndedir. Bu, kendi görevlerinizde doğrulanmak kaydıyla güçlü bir yükseltme adayı yapar.
Sol, daha düşük sıradan token fiyatları, daha ince muhakeme kontrolleri ve geniş bir yerel araç yığınına sahiptir. Kontrol edilen bağımsız maksimum-çaba yapılandırmasında aynı zamanda daha düşük ilk token’a kadar süreye sahiptir; çıktı throughput’u pratikte eşittir.
Başarı oranınızı en zor otonom görevler belirliyorsa Fable 5.1’i önceliklendirin. Maliyet bilinçli frontier çıkarımı veya araç ağırlıklı uygulamalar için Sol ile başlayın. Etkileşimli iş yükleri için, gözlenen başlangıç gecikmesi avantajının sürüp sürmediğini doğrulamak amacıyla dağıtılan çaba ayarlarını test edin.
Tek bir model, gereksinimlerinizi basitçe karşılıyorsa onu seçin. Değerlendirme sonuçları, ikisi arasında geçişin başarılı görev başına kaliteyi veya maliyeti iyileştirdiğini gösterdiğinde yönlendirmeyi ekleyin.
SSS
Claude Fable 5.1, GPT-5.6 Sol’dan daha mı iyi?
8 Eylül anlık görüntüsünde daha yüksek bağımsız Intelligence Index’e sahiptir: Sol için 47’ye karşı 53. Tarihli bağımsız terminal testinde de öndedir. Bu, her iş yükü için daha iyi olduğu iddiası değil; bu değerlendirmelerde bir kalite avantajını destekler.
GPT-5.6 Sol, Claude Fable 5.1’den daha mı ucuz?
Sıradan önbelleksiz API trafiği için evet: kontrol edilen doğrudan sağlayıcı giriş/çıkış oranları Sol için MTok başına $4/$20, Fable 5.1 için $10/$50’dir. Önbellek ağırlıklı iş yükleri, Fable’ın daha düşük önbellek okuma oranı nedeniyle bu farkı daraltabilir. Tahmine yazma ve sona erme davranışını dahil edin.
Kodlama için hangi model daha iyi?
Bu karşılaştırmada Fable 5.1, otonom kodlama benchmark kanıtında daha güçlüdür. Sol, daha düşük maliyetli iş akışları ve entegre yürütme araçları için çekici kalır. Ölçülen yetenek farkının uygulamanız için önemli olup olmadığını belirlemek üzere çalıştırılabilir testlere sahip depo görevlerini kullanın.
Hangi modelin bağlam penceresi daha büyük?
Sol, 1,05M ile Fable 5.1’in 1M token’ına karşı teknik olarak öndedir; her ikisi de 128K çıktı izni verir. Pratikte, Sol’un >272K fiyat eşiği ve Fable’ın ucuz önbellek okumaları, 50K token’lık kapasite farkından genellikle daha önemlidir.
Her iki modele de CometAPI üzerinden erişebilir miyim?
Evet. CometAPI’deki GPT-5.6 Sol API ve Claude Fable 5.1 API, metin değerlendirmeleri için ortak bir başlangıç noktası destekler. Taban çizgisini üretim ajanına genişletmeden önce rota bazlı muhakeme, önbellekleme ve araç desteğini kontrol edin.