Özet (TL;DR)
GPT-6.1 Sol, GPT-6 Sol için daha geniş bağlamlı veya daha pahalı bir yerine geçme değildir. Aynı 1.05 milyon belirteçlik bağlam penceresini, 128K maksimum çıktıyı ve $2/$10 standart API fiyatlandırmasını korurken, kodlama, bilgisayar kullanımı, profesyonel iş akışları, olgusal güvenilirlik ve ajan davranışını iyileştirir. Fiyatlandırmadaki en net değişiklik istem önbelleklemede: önbelleğe alınan giriş, milyon belirteç başına $0.20’den $0.10’a düşer.
Pratik sonuç, GPT-6.1 Sol’un API’nin biçimini değiştirmekten ziyade, yaklaşık aynı belirteç bütçesinden kayda değer ölçüde daha faydalı iş elde etmeye odaklanmasıdır.
Temel Çıkarımlar
- GPT-6.1 Sol, GPT-6 Sol’a yönelik bir yetenek yükseltmesidir; aynı 1,050,000 belirteçlik bağlam penceresi ve 128,000 belirteçlik çıktı tavanını korur.
- Standart API giriş ve çıkış fiyatları $2/M ve $10/M olarak kalır; önbelleğe alınan giriş $0.20/M’den $0.10/M’ye düşer.
- Resmi değerlendirmeler, kodlama, bilgisayar kullanımı, iş otomasyonu ve bilimsel iş akışlarında daha güçlü performans gösterir; sonuçlar kıyaslamaya ve akıl yürütme ayarına bağlıdır.
- Geçiş, hem akıl yürütme çabasını hem de API uç noktası uyumluluğunu kontrol etmeyi gerektirir: GPT-6.1 Sol none seçeneğini kaldırır ve araç çağırma için Responses API gerektirir.
- Mevcut, stabil bir GPT-6 Sol dağıtımını değiştirmeden önce görev başarısını, gecikmeyi, gerçek önbellek isabetlerini ve uçtan uca maliyeti doğrulayın.
GPT-6.1 Sol nedir ve GPT-6 Sol’dan sonra neden bu kadar hızlı geldi?
OpenAI, GPT-6 Sol’u 22 Eylül 2026’da tanıttı. Bir hafta sonra, 29 Eylül tarihli sistem kartı ekinde GPT-6.1 Sol duyuruldu. OpenAI, yeni sürümü GPT-6 Sol’a bir yükseltme olarak sunuyor; ayrı bir fiyatlandırma katmanı değil.
Kısa yayın aralığı önemlidir çünkü GPT-6.1 Sol yeni bir ürün katmanı olarak konumlandırılmıyor. OpenAI, Sol fiyatlandırma katmanını korudu ve güncellemeyi zor görev yeteneği, maliyet verimliliği ve ajan güvenilirliğine odakladı.
OpenAI, GPT-6.1 Sol’u ajansal kodlama, bilgisayar kullanımı ve profesyonel işlerin etrafında konumlandırıyor. Önemli karşılaştırma, model adı yerine belirli bir maliyette görev başarısıdır. Aşağıdaki resmi kıyaslama özeti, API özellikleri değişmeden kalan noktaları yetenek kazanımlarından ayırır.
Bu da karşılaştırmayı alışılmadık derecede basit hale getiriyor: GPT-6.1 Sol, öncelikle bağlam penceresi veya temel fiyat artırımı değil; bir yetenek ve verimlilik yükseltmesidir.
GPT-6.1 Sol ve GPT-6 Sol: Neler Aynı Kalıyor?
Her iki model de aynı başlık kapasitesini, desteklenen giriş/çıkış kiplerini ve Standart giriş/çıkış fiyatlarını korur. Tablo ayrıca kesim tarihleri, akıl yürütme seçenekleri, araç çağırma ve önbelleğe alınan giriş oranlarındaki farklılıkları listeler; bu farklar paylaşılan özellikler olarak yanlış anlaşılmamalıdır.
Paylaşılan Özellikler ve Uyumluluk Farkları
| Özellik | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Model kimliği | gpt-6.1-sol | gpt-6-sol |
| Yayın tarihi | 29 Eyl. 2026 | 22 Eyl. 2026 |
| Bağlam penceresi | 1,050,000 belirteç | 1,050,000 belirteç |
| Maksimum çıktı | 128,000 belirteç | 128,000 belirteç |
| Bilgi kesimi tarihi | 30 Nis. 2026 | 20 Nis. 2026 |
| Metin girişi / çıkışı | Evet / Evet | Evet / Evet |
| Görüntü girişi | Evet | Evet |
| Standart giriş fiyatı | $2.00 / 1M | $2.00 / 1M |
| Önbelleğe alınan giriş | $0.10 / 1M | $0.20 / 1M |
| Önbellek yazımı | $2.50 / 1M | $2.50 / 1M |
| Çıkış fiyatı | $10.00 / 1M | $10.00 / 1M |
| Akıl yürütme çabası | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Yapılandırılmış çıktılar | Evet | Evet |
| İşlev çağırma | Responses API üzerinden Evet; Chat Completions ile kullanılamaz | Responses API üzerinden Evet; Chat Completions yalnızca reasoning_effort=none ile |
| İnce ayar | Hayır | Hayır |
| Ses / video girişi | Desteklenmiyor | Desteklenmiyor |
| Doğal görüntü çıktısı | Desteklenmiyor; görüntü üretimi ayrı bir araçtır | Desteklenmiyor; görüntü üretimi ayrı bir araçtır |
Yukarıdaki iki resmi model sütunu, aynı bağlam ve çıktı sınırlarını belgeliyor. Bu sayılar kapasiteyi açıklar; her uzun-bağlam iş yükünde eşit geri getirme doğruluğu veya gecikmeyi garanti etmez.
Bilgi kesimi tarihi biraz ileriye, 20 Nisan’dan 30 Nisan 2026’ya taşınıyor. Daha da önemlisi, GPT-6.1 Sol artık reasoning.effort="none" seçeneğini desteklemiyor; kullanılabilir akıl yürütme ayarları low ile başlıyor.
Minimum gecikmeye bağımlı geliştiriciler için bu uyumluluk ayrıntısı test edilmeye değerdir çünkü GPT-6 Sol hâlâ reasoning effort none’u destekliyor.
Mimari: Neler Açıklanmadı
Bu karşılaştırma için kullanılan model sayfalarının hiçbiri parametre sayısı veya ayrıntılı mimari dökümü sağlamıyor. Resmi sistem kartı eki, GPT-6.1 Sol’un Astra ile aynı tür veri ve eğitim kullandığını söylüyor; bu ifade Sol ve Astra’nın aynı mimariye sahip olduğunu kanıtlamaz. Bu nedenle mimari ve parametre ölçeği farklılıkları aktarılan materyalde açıklanmamıştır.
Temel Fiyatlandırma Değişmedi; Önbellek Okuma Daha Ucuz
Normal, önbelleğe alınmamış belirteçler için hayır. Standart giriş ve çıkış oranları değişmedi. Başlıca fiyatlandırma iyileştirmesi, önbelleğe alınan giriştir.
| Resmi API fiyatlandırması — 1M belirteç başına USD | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Giriş / 1M belirteç | $2.00 | $2.00 |
| Önbelleğe alınan giriş / 1M | $0.10 | $0.20 |
| Önbellek yazımı / 1M | $2.50 | $2.50 |
| Çıkış / 1M belirteç | $10.00 | $10.00 |
GPT-6.1 Sol, önbelleğe alınan girişi milyon belirteç başına $0.10’a düşürür; bu, önbelleğe alınmamış giriş oranının %5’idir.
Örneğin, 100 milyon önbelleğe alınmış giriş belirteci yeniden kullanmak GPT-6.1 Sol’da yaklaşık $10, GPT-6 Sol’da ise $20 tutar. Bu fark tek seferlik istemler için mütevazıdır; ancak sabit istem ön ekleri olan yüksek hacimli ajanlar için daha anlamlıdır.
Model dokümantasyonunda gösterilen resmi fiyat koşulları da geçerlidir: 272K giriş belirtecinin üzerindeki istekler, tüm istek için 2x giriş ve önbellek oranları ve 1.5x çıkış fiyatlandırması kullanır. GPT-6.1 Sol Fast modu Standart’ın 2x’idir; Batch ve Flex, Standart’tan %50 daha düşüktür. Bölgesel işlem, mevcut olduğunda %10 prim ekler ve Fast modu, AB veri ikametiyle kullanılamaz. Ayrı araç ücretleri uygulanabilir. Seçilen işlem moduna, bölgeye ve gerçek önbellek isabetlerine göre bütçe oluşturun.
GPT-6.1 Sol’da Neler İyileşti?
Yükseltme, kodlama, ajan iş akışları, profesyonel belgeler, bilim, olgusallık ve hata kurtarma genelinde en iyi değerlendirilir. Aşağıdaki bölümler, iyileştirmeleri grup halinde sunar; orijinal kıyaslama koşulları ve sınırlamaları korunur.
Kıyaslama Genel Bakışı: Bildirilen Kazanımlar ve Değerlendirme Koşulları
GPT-6.1 Sol için en güçlü argüman, ham özelliklerden ziyade görev düzeyi performanstır. OpenAI, yazılım mühendisliği, iş otomasyonu, bilgisayar etkileşimi, bilimsel iş akışları, olgusallık ve ajan hizalanması genelinde iyileştirmeler rapor ediyor.
| Resmi karşılaştırma / değerlendirme sonuçları | GPT-6.1 Sol vs. GPT-6 Sol | Değişimin Anlamı |
|---|---|---|
| DeepSWE v1.1 | GPT-6 Sol’un en iyi sonucuna göre +6.4 puan; daha düşük akıl yürütme çabası ve görev maliyetiyle; bu eşleştirilmiş-çaba karşılaştırması değil | Daha güçlü uzun ufuklu yazılım mühendisliği |
| AutomationBench 1.0.6 | Her iki Sol modeli için medium çabada +4.8 puan; medium çabada Opus 5.5’e göre +2.2 puan | Daha iyi çok adımlı iş ajansı yürütümü |
| OSWorld 2.0 offline | max çabada +7 puan; çevrimdışı sette kısmi ödül, sürüm v2026.08.08; görev başına maliyetin yarısından az | Daha iyi bilgisayar kullanımı iş akışları |
| Terminal-Bench Science 0.1 | max çabada GPT-6 Sol’un skorunun 2 katından fazla, görev başına maliyetin yarısından az | Bilimsel ajan iş akışlarında büyük kazanım |
| Zor olgusal doğruluk değerlendirmesi | low çabada, hata içeren yanıtlar %11.4’ten %7.7’ye düşer; bu, seçilmiş zor istem değerlendirmesidir | Zor istemlerde daha az olgusal hata |
| Bozuk arama hizalama testi | maksimum çabada, bozuk aramayı açıklamama %4.9’dan %2.1’e düşer; kasıtlı olarak adversaryal görevler | Araç hatalarını daha iyi fark etme |
Bunlar OpenAI tarafından raporlanan sonuçlardır; bağımsız CometAPI ölçümleri değildir. OpenAI, modellerini kendi araştırma ortamında veya API’si üzerinden değerlendirdi; üretim davranışı sistem istemlerine ve mevcut araçlara göre farklılık gösterebilir. Rakip rakamları, kamuya açık raporlardan gelir. Görev maliyeti, test edilen yapılandırmayı yansıtır ve belirteç fiyatı ile aynı değildir. Çalışma başına bütçeler veya iskeleler gibi raporlanmamış ayrıntılar varsayılmamalıdır.
Kıyaslama tablosundaki resmi sonuç, GPT-6.1 Sol’u daha düşük akıl yürütme çabasında GPT-6 Sol’un en iyi skoru ile karşılaştırır. Bu, kontrollü, eşit-çaba hız karşılaştırması olarak yorumlanmamalıdır. DeepSWE v1.1, gerçek kod tabanlarında orijinal, uzun ufuklu yazılım mühendisliği görevlerini değerlendirir.
Bağlam için, orijinal GPT-6 Sol lansmanı DeepSWE v1.1’de maksimum çabada %68.8 rapor etmişti.
Kodlama: Uzun Ufuklu Yazılım Mühendisliğinde Daha Güçlü
Kodlama, muhtemelen en net yükseltmedir. DeepSWE v1.1, gerçek kod depolarında sürekli, çok adımlı çalışma gerektiren orijinal yazılım mühendisliği görevlerinde ajanları değerlendirir.
Yukarıda özetlenen DeepSWE iyileştirmesi, bir ajanın bir depoyu incelemesi, değişiklikleri planlaması, araçları kullanması ve birçok adım boyunca hataları onarması gerektiğinde anlamlıdır. Geliştiriciler, en zor görevlerin daha yüksek maliyetli bir modeli hak edip etmediğine karar verirken bu yükseltmeyi CometAPI’deki GPT-6 Astra API ile karşılaştırabilir.
Bu, kısa kodlama kıyaslamalarından daha fazla önem taşır çünkü uzun süre çalışan kodlama ajanları, tekrarlanan akıl yürütme, araç çağrıları, dosya okumaları, yamalar ve bağlam yeniden kullanımı yoluyla maliyet biriktirir. GPT-6.1 Sol, standart $2/$10 belirteç oranını artırmadan hem görev tamamlama hem de tekrarlanan bağlam ekonomisini iyileştirir.
CometAPI’deki GPT-6 Sol API, mevcut dağıtımlar için yararlı olmaya devam eder ve kodlama ile ajansal iş yükleri için OpenAI uyumlu bir yol sunar.
AI Ajanları ve İş Akışları: Otomasyon ve Bilgisayar Kullanımı
Evet, ve iyileşme kodlamanın ötesine uzanıyor. AutomationBench, bir ajanın satış, pazarlama, operasyon, destek, finans ve İK genelinde birçok aracı kullanarak uçtan uca iş akışlarını tamamlayıp tamamlayamayacağını değerlendirir.
Kıyaslama özetindeki medium eşleşmeli AutomationBench sonucu, araç ağırlıklı iş akışları için anlamlıdır. Bu yine de bir kıyaslama sonucudur; bir şirketin kendi araç yığını içindeki başarıyı garanti etmez. Karşılaştırma ayrıca CometAPI’deki Claude Opus 5.5 API içerir; seçimden önce tüm adayları aynı araçlar ve başarı kriterleriyle değerlendirin.
Bilgisayar kullanımı için, yukarıdaki OSWorld sonucu çevrimdışı seti ve kısmi ödülü kullanır. Daha yüksek kısmi-ödül skoru, her görevin uçtan uca tamamlandığı anlamına gelmez. Tarayıcı durumu, izinler, kurtarma davranışı ve araç entegrasyonunun kalitesi, dağıtım sonuçlarını hâlâ etkiler.
Profesyonel Belgeler ve Bilim: Daha Geniş Karmaşık Görev Yeteneği
GPT-6.1 Sol, Sol katmanını profesyonel bilgi işlerine daha da iter. OpenAI, GDP.pdf ile karmaşık belge anlayışını değerlendirir; modeller, finans, sağlık ve hukuk dahil alanlar boyunca tablolar, grafikler, diyagramlar, yoğun biçimlendirme ve ince yazı içeren PDF’lere dayalı gerçekçi soruları yanıtlar.
GDP.pdf, sıradan metin tabanlı soru yanıtlamanın ötesinde profesyonel PDF analizi için kanıt ekler. Lansman duyurusundaki sonucunu, her grafiğin, dipnotun veya taranmış sayfanın doğru yorumlanacağını garanti olarak değil; belge anlayışı değerlendirmesi olarak ele alın.
Resmi kıyaslama özetindeki Terminal-Bench Science sonucu, veri analizi, simülasyon ve teorem ispatı gibi iş akışlarını kapsar. Yararlı bir yerel değerlendirme, nihai çıktının doğruluğunu ve çoğaltılabilirliğini puanlarken toplam araç ve model maliyetini ölçmelidir.
Bu, GPT-6.1 Sol’un her durumda Astra’nın yerini aldığı anlamına gelmez. OpenAI, en zorlu uçtan uca işler için Astra’yı en yüksek yetenekli modeli olarak konumlandırmaya devam ediyor. Önemli değişim, Sol ve Astra arasındaki performans farkının daralırken belirteç fiyat farkının büyük kalmasıdır.
Olgusallık ve Ajan Güvenilirliği: Daha Az Hata ve Daha İyi Hata İşleme
OpenAI’nin olgusallık verileri bu yönde işaret ediyor; ancak değerlendirme evrensel bir halüsinasyon oranı olarak yorumlanmamalıdır.
Resmi duyuru doğrudan low çabada olgusallık iyileştirmesini bildirir: hata içeren yanıtlar GPT-6 Sol ile %11.4’ten GPT-6.1 Sol ile %7.7’ye düşer; 3.7 puanlık bir azalma, yaklaşık %32 göreli düşüş. Bu seçilmiş konuşmalar daha önce hataları tetiklemişti; rakamlar evrensel bir halüsinasyon oranı değildir.
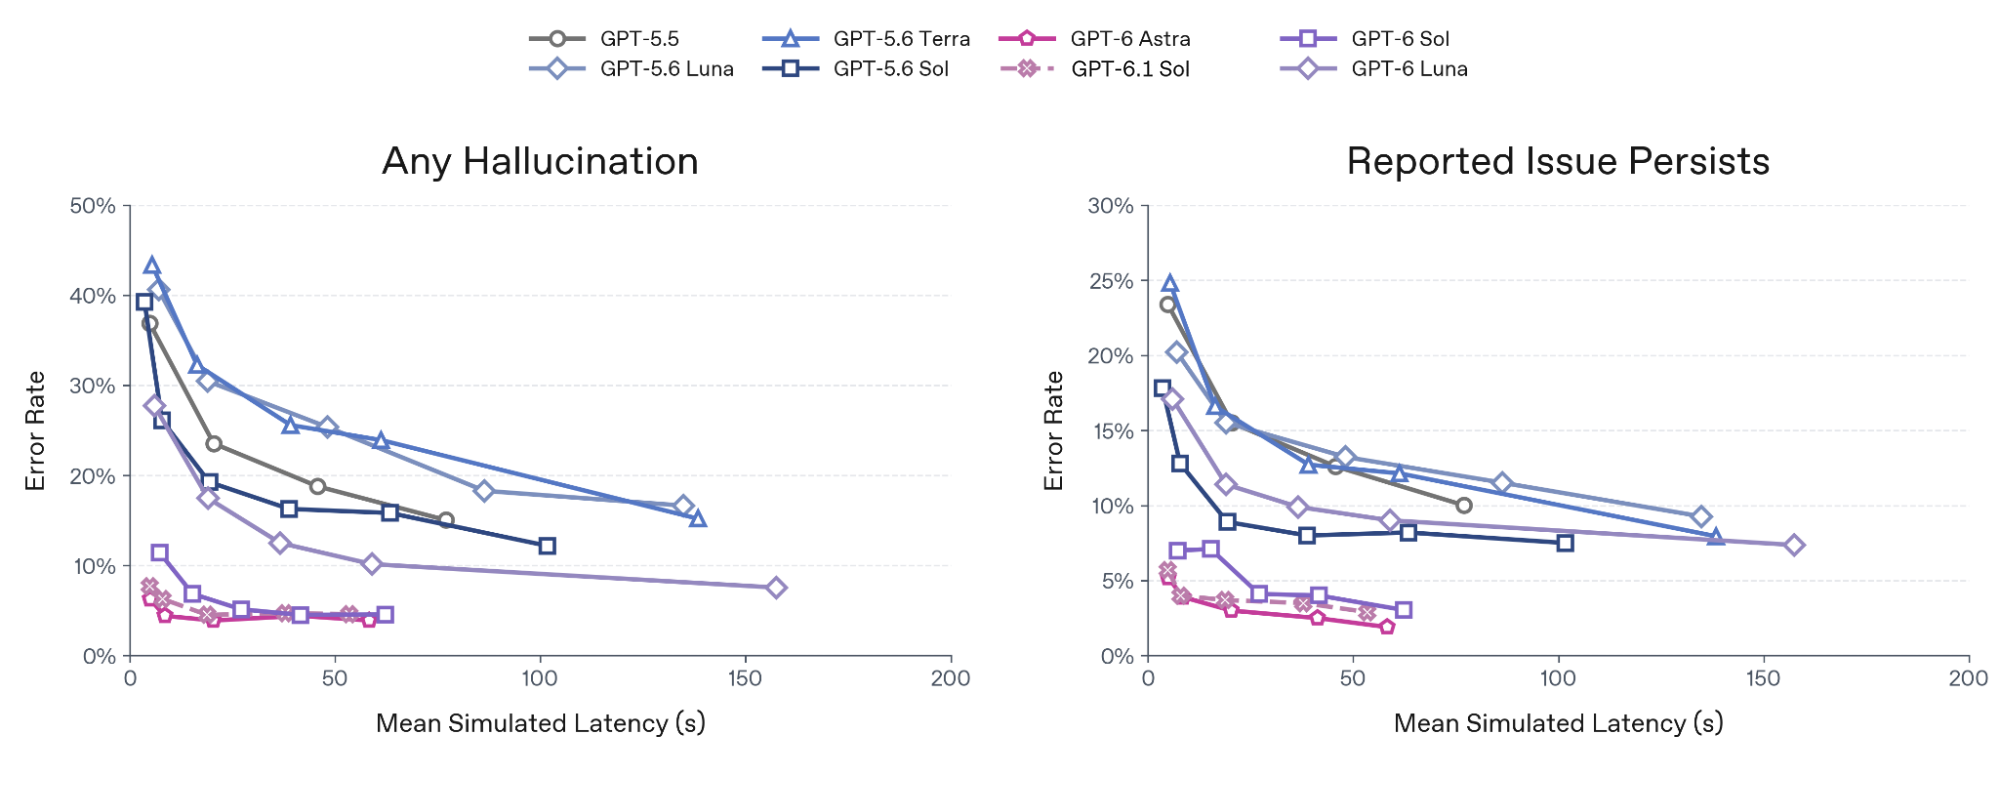
Yukarıdaki orijinal grafik, OpenAI sistem kartı PDF’sinden yeniden çizilmeden doğrudan çıkarıldı. Seçilmiş zor konuşma değerlendirmelerini simüle edilmiş gecikmeye karşı çizer; iki panel herhangi bir halüsinasyonu ve bildirilen sorunun kalıcılığını ölçer. Üretim genelinde bir hata tahmini olarak okunmamalıdır.
| Model | Bozuk arama Hata Oranı — en yüksek çaba |
|---|---|
| GPT-6.1 Sol | %2.1 |
| GPT-6 Sol | %4.9 |
| GPT-6 Astra | %1.5 |
| GPT-6 Luna | %28.7 |
CometAPI’deki GPT-6 Luna API, başka bir maliyet odaklı seçenektir; ancak buradaki bozuk arama sonucu, bir ajanın başarılı araç yürütmesinin yanı sıra hata işleme üzerinde de test edilmesi gerektiğini gösterir.
Bunlar temsilî üretim hata oranları yerine kasıtlı olarak adversaryal değerlendirmelerdir. Araçlar kullanılamadığında veya bozuk olduğunda desteklenmeyen iddialarla kendinden emin şekilde devam etmek yerine GPT-6.1 Sol’un bu durumu daha iyi tanıdığına dair kanıt olarak faydalıdırlar.
GPT-6.1 Sol ve GPT-6 Sol: Yükseltmeli misiniz?
Yeni bir karmaşık iş akışı için GPT-6.1 Sol güçlü bir değerlendirme adayıdır. Stabil bir GPT-6 Sol dağıtımı için, yükseltme ancak ölçülen kazanımlar geçişi haklı çıkardığında yapılmalıdır. Paylaşılan bağlam sınırı ve temel belirteç fiyatları, adil bir karşılaştırma olanağı sağlar; ancak kamuya açık kıyaslamalar, kendi uygulamanızın daha hızlı, güvenilir veya daha ucuz hale gelip gelmeyeceğini belirleyemez.
Ne Zaman Yükseltmeyi Test Etmeye Değer?
Depo ölçeğinde kodlama, çok adımlı iş otomasyonu, bilgisayar kullanımı veya zor belge analizi iş yükünüzde önemli pay tutuyorsa bir denemeyi önceliklendirin. Önceki bölümde bildirilen iyileştirmeler bu kullanım durumlarıyla ilgilidir. Bunları test nedeni olarak ele alın; üretim başarı oranınızın aynı miktarda artacağını garanti olarak değil.
Tekrarlanan bağlamlı uygulamalar başka bir yararlı test vakasıdır. Daha düşük önbellek okuma oranı, istekler gerçekten sabit bir ön eki yeniden kullanıyorsa faturanın giriş kısmını azaltabilir. Harcamanın çoğu, üretilen belirteçlerden, araçlardan veya başarısız denemelerden geliyorsa, yalnızca önbellek indirimi düşük etki yapabilir. Yeniden denemeler ve inceleme süresi dahil olmak üzere, kabul edilen sonuç başına toplam maliyeti karşılaştırın.
GPT-6 Sol’u Tutmanın Makul Olduğu Durumlar
Kalite, gecikme ve bütçe hedeflerinizi zaten karşılıyorsa ve yeni model temsilî bir değerlendirmede maddi bir fayda üretmiyorsa GPT-6 Sol’u koruyun. Çalışan bir entegrasyon da değerlidir: yalnızca model adı daha yeni olduğu için stabil bir rotayı değiştirmekten kaçının.
Uyumluluk belirleyici olabilir. GPT-6 Sol, none akıl yürütmeyi destekler; GPT-6.1 Sol, low ile başlar. Sol Chat Completions işlev çağrılarını none ile kullanan bir uygulama, 6.1 Sol’u kullanmak için araç döngüsünü Responses’a taşımak zorundadır. Ayrıca örnekleme parametrelerini ve yanıt ayrıştırmayı denetleyin. Bunlar, yalnızca model kimliği değişimi değil; geçiş değişiklikleridir. OpenAI geçiş rehberine bakın.
Yükseltme Kararını Nasıl Vermeli?
Planlanan iş akışınızdan rutin görevler, zor vakalar ve araç hataları içeren sabit bir değerlendirme seti oluşturun. Görev tanımlarını, araç izinlerini ve kabul kriterlerini tutarlı tutun. Doğrulanmış bir Sol temelini geçerli bir 6.1 Sol yapılandırmasıyla karşılaştırın; none ve low sanki eşdeğer değilmiş gibi akıl yürütme ayarlarını açıkça kaydedin.
- Kalite: kabul edilen tamamlamaları, olgusal düzeltmeleri, geçersiz araç çağrılarını ve insan inceleme çabasını ölçün.
- Hız: yeniden denemeler ve araç beklemeleri dahil uçtan uca p50/p95 gecikmeyi karşılaştırın.
- Maliyet: önbelleğe alınmamış giriş, önbellek okumaları, önbellek yazımları, çıkış/akıl yürütme belirteçleri, araç ücretleri ve mühendislik çabasını kaydedin.
- Yayılım: küçük bir trafik dilimiyle başlayın, bir Sol geri dönüş yolu koruyun ve yalnızca önceden tanımlanmış eşikler karşılandığında genişletin.
Pratik öneri: deneme, kabul edilen görev ekonomisini iyileştiriyor veya gerekli bir yetenek kazanımı sağlıyorsa ve kabul edilemez gerilemeler yoksa GPT-6.1 Sol’u seçin. Uyumluluk ve kanıtlanmış sonuçların ölçülen faydanın önüne geçtiği rotalarda GPT-6 Sol’u tutun. Yalnızca bazı görev sınıfları iyileştiğinde karma dağıtım makuldür. Bunlar iş yüküne dayalı önerilerdir; herhangi bir modelin evrensel olarak kazandığı iddiası değildir.
GPT-6 Sol’dan GPT-6.1 Sol’a Nasıl Geçiş Yaparsınız?
En basit düzeyde, model tanımlayıcısı gpt-6-sol’dan gpt-6.1-sol’a değişir.
Bir Responses API isteği şöyle görünebilir:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Analyze this repository and identify the cause of the failing tests."
)

print(response.output_text)
Model tanımlayıcısını değiştirmek yalnızca ilk adımdır. GPT-6.1 Sol, low, medium, high, xhigh ve max destekler; GPT-6 Sol, ayrıca none’u destekler. Açık none ayarını kaldırın ve izin verilen bir çaba seçin. Araç kullanan uygulamalar ayrıca Responses API’ye ihtiyaç duyar: GPT-6.1 Sol Chat Completions, araç çağırmayı desteklemez; GPT-6 Sol Chat Completions, araç çağırmayı yalnızca none ile destekler. Spesifikasyon tablosundaki resmi model sütunları bu uç nokta kısıtlarını belgeliyor.
Ekipler, gecikme duyarlı iş akışlarını, araç çağırmayı, istem önbelleklemesini, uzun bağlam davranışını ve reasoning.effort="none" değerini açıkça gönderen tüm mantığı yeniden test etmelidir.
Bu örnek, OPENAI_API_KEY kullanarak doğrudan OpenAI’yi hedefler; doğrulanmış bir CometAPI uç nokta örneği değildir. Aşamalı yayılım sırasında GPT-6 Sol rotanızı erişilebilir tutun, görev başarısını ve p95 gecikmeyi kaydedin ve uygulamanızın kabul kriterleri karşılanmazsa geri alın.
Hangi GPT-6.1 Sol İş Yükleri Yükseltmeden En Çok Fayda Sağlar?
| İş yükü | GPT-6.1 Sol avantajı |
|---|---|
| Kodlama ajanları | Daha yüksek DeepSWE performansı |
| Depo ölçekli hata ayıklama | Daha iyi uzun ufuklu yazılım mühendisliği |
| Tarayıcı/bilgisayar ajanları | OSWorld 2.0’da +7 puan |
| Kurumsal otomasyon | Daha yüksek AutomationBench performansı |
| Tekrarlanan bağlamlı ajanlar | %50 daha ucuz önbelleğe alınan giriş |
| Karmaşık PDF analizi | Profesyonel belge performansında Astra’ya yakın |
| Bilimsel iş akışları | OpenAI’nin Terminal-Bench Science değerlendirmesinde GPT-6 Sol skorunun 2 katından fazla |
| Olguya duyarlı iş akışları | Daha düşük zor istem olgusal hata oranı |
| Araç ağırlıklı ajanlar | Araçlar başarısız olduğunda daha iyi davranış |
GPT-6 Sol, mevcut entegrasyonlar zaten stabil olduğunda veya geliştiricilerin özel olarak none akıl yürütme ayarına ihtiyaç duyduğu durumlarda yararlı olmaya devam eder. Ajanlar, kodlama, bilgisayar kullanımı veya tekrarlanan bağlam iş akışlarına odaklı yeni dağıtımlar için, GPT-6.1 Sol normal giriş/çıkış belirteç fiyatını değiştirmeden maliyet-performans dengesini değiştirir.
CometAPI, GPT-6 Sol’dan GPT-6.1 Sol’a Yükseltmenize Nasıl Yardımcı Olabilir?
Halihazırda CometAPI’deki GPT-6 Sol API’yi kullanan geliştiriciler için, GPT-6.1 Sol’a yükseltme, tam entegrasyon yeniden yazımı yerine nispeten küçük bir geçiş olarak ele alınabilir.
GPT-6.1 Sol artık CometAPI üzerinden gpt-6.1-sol model tanımlayıcısıyla kullanılabilir. CometAPI, kısa bağlam giriş fiyatını şu anda milyon belirteç başına $1.60’dan gösterirken, OpenAI’nin resmi oranı $2.00’dır; çıkış fiyatlandırması milyon belirteç başına $8.00’dan başlar. Bu, geliştiricilere daha güçlü kodlama, ajan ve bilgisayar kullanımı performansına erişim sağlarken, yeni Sol modelini GPT-6 Sol ile aynı indirimli fiyatlandırma yapısında tutar.
CometAPI, OpenAI uyumlu bir arayüz sağladığından, mevcut GPT-6 Sol uygulamaları genellikle aynı SDK yapısını ve istek akışını koruyabilirken, model kimliğini gpt-6.1-sol olarak değiştirebilir. CometAPI ayrıca modelleri karşılaştırma, istemleri test etme, iş yükü maliyetlerini tahmin etme ve üretim yayılımından önce geçiş davranışını inceleme araçları sunar.
Daha güvenli bir yükseltme süreci, önce aynı temsilî istemleri GPT-6 Sol ve GPT-6.1 Sol’a karşı çalıştırmak, ardından çıktı kalitesini, gecikmeyi, araç davranışını ve toplam maliyeti karşılaştırmaktır. Bu, akıl yürütme ayarlarına, yapılandırılmış çıktılara, araç çağrılarına veya uzun süre çalışan ajanlara bağımlı uygulamalar için özellikle önemlidir; model uyumluluğu, her iş yükünde özdeş davranışı garanti etmez.
Tekrarlanan bağlamlı veya ajan ağırlıklı iş yükleri çalıştıran ekipler için, yeni rota ekonomiyi de iyileştirebilir. CometAPI, kısa bağlam önbellek okumalarını şu anda milyon belirteç başına $0.08 olarak fiyatlandırırken, OpenAI’nin resmi oranı $0.10’dur; kısa bağlam giriş ve çıkış oranları resmi fiyatlandırmanın %20 altında listelenir.
Uygulamada, CometAPI, GPT-6 Sol → GPT-6.1 Sol geçişini üç adımda gerçekleştirebilir:
gpt-6-solyerinegpt-6.1-solkullanın.- Trafiği taşımadan önce aynı üretim istemlerini ve ajan iş akışlarını kıyaslayın.
- Çıktı kalitesi, araç davranışı, gecikme ve maliyet gereksinimlerinizi karşıladığında iş yüklerini kademeli olarak taşıyın.
Bu yaklaşım, geliştiricilerin uygulamalarını yeni bir API yığınına göre yeniden inşa etmeden GPT-6.1 Sol’u benimsemesine ve yine de daha yeni modelin getirdiği davranış farklılıklarını doğrulamasına olanak tanır.
Sonuç
GPT-6 Sol teknik olarak modası geçmiş değildir. Aynı 1.05M bağlam penceresini, 128K çıktı tavanını, yapılandırılmış çıktıları, görüntü girişini ve $2/$10 Standart fiyatlandırmayı korur. none akıl yürütme seçeneği, mevcut entegrasyonlar için de önemli olabilir. Yükseltme kararı, yalnızca sürüm numarasına değil, ölçülen görev sonuçlarına ve uyumluluğa dayanmalıdır.
Bununla birlikte, OpenAI’nin GPT-6 Sol dokümantasyonu artık geliştiricileri Sol’un daha yeni modeli olarak GPT-6.1 Sol’a yönlendiriyor.
Çoğu karmaşık iş yükü için temel soru, GPT-6.1 Sol’un daha büyük bir bağlam penceresine veya daha yüksek belirteç oranına sahip olup olmadığı değil — sahip değildir. Soru, daha yüksek görev başarısı, daha ucuz önbellek okumaları, iyileştirilmiş olgusallık ve daha güçlü ajan davranışının, model tanımlayıcısını değiştirip iş yükünü yeniden test etmeyi haklı çıkarıp çıkarmadığıdır.
SSS
Araç çağırma ile GPT-6 Sol’dan GPT-6.1 Sol’a nasıl geçiş yaparsınız?
Hayır. Önce uç noktayı ve istek alanlarını denetleyin, ardından araç döngüsünü Responses API’ye taşıyın ve araç çağrısı ayrıştırmasını, argüman doğrulamayı, yeniden denemeleri ve hata işlemeyi test edin. Trafiği artırmadan önce temsilî görevlerde kanarya çalıştırın; başarılı bir salt metin isteği, çalışan bir araç döngüsünü doğrulamaz.
GPT-6.1 Sol gerçek iş yüklerinde daha ucuz mu?
Önbelleğe alınmış ve alınmamış giriş belirteçlerini, önbellek yazımlarını, akıl yürütme ve çıkış belirteçlerini, işlem modunu ve araç ücretlerini kaydedin. Yalnızca önbelleğe alınmış belirteç fiyatı yerine, kabul edilen görev başına maliyeti karşılaştırın. İstekler gerçekten önbelleğe isabet ettiğinde sabit ön ekler yardımcı olur ve daha uzun araç döngüleri veya başarısız denemeler önbellek tasarruflarını telafi edebilir.
GPT-6 Sol’dan GPT-6.1 Sol’a geçmeden önce GPT-6.1 Sol’u nasıl test etmelisiniz?
Üretime benzer sabit bir görev seti kullanın ve başarılı tamamlamayı, olgusal düzeltmeleri, geçersiz araç çağrılarını, p50/p95 gecikmeyi ve toplam maliyeti kaydedin. Testten önce kabul edilebilir eşikleri tanımlayın. Model yönlendirme için geri dönüş yolunu koruyun ve yeni yapılandırma bu eşikleri karşıladıktan sonra trafiği artırın.
PDF’lerle GPT-6.1 Sol’u nasıl test edersiniz?
Amaçlanan iş akışını temsil eden yoğun tablolar, dipnotlar, grafikler ve taranmış sayfalar içeren küçük bir derlem oluşturun. Doğrulanabilir yanıtları olan sorular sorun ve sayfa veya tablo kanıtı talep edin. Hesaplama doğruluğunu, gözden kaçan uyarıları ve desteklenmeyen yanıtları ayrı ayrı puanlayın; hatalarının maddi sonuçları olan çıktılar için insan incelemesini sürdürün.