
TL;DR
Grok 4.7 ve Xiaomi MiMo‑V2.6 yalnızca bir gün arayla çıktı, ancak öncü yapay zekâya iki farklı yaklaşımı temsil ediyor. Grok 4.7, kodlama ve profesyonel bilgi işleri için mülkiyetli, sıkı entegre bir ajan yığınına odaklanırken, MiMo‑V2.6‑Pro açık ağırlıkları, daha büyük bir bağlam penceresini, yerel çok kipli (multimodal) anlayışı ve agresif API fiyatlandırmasını birleştiriyor.
SpaceXAI, Grok 4.7’yi 500K token bağlam penceresi ve yapılandırılabilir akıl yürütme çabasıyla kodlama, ajan görevleri ve bilgi işi için öncü modeli olarak konumlandırıyor.
Xiaomi, MiMo‑V2.6‑Pro’yu açık ağırlıklar ve metin, görsel, ses ve video anlayışı desteğiyle 1M bağlamlı çok kipli amiral gemisi olarak konumlandırıyor.
Kısacası: Grok 4.7 daha dikey entegre, yönetilen‑ajan ürünü; MiMo‑V2.6‑Pro geliştiricilere daha fazla dağıtım denetimi ve çok daha düşük ham token fiyatlandırması sunuyor. En iyi uyum, tek bir benchmark skorundan çok iş yüküne bağlı.
Key Takeaways
- Grok 4.7, uzun ufuklu kodlama ve profesyonel ajanlar için geliştirildi. SpaceXAI’nin yayımladığı değerlendirmede CursorBench 4.0’da %46,3, yüksek çabayla DeepSWE v1.1’de %71,0 ve AA Briefcase v1.1’de 1.657 puan alıyor.
- MiMo‑V2.6‑Pro, açık bir model için olağanüstü rekabetçi. Xiaomi, model ağırlıklarını yayımlıyor ve çeşitli kodlama ve ajan kıyaslarında tescilli öncü sistemlere yakın sonuçlar raporluyor; ancak üreticiler arası skorlar doğrudan değiştirilebilir değildir.
- MiMo’nun bağlam ve çok kipli üstünlüğü var. MiMo‑V2.6‑Pro, 1M token bağlam penceresi ile metin, görsel, ses ve video anlayışını destekler; Grok 4.7 ise metin ve görsel girdili 500K bağlam sunar.
- MiMo, ham API tokenlarında belirgin biçimde daha ucuz. Resmî standart fiyatlandırma MiMo‑V2.6‑Pro için milyon başına önbelleksiz giriş/çıkış tokenlarında $0,435/$0,87, Grok 4.7 için ise $2/$6.
- Dağıtım mimarisi belirleyici ödünleşimdir. Grok, daha güçlü bir birinci taraf barındırılan araç yığını sunar; MiMo’nun açık ağırlıkları özel barındırma, özel sunum ve daha derin altyapı denetimi sağlar.
Grok 4.7 vs MiMo‑V2.6‑Pro at a Glance
| Boyut | Grok 4.7 | MiMo‑V2.6‑Pro |
|---|---|---|
| Yayın | 21 Eylül 2026 | 22 Eylül 2026 |
| Erişim ve denetim | Tescilli API ve yönetilen ajan ekosistemi | Açık ağırlıklar, kendi barındırma seçeneği ve API erişimi |
| Performans kanıtı | Sağlayıcıya göre kodlama ve uzun süreli ajan görevlerinde güçlü; aynı çerçevede doğrulayın | Sağlayıcıya göre akıl yürütme, kodlama ve çok kipli görevlerde güçlü; aynı çerçevede doğrulayın |
| Ayırt edici güçlü yönler | Birinci taraf araçlar, yönetilen iş akışları ve web/X bağlantılı ajanlar | Dağıtım denetimi, 1M token bağlam ve metin/görsel/ses/video anlayışı |
| Bağlam penceresi | 500K token | 1M token |
| Giriş kipleri | Metin ve görsel | Metin, görsel, ses ve video |
| Resmî standart önbelleksiz giriş/çıkış (1M token başına) | $2 / $6 | $0,435 / $0,87 |
| Akıl yürütme | Low’dan xHigh’a | Derin akıl yürütme |
| Açık ağırlıklar | No | No |
| En uygun kullanım | Yönetilen kodlama ve ajan iş akışları | Özel barındırma, çok kipli giriş ve daha düşük ham token maliyeti |
What Is Grok 4.7?
SpaceXAI, Grok 4.7’yi 21 Eylül 2026’da kodlama ve bilgi işi için en yetenekli modeli olarak resmen yayımladı. Lansman önemliydi çünkü öncesinde doğrulanmış bilgilerle sızdırılan mimari iddialar karışıyordu. Nihai lansman belgeleri toplam veya etkin parametre sayısını yayımlamıyor; bu nedenle ön sürüm parametre tahminleri resmî özellikler olarak görülmemelidir.
Resmî lansman paylaşımına göre Grok 4.7, Grok 4.6’dan daha büyük yeni bir temel model kullanıyor ve saatler süren problemleri önceleyen daha uzun bir pekiştirmeli öğrenme koşusuyla eğitildi.
Modeller yığının farklı katmanlarını optimize eder. Grok 4.7 modelin etrafında daha zengin, yönetilen bir ortam sunarken; MiMo‑V2.6‑Pro geliştiricilere model ve dağıtım katmanının daha fazlasını açar.
200K tokenın üzerindeki istemler için SpaceXAI daha yüksek bağlam fiyatlandırması uygular. Yayımlanan kademeler milyon başına giriş tokenlarında $4, önbelleklenmiş giriş tokenlarında $1 ve çıkış tokenlarında $12’dir.
Changes in Grok 4.7
En anlamlı değişim yalnızca daha yüksek bir benchmark skoru değil, eğitim hedefidir. SpaceXAI, pekiştirmeli öğrenme karmasının daha uzun, saatler süren görevlere kaydırıldığını, modelin kendi işini daha dikkatli doğrulamak ve Grok Bot düzeneğini yerel olarak anlamak üzere eğitildiğini söylüyor. Bu kombinasyon gerçek ajan icrasını hedefliyor: durumu korumak, araçları kullanmak, ara çıktıları kontrol etmek ve uzun görev yörüngeleri boyunca tutarlılığı sürdürmek.
Grok 4.7 Performance
| SpaceXAI tarafından yayımlanan benchmark | Grok 4.7 | Grok 4.6 | GPT‑5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 | %46,3 | %40,4 | %41,7 | %51,8 |
| DeepSWE v1.1 | %71,0* | %65,2 | %72,7 | %70,0 |
| EEBench | %64,0 | %53,0 | %39,4 | %56,4 |
| AA Briefcase v1.1 | 1.657 | 1.546 | 1.487 | 1.678 |
| Terminal‑Bench 4.0 | %38,0 | %20,3 | %37,3 | %57,9 |
| Harvey Legal Agent Benchmark | %19,6 | %15,8 | %2,5 | %6,7 |
| HealthBench Professional | %56,7 | %48,5 | %60,5 | %62,1 |
* SpaceXAI, Grok 4.7’nin DeepSWE skorunu yüksek çaba olarak işaretliyor. Bunlar sağlayıcı tarafından yayımlanan değerlendirmelerdir ve belirtilen düzenek ve akıl yürütme ayarları çerçevesinde yorumlanmalıdır.
SpaceXAI, lansman grafiklerini resmî duyuru sayfasında web‑yerel içerik olarak sunar; yukarıdaki kaynaklı tablo, açıklanan benchmark değerlerini yeniden çizilmiş bir grafikle değiştirmeden korur.
What Is Xiaomi MiMo‑V2.6?
Xiaomi, MiMo‑V2.6’yı 22 Eylül 2026’da resmen yayımladı ve açık kaynak yaptı. Aile MiMo‑V2.6‑Pro ve MiMo‑V2.6‑Flash’ı içerir; gecikmeye duyarlı iş yükleri için Pro‑UltraSpeed sunum seçeneği vardır. Grok 4.7 ile doğrudan karşılaştırma için uygun amiral gemisi muadil MiMo‑V2.6‑Pro’dur.
Xiaomi’nin resmî materyalleri açık ağırlıkları, yerel çok kipli girişi ve API fiyatlandırmasını ayrı ayrı belgeliyor. Bu kombinasyon, MiMo‑V2.6’yı benchmark sıralamalarının ötesinde de anlamlı kılıyor.
MiMo‑V2.6 vs MiMo‑V2.5: Ne geliştirildi?
Mimari başlık yalnızca daha büyük bir denetim noktası değil. Xiaomi’nin herkese açık sürümü, sonradan eğitim ve Live RL’e güçlü biçimde odaklanıyor. Resmî sürüm notlarına göre Pro ve Flash’ın her biri 30 pekiştirmeli öğrenme adımını tamamladı ve birlikte yaklaşık 750.000 trajektori üretti; açıklanan RL aşaması maliyetleri Pro için yaklaşık $2,62 milyon, Flash için $850.000 idi.
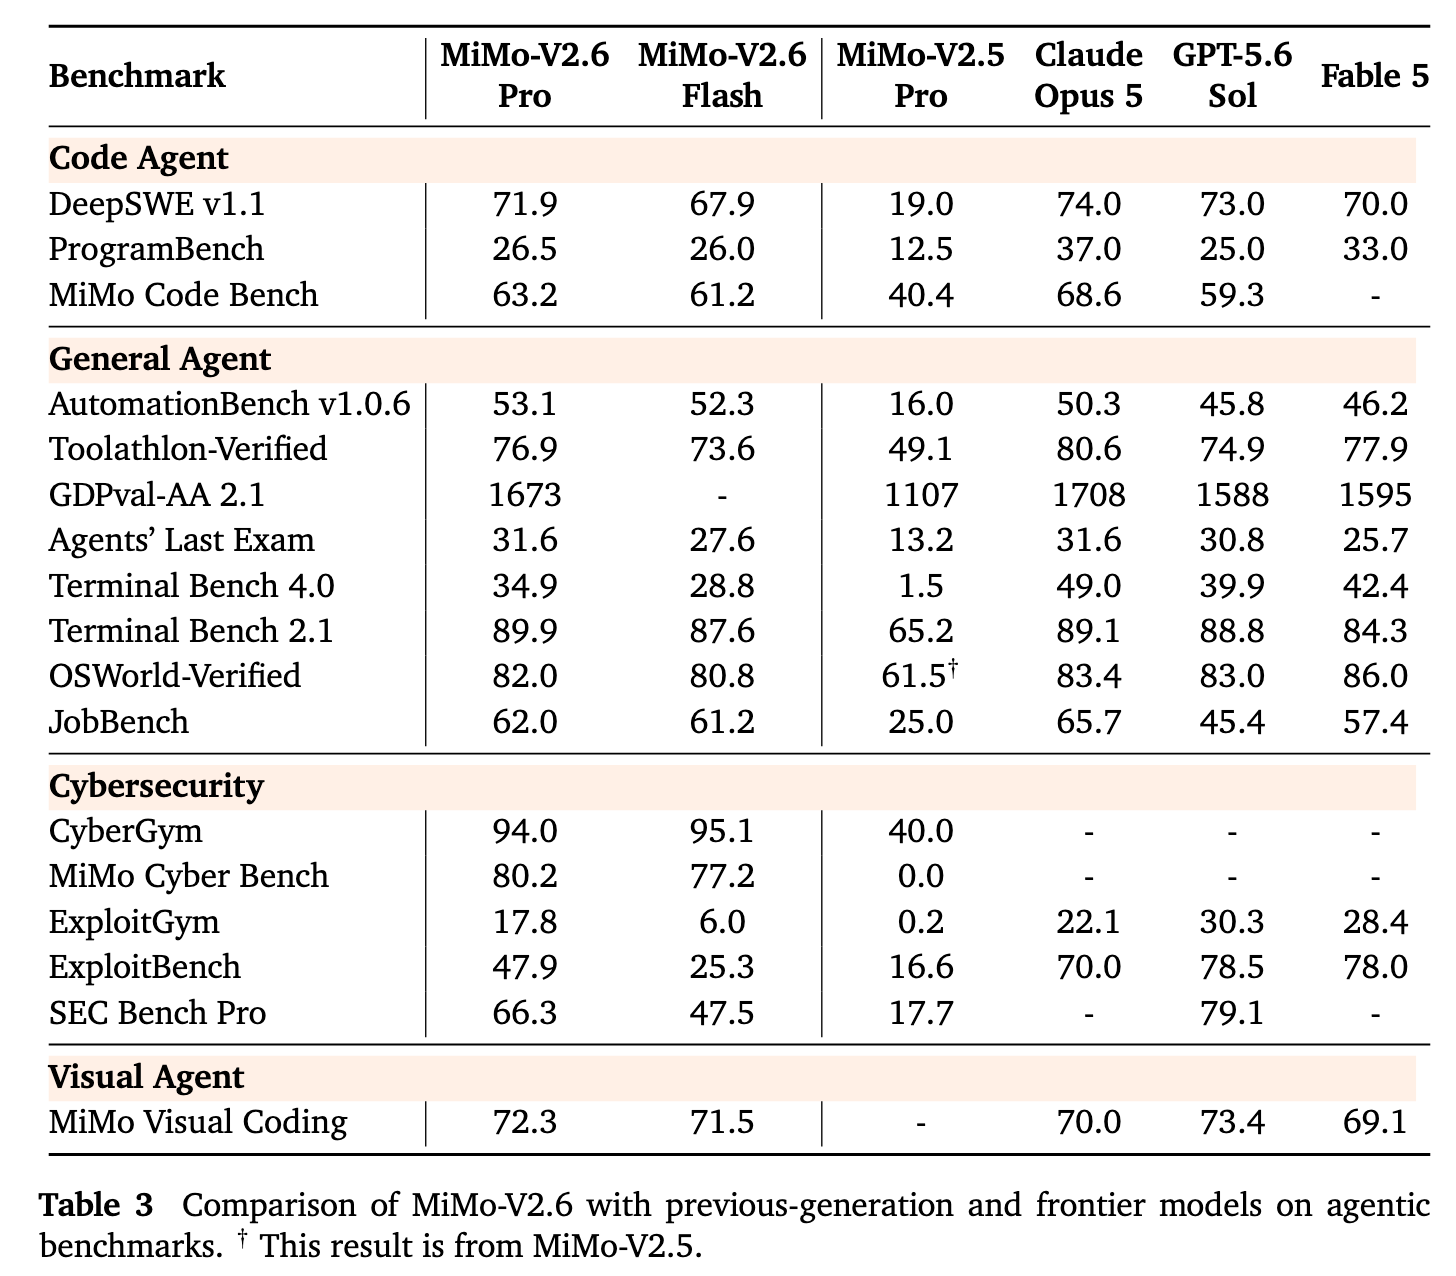
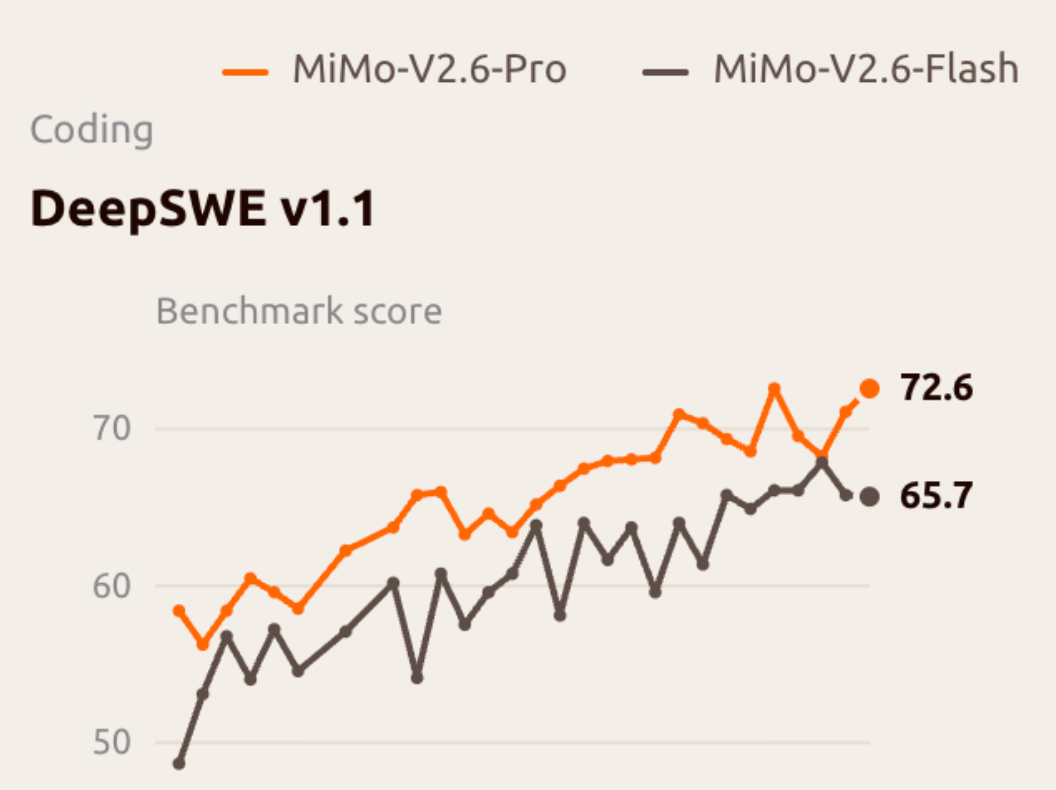
Bir benchmark ayrıntısı dikkatli ele alınmaya değer: Xiaomi’nin Live RL eğri grafiği, eğitim koşusu sırasında MiMo‑V2.6‑Pro’nun DeepSWE v1.1’de yaklaşık 72,6’ya ulaştığını gösterirken, nihai karşılaştırma tablosu 71,9 rapor ediyor. Bu sayılar farklı raporlanan değerlendirme bağlamlarına aittir ve sessizce birleştirilmemelidir.
Grok 4.7 vs MiMo‑V2.6‑Pro: Benchmark Comparison
Doğrudan benchmark karşılaştırmaları dikkat gerektirir. Sağlayıcılar her zaman aynı düzenekleri, akıl yürütme bütçelerini, denetim noktalarını veya araç yapılandırmalarını kullanmaz. Benchmark adları eşleşse bile küçük skor farkları göründüğü kadar anlamlı olmayabilir. En güvenli karşılaştırma, gerçekten hizalanmış ölçümleri yönlendirici kanıtlardan ayırmaktır.
Artificial Analysis Intelligence Index
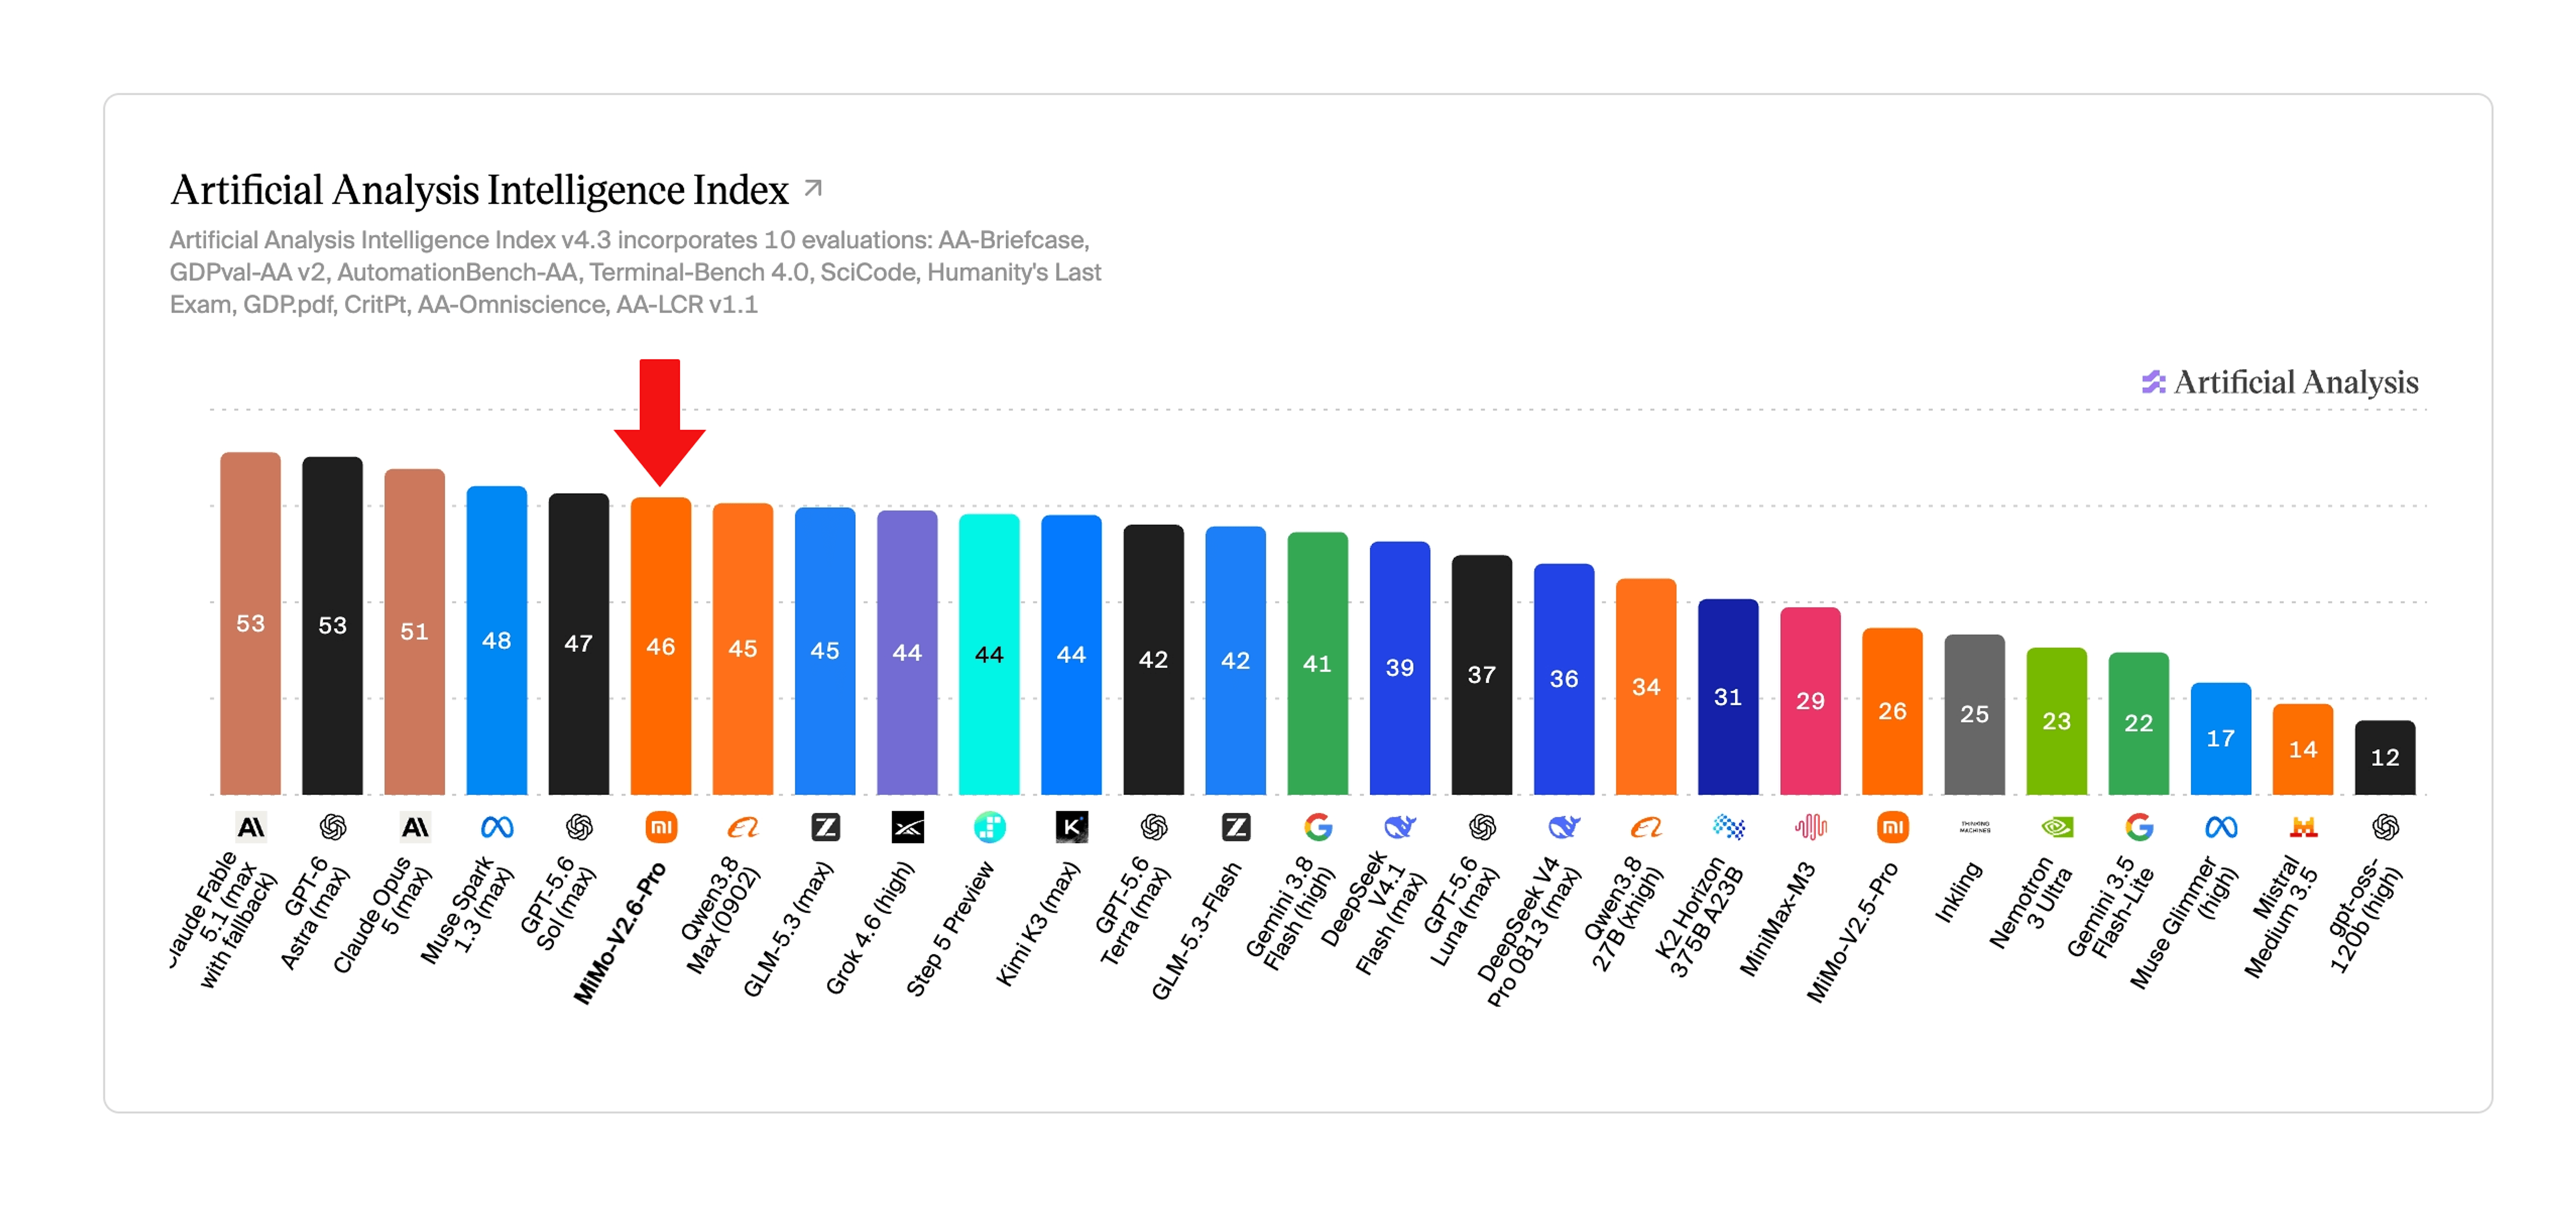
Xiaomi, MiMo‑V2.6‑Pro için Artificial Analysis bileşik endeksinde 46,32 rapor ediyor. Herhangi bir Grok karşılaştırması, kullanılan tam Artificial Analysis anlık görüntüsüne ve model yapılandırmasına bağlanmalıdır; kaynak olmadan yuvarlatılmış eşitlik iddiası sunulmamalıdır.
Coding and Agent Performance
| Benchmark | Grok 4.7 — SpaceXAI | MiMo‑V2.6‑Pro — Xiaomi | Yorum |
|---|---|---|---|
| DeepSWE v1.1 | 71,0* | 71,9** | Sayısal olarak yakın; yayımlanan koşular/ayarlar farklı |
| GDPval‑AA | SpaceXAI grafiğine bakın | 1.673 | Düzenekler hizalanmadıkça yalnızca yönlendirici |
| AA Briefcase | 1.657 | Xiaomi grafiğine bakın | Sağlayıcı raporlarına kaynak bağlamıyla birlikte bakın |
| Terminal‑Bench 4.0 | 38,0 | 34,9 | Benzer yön; düzenek önemlidir |
| Bağlam penceresi | 500K | 1M | MiMo daha fazla çalışma bağlamı destekler |
* SpaceXAI, Grok 4.7 DeepSWE’yi yüksek çabayla raporluyor. ** Xiaomi’nin nihai karşılaştırma tablosu 71,9 rapor eder; Live RL eğitim eğrisi yaklaşık 72,6’ya ulaşır. Bu rakamlar farklı değerlendirme bağlamlarından gelir.
Coding Workflow Fit
Kodlama için ayrım, “kodlama”nın ham depo problemi çözümü mü yoksa eksiksiz bir yönetilen kodlama‑ajan deneyimi mi olduğuna bağlıdır. DeepSWE v1.1’de yayımlanan sayılar, bir puanın altında kalan farkın tek başına üretim seçimini belirlememesi için yeterince yakındır.
Grok 4.7’nin üstünlüğü yığının daha üstünde. Grok Build ile entegredir, Cursor’da mevcuttur, Grok Bot düzeneğini anlamak üzere tasarlanmıştır ve birinci taraf kod yürütme ve arama araçlarıyla eşleştirilmiştir.
MiMo‑V2.6‑Pro’nun üstünlüğü yığının daha altında. Açık ağırlıklar, özel bir kodlama asistanı kurmayı, sunumu özelleştirmeyi, veri yerleşimi kontrollerini uygulamayı veya tescilli bir ajan düzeneğiyle denemeler yapmayı pratik hâle getirir.
Aralarında seçim yapan ekipler için, temsilî depolar üzerinde üretim A/B testi, tek bir herkese açık kodlama benchmark’ından daha bilgilendiricidir.
Grok 4.7 vs MiMo‑V2.6‑Pro: Multimodal Capability Differences
Bu en net farklardan biridir. Grok 4.7 metin ve görsel girişleri kabul eder ve metin üretir. Daha geniş Grok platformu ayrı medya ürünleri sunar, ancak bunlar doğrudan grok‑4.7 modelinin kip yüzeyiyle karıştırılmamalıdır.
MiMo‑V2.6‑Pro metin, görsel, ses ve video anlayışını destekler. 1M token bağlam penceresiyle birleştiğinde, tek bir model bağlamında ele alınabilecek iş akışlarının kapsamını genişletir.
- Aynı görevde ekran görüntüsü ve kod analizi
- Talimat eşlikli video anlayışı
- Uzun biçimli ses işleme
- Görsel geri bildirimli bilgisayar kullanım ajanları
- Çok kipli araştırma asistanları
- Büyük ölçekli çok kipli çıkarım ve QA
Grok 4.7 vs MiMo‑V2.6‑Pro: API Pricing Comparison
| Resmî API fiyatlandırması | Grok 4.7 | MiMo‑V2.6‑Pro |
|---|---|---|
| Giriş / 1M token | $2,00 | $0,435 |
| Önbellekli giriş / 1M | $0,50 | $0,0036 |
| Çıkış / 1M | $6,00 | $0,87 |
| Uzun bağlam ek ücreti | Evet, 200K istem tokenı üzeri | Yayınlanmış karşılaştırılabilir standart kademe yok |
| Açık ağırlık/kendi barındırma | Hayır | Evet |
Liste fiyatında MiMo‑V2.6‑Pro, normal girişte ve üretilen çıkışta birkaç kat daha ucuzdur; önbelleğe alınmış bağlamda fark özellikle büyüktür. Bu, depoları, uzun belgeleri veya kalıcı bağlamı tekrar tekrar işleyen ajanların ekonomisini maddi olarak etkileyebilir.
Önemli fiyatlandırma notu: Grok 4.7’nin 500K bağlam penceresi, tüm bağlamın standart oranda faturalandırıldığı anlamına gelmez. 200K istem tokenını aşan istekler uzun bağlam kademesinde ücretlendirilir.
24 Eylül 2026 itibarıyla CometAPI, Grok 4.7’yi resmî $2,00 ve $6,00 yerine milyon başına girişte $1,60 ve çıkışta $4,80 olarak listeliyor. MiMo‑V2.6‑Pro’yu ise resmî $0,435 ve $0,87 yerine girişte $0,348 ve çıkışta $0,696 olarak listeliyor. Bu listelenen standart oranlar, ilgili resmî oranlardan %20 daha düşüktür. Fiyatlar ve uygunluk değişebilir; bütçelemeden önce canlı model sayfalarını doğrulayın.
Token fiyatı, tamamlanan görev başına maliyetle aynı değildir. Akıl yürütme modelleri farklı token hacimleri tüketebilir, farklı sayıda araç çağrısı kullanabilir ve farklı yeniden deneme oranları gerektirebilir. Bu nedenle üretim değerlendirmesi, tamamlanan görev maliyetini, gecikmeyi ve başarı oranını birlikte izlemelidir.
Grok 4.7 vs MiMo‑V2.6‑Pro: Access and Availability
Erişim farkı açıktır: Grok 4.7 API ve yönetilen Grok iş akışları üzerinden kullanılabilirken, model ağırlıkları kendi barındırma için sunulmaz. MiMo‑V2.6‑Pro hem API üzerinden hem de açık ağırlık olarak mevcuttur ve ek bir kendi barındırma yolu sağlar.
Uygunluk, lisanslama veya dağıtım esnekliğinden ayrıdır. 24 Eylül 2026 itibarıyla her iki modelin de canlı CometAPI katalog sayfaları vardır. Ekipler, üretime geçmeden önce uç nokta, bölge, hız limitleri ve hesap uygunluğunu doğrulamalıdır; listelenmiş bir model, her hesap için aynı kullanılabilirlik veya hizmet düzeylerini garanti etmez.
| Uygunluk sorusu | Grok 4.7 | MiMo‑V2.6‑Pro |
|---|---|---|
| Resmî API | xAI üzerinden mevcut | Xiaomi MiMo üzerinden mevcut |
| CometAPI kataloğu | Mevcut olarak listelenmiş | Mevcut olarak listelenmiş |
| Kendi barındırılan ağırlıklar | Mevcut değil | Açık ağırlık seçeneği |
| Operasyonel kontrol | Hesap erişimi, bölge, hız limitleri ve araç uygunluğunu doğrulayın | Hesap erişimini, uç nokta hazırlığını ve kendi barındırma gereksinimlerini doğrulayın |
Open Weights and Proprietary Access
MiMo‑V2.6‑Pro’nun açık ağırlık olması, bir puanlık benchmark farkından daha fazlasını değiştirir. Özel dağıtım, çıkarım motoru ayarı, özel sonradan eğitim, veri yerleşimi kontrolleri ve daha derin altyapı entegrasyonu için seçenekler yaratır.
Grok 4.7 ters ödünleşimi seçer: model içlerine daha az denetim karşılığında yönetilen, sürekli işletilen bir hizmet ve sıkı entegre bir birinci taraf ekosistemi. Pek çok kuruluş için yönetişim ve altyapı gereksinimleri, benchmark performansından önce kısa listeyi belirleyecektir.
How to Use Grok 4.7 and MiMo V2.6 APIs in CometAPI
Geliştiriciler, CometAPI’de Grok 4.7 API erişimine birleşik API iş akışıyla ulaşabilir ve ayrı sağlayıcıya özgü entegrasyonları sürdürme ihtiyacını azaltabilir.
Birden çok öncü modeli kıyaslayan ekipler için birleşik bir API katmanı özellikle yararlıdır; çünkü aynı üretim istemleri, test düzeneği, token muhasebesi ve uygulama kodu, daha az entegrasyon değişkeniyle modeller arasında yeniden oynatılabilir.
CometAPI artık MiMo‑V2.6‑Pro’yu mevcut olarak listeliyor ve API uygunluğu 22 Eylül 2026’da doğrulandı. Üretim kullanımından önce canlı katalogu ve hesap erişimini kontrol edin.
Her iki model sayfası da artık mevcut olarak listelendiğine göre, uygulama düzeyinde bir A/B testi istemleri, araçları, akıl yürütme ayarlarını ve başarı ölçütlerini olabildiğince tutarlı tutabilir; ardından görev tamamlama, gecikme, token kullanımı ve hata kiplerini karşılaştırabilir.
Grok 4.7 vs MiMo‑V2.6‑Pro: Model Fit by Use Case
| Gereksinim | Model uyumu / değerlendirme rehberi |
|---|---|
| Birinci taraf web ve X araması | Grok 4.7 |
| Yönetilen uzun süreli ajanlar | Grok 4.7 |
| Grok Build / Cursor iş akışları | Grok 4.7 |
| 1M token bağlam | MiMo‑V2.6‑Pro |
| Yerel ses/video anlayışı | MiMo‑V2.6‑Pro |
| Açık ağırlıklar, kendi barındırma ve model denetimi | MiMo‑V2.6‑Pro |
| En düşük ham API token maliyeti | MiMo‑V2.6‑Pro |
| Depo kodlama | Temsilî depolarda ikisini de kıyaslayın |
| Profesyonel bilgi ajanları | Üretim görevlerinde ikisini de kıyaslayın |
Bu nedenle karar, iş yükü mimarisi etrafında çerçevelenmelidir. Grok 4.7, yönetilen bir ajan yığınını daha yetenekli hâle getirmek için tasarlanmıştır; MiMo‑V2.6‑Pro ise üst düzey zekâyı daha ucuz, daha çok kipli ve daha denetlenebilir kılmak üzere tasarlanmıştır.
Which one should you choose?
Birinci taraf web ve X araması, yerel kod yürütme ve daha az işletilecek altyapıyla yönetilen bir ajan deneyimi istiyorsanız Grok 4.7’yi seçin. Entegre bir araç yığınına ve uzun süreli profesyonel veya kodlama iş akışlarına değer veren ekipler için daha pratiktir.
Açık ağırlıklara, özel dağıtıma, 1M token bağlam penceresine, yerel ses ve video anlayışına veya belirgin biçimde daha düşük ham API fiyatlandırmasına ihtiyacınız varsa MiMo‑V2.6‑Pro’yu seçin. Dağıtım denetimi, çok kip kapsamı ve maliyet verimliliği birincil kısıtlar olduğunda daha güçlü seçenektir.
Seçim hâlâ net değilse, aynı temsilî görevlerde iki modeli de aynı istemler, araçlar, akıl yürütme bütçeleri, zaman aşımı ve yeniden deneme politikalarıyla çalıştırın. Tamamlama oranı, gecikme, başarılı görev başına toplam maliyet ve insan inceleme çabası kombinasyonunda en iyi sonucu veren modeli seçin.
Conclusion
Grok 4.7 ile MiMo V2.6 karşılaştırması, ham zekânın artık tek anlamlı ayırt edici olmadığını gösteriyor. Her iki model de güncel herkese açık değerlendirmelerde benzer yüksek yetkinlik bandını işgal ediyor, ancak ürün stratejileri keskin biçimde ayrışıyor.
Grok 4.7; 500K bağlam penceresini, yapılandırılabilir akıl yürütmeyi, güçlü uzun ufuklu ajan eğitimini ve olgun bir birinci taraf arama/yürütme yığınını birleştirir. MiMo‑V2.6‑Pro; 1M bağlam penceresini, yerel çok kipli girdileri, açık ağırlıkları ve pek çok tescilli öncü sistemin çok altında API fiyatlandırmasını birleştirir.
Geliştiriciler için pratik soru bu nedenle “hangi benchmark skoru daha yüksek?”ten çok “zeka nerede yaşamalı?”dır. Yönetilen bir ajan ekosistemi ile açık ve özelleştirilebilir bir model yığını farklı operasyonel problemleri çözer. Doğru tercih, üretim iş yüküne, altyapı kısıtlarına ve maliyet modeline en iyi uyanıdır.
FAQs
Grok 4.7, 2,1 trilyon parametreli bir model mi?
Yayımdan önce yaklaşık 2,1T rakamı dolaştı, ancak nihai SpaceXAI Grok 4.7 belgeleri toplam veya etkin parametre sayısını yayımlamıyor. Doğrulanmış ifade, Grok 4.7’nin Grok 4.6’dan daha büyük bir temel model kullandığıdır.
MiMo‑V2.6 açık kaynak mı?
Xiaomi, indirilebilir ağırlıklar ve ilişkili araştırma kaynaklarıyla MiMo‑V2.6’yı açık bir model ailesi olarak yayımladı. Üretim planlamasında, ekipler yine de amaçlanan kullanımları için tam model lisansını ve yeniden dağıtım koşullarını gözden geçirmelidir.
Tamamlanan ajan görevi başına Grok 4.7 ile MiMo‑V2.6‑Pro ne kadar maliyetli?
Görev kümesini, istemleri, araç izinlerini, yeniden deneme politikasını ve başarı ölçütlerini normalize edin. Toplam giriş, önbellekli giriş, akıl yürütme ve çıkış tokenlarını, araç çağrılarını, gecikmeyi, yeniden denemeleri ve insan inceleme süresini izleyin. Ham token fiyatı, tamamlanan görev maliyetinin yalnızca bir bileşenidir.
Grok 4.7 ile MiMo‑V2.6‑Pro benchmark karşılaştırmaları ne kadar güvenilir?
Aynı depo veya görev kümesini, ajan düzeneğini, araçları, akıl yürütme bütçesini, zaman aşımını, yeniden deneme politikasını ve puanlama rubriğini kullanın. Güven aralıkları veya tekrarlı çalıştırma değişkenliğini raporlayın ve sağlayıcı yayını verileri iç sonuçlardan ayrı tutun.
Grok 4.7 uzun bağlamlı istemler için daha fazla ücret alıyor mu?
SpaceXAI, istem tokenları 200K’yı aştığında daha yüksek oranlar belgeliyor. Daha yüksek kademe isteğe uygulandığından, büyük depoları veya kalıcı ajan bağlamını kullanan ekipler eşiği açıkça modellemelidir.