CometAPI ile geliştirinBirden çok model için tek bir API mi gerekiyor?İş akışını Playground'da test edin, ardından model ve maliyet kullanım senaryonuza uyduğunda bir API anahtarı oluşturun.
Qwen 3.8 Max'in Yerel Olarak Konuşlandırılması: Donanım, vLLM, SGLang ve Kantizasyon Rehberi
Qwen3.8-2.4T-A95B açık ağırlıklarıyla Qwen 3.8 Max’i yerelde nasıl dağıtılır; GPU gereksinimleri, FP8/FP4, vLLM, SGLang, 1M bağlam ve üretim ortamı optimizasyonu ile birlikte.
Qwen3.8-Max’i yerelde çalıştırmak artık mümkün, ancak “Qwen 3.8 Max’i yerelde” ifadesi önemli bir açıklamayı gerektiriyor. Alibaba’nın barındırılan Max ürünü ile indirilebilir checkpoint yakından ilişkilidir, ancak aynı ürün değildir.
Qwen, barındırılan Max hizmetini ilk olarak 2026 Ağustos ayının başında kullanıma sundu ve 12 Ağustos 2026’da Qwen3.8-2.4T-A95B’yi açık ağırlıklar olarak yayımladı. Kendi altyapınıza gerçekten kurup çalıştırdığınız model bu checkpoint’tir.
Bu, oyun bilgisayarında Ollama ile sıradan bir eğitim değil. Kuantize edilmemiş checkpoint, 2,4 trilyon parametreli bir Mixture-of-Experts modelidir ve mevcut vLLM tarifi BF16 ağırlıklarını 4.45 TiB olarak boyutlandırmaktadır. Üretime dönük 4-bit kayan nokta varyantları bile yaklaşık 1.3–1.5 TiB ağırlık kaplar.
Kısa cevap: tam Qwen 3.8 Max sınıfı kendi ortamında barındırma bir veri merkezi dağıtımıdır. Pratik bir üretim başlangıç noktası, ’tir; H200 dağıtımları daha fazla GPU gerektirir. Normal bir iş istasyonu için bunun yerine Qwen3.8-27B kullanın.
Qwen 3.8 Max ile Gerçekte Dağıttığınız Açık Modelin Karşılaştırması
İndirilebilir Qwen3.8-2.4T-A95B checkpoint’i, her token için yaklaşık 95B parametrenin etkinleştiği 2,4T parametreli nedensel dil modeli olarak resmen tanımlanır. Barındırılan Max hizmeti, mevcut açık checkpoint’te bulunmayan ürün katmanı yetenekleri ekler.
Barındırılan ürün, 1,000,000 token’lık bağlamla metin, görüntü ve video girdi desteği sunar. Buna karşılık, açık checkpoint yalnızca metinseldir ve yerel 262,144 token’lık bağlama sahiptir. Uygulamanız çok kipli girdiye veya yönetilen yerleşik araçlara bağlıysa bu fark önemlidir.
Qwen 3.8 Mimarisi ve Teknik Özellikler
CometAPI, “Qwen3.8 Max nedir” bölümünde model arka planını zaten ele alıyor; bu nedenle bu dağıtım kılavuzu, mimari tartışmasını belleği, paralelliği ve sunumu etkileyen ayrıntılarla sınırlı tutar.
Dağıtımla ilgili özellik
Qwen3.8-2.4T-A95B
Toplam / etkin parametreler
2.4T / ~95B token başına
Katman düzeni
92 katman: 69 Gated DeltaNet + 23 tam dikkat
MoE yönlendirmesi
512 yönlendirilen uzman; 10 yönlendirilen + 1 paylaşılan etkin
“95B aktif parametre” ifadesini 95B’lik bir modelin bellek ayak izi olarak yorumlamayın. Seyrek etkinleştirme, token başına hesaplamayı azaltır, ancak sunum sistemi yine de tüm uzman ağırlık setine erişime ihtiyaç duyar.
Qwen 3.8 Max Karşılaştırma (Benchmark) Anlık Görünümü
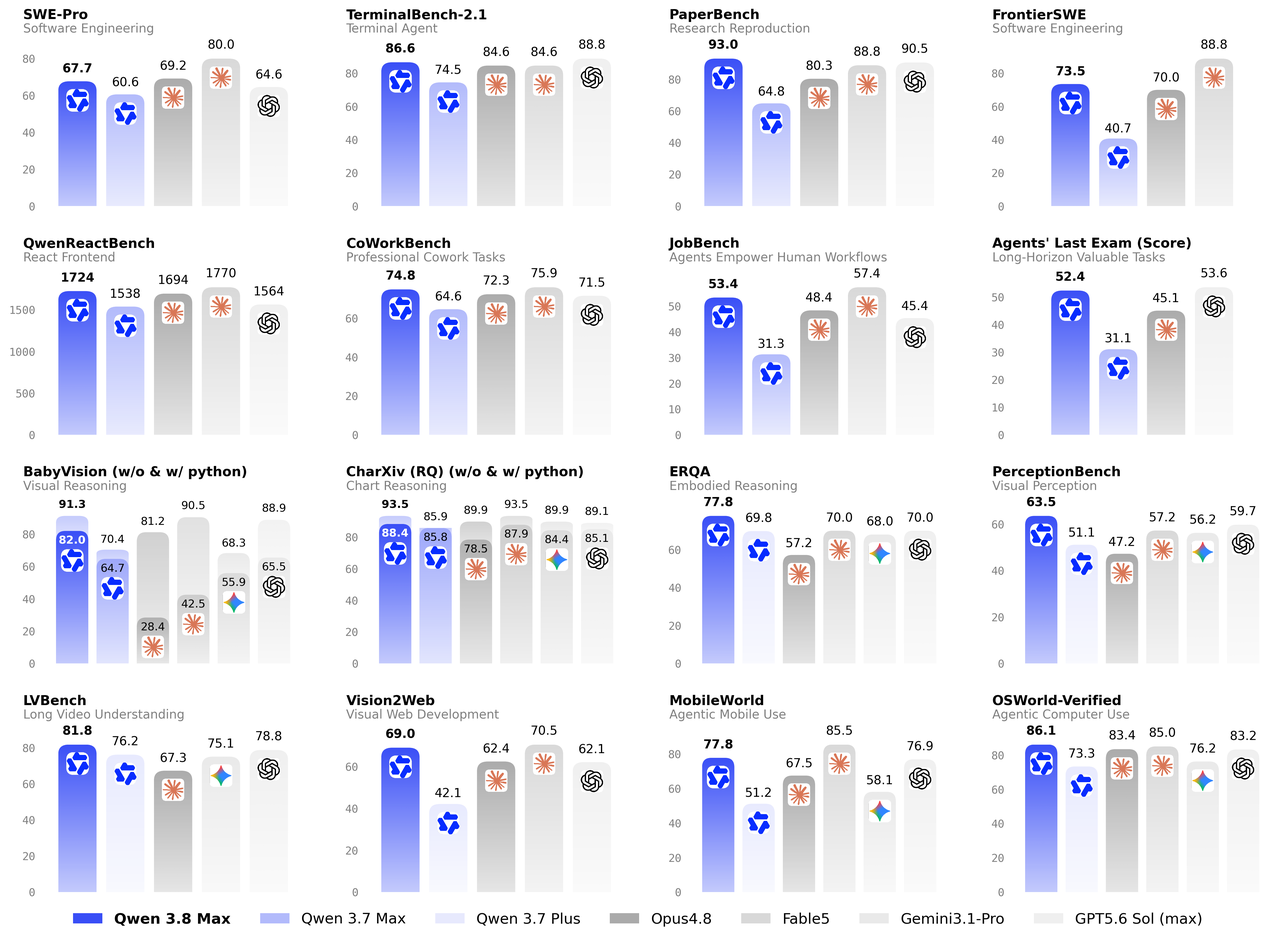
CometAPI’nin mevcut Qwen3.8 Max genel bakışı zaten karşılaştırmaları ayrıntılı olarak ele aldığından, bu yazı resmi Qwen model kartındaki benchmark tablosundan yalnızca dağıtımla ilgili bir alt küme kullanır.
Benchmark
Qwen3.8-Max
Qwen3.7-Max
GPT-5.6 Sol (max)
Terminal Bench 2.1
86.6
74.5
88.8
SWE-bench Pro
67.7
60.6
64.6
PaperBench
93.0
64.8
90.5
FrontierSWE
73.5
40.7
—
CoWorkBench
74.8
64.6
71.5
GPQA Diamond
92.6
92.4
94.1
Qwen ekibi* tarafından yayımlanan resmi Qwen3.8 performans grafiği.*
Bu alt kümede Qwen3.7-Max’e göre bildirilen en büyük kazanımlar PaperBench ve FrontierSWE’dedir. Qwen3.8-Max, SWE-bench Pro ve PaperBench’te GPT-5.6 Sol’u da aşarken, GPT-5.6 Sol Terminal Bench 2.1’de önde kalır. Dağıtım kararları için bunları yetenek bağlamı olarak değerlendirin; aşağıdaki bellek ve sunum-verim ölçümleri operasyonel açıdan daha ilişkilidir.
Benchmark tabloları evrensel sıralamalar değildir. Ortamlar, zaman aşımı değerleri, bağlam sınırları, araç erişimi ve kuantizasyon sonuçları değiştirebilir. Kullanmayı planladığınız tam checkpoint, hassasiyet, sunum motoru ve prompt dağılımını bizzat kıyaslayın.
Yerel Dağıtım için Qwen3.8 Hangi Donanıma İhtiyaç Duyar?
Qwen3.8-2.4T-A95B için GPU Gereksinimleri
Bu kilit dağıtım sorusudur. Mevcut vLLM Qwen3.8 tarifi denetim noktası ayak izlerini ve çalışma zamanı payıyla gerçekçi GPU sayılarını yayımlar; bu, VRAM’i yalnızca parametre sayısından tahmin etmekten daha kullanışlıdır.
Hassasiyet
Ağırlık ayak izi
B300 (268 GB)
MI355X (288 GB)
H200 (141 GB)
En uygun
BF16
4.45 TiB
24 GPU
24 GPU
48 GPU
Maksimum sadakat / araştırma
FP8
2.27 TiB
16 GPU
16 GPU
32 GPU
Yüksek sadakatli üretim
MXFP4
1.45 TiB
—
8 GPU
16 GPU
Pratik AMD dağıtımı
NVFP4 W4A4
1.32 TiB
8 GPU
—
16 GPU
Pratik NVIDIA dağıtımı
Qwen3.8’i gerçekten kendi ortamında barındırmaya ihtiyaç duyan çoğu kuruluş için pratik başlangıç noktası FP4’tür. Öne çıkan NVIDIA yapılandırması 8× B300 üzerinde NVFP4 W4A4’tır; karşılık gelen AMD yolu 8× MI355X üzerinde MXFP4’tür.
8× H200 sunucusu bu önerilen tam model dağıtımları için yeterli değildir. Resmi tarif, H200’ü FP4 için 16 GPU, FP8 için 32 ve BF16 için 48 GPU olarak boyutlandırır.
Qwen3.8-27B için VRAM Gereksinimleri
Qwen3.8-27B pratik iş istasyonu sınıfı alternatiftir. Ham ağırlık belleği BF16’da yaklaşık 54 GB, FP8’de 27 GB ve 4-bit hassasiyette 13.5 GB’tır. Çalışma zamanı ek yükü ve KV önbelleği, özellikle uzun bağlam uzunluklarında gerçek gereksinimi artırır.
Hassasiyet
Yaklaşık ağırlık belleği
Pratik dağıtım rehberi
BF16
~54 GB
Bağlam ve sunum ek yüküne bağlı olarak 64–80 GB GPU kullanın.
FP8 / INT8
~27 GB
40–48 GB GPU daha pratik çalışma zamanı payı sağlar.
4-bit
~13.5 GB
Orta bağlam uzunluklarında 20–24 GB tüketici GPU’su uygulanabilir olabilir.
Bu rakamlar, parametre sayısından türetilmiş planlama tahminleridir. Üretim donanımını boyutlandırmadan önce tam checkpoint’i, kuantizasyon formatını, sunum motorunu, bağlam uzunluğunu ve KV önbellek ayarlarını doğrulayın.
Qwen3.8 Tüketici GPU’larında Çalışabilir mi?
Tam Qwen3.8-2.4T-A95B modeli, agresif şekilde kuantize edildiğinde bile sıradan tüketici GPU’larında pratik değildir. Topluluk projesi, dört DGX Spark sisteminde agresif biçimde sıkıştırılmış 397 GB UD-Q1_0 yapısını göstermiştir; ancak bu yol, kaliteye duyarlı sunum için temel alınacak yol değil, deneysel bir aşırı kuantizasyondur.
Bir iş istasyonu veya ev laboratuvarı için daha uygun model açık ağırlıkları 14 Ağustos 2026’da yayımlanan Qwen3.8-27B’dir. Modeli barındırmak kat kat daha kolaydır ve “yerel” ifadesi tek bir iş istasyonu anlamına geliyorsa doğru seçenektir.
Qwen 3.8 Max’i Kurmadan Önce
Bir kurulum komutu çalıştırmadan önce altyapıyı planlayın. Linux’a, uyumlu bir hızlandırıcı yığına, checkpoint için yeterli yerel veya paylaşımlı depolamaya, yüksek bant genişlikli GPU ara bağlantılarına ve düğümler arası geçerken dağıtılmış çıkarım için tasarlanmış bir ağa ihtiyacınız var. vLLM tarifi şu anda vLLM nightly ve Transformers 5.4.0 veya daha yenisini öneriyor.
Qwen tarafından sağlanan bir checkpoint isteyip çok düğümlü altyapıyı karşılayabildiğiniz durumlarda FP8 mantıklı bir seçimdir. Resmi checkpoint Qwen/Qwen3.8-2.4T-A95B-FP8’dir.
İki düğümlü, 16 GPU’lu B300 sınıfı bir dağıtım için baş düğümü şu şekilde çalıştırın:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr "$HEAD_ADDR" \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
On the worker node, use the same topology with a different node rank and no API server:
Topolojiyi yeniden boyutlandırmadan 16 GPU’luk örneği H200 sunucularına kopyalamayın. Aynı FP8 varyantı vLLM tarifinde şu anda 32× H200 olarak boyutlandırılmıştır.
Qwen 3.8 Tek 8× B300 Sunucusunda Nasıl Çalıştırılır
NVIDIA Blackwell için en pratik tam model yapılandırması NVFP4’tür. vLLM, şu anda NVFP4 W4A4’ü sekiz B300 GPU arasında tensör paralelliğiyle doğrulamaktadır.
Inferact NVFP4 derlemesi, özgün BF16 Qwen eserinden ziyade kuantize bir checkpoint’tir. BF16 veya FP8 için bire bir ikame olarak değerlendirmeden önce model kalitesini kendi kabul setinizde doğrulayın.
Qwen 3.8 SGLang ile Nasıl Dağıtılır
SGLang, 12 Ağustos’ta Qwen3.8 için Gün-0 desteği ekledi ve yüksek verimli sunum, önek önbellekleme, uzman paralelliği, spekülatif kod çözme ve prefill/decode ayrıştırması için özellikle caziptir.
SGLang, MTP ile TP8 B300 üzerinde yığın boyutu 1 için saniyede 346 çıktı token’ı bildiriyor ve ayrık sunum yerleşimlerinde toplam verim önemli ölçüde daha yüksektir. Bu sayıları model kalitesi benchmark’ları değil, sunum yığını ölçümleri olarak değerlendirin.
Yerel OpenAI Uyumlu Uç Noktayı Test Edin
Hem vLLM hem SGLang OpenAI uyumlu API’ler sunar; bu da uygulama entegrasyonunu kolaylaştırır.
python
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
    timeout=3600,
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.8-2.4T-A95B-FP8",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant Redis architecture for three regions."
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=8192,
)

print(response.choices[0].message.content)
Resmi model kartı, temel örnekleme parametreleri olarak temperature=1.0, top_p=0.95 ve top_k=20’yi önerir. Aracısal (agentic) işler için, yalnızca nihai görünür yanıt için max_tokens’ı ayarlamak yerine akıl yürütme için yeterli çıktı bütçesi bırakın.
Desteklendi diye 1M’i varsayılan yapmayın. Daha büyük azami bağlamlar daha fazla önbellek kapasitesi ayırır ve eşzamanlılığı ciddi biçimde azaltabilir. --max-model-len değerini gerçek iş yüküne göre belirleyin.
Qwen3.8 Çıkarım Performansı Nasıl İyileştirilir?
Tek Kullanıcı Gecikmesini Azaltmak için MTP-3 Kullanın
Qwen3.8, Çoklu Token Tahmini (MTP) içerir. vLLM’nin yayımladığı ölçümlerde MTP-3, kullanıcı başına çıktıyı FP8 TP16 için 130’dan 307 tok/sn’ye ve NVFP4 TP8 için 133’ten 304 tok/sn’ye çıkarır.
Daha Hızlı Başlangıç için fastsafetensors Kullanın
Terabayt ölçeğindeki modeller için başlangıç süresi önemlidir. Bir vLLM ölçümünde, fastsafetensors ve lazy loading ile ağırlık yükleme süresi 545 sn’den 306 sn’ye düştü.
Eşzamanlı verimi artırmak için Uzman Paralelliği Kullanın
Yüksek eşzamanlılık için Qwen3.8, 512 yönlendirilen uzmana sahip olduğundan uzman-paralel yerleşimlerden fayda sağlar. vLLM, FP8 EP için GPU başına toplam 3,200 tok/sn ve optimize edilmiş NVFP4 DEP16 yapılandırması için GPU başına toplam 4,300 tok/sn’ye kadar rapor eder.
VRAM ile Eşzamanlılığı Dengelemek için --max-model-len Ayarlayın
--max-model-len değerini iş yükünün gerçekten gerektirdiği en uzun dizgeye ayarlayın. Daha büyük bir değer daha fazla KV-önbellek kapasitesi ayırır, bellek baskısını artırır ve model ağırlıkları zaten sığsa bile eşzamanlı istek sayısını azaltabilir.
Modelin en büyük ilan edilen bağlamı yerine temsil edici bir üretim yüzdelik dilimiyle başlayın. Üretimde kullanacağınız aynı hassasiyet, yığın modeli ve sunum motoruyla seçtiğiniz sınırı yük testine tabi tutun; gerçek istekler daha fazla bağlam gerektirdiğinde artırın.
Qwen 3.8 Max Yerel Dağıtım ve API Karşılaştırması
Açık ağırlıklar yerel çıkarımı kendiliğinden ekonomik hâle getirmez. Doğru karar, kullanım oranına, veri yerleşimine, personel kaynağına, erişilebilirlik hedeflerine ve gerçekten yönetilen modelin çok kipli özelliklerine ihtiyaç duyup duymadığınıza bağlıdır.
Boyut
Kendi altyapında Qwen3.8-2.4T-A95B
CometAPI üzerinden Qwen3.8-Max
Altyapı
Çok GPU’lu sunucu veya küme
GPU altyapısı gerekmez
Girdi kipleri
Metin
Metin, görüntü, video
Bağlam
262K yerel; ~1.01M genişletilmiş
Yönetilen 1M
Veri kontrolü
Azami
Bulut API
Operasyonlar
İzleme, yükseltmeler ve Yüksek Erişilebilirlik (HA) size aittir
Sağlayıcı yönetimli
En uygun
Veri yerleşimi, sürekli yüksek kullanım, altyapı ekibi
Çoğu uygulama ekibi ve değişken iş yükleri
Uygun hızlandırıcılara zaten sahipseniz ve kullanım sürekli yüksekse, kendi ortamınızda barındırma gerekçelendirilebilir. Yalnızca bu model için bir küme satın alacaksanız, CometAPI üzerindeki Qwen3.8-Max genellikle daha az sürtünmeli yoldur. Mevcut API kılavuzu barındırılan entegrasyonu, fiyatlandırma kılavuzu maliyet modellemeyi kapsar; bu yazı bu nedenle yerel dağıtıma odaklanır.
Yaygın Qwen 3.8 Yerel Dağıtım Sorunları
Sunucu Başlangıçta GPU Belleğini Tüketiyor
Önce sorun önbellekse --max-model-len değerini azaltın. Ağırlıkların kendisi sığmıyorsa bağlamı düşürmek kök sorunu çözmez; doğrulanmış daha düşük hassasiyetli bir checkpoint’e geçin veya GPU ekleyin.
Tensör Paralelliği Geçersiz Boyut Hatasıyla Başarısız Oluyor
Qwen3.8’in tam dikkat katmanlarında 64 başlık bulunur, bu nedenle vLLM TP’nin 64’ü bölmesi gerektiğini varsayar. Doğrudan TP boyutları 1, 2, 4, 8, 16 ve 32’dir. Bu yüzden yalnızca toplam VRAM, topolojiyi seçmek için yeterli değildir.
Sunucunun Başlaması Uzun Sürüyor
Bir ila birkaç terabayt ağırlığın yüklenmesi ve çekirdek JIT dakikalar sürebilir. VLLM_ENGINE_READY_TIMEOUT_S değerini artırın ve kısa bir başlangıç penceresi varsaymak yerine gerçek bir çıkarım uç noktasını yoklayın.
Yerel Model Bir Görüntüyü İşleyemiyor
Bu beklenen bir durumdur. Qwen3.8-2.4T-A95B açık checkpoint yalnızca metinseldir. Bu sınırlama Qwen3.8-2.4T-A95B’ye özeldir. Qwen3.8-27B, ayrı görsel projeksiyon dosyaları yüklendiğinde görsel girdiyi destekler.
1M Bağlam Verimi Dramatik Şekilde Azaltıyor
--max-model-len değerini iş yükünüzün gerçekten ihtiyaç duyduğu en uzun dizgeye düşürün. Desteklenen en büyük bağlam penceresi, en iyi üretim ayarı olmak zorunda değildir; iş yükü gereksinimleri, KV-önbellek kullanımı ve eşzamanlılığı dengeleyen bir bağlam sınırı seçin.
Ollama veya LM Studio Qwen 3.8 Max’i Çalıştırabilir mi?
Ekosistem, llama.cpp tarzı çıkarım için ağır kuantize edilmiş Qwen3.8 ağırlıklarını paketleyebilir; ancak bu, normal bir masaüstü Ollama iş akışıyla karıştırılmamalıdır. Yüzlerce gigabayt kaplayan bir kuantize derleme, hâlâ yüzlerce gigabayt erişilebilir bellek gerektirir ve kalite ile performansta önemli ödünler içerir.
Sıradan yerel geliştirme için uygun hedef Qwen3.8-27B’dir. Aşırı topluluk kuantları onu alışılmadık donanımlarda teknik olarak önyüklenebilir kılsa bile tam 2,4T model, sunucu/küme modeli olarak ele alınmalıdır.
Hangi Dağıtım Yöntemini Seçmelisiniz?
NVIDIA Blackwell için şu anda en temiz tam model başlangıç noktası 8× B300 NVFP4 dağıtımıdır. AMD için karşılık gelen pratik yapılandırma MXFP4 ile 8× MI355X’tir. Altyapı boyutuna kıyasla checkpoint kökeni ve kaliteyi önceliyorsanız FP8 kullanın; çok raflı ölçekli bellek gereksinimlerini yalnızca azami sadakat haklı çıkarıyorsa BF16 kullanın.
Bir iş istasyonu için Qwen3.8-27B kullanın. GPU-küme operasyonları olmadan Max yeteneklerine ihtiyaç duyan uygulama ekipleri için barındırılan CometAPI üzerindeki Qwen3.8-Max modelini kullanın.
Sonuç
Qwen3.8-Max, ilk API lansmanından bu yana önemli bir eşiği geçti: Max sınıfı Qwen ailesinin artık kuruluşların tamamen kendi altyapılarında çalıştırabileceği açık bir 2,4T checkpoint’i var.
Ancak açık ağırlıklar, tüketici donanımı anlamına gelmez. 4.45 TiB BF16 ayak izi, 2.27 TiB FP8 checkpoint ve 1.3–1.5 TiB FP4 varyantları, Qwen3.8-2.4T-A95B’yi mevcut en altyapı-yoğun açık modellerden biri yapar. Pratik açıdan olumlu olan, vLLM ve SGLang’in mimariyi zaten desteklemesi ve FP4’ün tek düğümlü 8× B300 veya 8× MI355X dağıtımını mümkün kılmasıdır.
Veri kontrolü, sürekli kullanım ve altyapı sahipliği kümeyi haklı çıkarıyorsa kendi ortamınızda barındırın. Aksi halde yönetilen Max API’sini kullanın—ya da aslında istediğiniz tek bir iş istasyonunda güçlü bir Qwen modeli ise Qwen3.8-27B’yi seçin.