Xây dựng với CometAPICần một API cho nhiều mô hình?Kiểm thử quy trình trong Playground, sau đó tạo API key khi mô hình và chi phí phù hợp với trường hợp sử dụng của bạn.
Đối với nhà phát triển dùng DeepSeek V4.1 Flash API trong CometAPI, việc tích hợp thực tế tương thích OpenAI: dùng https://api.cometapi.com/v1 làm URL nền tảng, đặt model thành deepseek-v4.1-flash, và gọi giao diện Chat Completions tiêu chuẩn.
Một khác biệt tên gọi quan trọng: API chính thức của DeepSeek dùng deepseek-flash, còn CometAPI dùng deepseek-v4.1-flash. Hãy coi định danh model là phần cấu hình phụ thuộc nhà cung cấp.
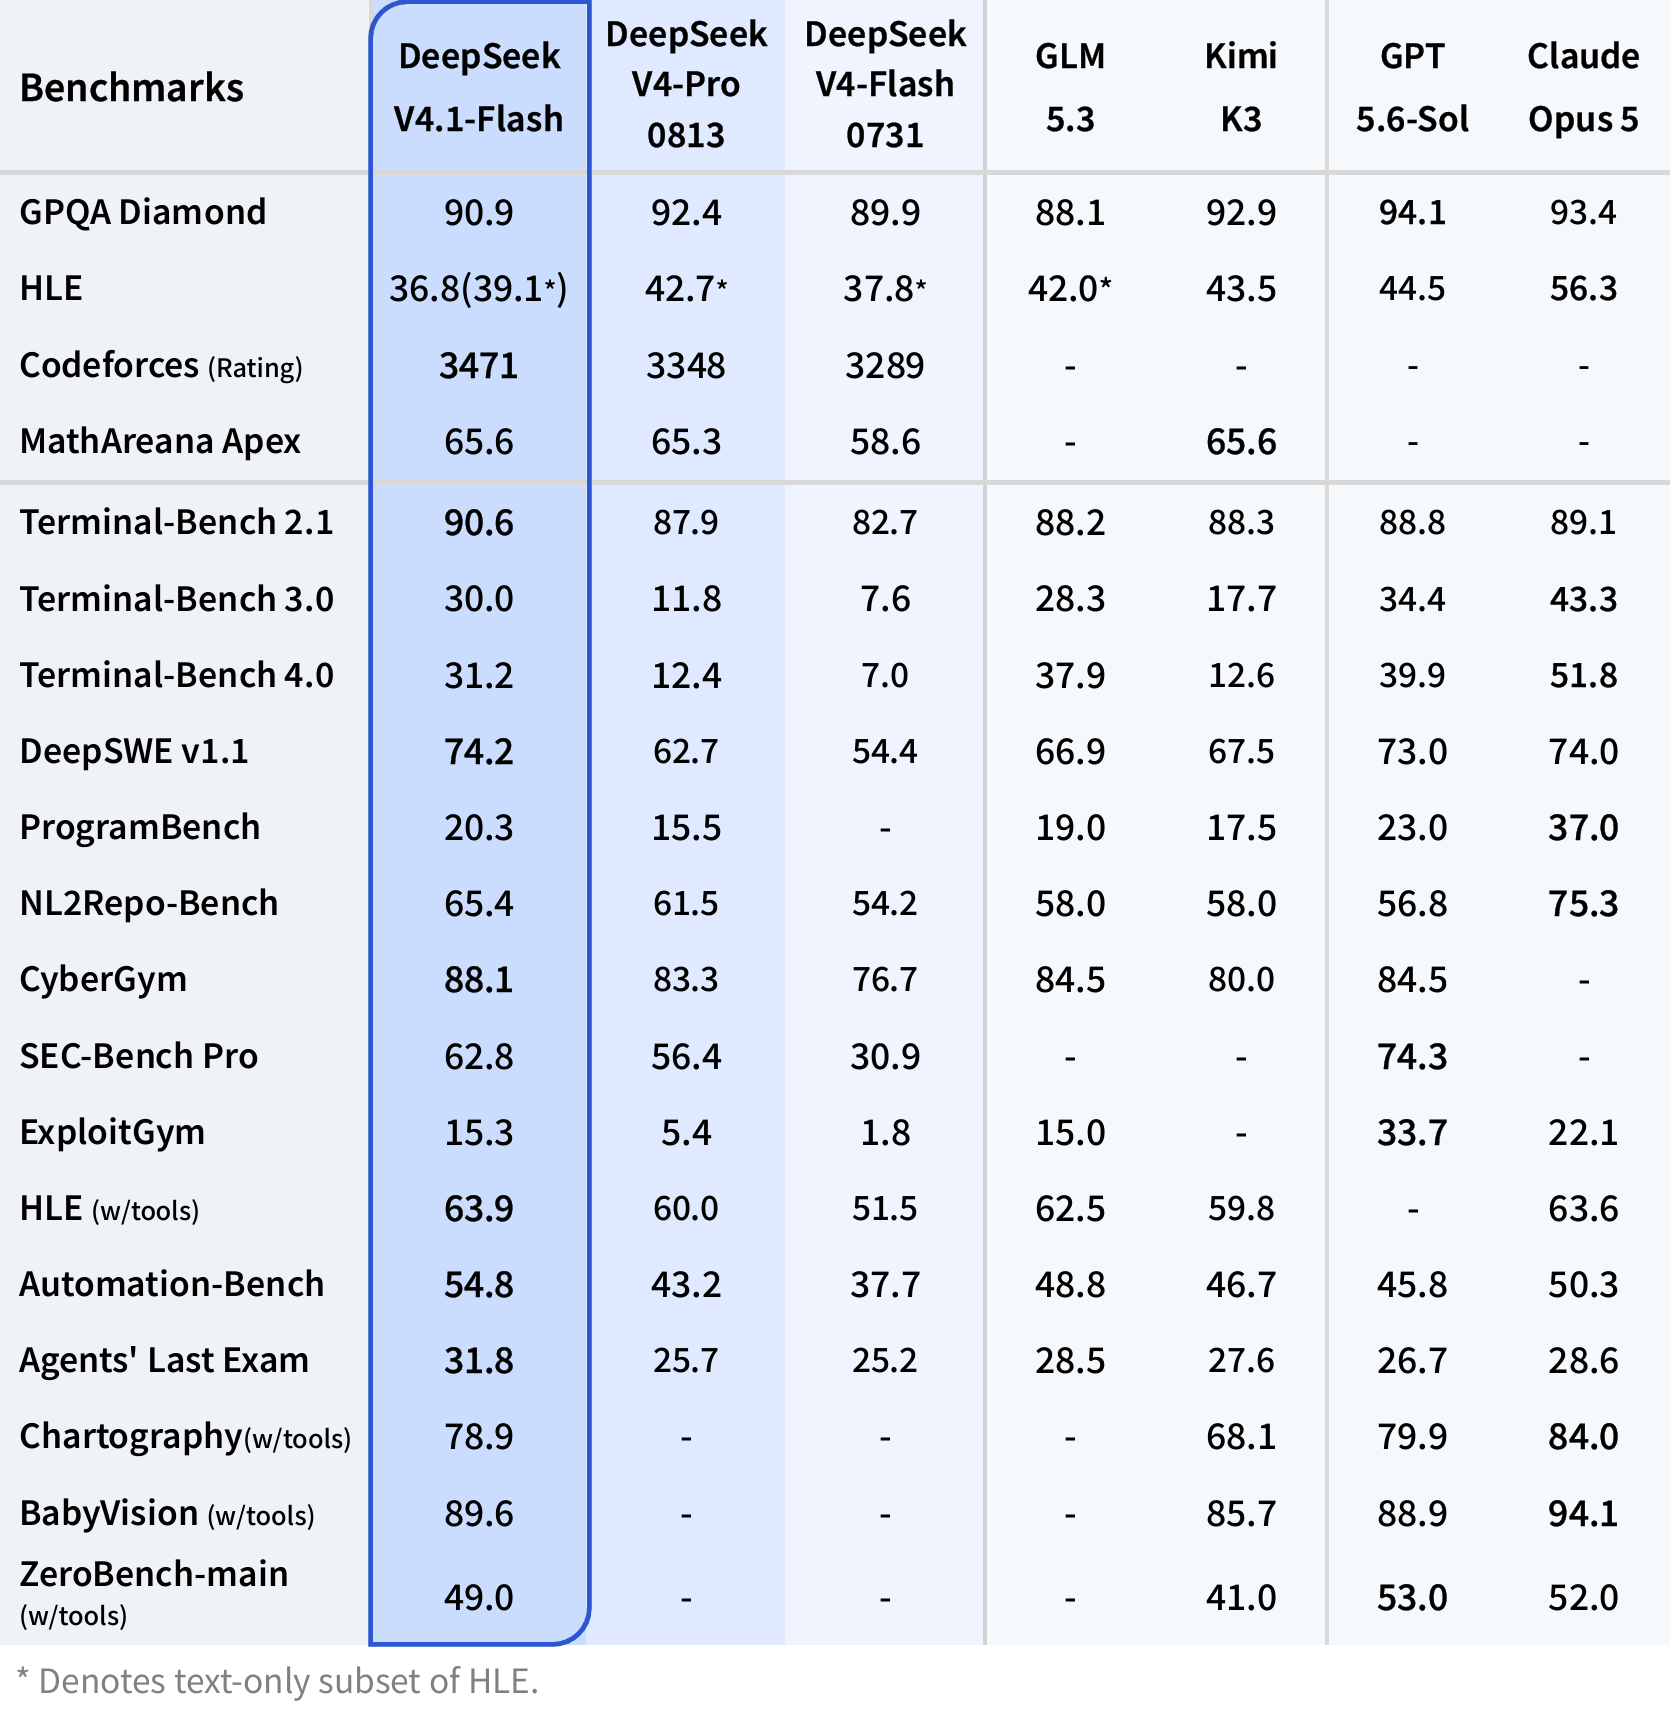
Khác biệt lớn nhất được đo tập trung vào các bài kiểm tra lập trình, terminal, repository, tự động hóa và agent có hỗ trợ công cụ.
Trước khi triển khai sản xuất, hãy xác thực các trường nâng cao như kiểm soát “thinking”, payload thị giác, streaming, gọi công cụ, và đầu ra có cấu trúc trên đúng tuyến nhà cung cấp bạn sẽ dùng.
What Is the DeepSeek V4.1 Flash API?
DeepSeek V4.1 Flash là mô hình Flash mới nhất được xây dựng trên kiến trúc Mixture-of-Experts 552B tham số. Thiết kế Causal Encoder-Decoder kích hoạt 8B tham số cho xử lý đầu vào và 16B cho tạo đầu ra.
Về kế hoạch tích hợp, API chính thức của DeepSeek cung cấp cửa sổ ngữ cảnh 1M token và tối đa đầu ra 384K token. Dịch vụ thượng nguồn hỗ trợ Chat Completions và Responses APIs tương thích OpenAI, API tương thích Anthropic, streaming, đầu ra JSON, gọi công cụ, và đầu vào hình ảnh gốc. Hướng dẫn này sử dụng tuyến Chat Completions của CometAPI, vì vậy hãy xác minh khả năng “passthrough” của tính năng trên tuyến đó trước khi triển khai sản xuất.
Specification
Chi tiết API chính thức DeepSeek V4.1 Flash
Architecture
552B MoE, Causal Encoder-Decoder
Active parameters
8B cho đầu vào; 16B cho đầu ra
Context length
1M tokens
Maximum output
384K tokens
Interfaces
Chat Completions, Responses API, API tương thích Anthropic
Streaming
Hỗ trợ
Structured output
Đầu ra JSON và JSON Schema qua các endpoint được hỗ trợ
Tool calls
Hỗ trợ, bao gồm sử dụng công cụ trong chế độ thinking
Ghi chú nhà cung cấp: ID model và các trường yêu cầu nâng cao là phụ thuộc tuyến. Dùng deepseek-v4.1-flash cho các ví dụ CometAPI trong hướng dẫn này và kiểm thử thị giác, gọi công cụ, đầu ra có cấu trúc, và kiểm soát thinking trên endpoint triển khai.
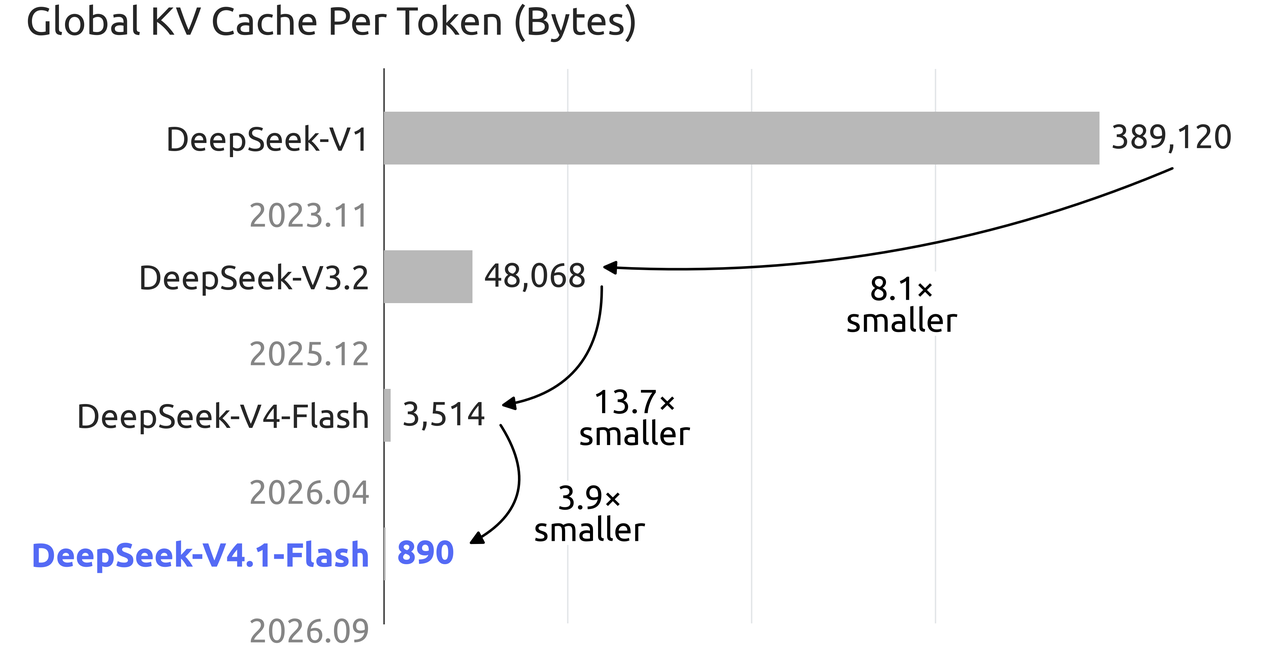
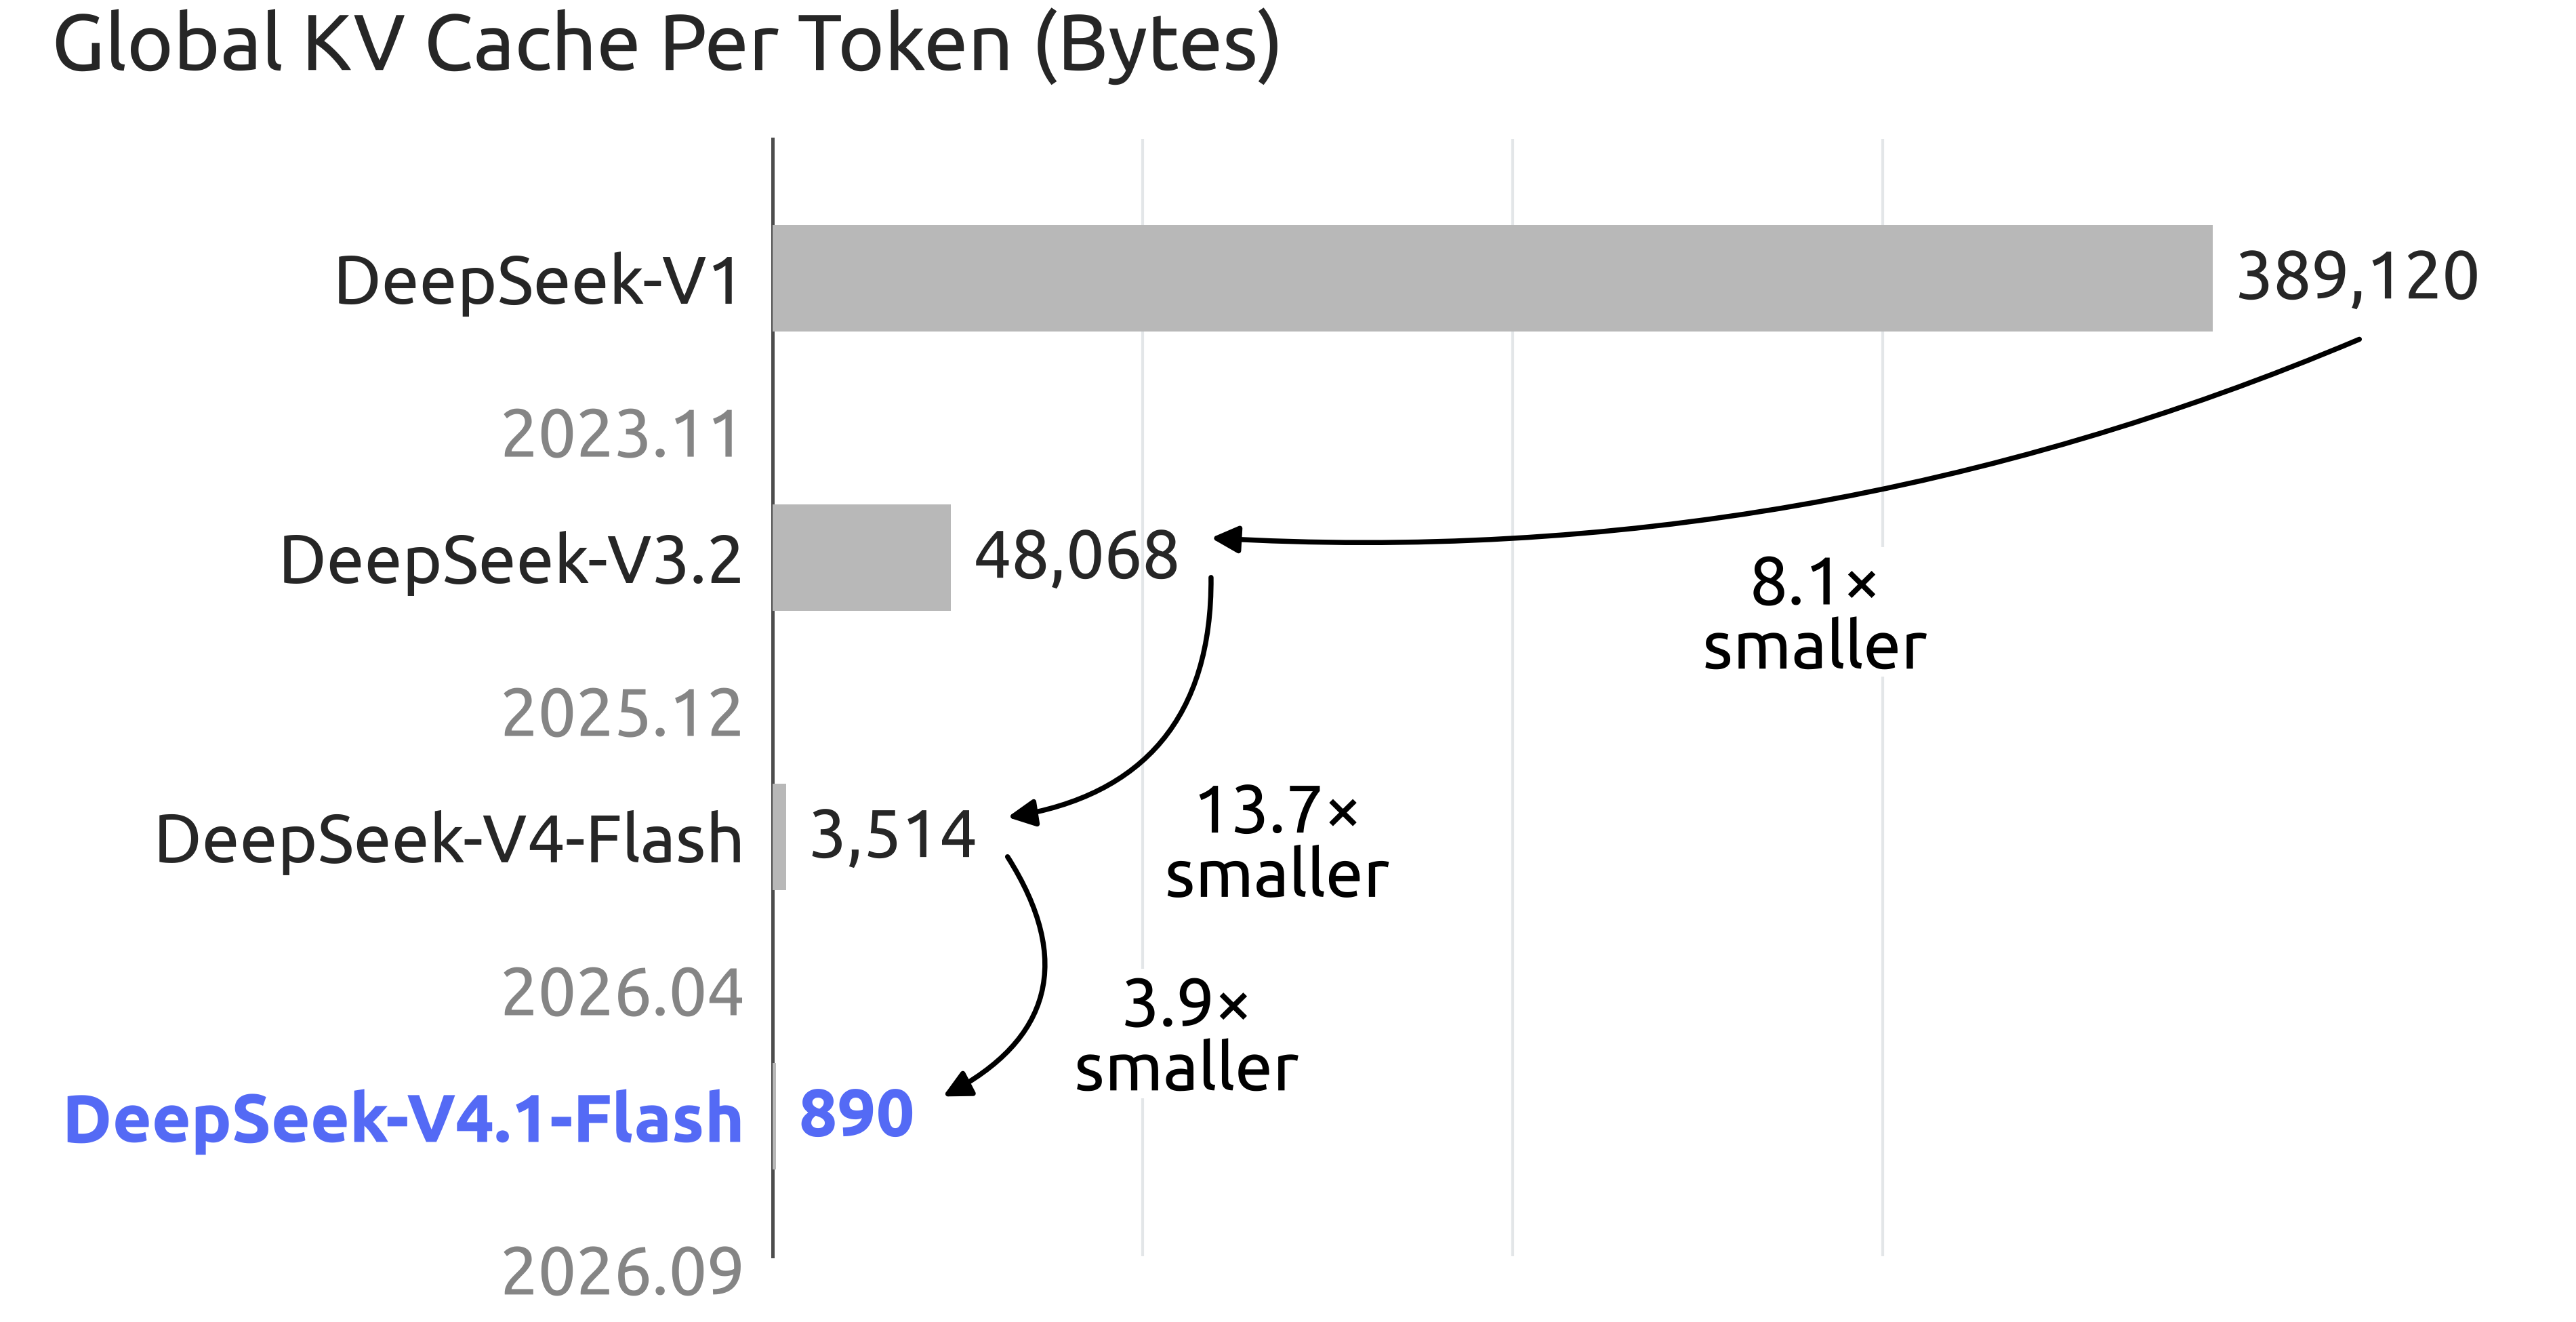
DeepSeek cũng báo cáo KV cache toàn cục khoảng 890 byte mỗi token, so với 3,514 byte mỗi token ở thế hệ V4 Flash trước. Sự giảm này đặc biệt quan trọng với các agent chạy lâu, liên tục tái sử dụng prompt lớn, schema công cụ, và lịch sử hội thoại.
How Strong Is DeepSeek V4.1 Flash for Coding and AI Agents?
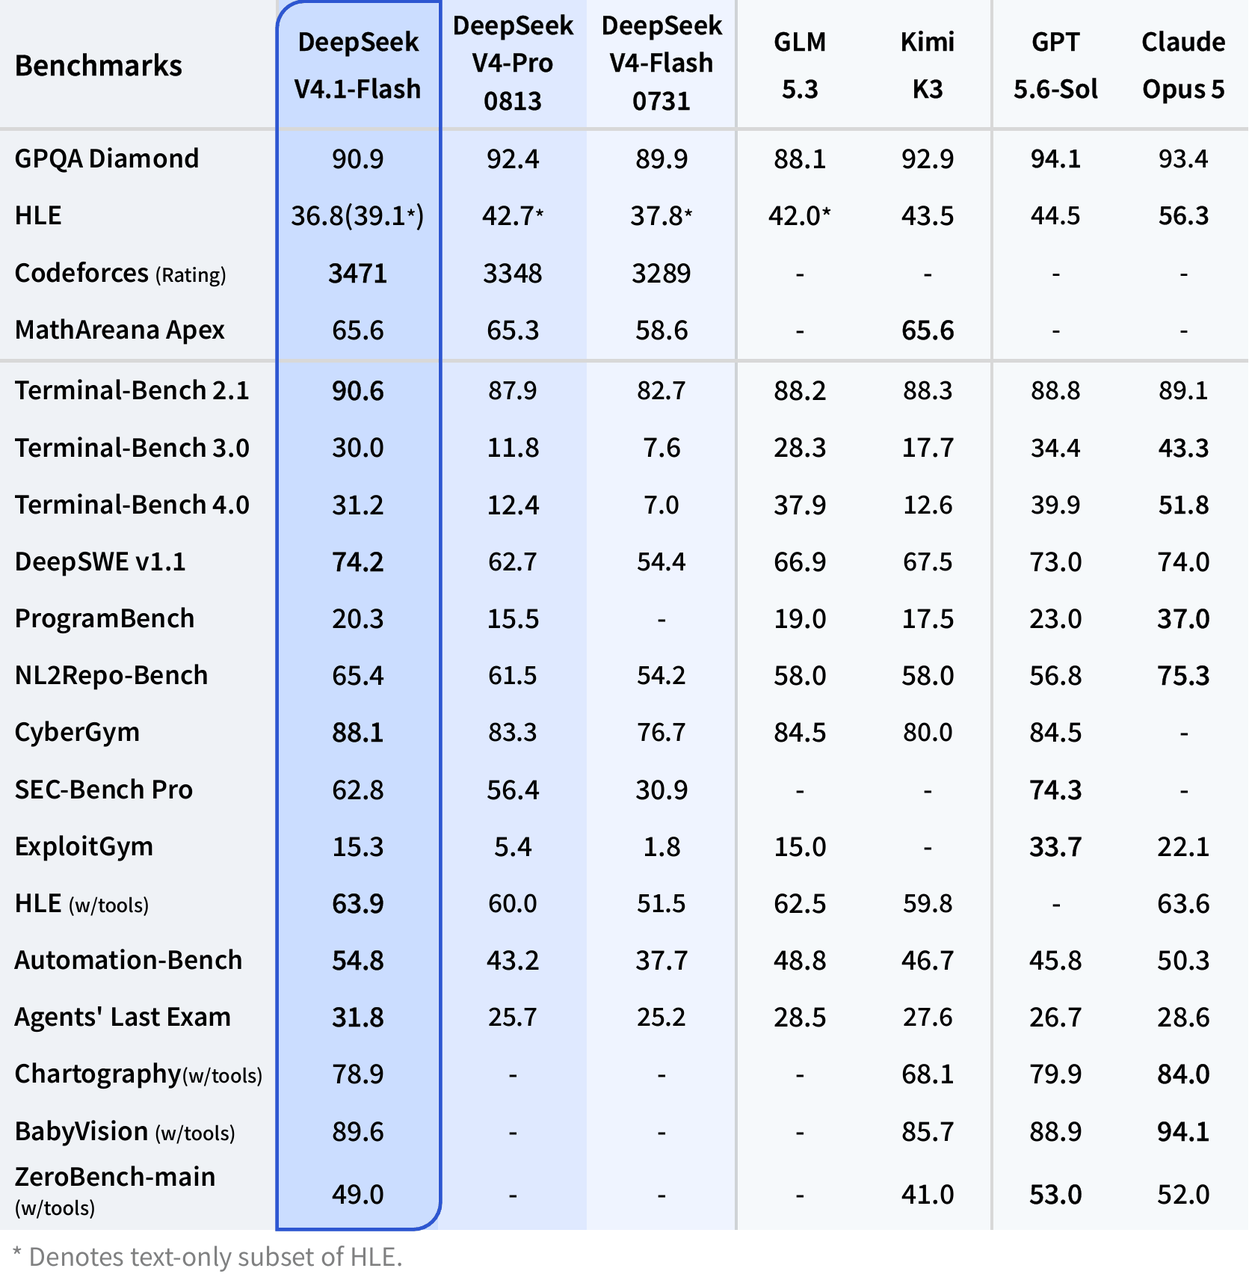
Hướng dẫn này tập trung vào bằng chứng benchmark trực tiếp hỗ trợ chọn API. DeepSeek mô tả V4.1 Flash vượt các model đầu bảng, bao gồm V4 Pro, trên gói đánh giá đã công bố. Những cải thiện hữu ích nhất xuất hiện ở công việc terminal, kỹ nghệ phần mềm, nhiệm vụ repository, tự động hóa, và agent có hỗ trợ công cụ; các đội sản xuất vẫn nên xác thực model trên prompt và tiêu chí hoàn thành riêng.
Benchmark
DeepSeek V4.1 Flash
DeepSeek V4 Pro
DeepSeek V4 Flash
GPQA Diamond
90.9
92.4
89.9
Terminal-Bench 2.1
90.6
87.9
82.7
DeepSWE v1.1
74.2
62.7
54.4
NL2Repo-Bench
65.4
61.5
54.2
HLE with tools
63.9
60.0
51.5
Automation-Bench
54.8
43.2
37.7
Agents' Last Exam
31.8
25.7
25.2
Kết luận thực tiễn hẹp hơn “V4.1 thông minh hơn”. DeepSeek V4.1 Flash đặc biệt hấp dẫn cho sử dụng công cụ lặp lại, thao tác terminal, lập trình ở quy mô repository, tự động hóa, và quỹ đạo agent dài. Các khối lượng công việc thuần tri thức hoặc lý luận có thể cho thứ hạng khác.
Why Use the DeepSeek V4.1 Flash API Through CometAPI?
Lợi thế tích hợp chính là DeepSeek V4.1 Flash API trong CometAPI có thể gọi theo cùng mẫu client tương thích OpenAI dùng cho các model khác, giảm thay đổi SDK trong ứng dụng đa model.
Setting
Giá trị
Base URL
https://api.cometapi.com/v1
Chat endpoint
/chat/completions
Model ID
deepseek-v4.1-flash
Authentication
Bearer API key
Python SDK
Tương thích OpenAI SDK
JavaScript SDK
Tương thích OpenAI SDK
Điều này cũng tránh một lỗi tích hợp phổ biến: sao chép định danh của DeepSeek từ phía nhà cung cấp vào yêu cầu CometAPI. Các tuyến nhà cung cấp tham chiếu cùng họ model, nhưng ID model được ghi tài liệu là khác nhau.
Tạo CometAPI API key, lưu vào biến môi trường, và cấu hình base URL tương thích OpenAI là https://api.cometapi.com/v1. Không nhúng thông tin xác thực sản xuất trong mã nguồn.
Dùng định danh model deepseek-v4.1-flash với endpoint Chat Completions tiêu chuẩn.
curl "https://api.cometapi.com/v1/chat/completions"
  -H "Content-Type: application/json"
  -H "Authorization: Bearer ${COMETAPI_KEY}"
  -d '{
    "model": "deepseek-v4.1-flash",
    "messages": [
      {
        "role": "user",
        "content": "Explain three ways to reduce latency in a high-throughput API service."
      }
    ]
  }'
Phản hồi thành công dùng cấu trúc completion kiểu OpenAI quen thuộc, nên các ứng dụng đã đọc choices[0].message.content gần như không cần chuyển đổi.
Python SDK Example
pip install openai
``````python
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Write a Python retry helper with exponential backoff."
        }
    ],
)

print(response.choices[0].message.content)
Trong môi trường sản xuất, thêm timeout rõ ràng, retry có giới hạn, ghi log yêu cầu, và theo dõi mức sử dụng.
JavaScript SDK Example
npm install openai
``````js
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
});

const response = await client.chat.completions.create({
  model: "deepseek-v4.1-flash",
  messages: [
    {
      role: "user",
      content: "Create a typed rate limiter interface for an Express API."
    }
  ],
});

console.log(response.choices[0].message.content);
Lớp trừu tượng client giữ nguyên trong khi base URL và ID model trở thành cấu hình nhà cung cấp.
DeepSeek V4.1 Flash API Features
Configure Reasoning and Thinking Mode
DeepSeek ghi nhận cả chế độ thinking và non-thinking. Khi định tuyến qua CometAPI, hãy xác minh các trường cụ thể của nhà cung cấp được truyền chính xác như kỳ vọng trước khi dựa vào chúng như hợp đồng sản xuất.
Kiểm thử từng mức nỗ lực được hỗ trợ so với mục tiêu độ trễ, dùng token, và hoàn thành tác vụ của bạn bởi vì ánh xạ giữa nhà cung cấp có thể khác nhau.
Analyze Images with Vision Input
DeepSeek V4.1 Flash chấp nhận ảnh JPEG, PNG, GIF, và WebP. Giới hạn chính thức gồm 32 MiB cho ảnh inline, 64 MiB cho ảnh dạng tệp, tối đa 600 ảnh mỗi yêu cầu, và giới hạn 8,192 ký tự cho URL ảnh ngoài. Ảnh thuộc về thông điệp user hoặc developer, không phải system hoặc assistant.
response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "Identify the three most important anomalies."},
                {
                    "type": "image_url",
                    "image_url": {"url": "https://example.com/dashboard.png"}
                }
            ]
        }
    ],
)
Xác thực kích thước ảnh, khả năng truy cập URL, tiền xử lý, dùng token, và độ trễ trên đúng tuyến CometAPI dùng trong sản xuất.
Stream Responses with SSE
Streaming giảm độ trễ cảm nhận bằng cách cung cấp đầu ra tăng dần cho giao diện lập trình, chat, và agent tương tác.
stream = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Explain distributed-cache invalidation."
        }
    ],
    stream=True,
)

for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
Client sản xuất cần xử lý stream bị gián đoạn, delta rỗng, khôi phục khi timeout, ranh giới retry, và tính toán mức sử dụng cuối cùng.
How Much Does the DeepSeek V4.1 Flash API Cost?
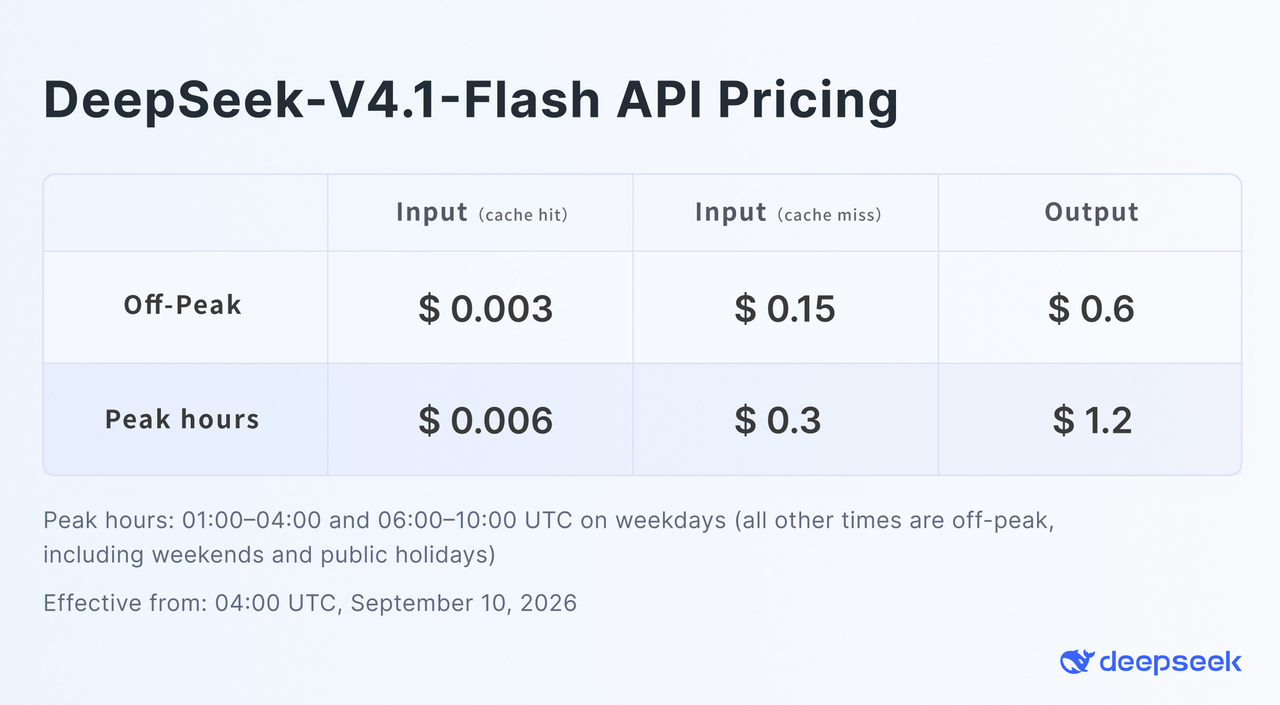
Giá API được DeepSeek công bố sử dụng khung giờ peak và off-peak. Hình giá chính thức cho thấy mức off-peak là $0.003/M cache-hit input, $0.15/M cache-miss input, và $0.60/M output; mức peak gấp đôi.
Ví dụ đơn giản theo giá cơ bản cho 100M cache-miss input tokens và 20M output tokens:
Input:
100 x $0.12 = $12.00

Output:
20 x $0.48 = $9.60

Total base cost:
$21.60
Chi phí sản xuất thực tế phụ thuộc vào tỷ lệ token được cache, hệ số peak, điều kiện yêu cầu, và mức giá hiện tại của nhà cung cấp. Chênh lệch lớn giữa giá cache-hit và cache-miss khiến các tiền tố có thể tái sử dụng ổn định - hướng dẫn hệ thống, schema công cụ, và ngữ cảnh chung - trở thành đòn bẩy chi phí quan trọng.
DeepSeek V4.1 Flash API vs V4 Pro vs V4 Flash
Dimension
DeepSeek V4.1 Flash
DeepSeek V4 Pro
DeepSeek V4 Flash
Primary positioning
Lý luận hiệu quả, agent, thị giác
Lý luận V4 cao cấp
Tầng V4 nhanh trước đây
Native vision
Có
Phụ thuộc model / tuyến cụ thể
Tuyến thị giác riêng ở thế hệ trước
Thinking
Có
Có
Có
Agent performance
Mạnh nhất trong ba ở nhiều bài kiểm tra agent công bố
Mạnh
Thấp hơn V4.1 ở các bài kiểm tra công bố
First-party canonical ID
deepseek-flash
deepseek-v4-pro
Alias kế thừa/tương thích
CometAPI ID
deepseek-v4.1-flash
deepseek-v4-pro
deepseek-v4-flash
Best fit
Khối lượng agent/lập trình mới, lưu lượng lớn
Khối lượng được xác thực riêng trên Pro
Tương thích kế thừa và so sánh
Trạng thái hiện tại: tài liệu trực tiếp của DeepSeek
nêu rằng DeepSeek V4 Pro vẫn khả dụng sau ngày 14 tháng 9, 2026, với billing không đổi. Hãy xác minh tài liệu trực tiếp trước khi phụ thuộc vào hành vi định tuyến hoặc di trú.
What Should You Test Before Putting DeepSeek V4.1 Flash API into Production?
Định tuyến model: xác nhận deepseek-v4.1-flash trong CometAPI và giữ ID phụ thuộc nhà cung cấp trong cấu hình thay vì logic ứng dụng.
Hồi quy prompt: chạy các prompt sản xuất tiêu biểu và so sánh mức hoàn thành tác vụ, không chỉ điểm benchmark.
Đầu ra có cấu trúc: xác thực mọi phản hồi JSON với schema ứng dụng và định nghĩa đường sửa hoặc retry.
Gọi công cụ: kiểm thử kiểu đối số, lời gọi sai định dạng, lời gọi song song, và điều kiện dừng vòng lặp.
Kiểm soát thinking: xác minh các trường nào CometAPI truyền qua và đo độ trễ cùng tác động token của mỗi thiết lập.
Thị giác: kiểm thử ảnh chụp màn hình và tài liệu thực tế, gồm giới hạn kích thước, URL không truy cập được, và vai trò thông điệp không hỗ trợ.
Streaming: xử lý delta rỗng, kết nối gián đoạn, ranh giới retry, và tính toán mức sử dụng cuối cùng.
Ngữ cảnh dài và caching: đo chất lượng câu trả lời, tỷ lệ cache-hit, và chi phí khi độ dài prompt tăng.
Độ tin cậy: ghi nhận độ trễ p50, p95, p99; diễn tập đường 429, 5xx, timeout, và fallback.
Kiểm soát chi phí: theo dõi input, cached input, reasoning, và output tokens trên mỗi tác vụ hoàn thành.
Đối với khối lượng agent, so sánh chi phí mỗi tác vụ hoàn thành - không chỉ đô-la trên mỗi triệu token. Một model có thể đắt hơn trên mỗi token đầu ra nhưng vẫn rẻ hơn đầu-cuối nếu nó giảm số lần retry và gọi công cụ; điều ngược lại cũng đúng khi nỗ lực lý luận cao làm tăng token mà không cải thiện hoàn thành tác vụ.
Is the DeepSeek V4.1 Flash API Worth Using?
Với các tích hợp DeepSeek mới, DeepSeek V4.1 Flash là ứng viên mặc định mạnh cho họ Flash vì nó kết hợp hiệu năng agent tốt hơn theo công bố với thị giác gốc và mức giá cạnh tranh.
Các trường hợp sử dụng mạnh nhất không chỉ là chat chung. Phù hợp hơn là agent lập trình, kỹ nghệ phần mềm tự động, phân tích ngữ cảnh dài, trợ lý đa phương thức, tự động hóa quy trình lưu lượng lớn, và agent dùng công cụ nơi ngữ cảnh lặp lại có thể chi phối tổng chi phí.
Đối với nhà phát triển muốn giữ kiến trúc SDK kiểu OpenAI, DeepSeek V4.1 Flash API trong CometAPI cung cấp mẫu tích hợp dùng xuyên suốt hướng dẫn này: giữ giao diện client tiêu chuẩn, trỏ tới https://api.cometapi.com/v1, và dùng deepseek-v4.1-flash.
DeepSeek V4.1 Flash API FAQ
Tôi nên tổ chức ID model phụ thuộc nhà cung cấp như thế nào?
Lưu nhà cung cấp, base URL, và ID model cùng nhau trong cấu hình theo môi trường. Điều này tránh việc vô tình gửi ID từ phía nhà cung cấp như deepseek-flash tới một tuyến CometAPI mong đợi deepseek-v4.1-flash.
Làm sao cải thiện tái sử dụng cache trong agent chạy lâu?
Giữ hướng dẫn hệ thống ổn định, schema công cụ, và ngữ cảnh tham chiếu chung ở đầu prompt. Nối thêm input người dùng biến động và kết quả công cụ sau đó để tiền tố có thể tái sử dụng ít thay đổi hơn.
Cách an toàn nhất để so sánh V4.1 Flash với V4 Pro là gì?
Phát lại cùng tập nhiệm vụ sản xuất, giới hạn ngân sách retry, và so sánh tỷ lệ hoàn thành, độ trễ, số lần gọi công cụ, và tổng token. Giá mỗi token thấp hơn không đảm bảo chi phí thấp hơn trên mỗi tác vụ thành công.
Agent nên dùng chính sách fallback nào?
Xác định lỗi nào có thể retry, đặt trần retry nghiêm ngặt, và chọn model fallback chỉ sau khi bảo toàn trạng thái công cụ cần thiết để tiếp tục an toàn. Ghi log mọi fallback để trôi chất lượng im lặng có thể thấy được.
Tôi nên xác thực đầu vào ảnh như thế nào trước khi gửi?
Kiểm tra chữ ký tệp thực, định dạng được hỗ trợ, kích thước byte, khả năng truy cập URL, và vai trò thông điệp. Loại bỏ siêu dữ liệu không cần thiết và tránh gửi ảnh nhạy cảm trừ khi chính sách lưu trữ và truy cập của bạn cho phép rõ ràng.
Khi nào nên cân nhắc Responses API thay vì Chat Completions?
Dùng Chat Completions khi duy trì workflow thông điệp tương thích OpenAI hiện có. Cân nhắc Responses API khi ứng dụng hưởng lợi từ input item có kiểu, ảnh đầu ra từ công cụ, hoặc đầu ra JSON Schema, sau đó xác nhận tuyến nhà cung cấp đã chọn hỗ trợ các trường cần thiết.
Tôi nên xử lý lỗi xác thực schema như thế nào?
Từ chối đầu ra không hợp lệ trước khi đến hệ thống hạ nguồn, ghi nhận lỗi xác thực, và retry với prompt sửa có giới hạn. Nếu sửa lặp lại vẫn thất bại, định tuyến tác vụ tới fallback an toàn thay vì chấp nhận JSON có vẻ hợp lệ nhưng thực tế sai.